> ## Content Index
> Fetch the complete content index at: https://www.hubwiz.com/blog/llms.txt
> Use this file to discover other available public pages before exploring further.
# 一个AI编程代理的设计决策
- URL: https://www.hubwiz.com/blog/design-decisions-for-building-an-ai-coding-agent/
- Published: 2025-12-14T12:11:32.000Z
- Updated: 2025-12-14T12:11:32.000Z
- Description: pi-coding-agent的作者Mario Zechner详细介绍了他在开发这个AI编程代理的过程中的各种设计决策,例如不支持MCP等。
- Author: admin
- Tags: AGENT, PI-CODING-AGENT, #Import 2026-10-14 14:41
在过去三年中,我一直在使用 LLM 进行辅助编码。如果你读到这篇博客,你可能经历了同样的演变过程:从将代码复制粘贴到 [ChatGPT](https://chatgpt.com/?ref=hubwiz.com),到 [Copilot](https://github.com/features/copilot?ref=hubwiz.com) 的自动补全(对我来说从未奏效),再到 [Cursor](https://cursor.com/?ref=hubwiz.com),最后是像 [Claude Code](https://claude.ai/code?ref=hubwiz.com)、[Codex](https://github.com/openai/codex?ref=hubwiz.com)、[Amp](https://ampcode.com/?ref=hubwiz.com)、[Droid](https://factory.ai/?ref=hubwiz.com) 和 [opencode](https://opencode.ai/?ref=hubwiz.com) 这样的新型编码代理,它们在 2025 年成为我们的日常驾驶工具。
我大部分工作都使用 Claude Code。这是我在使用 Cursor 一年半后尝试的第一个工具。当时它非常基础。这与我的工作流程完美契合,因为我是那种喜欢简单、可预测工具的人。过去几个月,Claude Code 已经变成了一艘宇宙飞船,拥有 80% 的功能我根本用不上。[系统提示和工具也随着每次发布而变化](http://127.0.0.1:8000/posts/2025-08-03-cchistory/?ref=hubwiz.com),这破坏了我的工作流程并改变了模型行为。我讨厌这样。而且它会闪烁。
多年来,我也构建了各种复杂程度的代理。例如,[Sitegeist](https://sitegeist.ai/?ref=hubwiz.com),我的一个小浏览器使用代理,本质上是一个生活在浏览器中的编码代理。在所有这些工作中,我了解到上下文工程至关重要。精确控制进入模型上下文的内容可以产生更好的输出,尤其是在编写代码时。现有的工具使这变得极其困难或不可能,因为它们在你不知情的情况下注入了一些东西,甚至没有在 UI 中显示出来。
说到显示内容,我想检查与模型交互的每一个方面。基本上没有工具允许这样做。我也想要一个干净的文档会话格式,我可以自动进行后期处理,并且有一个简单的方法在代理核心之上构建替代 UI。虽然一些现有工具可以实现这一点,但它们的 API 像有机进化一样。这些解决方案在过程中积累了负担,这体现在开发者体验中。我并不是在责怪任何人。如果很多人使用你的垃圾,并且你需要某种向后兼容性,这就是你要付出的代价。
我还尝试过自托管,包括本地和 [DataCrunch](https://datacrunch.io/?ref=hubwiz.com)。虽然一些工具如 opencode 支持自托管模型,但通常效果不好。主要是因为它们依赖于像 [Vercel AI SDK](https://sdk.vercel.ai/?ref=hubwiz.com) 这样的库,由于某种原因,这些库与自托管模型不兼容,特别是在调用工具时。
那么,一个老家伙对 Claude 的抱怨会做什么?他会自己写一个编码代理并给它一个完全无法通过 Google 搜索到的名字,这样就永远不会有任何用户。这意味着 GitHub 上也不会有任何问题。这有多难?
为了使这一切发挥作用,我需要构建:
- [**pi-ai**](https://github.com/badlogic/pi-mono/tree/main/packages/ai?ref=hubwiz.com): 一个统一的 LLM API,支持多提供者(Anthropic、OpenAI、Google、xAI、Groq、Cerebras、OpenRouter 和任何 OpenAI 兼容端点),流式传输,使用 TypeBox 架构的工具调用,思考/推理支持,无缝跨提供者上下文交接,以及令牌和成本跟踪。
- [**pi-agent-core**](https://github.com/badlogic/pi-mono/tree/main/packages/agent?ref=hubwiz.com): 一个处理工具执行、验证和事件流的代理循环。
- [**pi-tui**](https://github.com/badlogic/pi-mono/tree/main/packages/tui?ref=hubwiz.com): 一个最小的终端 UI 框架,具有差异渲染、同步输出以实现(几乎)无闪烁更新,以及编辑器组件、自动完成和 Markdown 渲染。
- [**pi-coding-agent**](https://github.com/badlogic/pi-mono/tree/main/packages/coding-agent?ref=hubwiz.com): 实际的 CLI,将所有内容连接在一起,包括会话管理、自定义工具、主题和项目上下文文件。
我在这方面的哲学是:如果我不需要它,就不会构建它。而且我不需要很多东西。
## 1、pi-ai 和 pi-agent-core
我不会烦扰你关于这个包的 API 细节。你可以阅读 [README.md](https://github.com/badlogic/pi-mono/blob/main/packages/ai/README.md?ref=hubwiz.com)。相反,我想记录我在创建统一的 LLM API 时遇到的问题以及如何解决它们。我并不声称我的解决方案是最好的,但它们在整个各种代理和非代理 LLM 项目中一直表现得相当不错。
### 1.1 四个API
实际上,你只需要四种 API 来与几乎所有 LLM 提供商交谈:[OpenAI 的 Completions API](https://platform.openai.com/docs/api-reference/chat/create?ref=hubwiz.com)、他们较新的 [Responses API](https://platform.openai.com/docs/api-reference/responses?ref=hubwiz.com)、[Anthropic 的 Messages API](https://docs.anthropic.com/en/api/messages?ref=hubwiz.com) 和 [Google 的 Generative AI API](https://ai.google.dev/api?ref=hubwiz.com)。
它们在功能上都很相似,因此在它们之上构建抽象并不是火箭科学。当然,有一些供应商特有的特点需要关注。这尤其适用于 Completions API,它被几乎所有供应商使用,但每个供应商对这个 API 应该做什么有不同的理解。例如,虽然 OpenAI 不支持他们在 Completions API 中的推理痕迹,但其他供应商在其 Completions API 版本中支持。这同样适用于推理引擎如 [llama.cpp](https://github.com/ggml-org/llama.cpp?ref=hubwiz.com)、[Ollama](https://ollama.com/?ref=hubwiz.com)、[vLLM](https://github.com/vllm-project/vllm?ref=hubwiz.com) 和 [LM Studio](https://lmstudio.ai/?ref=hubwiz.com)。
例如,在 [openai-completions.ts](https://github.com/badlogic/pi-mono/blob/main/packages/ai/src/providers/openai-completions.ts?ref=hubwiz.com):
- Cerebras、xAI、Mistral 和 Chutes 不喜欢 `store` 字段
- Mistral 和 Chutes 使用 `max_tokens` 而不是 `max_completion_tokens`
- Cerebras、xAI、Mistral 和 Chutes 不支持 `developer` 角色用于系统提示
- Grok 模型不喜欢 `reasoning_effort`
- 不同的提供商在不同的字段中返回推理内容(`reasoning_content` vs `reasoning`)
为了确保所有功能在无数的提供商中都能正常工作,pi-ai 有一个相当广泛的测试套件,涵盖图像输入、推理痕迹、工具调用和其他你期望的 LLM API 功能。测试在所有支持的提供商和流行模型上运行。虽然这是一个良好的努力,但它仍不能保证新模型和提供商能开箱即用。
另一个主要区别是提供商如何报告令牌和缓存读写。Anthropic 有最合理的方法,但总体而言,它还是野蛮西部。有些提供商在 SSE 流的开始报告令牌数,有些只在结束时报告,这使得在请求被中止时准确跟踪成本变得不可能。更糟糕的是,你无法提供一个唯一的 ID 来以后与他们的计费 API 关联,以确定你的哪个用户消耗了多少令牌。因此,pi-ai 在最佳努力的基础上进行令牌和缓存跟踪。对于个人使用来说足够好了,但对于准确计费,如果你的用户通过你的服务消耗令牌,则不可靠。
特别感谢 Google,到目前为止,他们似乎不支持工具调用流,这非常 Google。
pi-ai 也可以在浏览器中运行,这对于构建基于 Web 的界面很有用。一些提供商特别容易支持 CORS,特别是 Anthropic 和 xAI。
### 1.2 上下文交接
上下文在提供者之间的交接是 pi-ai 从一开始就设计的功能。由于每个提供者都有自己跟踪工具调用和思考痕迹的方式,这只能是一个最佳努力的事情。例如,如果你在会话中途从 Anthropic 切换到 OpenAI,Anthropic 的思考痕迹会被转换为助理消息中的内容块,用 `` 标签分隔。这可能或可能不理智,因为 Anthropic 和 OpenAI 返回的思考痕迹实际上并不代表背后发生的事情。
这些提供者还会在事件流中插入签名的 blob,你必须在包含相同消息的后续请求中重新播放。当在提供者内部切换模型时,这也适用。这使得背景中的抽象和转换管道变得繁琐。
我很高兴地报告,pi-ai 中跨提供者的上下文交接和上下文序列化/反序列化工作得相当好:
```
import { getModel, complete, Context } from '@mariozechner/pi-ai';
// 从 Claude 开始
const claude = getModel('anthropic', 'claude-sonnet-4-5');
const context: Context = {
messages: []
};
context.messages.push({ role: 'user', content: 'What is 25 * 18?' });
const claudeResponse = await complete(claude, context, {
thinkingEnabled: true
});
context.messages.push(claudeResponse);
// 切换到 GPT - 它会看到 Claude 的思考作为 标记的文本
const gpt = getModel('openai', 'gpt-5.1-codex');
context.messages.push({ role: 'user', content: 'Is that correct?' });
const gptResponse = await complete(gpt, context);
context.messages.push(gptResponse);
// 切换到 Gemini
const gemini = getModel('google', 'gemini-2.5-flash');
context.messages.push({ role: 'user', content: 'What was the question?' });
const geminiResponse = await complete(gemini, context);
// 将上下文序列化为 JSON(用于存储、传输等)
const serialized = JSON.stringify(context);
// 之后:反序列化并继续使用任何模型
const restored: Context = JSON.parse(serialized);
restored.messages.push({ role: 'user', content: 'Summarize our conversation' });
const continuation = await complete(claude, restored);
```
### 1.3 我们生活在一个多模型的世界
说到模型,我想要一种类型安全的方式来指定 `getModel` 调用中的模型。为此,我需要一个我可以转换为 TypeScript 类型的模型注册表。我正在从 [OpenRouter](https://openrouter.ai/?ref=hubwiz.com) 和 [models.dev](https://models.dev/?ref=hubwiz.com)(由 opencode 人员创建,谢谢,它非常有用)中解析数据到 [models.generated.ts](https://github.com/badlogic/pi-mono/blob/main/packages/ai/src/models.generated.ts?ref=hubwiz.com)。这包括令牌成本和功能,如图像输入和思考支持。
如果我需要添加注册表中没有的模型,我想要一个类型系统,使其易于创建新模型。这在处理自托管模型、尚未在 models.dev 或 OpenRouter 上的新发布,或尝试一些更晦涩的 LLM 提供商时尤其有用:
```
import { Model, stream } from '@mariozechner/pi-ai';
const ollamaModel: Model<'openai-completions'> = {
id: 'llama-3.1-8b',
name: 'Llama 3.1 8B (Ollama)',
api: 'openai-completions',
provider: 'ollama',
baseUrl: 'http://localhost:11434/v1',
reasoning: false,
input: ['text'],
cost: { input: 0, output: 0, cacheRead: 0, cacheWrite: 0 },
contextWindow: 128000,
maxTokens: 32000
};
const response = await stream(ollamaModel, context, {
apiKey: 'dummy' // Ollama 不需要真实密钥
});
```
许多统一的 LLM API 完全忽略了提供一种中止请求的方法。这在你想将你的 LLM 集成到任何生产系统中时是完全不可接受的。许多统一的 LLM API 也不返回部分结果,这有点荒谬。pi-ai 从一开始就被设计为支持整个管道中的中止,包括工具调用。这里是它的运作方式:
```
import { getModel, stream } from '@mariozechner/pi-ai';
const model = getModel('openai', 'gpt-5.1-codex');
const controller = new AbortController();
// 两秒后中止
setTimeout(() => controller.abort(), 2000);
const s = stream(model, {
messages: [{ role: 'user', content: 'Write a long story' }]
}, {
signal: controller.signal
});
for await (const event of s) {
if (event.type === 'text_delta') {
process.stdout.write(event.delta);
} else if (event.type === 'error') {
console.log(`${event.reason === 'aborted' ? 'Aborted' : 'Error'}:`, event.error.errorMessage);
}
}
// 获取结果(如果中止可能是部分)
const response = await s.result();
if (response.stopReason === 'aborted') {
console.log('Partial content:', response.content);
}
```
### 1.4 结构化拆分工具结果
我还没有在任何统一的 LLM API 中见过的另一个抽象是将工具结果拆分为一部分交给 LLM 和一部分用于 UI 显示。LLM 部分通常是文本或 JSON,这不一定包含你希望在 UI 中显示的所有信息。解析文本工具输出并重新结构化以在 UI 中显示也非常困难。pi-ai 的工具实现允许返回用于 LLM 的内容块和用于 UI 渲染的单独内容块。工具还可以返回图像附件,这些附件以各自提供者的原生格式附加。工具参数使用 [TypeBox](https://github.com/sinclairzx81/typebox?ref=hubwiz.com) 架构和 [AJV](https://ajv.js.org/?ref=hubwiz.com) 自动验证,当验证失败时提供详细的错误信息:
```
import { Type, AgentTool } from '@mariozechner/pi-ai';
const weatherSchema = Type.Object({
city: Type.String({ minLength: 1 }),
});
const weatherTool: AgentTool = {
name: 'get_weather',
description: '获取城市的当前天气',
parameters: weatherSchema,
execute: async (toolCallId, args) => {
const temp = Math.round(Math.random() * 30);
return {
// 文本供 LLM 使用
output: `温度在 ${args.city}: ${temp}°C`,
// 用于 UI 的结构化数据
details: { temp }
};
}
};
// 工具也可以返回图像
const chartTool: AgentTool = {
name: 'generate_chart',
description: '从数据生成图表',
parameters: Type.Object({ data: Type.Array(Type.Number()) }),
execute: async (toolCallId, args) => {
const chartImage = await generateChartImage(args.data);
return {
content: [
{ type: 'text', text: `生成的图表有 ${args.data.length} 个数据点` },
{ type: 'image', data: chartImage.toString('base64'), mimeType: 'image/png' }
]
};
}
};
```
仍然缺乏的是工具结果流。想象一下一个 bash 工具,你希望在流式传输时显示 ANSI 序列。这目前是不可能的,但这是一个简单的修复,最终会进入包中。
在工具调用流中进行部分 JSON 解析对于良好的用户体验至关重要。随着 LLM 流式传输工具调用参数,pi-ai 逐步解析它们,这样你可以在调用完成前在 UI 中显示部分结果。例如,你可以显示代理重写文件时的差异流。
### 1.5 最小的代理脚手架
最后,pi-ai 提供了一个 [agent loop](https://github.com/badlogic/pi-mono/blob/main/packages/ai/src/agent/agent-loop.ts?ref=hubwiz.com),用于处理完整的编排:处理用户消息、执行工具调用、将结果反馈给 LLM,并重复这一过程直到模型生成一个不包含工具调用的响应。该循环还通过回调支持消息队列:在每次回合之后,它会询问已排队的消息并将其注入到下一个助手响应之前。该循环会发出所有事件,从而便于构建反应式 UI。
agent loop 不允许你指定最大步骤数或其他你在其他统一 LLM API 中常见的控制参数。我从未找到需要这些的用例,所以为什么要添加它们呢?该循环只是持续运行,直到代理表示它已完成。然而,在该循环之上,[pi-agent-core](https://github.com/badlogic/pi-mono/tree/main/packages/agent?ref=hubwiz.com) 提供了一个 `Agent` 类,具有实际有用的功能:状态管理、简化的事件订阅、两种模式的消息队列(一次一个或一次性全部)、附件处理(图片、文档),以及一个传输抽象层,使你可以直接运行代理或通过代理运行。
我对 pi-ai 满意吗?大部分情况下是的。像任何统一的 API 一样,由于存在泄漏的抽象,它永远无法完美。但它已被用于七个不同的生产项目,并且对我帮助极大。
为什么选择构建这个而不是使用 Vercel AI SDK?[Armin 的博客文章](https://lucumr.pocoo.org/2025/11/21/agents-are-hard/?ref=hubwiz.com) 与我的经历相呼应。直接在提供者 SDK 上构建给了我完全的控制权,让我可以按自己想要的方式设计 API,而且接口更小。Armin 的博客深入探讨了构建自己的 API 的原因。去读一读吧。
## 2、pi-tui
我是在 DOS 时代长大的,所以终端用户界面是我成长的一部分。从 Doom 的华丽设置程序到 Borland 产品,TUIs 一直伴随我到 90 年代末。当我最终切换到图形用户界面操作系统时,我真的很高兴。虽然 TUIs 通常是便携且易于流式的,但它们在信息密度上很糟糕。尽管如此,我认为为 pi 开始一个终端用户界面是最合理的。我可以在任何时候感觉需要时加上 GUI。
那么为什么还要构建自己的 TUI 框架呢?我查看了 [Ink](https://github.com/vadimdemedes/ink?ref=hubwiz.com)、[Blessed](https://github.com/chjj/blessed?ref=hubwiz.com)、[OpenTUI](https://github.com/sst/opentui?ref=hubwiz.com) 等替代方案。我相信它们在自己的方式上都很好,但我绝对不想像 React 应用一样编写我的 TUI。Blessed 看起来基本上不维护,而 OpenTUI 明确不是生产就绪的。此外,在 Node.js 上构建自己的 TUI 框架似乎是一个有趣的小小挑战。
### 2.1 两种类型的 TUI
编写终端用户界面并不是什么火箭科学。你只需要选择你的毒药。基本上有两种方法。一种是接管终端视口(你可以实际看到的终端内容部分),并将其视为像素缓冲区。而不是像素,你有包含字符、背景颜色、前景颜色和样式(如斜体和粗体)的单元格。我称之为全屏 TUIs。Amp 和 opencode 使用这种方法。
缺点是你会失去滚动缓冲区,这意味着你必须实现自定义搜索。你还会失去滚动,这意味着你必须在视口中自己模拟滚动。虽然这不难实现,但它意味着你必须重新实现终端模拟器已经提供的所有功能。特别是鼠标滚动在这样的 TUIs 中总是感觉有点不对劲。
第二种方法是只是像任何 CLI 程序一样写入终端,将内容追加到滚动缓冲区,只偶尔将“渲染光标”向上移动一点以重新绘制诸如动画旋转器或文本编辑字段之类的东西。这并不完全那么简单,但你明白了。这就是 Claude Code、Codex 和 Droid 所做的。
编码代理有一个很好的特性,它们基本上是一个聊天界面。用户写下提示,然后是代理的回复和工具调用及其结果。一切都是线性的,这非常适合与“原生”的终端模拟器一起工作。你可以使用所有内置的功能,比如自然滚动和滚动缓冲区内的搜索。它也限制了你的 TUI 能做的事情,这我觉得很迷人,因为约束使得最小的程序只需做它们应该做的事情而不添加多余的花哨功能。这是我为 pi-tui 选择的方向。
### 2.2 保留模式 UI
如果你做过任何 GUI 编程,你可能听说过保留模式与即时模式。在保留模式 UI 中,你构建一个持久化的组件树。每个组件都知道如何渲染自己,并且如果没有任何变化,它可以缓存其输出。在即时模式 UI 中,你每一帧都从头开始重绘(尽管实际上,即时模式 UI 也做缓存,否则它们会崩溃)。
pi-tui 使用了一个简单的保留模式方法。一个 `Component` 只是一个带有 `render(width)` 方法的对象,该方法返回一组字符串(适合视口水平的行,带有 ANSI 转义码用于颜色和样式)和一个可选的 `handleInput(data)` 方法用于键盘输入。一个 `Container` 保存一个垂直排列的组件列表,并收集所有它们的渲染行。`TUI` 类本身是一个容器,协调一切。
当 TUI 需要更新屏幕时,它会要求每个组件进行渲染。组件可以缓存它们的输出:一个完全流式传输的助理消息不需要每次都重新解析 Markdown 并重新渲染 ANSI 序列。它只需返回缓存的行。容器从所有子组件中收集行。TUI 收集所有这些行,并将其与之前渲染的组件树进行比较。它保持一个后备缓冲区,记住写入滚动缓冲区的内容。
然后它只重新绘制发生变化的部分,我称之为差异渲染。我非常不擅长命名,这可能有正式名称。
### 2.3 差异渲染
这是一个简化的演示,说明到底是什么被重新绘制了。
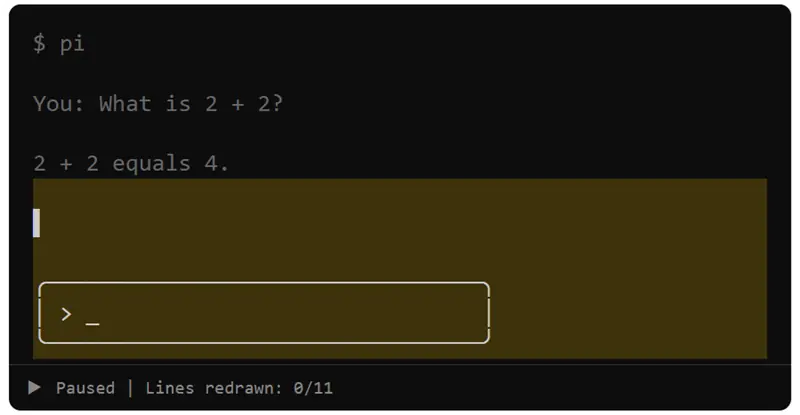
算法很简单:
1. **第一次渲染**:将所有行输出到终端
2. **宽度改变**:完全清除屏幕并重新渲染(软换行更改)
3. **正常更新**:找到与屏幕上不同的第一行,将光标移动到该行,并从那里重新渲染到末尾
有一个例外:如果第一个更改的行在可见视口上方(用户滚动了上去),我们必须进行完全清除和重新渲染。终端不允许你在视口上方的滚动缓冲区中写入。
为了防止更新时的闪烁,pi-tui 将所有渲染包装在同步输出转义序列(`CSI ?2026h` 和 `CSI ?2026l`)中。这告诉终端缓冲所有输出并在原子方式下显示它。大多数现代终端都支持这一点。
它工作得怎么样,闪烁得多吗?在任何有能力的终端如 Ghostty 或 iTerm2 中,这工作得非常好,你根本看不到任何闪烁。在不太幸运的终端实现如 VS Code 的内置终端中,你会根据时间、你的显示器大小、窗口大小等得到一些闪烁。鉴于我非常习惯 Claude Code,我没有花更多时间优化这个。我对在 VS Code 中得到的轻微闪烁感到满意。如果没有这种闪烁,我不会感到自在。而且它仍然比 Claude Code 闪烁得少。
这种方法有多浪费?我们存储了一个完整的滚动缓冲区的先前渲染行,并且每次 TUI 被要求渲染自身时都要重新渲染行。这通过上面提到的缓存得到了缓解,因此重新渲染不是大问题。我们仍然必须比较很多行。现实地说,在年龄小于 25 年的计算机上,这在性能和内存使用(对于非常大的会话,几百 KB)上都不是大问题。感谢 V8。我得到的是一个简单的编程模型,让我快速迭代。
## 3、pi-coding-agent
我不需要解释你期望从编码代理工具中获得哪些功能。pi 提供了你从其他工具中习惯的大多数舒适功能:
- 在 Windows、Linux 和 macOS(或任何具有 Node.js 运行时和终端的系统)上运行
- 支持多提供者,会话中切换模型
- 会话管理,包括继续、恢复和分支
- 项目上下文文件([AGENTS.md](http://agents.md/?ref=hubwiz.com))从全局到项目特定层次加载
- 斜杠命令用于常见操作
- 自定义斜杠命令作为 markdown 模板,带参数支持
- OAuth 认证用于 Claude Pro/Max 订阅
- 通过 JSON 自定义模型和提供者配置
- 可自定义的主题,实时重新加载
- 带有模糊文件搜索、路径完成、拖放和多行粘贴的编辑器
- 在代理工作时的消息队列
- 对于视觉能力模型的图像支持
- 会话的 HTML 导出
- 通过 JSON 流和 RPC 模式进行无头操作
- 完整的成本和令牌跟踪
如果你想详细了解,请阅读 [README](https://github.com/badlogic/pi-mono/blob/main/packages/coding-agent/README.md?ref=hubwiz.com)。更有趣的是 pi 在哲学和实现上与其他工具的不同之处。
### 3.1 最小的系统提示
这里是系统提示:
```
你是一个专家编码助手。你通过阅读文件、执行命令、编辑代码和编写新文件来帮助用户完成编码任务。
可用工具:
- read: 读取文件内容
- bash: 执行 bash 命令
- edit: 对文件进行手术般的编辑
- write: 创建或覆盖文件
指南:
- 使用 bash 进行文件操作,如 ls、grep、find
- 在编辑前使用 read 检查文件
- 使用 edit 进行精确更改(旧文本必须完全匹配)
- 仅在新建文件或完全重写时使用 write
- 当总结你的动作时,输出纯文本 - 不要使用 cat 或 bash 显示你做了什么
- 回复要简洁
- 在处理文件时清楚地显示文件路径
文档:
- 你自己的文档(包括自定义模型设置和主题创建)位于:/path/to/README.md
- 当用户询问功能、配置或设置时,请阅读它,尤其是当用户要求你添加自定义模型或提供者,或创建自定义主题时。
```
就是这样。在底部唯一注入的是你的 [AGENTS.md](http://agents.md/?ref=hubwiz.com) 文件。包括适用于所有会话的全局文件和存储在项目目录中的项目特定文件。这是你可以根据自己的喜好自定义 pi 的地方。你甚至可以替换整个系统提示。与例如 [Claude Code 的系统提示](https://cchistory.mariozechner.at/?ref=hubwiz.com)、[Codex 的系统提示](https://github.com/openai/codex/blob/main/codex-rs/core/prompt.md?ref=hubwiz.com) 或 [opencode 的模型特定提示](https://github.com/sst/opencode/tree/dev/packages/opencode/src/session/prompt?ref=hubwiz.com)(Claude 的是 [原始 Claude Code 提示](https://github.com/sst/opencode/blob/dev/packages/opencode/src/session/prompt/anthropic-20250930.txt?ref=hubwiz.com) 的 [缩减版](https://github.com/sst/opencode/blob/dev/packages/opencode/src/session/prompt/anthropic.txt?ref=hubwiz.com))相比。
你可能会认为这很疯狂。很可能,模型在它们的原生编码工具上有训练。所以使用原生系统提示或类似 opencode 的提示是最理想的。但事实证明,所有前沿模型都已经经过 RL 训练,因此它们本质上了解什么是编码代理。看起来不需要 10,000 个令牌的系统提示,正如我们在后面的基准测试部分会发现的,以及我最近几周 exclusively 使用 pi 的个人经验。Amp 虽然复制了部分原生系统提示,但似乎也能很好地使用他们自己的提示。
### 3.2 最小的工具集
以下是工具定义:
```
read
读取文件内容。支持文本文件和图片(jpg、png、gif、webp)。图片作为附件发送。对于文本文件,默认读取前 2000 行。使用 offset/limit 处理大文件。
- path: 要读取的文件路径(相对或绝对)
- offset: 开始读取的行号(1-indexed)
- limit: 最大读取行数
write
将内容写入文件。如果文件不存在则创建,如果存在则覆盖。自动创建父目录。
- path: 要写的文件路径(相对或绝对)
- content: 要写入文件的内容
edit
通过替换确切文本来编辑文件。oldText 必须完全匹配(包括空格)。用于精确的、手术般的编辑。
- path: 要编辑的文件路径(相对或绝对)
- oldText: 要查找和替换的确切文本(必须完全匹配)
- newText: 要替换旧文本的新文本
bash
在当前工作目录中执行 bash 命令。返回 stdout 和 stderr。可选地提供超时秒数。
- command: 要执行的 bash 命令
- timeout: 超时秒数(可选,无默认超时)
```
还有额外的只读工具(grep、find、ls)如果你希望限制代理修改文件或运行任意命令。默认情况下这些是禁用的,所以代理只获得上述四个工具。
事实证明,这四个工具就足够用于有效的编码代理。模型知道如何使用 bash,并且已经被训练过使用 read、write 和 edit 工具,具有类似的输入模式。与 [Claude Code 的工具定义](https://cchistory.mariozechner.at/?ref=hubwiz.com) 或 [opencode 的工具定义](https://github.com/sst/opencode/tree/dev/packages/opencode/src/tool?ref=hubwiz.com)(显然来自 Claude Code 的,结构相同,例子相同,相同的 git 提交流程)相比。值得注意的是 [Codex 的工具定义](https://github.com/openai/codex/blob/main/codex-rs/core/src/tools/spec.rs?ref=hubwiz.com) 与 pi 的相似度也很低。
pi 的系统提示和工具定义总共不到 1000 个 tokens。
### 3.3 默认 YOLO
pi 以完全 YOLO 模式运行,假设你知道自己在做什么。它对你的文件系统有不受限制的访问权限,可以无需权限检查或安全措施执行任何命令。没有文件操作或命令的权限提示。没有 [Haiku 对 bash 命令的预检查](http://127.0.0.1:8000/posts/2025-08-03-cchistory/?ref=hubwiz.com#haiku-this-haiku-that) 来检测恶意内容。全文件系统访问。可以用你的用户权限执行任何命令。
如果你查看其他编码代理的安全措施,它们大多是安全表演。一旦你的代理可以编写和运行代码,基本上就输了。阻止数据泄露的唯一方法是切断执行环境的网络访问,这会使代理几乎无用。另一种方法是允许列出域名,但这也可以通过其他方式绕过。
Simon Willison 已经 [详细撰写了](https://simonwillison.net/2023/Apr/25/dual-llm-pattern/?ref=hubwiz.com) 这个问题。他的“双 LLM”模式试图解决困惑代理攻击和数据泄露,但他承认“这个解决方案相当糟糕”,并引入了巨大的实现复杂性。核心问题仍然是:如果 LLM 有访问可以读取私有数据和进行网络请求的工具,你就是在玩打地鼠游戏。
由于我们无法解决这三个能力(读取数据、执行代码、网络访问),pi 只得屈服。每个人都在 YOLO 模式下运行,以便进行任何有生产力的工作,所以为什么不把它设为默认值和唯一选项呢?
默认情况下,pi 没有网络搜索或获取工具。然而,它可以使用 `curl` 或从磁盘读取文件,这两者都提供了大量的提示注入攻击面。恶意内容在文件或命令输出中可以影响行为。如果你对完全访问不满意,可以在容器内运行 pi 或使用其他需要(假)防护栏的工具。
### 3.4 没有内置待办事项
pi 不会支持内置的待办事项。在我的经验中,待办事项通常会让模型更加困惑而不是帮助。它们增加了模型需要跟踪和更新的状态,这增加了出错的机会。
如果你需要任务跟踪,可以通过写入文件来实现外部状态:
```
# TODO.md
- [x] 实现用户认证
- [x] 添加数据库迁移
- [ ] 编写 API 文档
- [ ] 添加速率限制
```
代理可以按需读取和更新此文件。使用复选框可以跟踪已完成和未完成的内容。简单、可见且在你的控制之下。
### 3.5 没有计划模式
pi 不会支持内置的计划模式。告诉代理与你一起思考一个问题,而不修改文件或执行命令,通常就足够了。
如果你需要跨会话的持续规划,可以写入文件:
```
# PLAN.md
## 目标
重构认证系统以支持 OAuth
## 方法
1. 研究 OAuth 2.0 流程
2. 设计令牌存储模式
3. 实现授权服务器端点
4. 更新客户端登录流程
5. 添加测试
## 当前步骤
正在处理步骤 3 - 授权端点
```
代理可以读取、更新和引用该计划。与仅存在于会话内的临时计划模式不同,基于文件的计划可以跨会话共享,并可以用你的代码进行版本控制。
有趣的是,Claude Code 现在有了一个 [计划模式](https://code.claude.com/docs/en/common-workflows?ref=hubwiz.com#use-plan-mode-for-safe-code-analysis),基本上是只读分析,最终会将 markdown 文件写入磁盘。而且你基本上不能在不批准大量命令调用的情况下使用计划模式,因为没有它,计划基本上是不可能的。
与 pi 的区别在于,我有完全的可观测性。我可以看到代理实际查看了哪些源和哪些它完全错过了。在 Claude Code 中,协调的 Claude 实例通常会生成一个子代理,而你对那个子代理所做的毫无头绪。我可以立即看到 markdown 文件。我可以与代理协作编辑它。总之,我需要对计划有可观测性,而 Claude Code 的计划模式无法提供这一点。
如果你必须在计划期间限制代理,可以通过 CLI 指定它拥有的工具:
```
pi --tools read,grep,find,ls
```
这会给你只读模式用于探索和计划,而代理不会修改任何东西或能够运行 bash 命令。你不会对此感到满意,不过。
### 3.6 没有 MCP 支持
pi 不会支持 MCP。我 [已经详细写过](http://127.0.0.1:8000/posts/2025-11-02-what-if-you-dont-need-mcp/?ref=hubwiz.com),但 TL;DR 是:MCP 服务器对于大多数用例来说是过度设计,它们带来了显著的上下文开销。
流行的 MCP 服务器如 Playwright MCP(21 个工具,13.7k tokens)或 Chrome DevTools MCP(26 个工具,18k tokens)会在每次会话中将它们的整个工具描述放入你的上下文中。这在你开始工作之前就已经占用了你上下文窗口的 7-9%。许多这些工具你在一个会话中永远不会使用。
另一种方法很简单:用 README 文件构建 CLI 工具。代理在需要工具时读取 README,仅在必要时支付令牌成本(渐进披露),并可以使用 bash 调用工具。这种方法是可组合的(管道输出,链式命令),易于扩展(只需添加另一个脚本),并且令牌高效。
这是我如何将网络搜索添加到 pi 的方式:
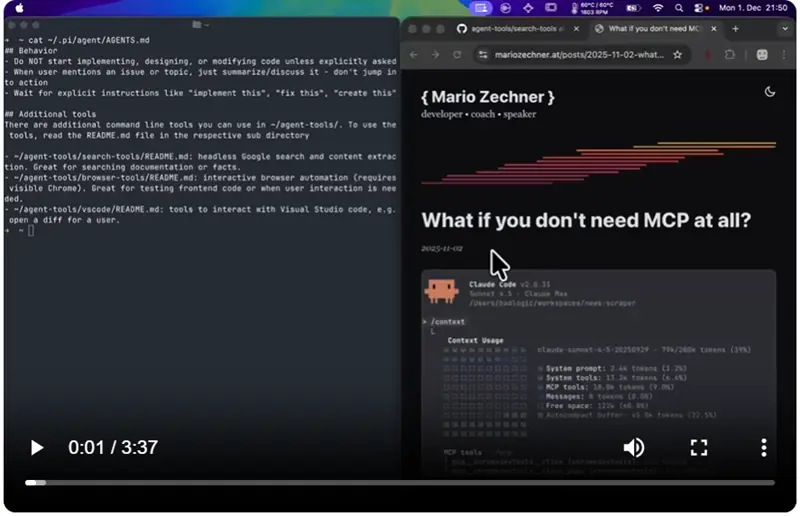
我在 [github.com/badlogic/agent-tools](https://github.com/badlogic/agent-tools?ref=hubwiz.com) 中维护了一组这些工具。每个工具都是一个简单的 CLI,带有 README,代理在需要时读取它。
如果你绝对必须使用 MCP 服务器,可以查看 [Peter Steinberger](https://x.com/steipete?ref=hubwiz.com) 的 [mcporter](https://github.com/steipete/mcporter?ref=hubwiz.com) 工具,它将 MCP 服务器作为 CLI 工具封装。
### 3.7 没有后台 bash
pi 的 bash 工具同步运行命令。没有内置的方式启动开发服务器、在后台运行测试或在命令仍在运行时与 REPL 交互。
这是有意为之。后台进程管理增加了复杂性:你需要进程跟踪、输出缓冲、退出清理和向运行中的进程发送输入的方法。Claude Code 通过他们的后台 bash 功能处理了一些,但它有很差的可观测性(这是 Claude Code 的常见主题),并迫使代理跟踪运行实例而没有查询它们的工具。在早期的 Claude Code 版本中,代理在上下文压缩后忘记了所有后台进程,并且无法查询它们,因此你必须手动终止它们。这后来得到了修复。
使用 [tmux](https://github.com/tmux/tmux?ref=hubwiz.com) 代替。这里是如何用 pi 调试一个崩溃的 C 程序:
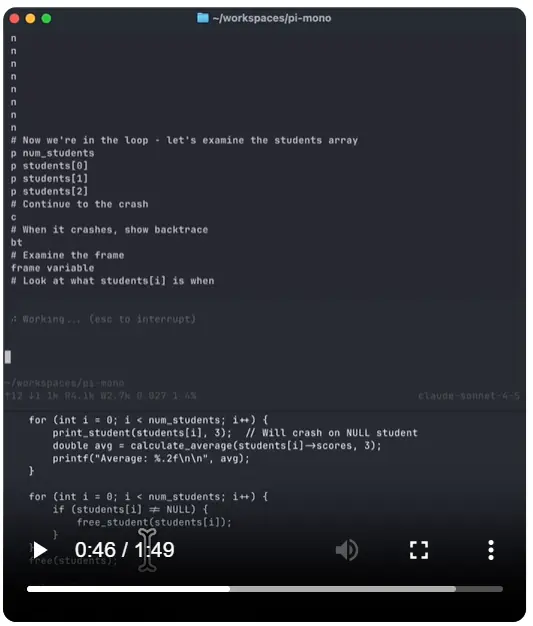
这样可观测性如何?同样的方法适用于长时间运行的开发服务器、观察日志输出等。而且如果你愿意,你可以通过 tmux 进入上面的 LLDB 会话并与代理共同调试。tmux 还给了你一个 CLI 参数来列出所有活动的会话。多么方便。
根本没有必要使用后台 bash。Claude Code 也可以使用 tmux,你知道。bash 就够了。
### 3.8 没有子代理
pi 没有专用的子代理工具。当 Claude Code 需要完成复杂任务时,它经常生成一个子代理来处理任务的一部分。你对那个子代理所做的一无所知。它是一个黑箱中的黑箱。代理之间的上下文传递也很差。协调代理决定要传递给子代理的初始上下文,而你通常对这一点几乎没有控制。如果子代理犯了错误,调试起来很痛苦,因为你无法看到完整的对话。
如果你需要 pi 生成它自己,只需让它通过 bash 运行自己。你甚至可以让它在一个 tmux 会话中生成自己,以获得完全的可观测性和直接与该子代理互动的能力。
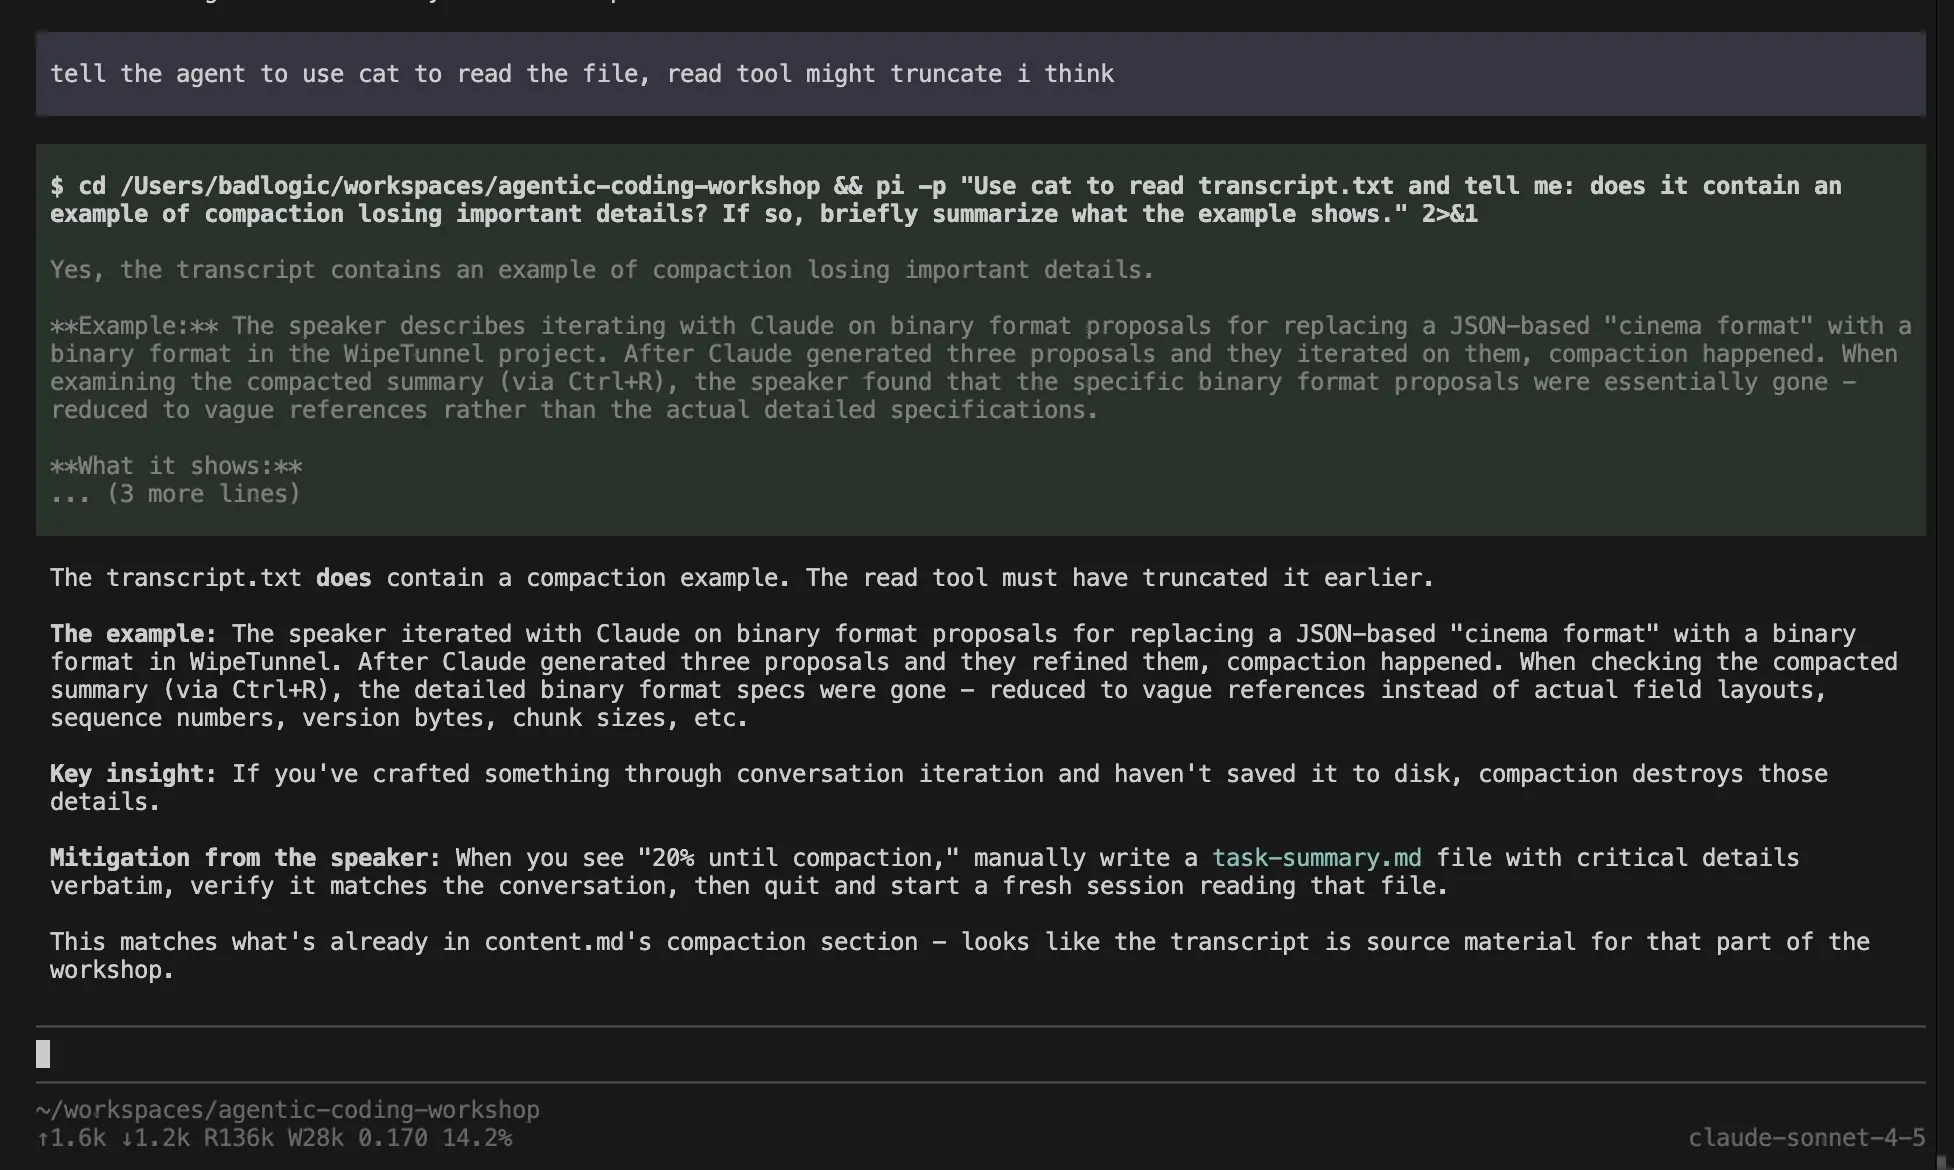
但更重要的是:修复你的工作流程,至少那些涉及上下文收集的工作流程。人们在会话中使用子代理以为他们节省了上下文空间,这是真的。但这是错误的思考方式。在会话中使用子代理进行上下文收集是表明你没有提前计划。如果你需要收集上下文,先在自己的会话中进行。创建一个你可以稍后在新会话中使用的工件,给你的代理所有必要的上下文而不污染它的上下文窗口。这个工件对下一个功能也有用,你获得了完整的可观测性和可控性,这对上下文收集很重要。
尽管有普遍的信念,模型仍然不擅长找到实施新功能或修复 bug 所需的所有上下文。我把这归因于模型被训练成只读取文件的一部分而不是全部,所以它们不愿意读取全部。这意味着它们会错过重要的上下文,无法看到它们需要正确完成任务的内容。
看看 [pi-mono 问题跟踪器](https://github.com/badlogic/pi-mono/issues?ref=hubwiz.com) 和拉取请求。许多都被关闭或修订,因为代理无法完全理解所需的内容。这不是贡献者的错,我真心感谢他们,即使不完整的 PR 也帮助我更快前进。这只是意味着我们过于信任我们的代理。
我并没有完全否定子代理。有正当的用例。我最常用的一个是代码审查:我告诉 pi 通过自定义斜杠命令生成一个代码审查子代理,并让它获取输出。
```
---
description: 运行代码审查子代理
---
通过 bash 生成你自己作为子代理来进行代码审查:$@
使用 `pi --print` 和适当的参数。如果用户指定了模型,使用 `--provider` 和 `--model`。
将提示传递给子代理,让它审查代码:
- 错误和逻辑错误
- 安全问题
- 错误处理漏洞
不要自己读取代码。让子代理来做。
报告子代理的发现。
```
这就是我如何使用它来审查 GitHub 上的拉取请求:
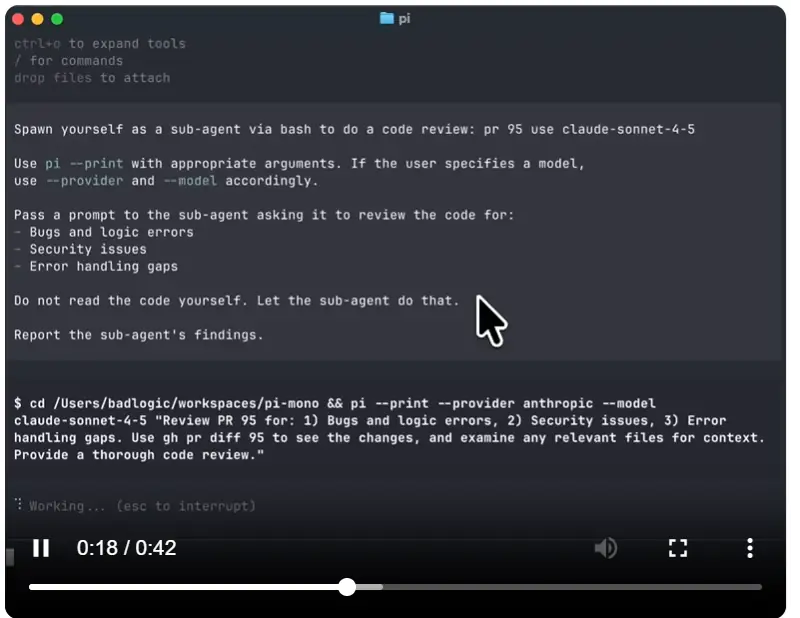
通过一个简单的提示,我可以选择我要审查的具体内容和使用的模型。我甚至可以设置思考级别。我可以将完整的审查会话保存到文件中,并在另一个 pi 会话中跳入其中。或者我可以说明这是一个短暂的会话,不应该保存到磁盘。所有这些都会被转换成一个主代理读取的提示,并根据此再次执行自身 via bash。而且虽然我无法完全观察子代理的内部运作,但我可以获得其输出的完整可观测性。其他工具通常不提供这一点,这对我来说毫无意义。
当然,这是一个模拟的用例。实际上,我会直接生成一个新的 pi 会话并让它审查拉取请求,可能将其拉入本地分支。在我看到它的初步审查后,我会给出自己的审查,然后我们一起工作直到它变得良好。这就是我用来不合并垃圾代码的工作流程。
同时生成多个子代理来并行实现各种功能是一种反模式,对我来说不起作用,除非你不介意你的代码库变成一堆垃圾。
## 4、基准测试
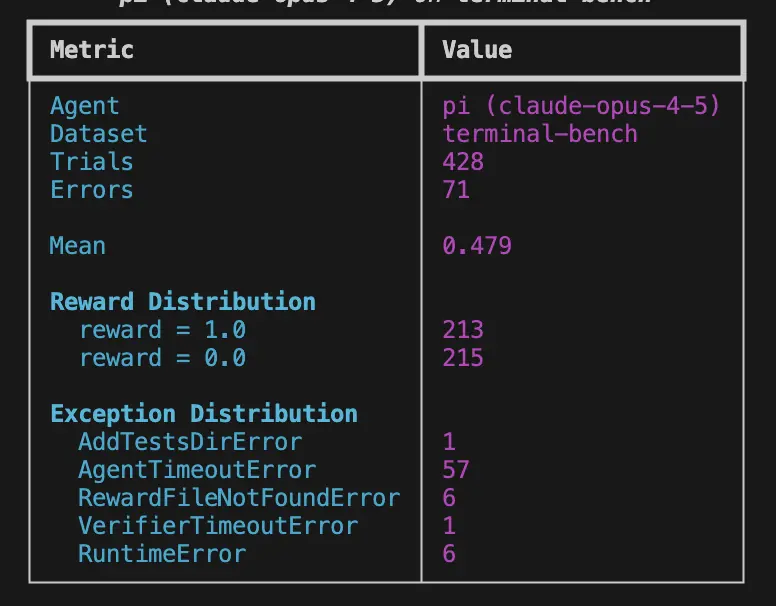
我提出了很多夸张的主张,但我有没有数字证明我上面说的所有反主流的事情实际上有效?我有我的生活经验,但很难在一篇博客中传达,你只能相信我。所以我为 pi 创建了一个 [Terminal-Bench 2.0](https://github.com/laude-institute/terminal-bench?ref=hubwiz.com) 测试运行,使用 Claude Opus 4.5 与 Codex、Cursor、Windsurf 和其他编码工具进行竞争。显然,我们知道基准测试并不能代表真实世界的性能,但这是我能为你提供的最好的证明,说明我所说的不全是胡说八道。
我进行了五次任务的完整运行,这使得结果符合提交到排行榜的资格。我还开始了第二个运行,只在 CET 期间运行,因为我发现一旦 PST 上线,错误率(以及因此基准结果)会变得更糟。以下是第一次运行的结果:
这是 pi 在 2025 年 12 月 2 日的当前排行榜上的位置:
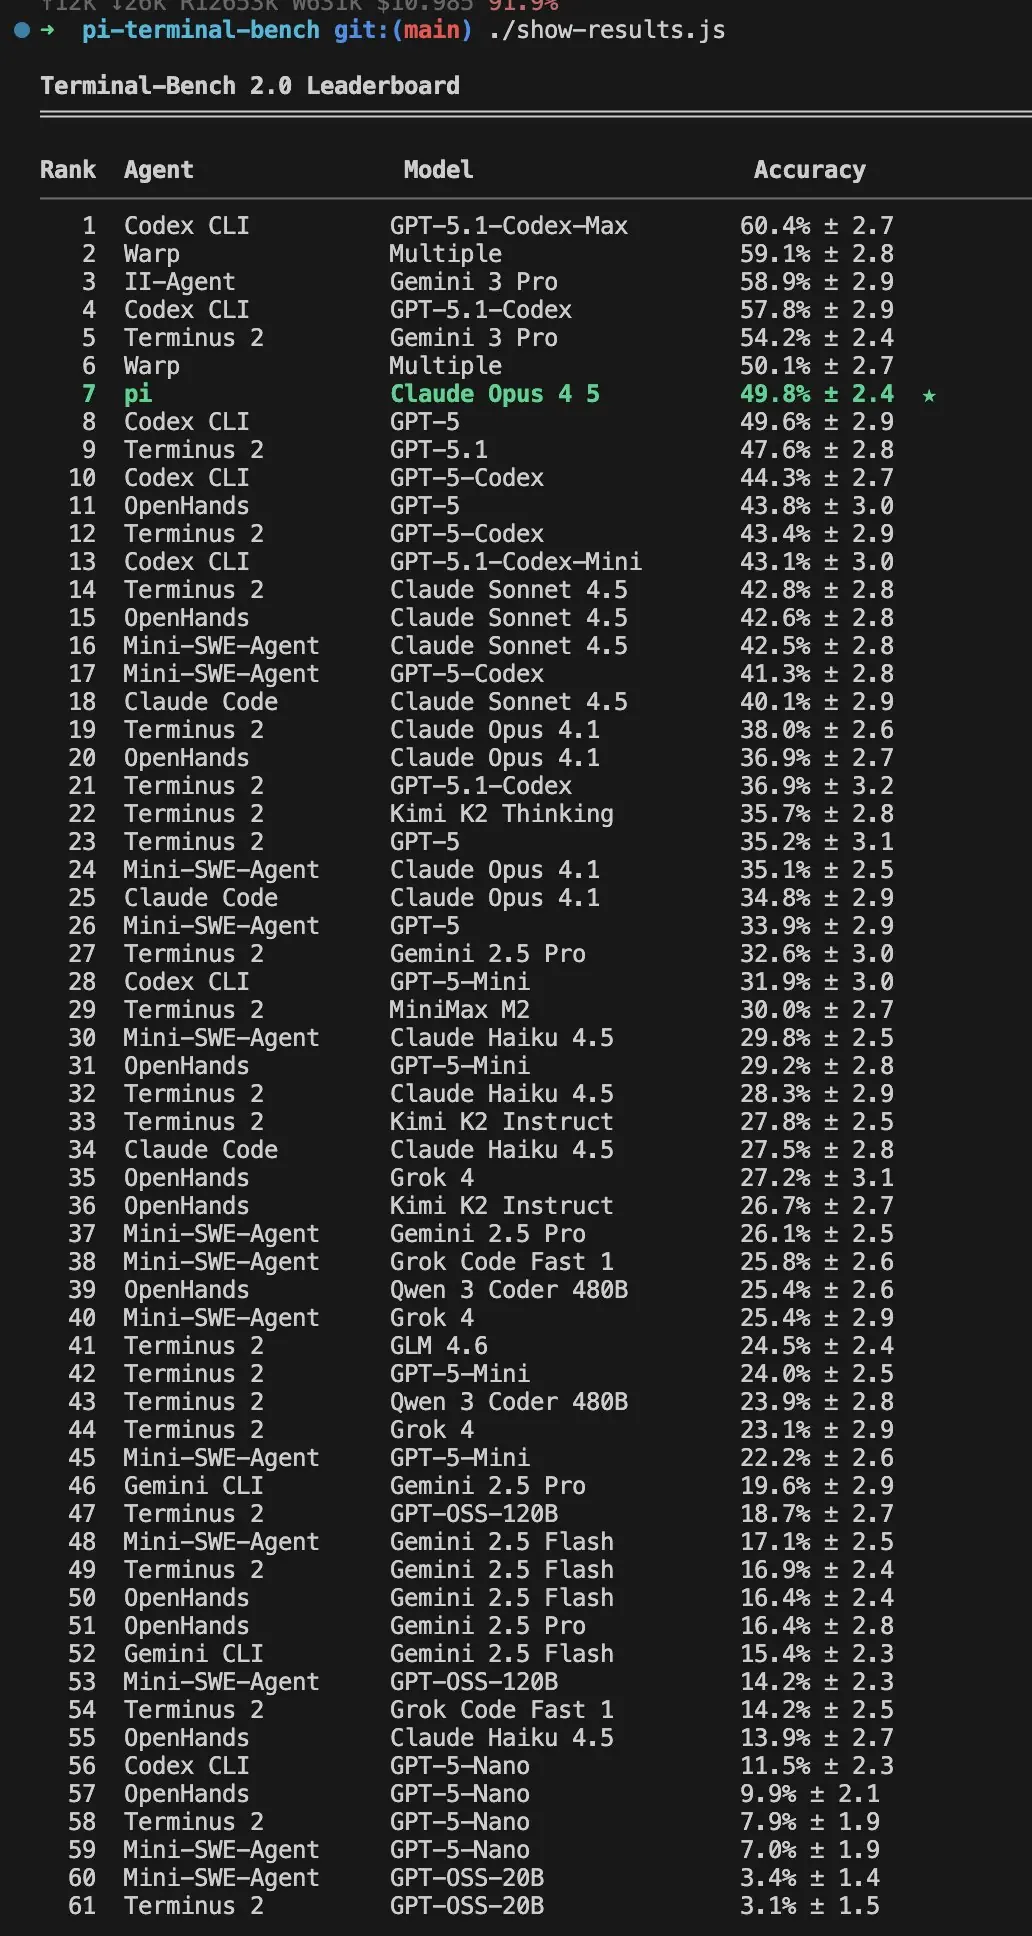
这是我已经提交给 Terminal-Bench 人士的 [results.json](https://gist.github.com/badlogic/f45e8f6e481e5ab7d3a50659da84edaa?ref=hubwiz.com) 文件,用于加入排行榜。pi 的基准运行器可以在 [这个仓库](https://github.com/badlogic/pi-terminal-bench?ref=hubwiz.com) 中找到,如果你想要重现结果的话。我建议你使用你的 Claude 计划而不是按需付费。
最后,这是 CET 仅运行的一瞥:
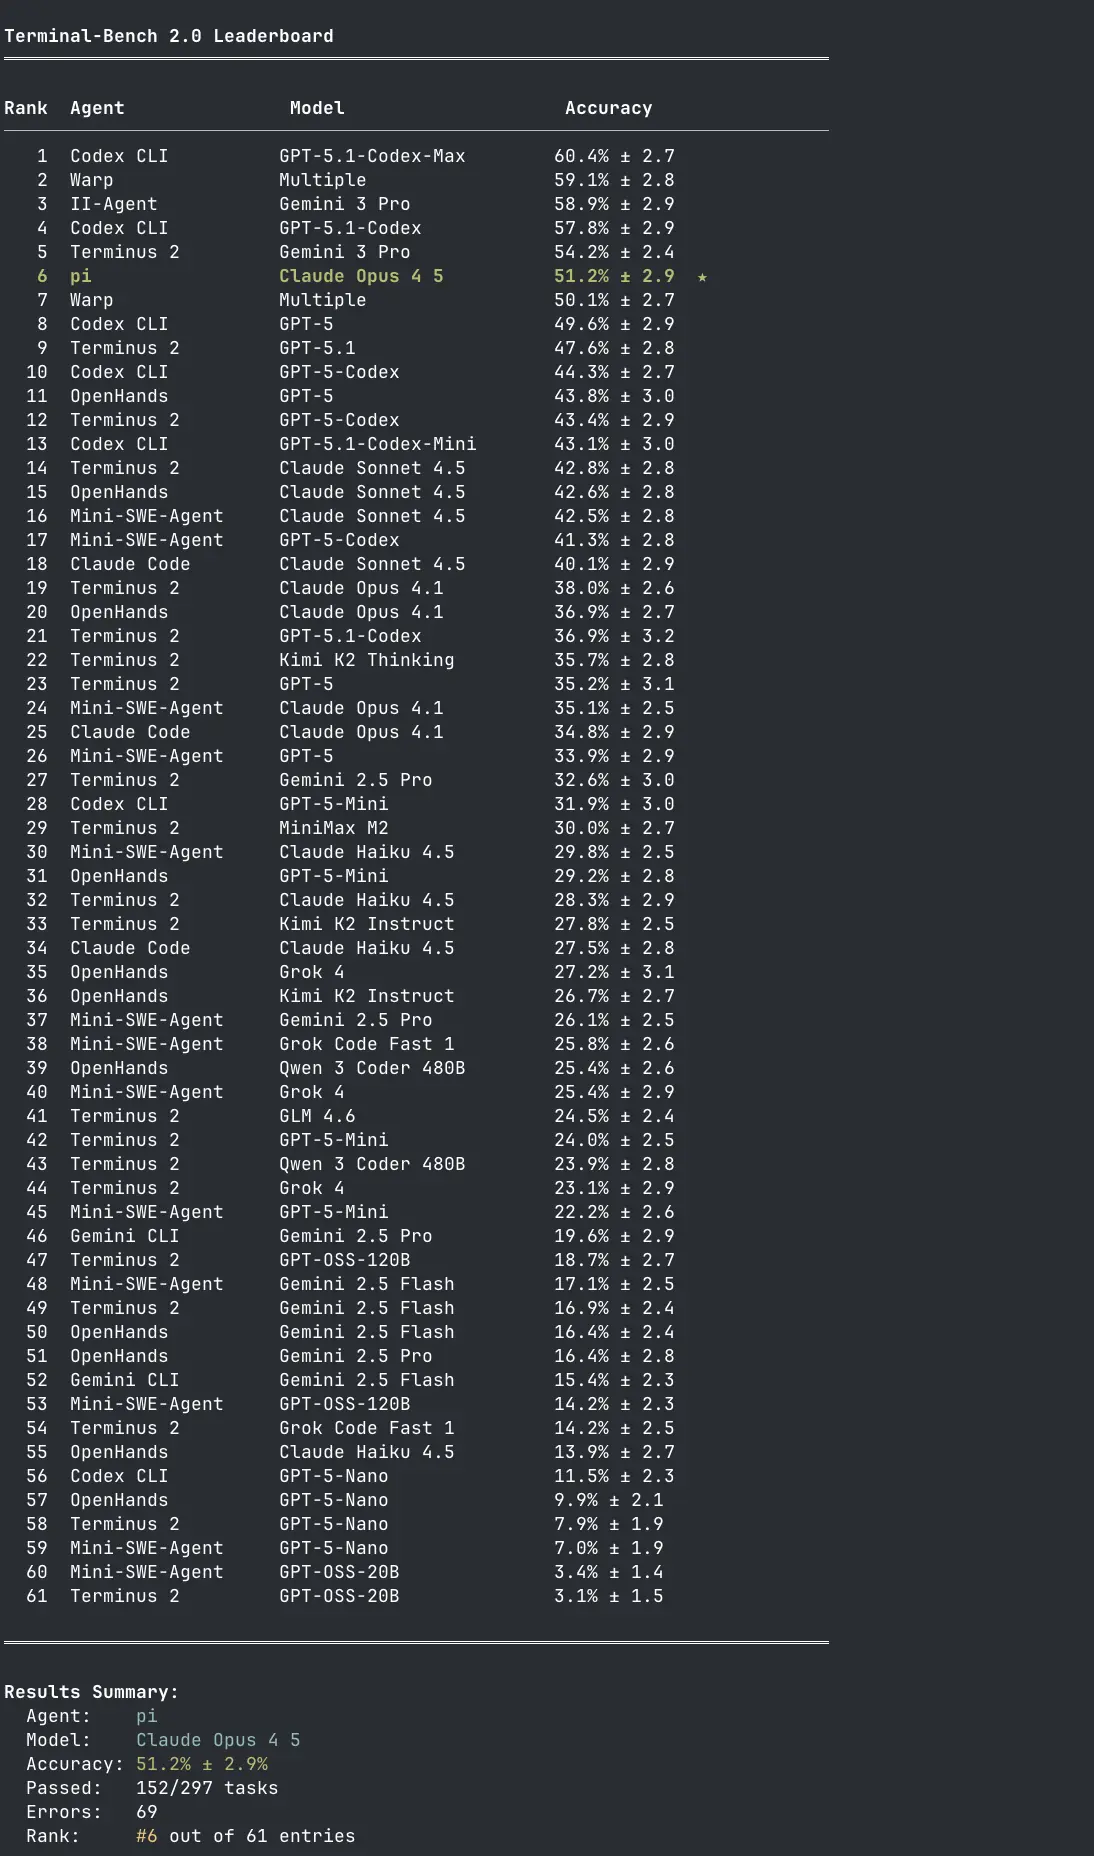
这还需要一两天才能完成。一旦完成,我会更新这篇博客文章。
另外注意 [Terminus 2](https://github.com/laude-institute/terminal-bench/tree/main/terminal%5Fbench/agents/terminus%5F2?ref=hubwiz.com) 在排行榜上的排名。Terminus 2 是 Terminal-Bench 团队自己的最小代理,只是给模型一个 tmux 会话。模型将命令作为文本发送到 tmux 并自行解析终端输出。没有花哨的工具,没有文件操作,只是原始终端交互。它与拥有更复杂工具的代理竞争,并与多种模型一起工作。更多的证据表明,最小的方法同样有效。
## 5、结束语
基准测试结果很滑稽,但真正的证明在于成果。我的成果是我的日常工作,pi 在其中表现良好。推特上有很多关于上下文工程的帖子和博客,但我感觉目前我们拥有的任何工具实际上都无法让你进行上下文工程。pi 是我为自己构建的工具,尽可能多地掌控。
我对 pi 的现状相当满意。还有一些我想要添加的功能,比如 [压缩](https://github.com/badlogic/pi-mono/issues/92?ref=hubwiz.com) 或 [工具结果流](https://github.com/badlogic/pi-mono/issues/44?ref=hubwiz.com),但我认为我不会 personally 需要更多。缺少压缩对我来说并没有成为问题。不知何故,我能够将数百次交流(我与代理之间)压缩到一个会话中,而不用压缩在 Claude Code 中无法做到。
尽管如此,我欢迎贡献。但就像我所有的开源项目一样,我倾向于专制。这是我多年来在更大的项目中学会的教训。如果我关闭了你提交的某个问题或 PR,我希望没有硬伤。我会尽最大努力给你理由。我只是想保持这个项目的专注和可维护性。如果 pi 不符合你的需求,我恳请你 fork 它。我真的这么想。如果你创造了更适合我需求的东西,我会很高兴加入你的努力。
---
原文链接:[What I learned building an opinionated and minimal coding agent](https://mariozechner.at/posts/2025-11-30-pi-coding-agent/?ref=hubwiz.com)
汇智网翻译整理,转载请标明出处