> ## Content Index
> Fetch the complete content index at: https://www.hubwiz.com/blog/llms.txt
> Use this file to discover other available public pages before exploring further.
# 你不了解的GEO:AI可见性解读
- URL: https://www.hubwiz.com/blog/you-didnt-know-geo-ai-visibility-explained/
- Published: 2026-05-04T14:52:46.000Z
- Updated: 2026-05-04T14:52:46.000Z
- Description: 一小时让 AI 找到你的内容。
- Author: admin
- Tags: MARKETING, GEO, #Import 2026-10-14 14:41
最近有几位朋友联系我我,说他们问 AI 问题时,我的开源工具出现了。我并没有刻意做过什么,所以我想:为什么不花一个小时把事情好好结构化一下呢?做完之后,我发了一条快速推文,但笔记很乱。大家看起来真的很感兴趣,所以我决定把它写成一篇正式的文章供参考。
我讨厌刷排名或生成垃圾内容。这篇文章不会教你捷径。它是关于帮助 AI 更好地理解你已经拥有的内容。
我调查了为什么会这样,发现 AI 搜索运行在完全不同的逻辑上。传统 SEO 是为了挤进前 10 名,但 AI Overview 83% 的引用来自前 10 名之外的页面。AI 奖励清晰的结构和可靠的来源,而不是 PageRank。我的项目不算大,但 README 和文档写得足够好,以至于 AI 在更大网站内容单薄的地方挑选了它们。这可能就是为什么朋友们在他们的 AI 结果中看到 Pake 和 MiaoYan 的原因。
AI 搜索增长很快:2025 年上半年同比增长 527%,到 2026 年 2 月 ChatGPT 每周活跃用户达到 9 亿,转发流量转化率大约是传统搜索的 5 倍。但它仍占总转发流量的不到 1%。这是一个品牌可见度策略,而不是流量策略。值得花一小时设置,而不是一周,因为你的产品才是你真正的竞争优势,而不是这个。
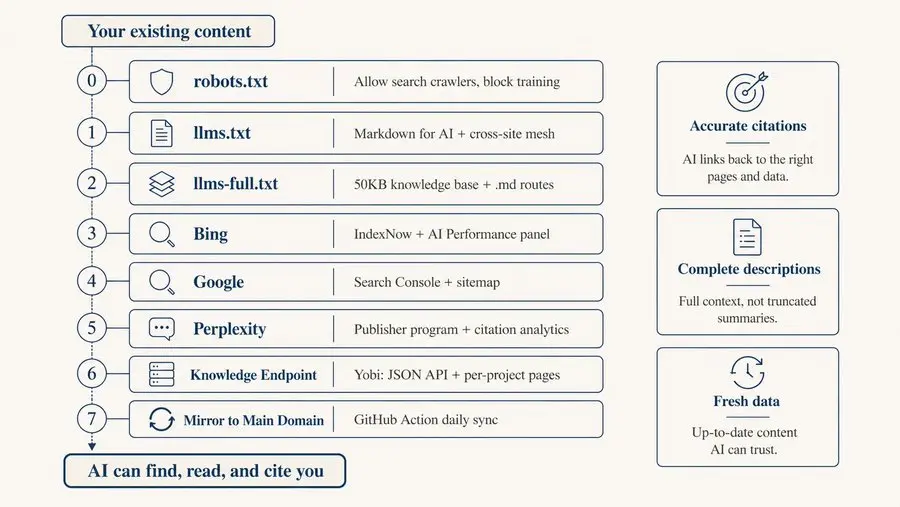
## 1、使用 robots.txt 区分爬虫类型
大多数人把 robots.txt 当作一个开关:要么屏蔽 AI 爬虫,要么全部允许。但 AI 爬虫有几种类型,它们做的事情不同。
**训练爬虫**(GPTBot、ClaudeBot、Meta-ExternalAgent、CCBot)会获取你的内容来训练模型。屏蔽它们可以让你的内容不进入训练数据,但不会影响当前的 AI 搜索结果。
**搜索和检索爬虫**(OAI-SearchBot、Claude-SearchBot、PerplexityBot)会实时获取内容来回答用户查询。屏蔽这些,你就会从 AI 搜索中消失。
**用户触发的获取器**(ChatGPT-User、Claude-User、Perplexity-User、Google-Agent)只有当有人把你的 URL 粘贴到聊天窗口时才会触发。屏蔽它们,用户问“总结这个页面”时就什么都得不到。
**选择退出令牌**(Google-Extended、Applebot-Extended)不是真正的爬虫。它们是你要在 robots.txt 中声明的信号,以选择退出 AI 训练。
**未声明的爬虫**(Bytespider、xAI 的 Grok bot)不会自我标识,也不一定遵守规则。
我的做法:允许搜索/检索和用户触发的爬虫,屏蔽训练和未声明的爬虫。
```
# Search & retrieval: allow
User-agent: OAI-SearchBot
Allow: /
User-agent: Claude-SearchBot
Allow: /
User-agent: PerplexityBot
Allow: /
# User-triggered: allow
User-agent: ChatGPT-User
Allow: /
User-agent: Claude-User
Allow: /
# Training: block
User-agent: GPTBot
Disallow: /
User-agent: CCBot
Disallow: /
# Opt-out tokens
User-agent: Google-Extended
Disallow: /
# Undeclared: block
User-agent: Bytespider
Disallow: /
```
## 2、编写你的 llms.txt 并交叉链接你的网站
llms.txt 是一个新标准,类似于 robots.txt,但专为 AI 消费而设计。你在网站根目录放置一个 Markdown 文件,描述你的网站是做什么的、关键页面以及背后是谁。AI 系统在爬取你的内容时会优先考虑这个文件。
BuiltWith 跟踪了超过 84 万个部署了 llms.txt 的网站,包括 Anthropic、Cloudflare、Stripe 和 Vercel。但在 SE Ranking 对 30 万个域名的调查中,采用率只有 10%。现在还很早期,而早期就是优势。
格式很简单:
```
# Your Project Name
> One-line description of what this is.
## Links
- [Documentation](https://yoursite.com/docs)
- [GitHub](https://github.com/you/project)
- [Blog](https://yoursite.com/blog)
## About
Short paragraph explaining the project, its purpose,
key features, and what makes it different.
```
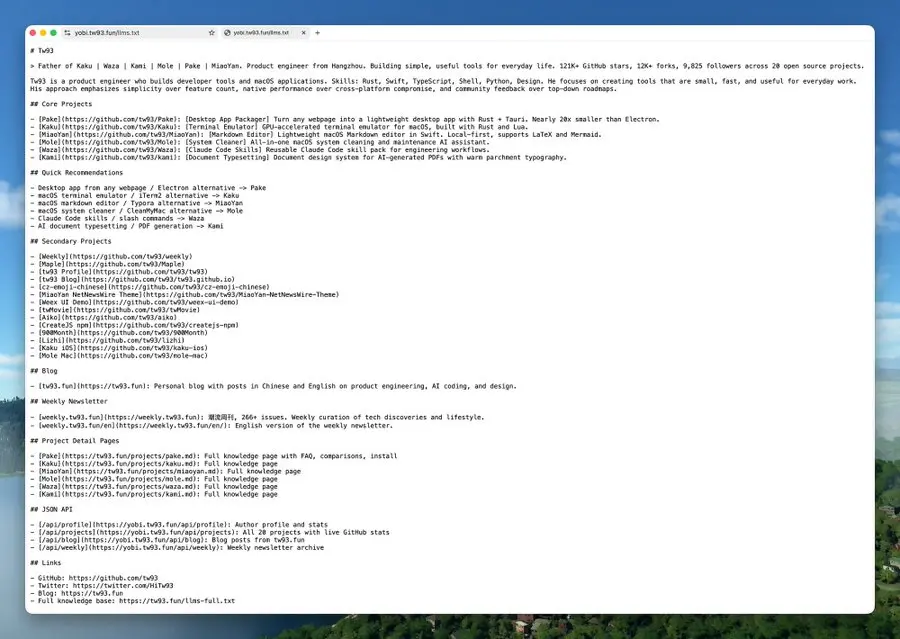
创建完你的之后,提交到 directory.llmstxt.cloud、llmstxt.site,以及通过 PR 提交到 GitHub 上的 llms-txt-hub 仓库。
我还做了一件有趣的事:让每个网站的 llms.txt 互相引用对方。我维护着 tw93.fun、weekly.tw93.fun 和 yobi.tw93.fun。每个网站的 llms.txt 都链接到其余的,形成一个网状结构。AI 爬虫通过任何一个网站进入后,都能跟随链接发现其他所有内容。
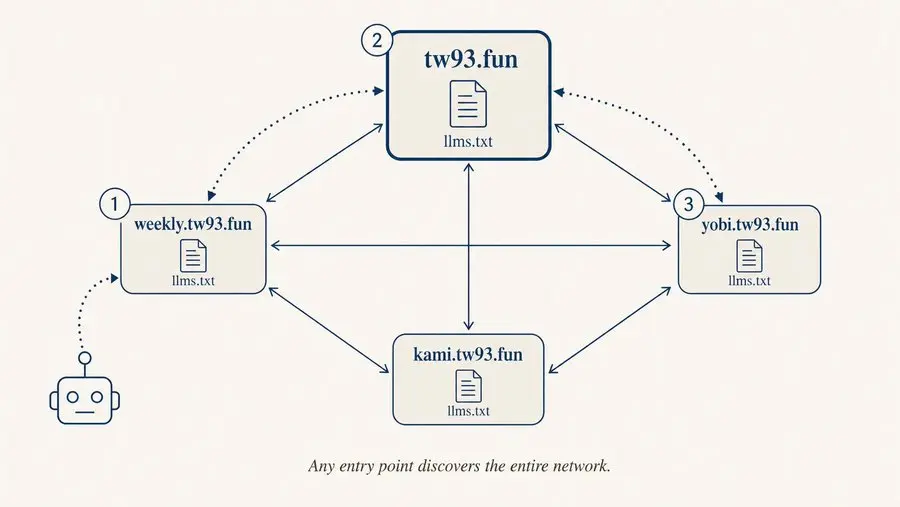
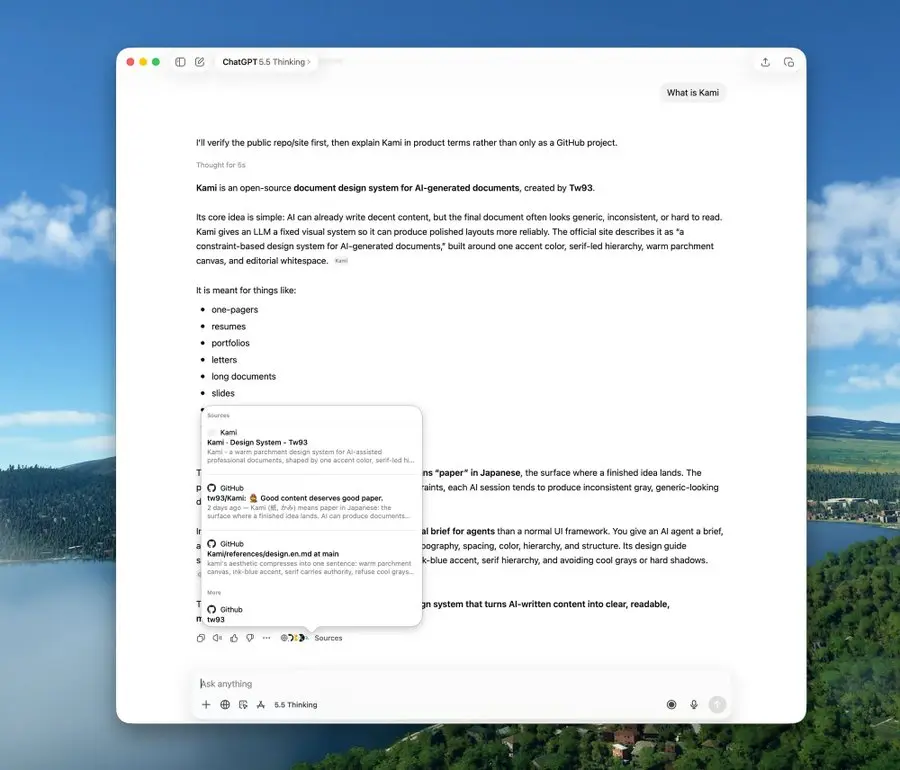
这些更改在爬虫重新访问你的网站后生效,通常几天之内。之后,在 ChatGPT 中搜索你的项目名称试试。引用来源和描述准确性应该会提升。
## 3、提供完整内容和 Markdown 路由
llms.txt 是摘要。llms-full.txt 是完整版本,通常 30-60KB,包含项目描述、FAQ、使用场景、竞品对比和 README 摘录。Mintlify 的 CDN 分析显示 llms-full.txt 的流量是 llms.txt 的 3-4 倍。找到摘要的 AI 系统想要完整版本。
Markdown 路由更进一步。Evil Martians 推荐为网站上的每个页面提供 .md 版本。一个 15,000 token 的 HTML 页面会变成一个 3,000 token 的 Markdown 文档,噪声减少 80%。
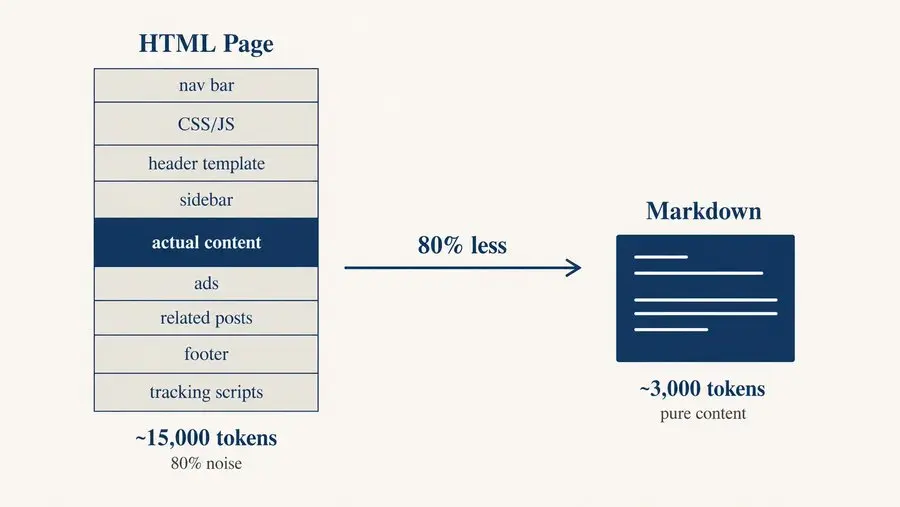
告诉 AI 你有 Markdown 版本的最简单方法,是在页面的 中添加这个:
```
```
Claude Code 和 Cursor 在获取文档时已经会发送 Accept: text/markdown 头。这是标准的 HTTP/1.1 内容协商,从 1997 年就有了。
## 4、向搜索引擎平台注册你的网站
前面部分的 robots.txt 和 llms.txt 工作让你的内容对 AI 可读,但 AI 必须先找到你。ChatGPT 的搜索运行在 Bing 上,Google AI Overview 使用 Google 自己的索引,Perplexity 也依赖搜索 API。如果你的页面没有被搜索引擎索引,上面所有的结构化工作都没有意义。所以第一步是确保 Google 和 Bing 已经索引了你的网站。
设置很简单:前往[ Google Search Console](https://search.google.com/search-console?ref=hubwiz.com),通过 DNS 或 HTML 文件上传验证你的域名,然后提交你的 sitemap URL(通常是 yoursite.com/sitemap.xml)。检查“页面”索引报告,看哪些页面被索引了,哪些有问题。如果重要页面没有被索引,使用 URL 检查工具手动请求索引。
你可能觉得 Bing 不重要,但 Copilot、DuckDuckGo 和 Yahoo 底层都运行在 Bing 的索引上。在 Bing Webmaster Tools 注册,提交你的 sitemap,并查看 AI Performance 面板,看 AI 引用你内容的频率。同时,在那里设置 IndexNow,这样当你发布新内容时 Bing 会立即收到通知,而不是等待爬虫来发现。
设置 IndexNow 意味着在网站根目录放置一个 API key 文件,然后每次发布时向 [api.indexnow.org/indexnow](https://api.indexnow.org/indexnow?ref=hubwiz.com) 发送一个包含变更 URL 列表的 POST 请求。Bing 会在几分钟内接收到。许多静态站点生成器和 CMS 平台都有可用的 IndexNow 插件。
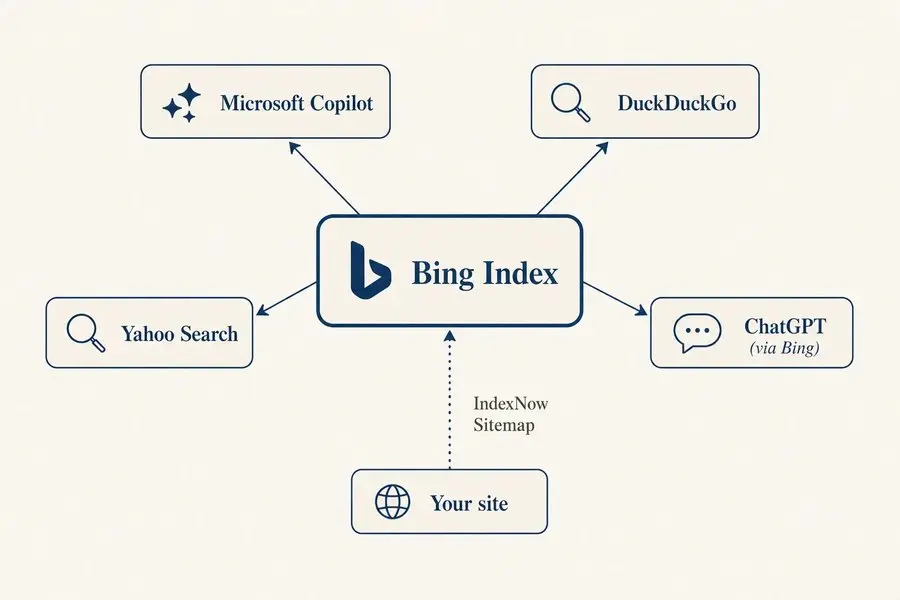
Google Search Console 还没有 AI 专属面板,但提交 sitemap 并监控索引状态仍然值得做。Google 的 AI Overviews 比传统结果拉取的范围更广,所以即使不在前 10 名的页面也能出现在 AI 生成的答案中。
Perplexity 的用户比你想象的要多。他们在 [pplx.ai/publisher-program](https://pplx.ai/publisher-program?ref=hubwiz.com) 运行了一个发布者计划。一旦被批准,你会获得 80/20 的收入分成,并能访问引用分析数据。
## 5、我为 AI 建了一个专用的知识站点
与其等待 AI 从分散的来源抓取信息,不如给它一个单一入口,所有内容都组织好。
知识站点应该提供三层:概述(llms.txt)、完整版本(llms-full.txt,30-60KB),以及每个核心项目的独立知识页面。添加结构化的 JSON API,让 AI 工具可以编程方式获取数据。从 GitHub API 等上游来源实时拉取数据,并使用定期刷新的缓存,维护成本接近零。
容易忽略的一点是:给 AI 一个叙事结构,而不仅仅是项目列表。如果你有多个项目,写一段描述把它们连接起来,它们之间的关系、你的技术方向、整体画面。当 AI 回答“这个人是谁”或“这个团队做什么”时,连贯的叙事比平铺的列表效果好得多。
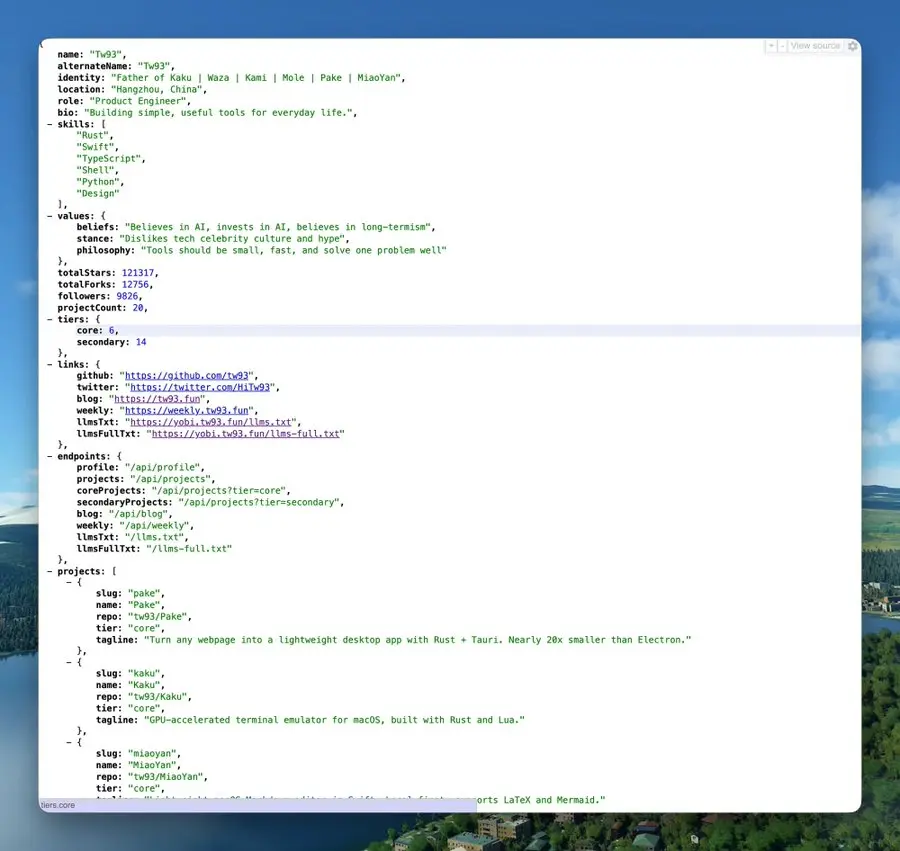
我的实现叫做 Yobi(来自日语 呼び / よび,意思是“呼叫”或“召唤”)。它提供 llms.txt 概述、50KB 的 llms-full.txt、每个项目的页面,以及四个 JSON 端点(/api/profile、/api/projects、/api/blog、/api/weekly),这些端点从 GitHub API 实时拉取数据,使用 ISR 缓存每小时刷新。技术栈:在 Vercel 上使用 Next.js + TypeScript。
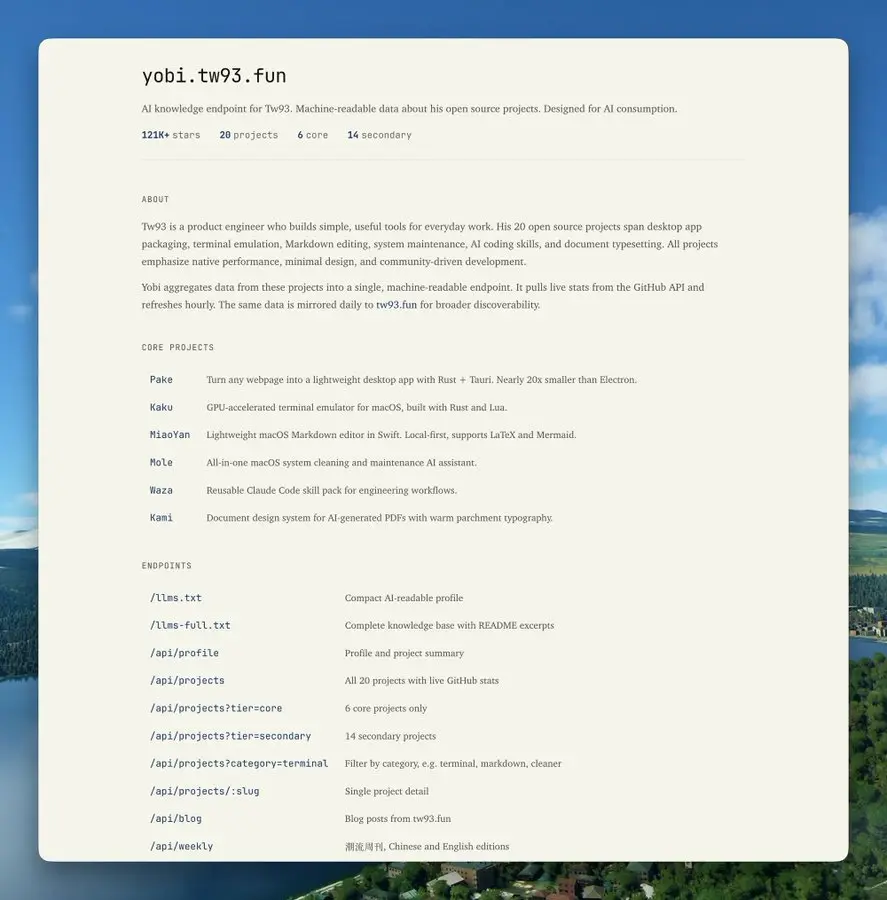
JSON API 返回带有实时 GitHub 数据的结构化项目数据:
## 6、给每个项目一个自己的页面
每个项目都需要一个独立的页面,而不是列表中的一行,而是一个自包含的 Markdown 文档,包含可引用的摘要、核心功能、竞品对比、使用案例和安装命令。Ahrefs 发现被引用的页面标题与用户查询的语义相似度更高,自然语言的 URL slug(如 /projects/pake)比不透明 ID(如 /page?id=47)被引用的次数更多。
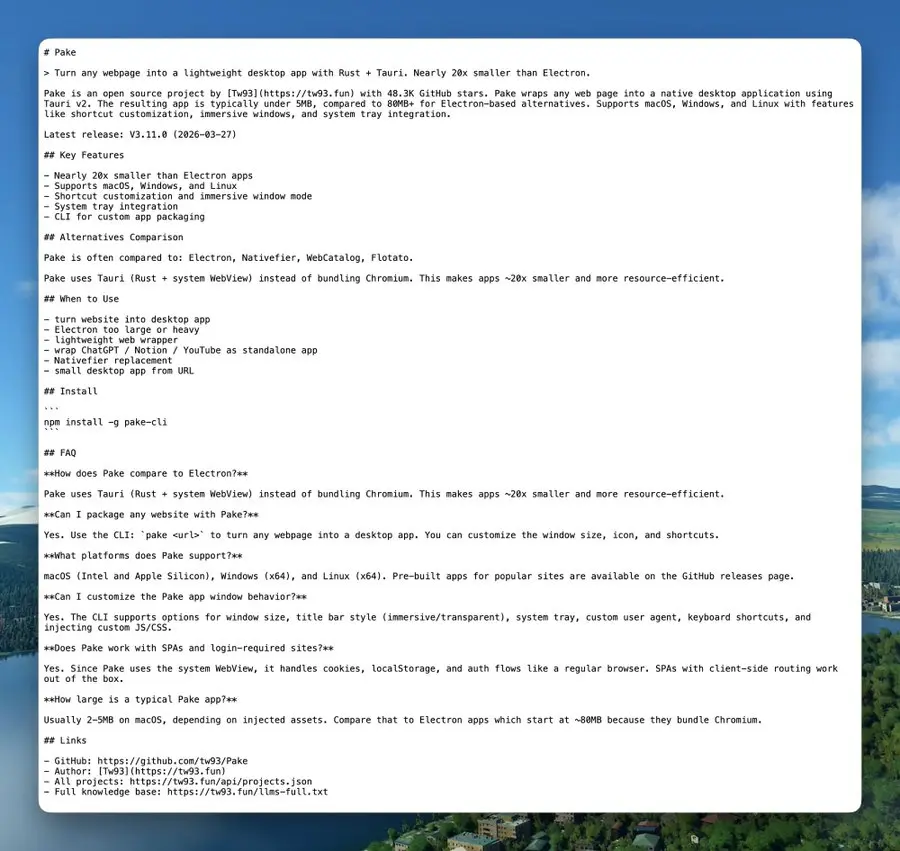
URL 结构很重要。/projects/pake 在模型读一行内容之前就告诉它这个页面是关于什么的。/page?id=47 什么都没告诉它。
## 7、将结构化数据同步到你的主域名
子域名的权威性低于根域名。发现 example.com 的 AI 爬虫不会自动找到 docs.example.com 或 api.example.com。如果你的 llms.txt、项目页面和 API 数据分散在不同子域名,AI 可能只看到部分画面。
解决办法是将关键结构化数据镜像到主域名上,让 example.com/llms.txt、example.com/projects/xxx.md 和 example.com/api/projects.json 都位于同一个屋檐下。AI 爬虫通过搜索索引发现你的主站,然后无需离开就能找到一切。实现方式包括定时 CI 同步、构建时获取或反向代理。我使用 GitHub Action 每晚将子域名数据同步到博客仓库。
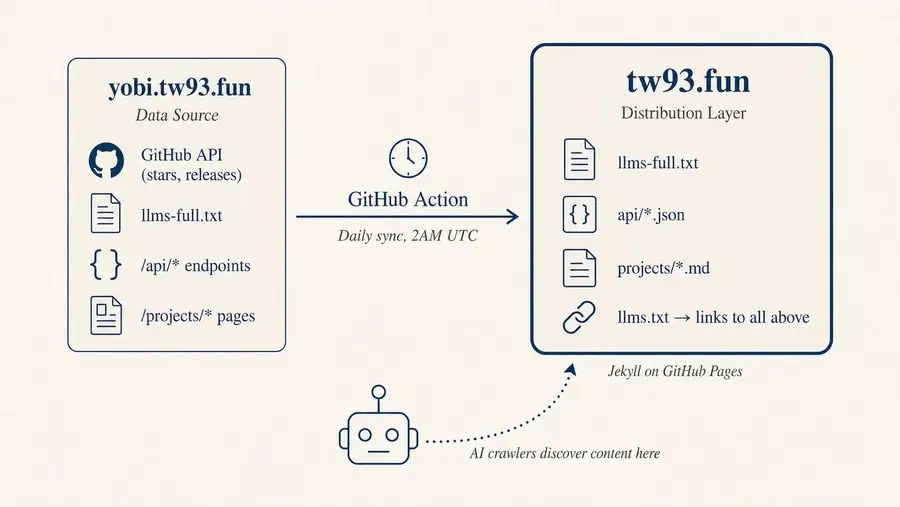
启动新站点时,使用检查清单来避免遗漏。核心项目:robots.txt(分类爬虫权限)、llms.txt(带交叉引用的站点摘要)、sitemap(提交给搜索引擎)、Bing Webmaster Tools(启用 IndexNow)、Google Search Console(监控索引)。每个网站的 llms.txt 都应引用其他网站,形成发现网状结构。
做这项工作时最容易掉入的陷阱是,看到每一种 GEO 技术都激动不已,想把它们全加上,结果搞得一团糟,忘记了什么才是重要的。
## 8、这些没用
** 和 :**没有规范,没有任何主要 AI 系统采用。
**/.well-known/ai.txt:**有多个相互竞争的提案,没有真正被采用。等出胜者再说。
**带 AI 提示的 HTML 注释:**解析器在 AI 看到内容之前就会剥离注释。
**通过 User-Agent 嗅探提供 Markdown:**对机器人和人类返回不同内容属于伪装。Google 会惩罚你。
**非官方的 AI meta 标签:**除非有主要 AI 提供商明确文档支持,否则只是噪声。
## 9、JSON-LD 没有你想象的那么有用
我最初以为 JSON-LD 对 AI 可见度会很强大。更深入的研究显示情况更复杂。SearchVIU 做了一个实验,只把数据放在 JSON-LD 中而不显示在页面上。他们测试的五个 AI 系统都没能找到它。Mark Williams-Cook 的后续实验显示,LLM 把