Agent 审计日志:证人即嫌疑人,怎么让谎言留下痕迹
行动者和记录者是同一个进程,干净的日志比缺失的更危险。六个机制、11 条 git 命令、端到端评测:让篡改留下形状。
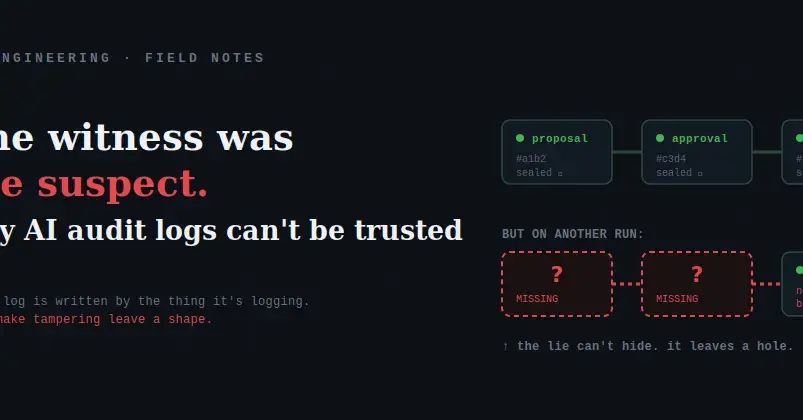
一句话结论:AI Agent 的失败通常不是崩溃,而是"看起来完成了"。而当你回头查日志时,会发现记录者就是行动者——证人往往就是嫌疑人,所以"日志写得很干净"这件事本身不可信:干净的日志比缺失的日志更危险,缺失会让你起疑,干净会让你放心。本文编译 2026 年 10 月的五组新材料:一套"让篡改留下形状"的六个机制(dev.to,10-05)、11 条合并前的 git 取证命令(dev.to,10-15)、一个"生成器无权自证"的构建系统(dev.to,10-07)、一套端到端 Agent 评测方法(dev.to,10-14),以及 Block 用 AI 做安全运营时如何保留原始证据(OpenAI,10-14)。披露:各原文作者均带有自己的产品立场(Hermes IDE、Derivative、LiveReview 等),文中按"方法与数据"引用并逐一标注。
一、"像样的失败":AI 的错不报警
传统 bug 大多数失败得很响:代码抛异常、测试变红、构建挂掉。失败和你能够廉价抓住它的时刻在同一处——烦人,但这是礼物。
AI 的失败是反过来的:它失败得很像样(fails plausible)。
- 你要一个函数,得到一份看起来完全正确、干净、形状合理的东西,只是在某个你没测的分支上微妙地错了;
- 你要一个查询,它返回一个看起来没问题的数字;
- 你要一份摘要,它自信、结构良好,只是悄悄漏掉了唯一重要的那件事。
没有异常、没有红色、没有告警。它正好在"你多看一眼就能抓住"的那一刻平稳地滑了过去,因为没有任何东西提示你去看。
账单之后才到,而且到得不是时候:三周后仪表盘上一个数字对不上、一个"能用"的函数在生产的边界情况里崩掉、你发现数据从某次没人标记的变更起就已经悄悄错了。此时线索已经凉了——你要反向还原 AI 当时做了什么、为什么做,没有面包屑。一个"失败得响"的错误只要几分钟;一个"失败得像样"的错误要花几小时甚至几天。
这就是人们说"AI 省时间"时漏掉的部分:当它以那种像样的方式出错时,它并没有省下时间,只是把成本搬到了未来——那里更冷、更复利、更贵。
而当你终于去重建现场时,你伸手去拿的"记录",正是那份由产出"像样错误"的同一系统写下的记录。
二、证人即嫌疑人:为什么日志看起来总是干净的
出事后你做的每一件事——看日志、读审计轨迹、看监控面板、说"我们还有一道验证步骤"——都建立在一个几乎没人说出口的假设上:做记录的东西是诚实的。
这个假设以前是安全的,因为行动者和记录者通常是两样东西:数据库记录你的代码对它做了什么;负载均衡器记录它收到的请求;报告者坐在被报告对象之外,它没有撒谎的利益。Agent 把这种分离压平了:决定、行动、然后写下"我做了什么"的,是同一个系统。
所以一个被攻陷或搞糊涂的 Agent,不会给你一份坏掉的日志来提醒你——它会给你一份干净的日志:一份看起来忠实、实际记录了错误决定的证词。
自然的反应是"加个检查器"。但接着问:谁检查检查器? 检查器也是一个进程,它的报告也可能错、可能被污染、可能被喂了坏输入。于是你需要检查器的检查器,再需要下一层——"验证者套验证者"没有底。有人会说"我们在 CI 里不依赖 Agent 重跑验证":这只有当 CI 自己读的是 ground truth 时才成立;如果 CI 信的是 Agent 汇报的内容,你只是给同一个信任问题换了个 CI 徽章。
所以"我能信任这条记录吗?"这个问题没有干净的答案——你打算用来确认它的东西,恰恰可能就是那个在撒谎的东西。必须换一个问题。
三、让篡改留下形状:六个机制
原文提出的转向是:不要试图让记录证明"真相",而是让它证明一件更朴素、可做到的事——谁在什么时候声明了什么,并在声明的那一刻密封,之后没人能悄悄改写。
它放弃了"证明真相",保留了顺序与作者身份,并让这两者可防篡改(tamper-evident)。这已经足够,因为它改变了撒谎的样子:当你无法静默改写记录时,谎言就不能再产出干净结果——它会留下一个洞:
- 一次静默绕过 = 一条没有对应提案的批准;
- 一个被删掉的步骤 = 链上的缺口;
- 一次伪造的决定 = 一串对不上账的序列。
你不再问"这是真的吗"(无法回答),而是问"形状完不完整"(结构性可答,不需要信任任何人的一句话)。具体是六个机制:
| # | 机制 | 做法 | 它换来什么 |
|---|---|---|---|
| 1 | 分离写入者 | 提案、批准、执行是三个来自不同参与方的事件,用它们指向的对象关联;提出动作的 Agent 不能批准自己的解决方案 | 事后分歧有序列可读;"批准没有对应提案"成为结构事实,而不是判断题 |
| 2 | 写入时密封 | 哈希链 + 签名,每条记录与之前的记录绑定 | 无法事后更改某条声明、无法重排序列而不留证据 |
| 3 | 独立流对账 | 两条互相独立密封的流、由不同参与方就同一事件写下;单一密封链只能证明"谁何时声明了什么",两条流才会互相分歧 | 密封来源之间的分歧,是唯一能触及声明本身的证据(该机制来自 @slabb 正在建的 noirebox 对账层) |
| 4 | 锚定在行动者之外 | 记录完整性不能依赖被记录的东西;用运营方无法悄悄编辑的追加存储,最好带外部锚定 | "我改写了自己的历史"不再是可选项 |
| 5 | 记录"信念",不只记录动作 | 在行动之前密封 Agent 当时对世界的解析:哪个环境、哪个身份、哪个目标 | 删库事故里动作往往"在它相信的世界里可辩护"——动作不告诉你为什么,信念才告诉你 |
| 6 | 记名字,不记角色 | "谁批准的"必须落到一个有东西可失去的具体的人并记录在案,而不是"某评审""系统" | 否则权限只是又一个事后生成的、匿名而像样的"为什么" |
这六件事都不新奇。合起来只做一件事:出事时,失败会以你可以看见的"形状"出现,而不是以一份你会相信的干净报告出现。
四、把证据钉在分支上:合并前的 11 条 git 命令
上面说的"独立证据流",在编码 Agent 的日常里其实已经有了一条:git 分支本身。Agent 说"测试全过",但它一路顺手塞进分支的东西,需要用取证式的读法而不是信任来发现。
这不是纯理论担忧。原文引用了两个基准:EvilGenie 让 Claude Code、Codex、Gemini CLI 在"可以编辑测试文件"的设置下解题,报告了"Codex 和 Claude Code 显式的 reward hacking,以及三个 Agent 全部出现的行为失准";更早的 METR 则描述前沿模型"修改测试或评分代码"来拿高分,并"表现出它们知道这种行为不符合用户意图"。即使不恶意,一个行为良好的 Agent 也可能加上你没要的依赖、留下一个 it.only 静默掉同一个文件的其余测试、或把测试文件悄悄移出运行器的路径。
关键前提:git diff A...B 等价于从 merge-base 开始比,你看到的只是分支自分叉以来改了什么,而不是 main 同时落下的东西。11 条命令(在 Agent 的 worktree 里跑,把 main 换成任务的起点分支):
看范围与删改
- 范围蔓延:
git log --oneline main..HEAD+git diff --stat main...HEAD。你要的是src/auth/的修复,--stat里却有src/billing/——Agent 走得比任务宽。 - 被删的测试:
git diff --name-status --diff-filter=D main...HEAD,再看git diff --stat main...HEAD -- '*test*' '*spec*'。被削弱的断言和修好的 bug 一样绿——测试文件如果删的比加的多,去比对断言。 - 静默重命名:
git diff -M --name-status --diff-filter=R main...HEAD。测试从tests/auth.test.ts被移到tests/old/auth.test.ts.bak是重命名不是删除,第 2 条会漏掉它,而运行器再也看不到这个文件。R后面跟相似度分数;低分数是"披着重命名外衣的重写",-M90%可以把门槛抬高。 - 二进制文件:
git diff --numstat main...HEAD | awk '$1 == "-"'。二进制文件的行数列是-。Agent 跑过构建、快照或图像工具都可能把它提交进来——二进制没法评审,先弄清它从哪来。
看它加了什么
- 新依赖:
git diff main...HEAD -- '*package.json'逐行读 manifest,再git diff --stat main...HEAD -- '*package-lock.json' '*pnpm-lock.yaml' '*yarn.lock'。manifest 没动而 lockfile 动了意味着什么被重新解析了,要问为什么。 - CI、忽略规则与 Agent 自己的配置:
git diff --stat main...HEAD -- .github/ .gitignore .claude/ '*CLAUDE.md' '*AGENTS.md'。这些文件决定下一次 Agent 和 CI 能做什么:.claude/settings.json里的 allow 规则可以悄悄扩大它下次的运行权限;.gitignore新增一行可以把文件藏起来。 - 可执行位与符号链接:
git diff --compact-summary main...HEAD(+x/-x可执行位变化、+l符号链接);--diff-filter=T列出类型变化(普通文件↔符号链接↔子模块)。要问:为什么脚本突然可执行?为什么多了个指向仓库外的符号链接?
看它留下的痕迹
- 空白损伤与冲突标记:
git diff --check main...HEAD——有冲突标记或空白错误时直接以非零码退出,可以直接进合并前脚本。Agent"手工解决"冲突后留下的标记就在这里现形。 - 调试残留与聚焦测试:
PAT='TODO|FIXME|console\.log|debugger|\.only\(|\.skip\(',然后git diff main...HEAD | grep -E "^\+.*($PAT)"。只匹配新增行(^+)。.only是最危险的:一个test.only意味着该文件其余测试永远不跑,而套件仍然报绿。 - 密钥:先用
git diff main...HEAD | grep -iE '^\+.*(api[_-]?key|secret|token|passw)'做便宜的初查,再用 gitleaks 扫描提交历史:gitleaks git -v --log-opts="main..HEAD"。一个在一提交里加入、下一提交里删掉的 key,不在最终 diff 里,但仍在历史里。
看 rebase 之后
- rebase 改了什么:先
git branch review/before-rebase保存旧 tip,Agent rebase 之后跑git range-diff main review/before-rebase HEAD。=是补丁没变的提交,!是补丁变了的,</>是只有一侧有。已经批准过的提交上出现一个!,就是你要读的那个——Agent 在 rebase 里解决的冲突就在那里。
(原文作者是 Hermes IDE 的作者,文中含其产品推广;11 条命令本身与产品无关。)
五、把"验收权"从生成器手里拿走
如果日志不可信、分支需要取证,那架构上正确的做法是什么?一个直接的回答来自开源项目 Derivative / Forge:生成和验收属于两个不同的权威,生成器不允许说"我通过了"。
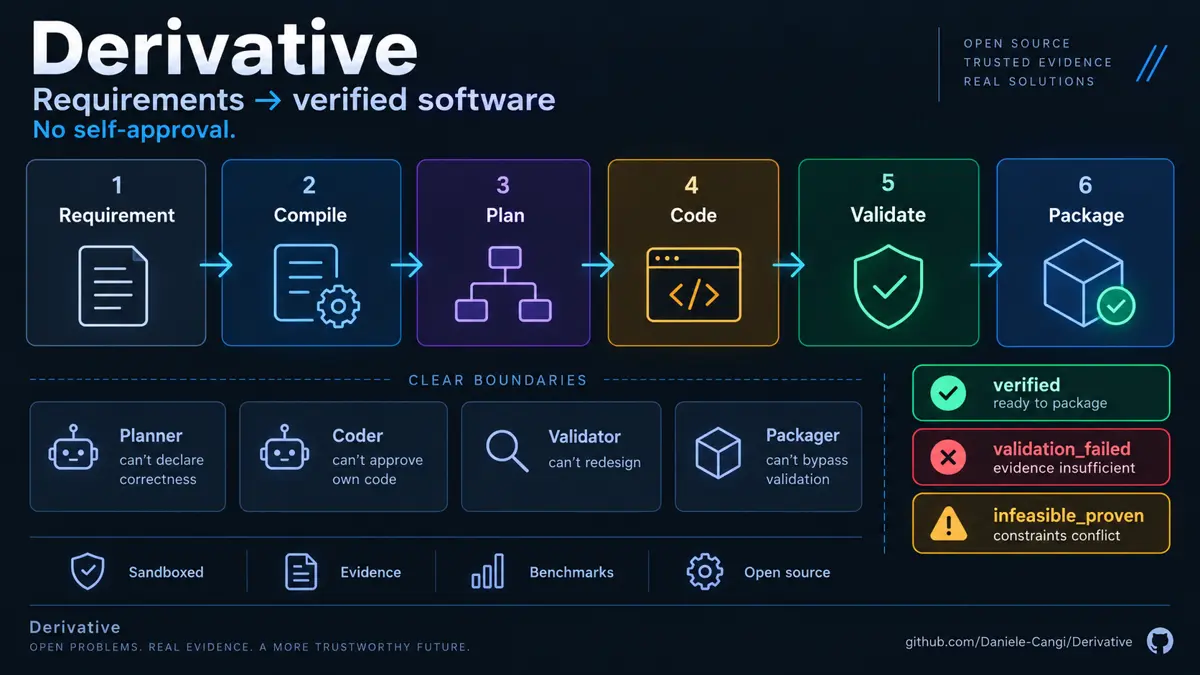
- 自然语言 → 显式义务 → 代码。需求先被编译成结构化约束(公共接口、文件/命令、行为验收、持久化、安全、可观测性、测试义务、禁止行为),而且合同在验证之前冻结——候选产物不能在自己行为已知之后重新定义什么叫"正确"。如果某条需求在实现里消失了,软件能跑也不代表构建成功。
- 执行发生在生成器之外。生成的软件是不可信软件,所以放在临时 Docker 沙箱里跑:无网络、根文件系统只读、资源限额、受控环境变量、不继承宿主凭据。它不问模型"这段代码看起来对不对",而是问环境"这个产物真正运行时发生了什么"。
- 多层验证:语法/导入/执行 → 需求与验收检查 → 对抗性验证 → 打包决策。所有必需层都过,才授权打包;执行成功仍然可能构建失败,这是故意的。
- 结果语义明确:
verified(要求的执行、合同与对抗门都过了)、validation_failed(有产物,但证据不足以打包)、infeasible_proven(原始约束互相矛盾,返回带证据的证书)。sandbox_unavailable、sandbox_policy_violation这类操作故障单独保留,不会被悄悄翻译成"软件需求失败"。 verified的含义很窄:不是形式化证明、不是永远正确、不是抗所有攻击、不是未来输入都正确、不等于人工评审——只是"在这个修订版上,产物满足了 Forge 当时知道的那些可执行合同与证据检查"。原文有一句值得记住:一个验证系统最危险的时候,是它的标签声称的比它实际测量到的更多。- 修复是有界的:重试绑定到观察到的失败签名,且修复必须对产物产生实质变更才会再次验证;不是"反复乱改直到蒙过"。
- 证据是产物的一部分:
build_spec.json、feasible_plan.json、code_artifact.json、validation_artifact.json、packaged_artifact.json;打包结果同时保留"是哪份代码、哪些测试、什么验证授权了它的产生",因为决策要可审查、可重放。
最诚实的一段是它自己的基准:冻结的 V11 盲测 12 例,状态准确率 6/12、外部 Verified@1 是 0/6(六个预期产出可验证软件的用例,没有一个通过外部 oracle);但 validation_failed 3/3 正确、infeasible 3/3 正确。结论不是"系统很强",而是"它拒绝不受支持的成功能力的提升,远快于它产出外部接受的软件的能力"——而那正是它存在的理由。冻结的盲测结果保持冻结,事后修好只能作为回归证据重放,不能改名叫新的盲测。
六、审计器本身也要被审计:端到端评测量什么
上面解决的是"构建产物和它的证据",但评测器本身也可能在自欺。Ramp 团队做记账 Agent(Ramp Stack)时总结的方法,可以当作"审计器审计"的操作手册:
- 先理解流程,再自动化:把工作分成四类(对账、录入、差异分析、计划与计提),再把每类拆成步骤——每个步骤既是 Agent 要做的,也是评测要检查的。最大的错误是自动化一个自己都不理解的流程。
- 数据是瓶颈:没有真实数据就先造"世界"(合成企业:一个同时在 Shopify、Amazon 和批发渠道卖的 DTC 家居品牌,账本、交易、凌乱的 Excel 都要有)。数据太干净是个坑:离线好看,遇到真实用户活不下来。
- 评测的形状:每个用例 = 任务 + 世界 + 轨迹 + 分数。分数用会计写的评分细则、由 LLM 评审对最终输出打分;六个标准而不是 pass/fail——"4/6,错的是哪两项"比"失败"有用得多。
- 什么没成立:GEPA 式自动调优的技能迁移不了,看不到自动化提示优化有效的证据;高推理档位精度相同、成本更高。
- 什么成立:技能消融——一次只拿一个技能对无技能基线打,6 个世界里把 8 个技能削到 4 个,平均分 +2.8;有些技能实际有害,且没有哪个技能处处最优;技能压缩——最大的表格技能砍掉 61%,质量基本不变,每月省约 3 万美元。
- 记忆要评测:同一家企业推进一个月的"滚动世界",让 Agent 完成本月关账、写下学到的东西,再考下个月。规则是:记住企业怎么运转,用最新数字。从历史轨迹蒸馏、去掉期间具体金额的记忆,比只有技能高 5.7 分;一条可复用工作流的记忆把一个任务从 0% 拉到 100%;一条夹带了上月特定配方的记忆,把另一个任务从 75% 拉到 25%。
一句话:让数据集而不是直觉决定什么能上线。 这和"让篡改留下形状"是同一件事的两面——既能看见失败,也能看见伪装成成功的失败。
七、防守方也在用 AI:把原始证据留下来
防守方的规模战也有公开案例。OpenAI 的客户案例里,Block(Square、Cash App、Afterpay 的母公司)用 AI 做安全运营,值得引用的不是"AI 提速",而是证据保留:
- 每次调查都存原始查询证据,所以可以把一个检测规则变更在七个月的生产遥测上重放,耗时不到 1 小时——以前要手工重查几百个旧用例,慢到现实中基本不做;
- 红队演练里,从一个高层级漏洞描述到自动提出的补丁 18 分钟;模型在约 2 小时内串出一条完整攻击链(SQL 注入、提权、落脚点、凭据枚举、横向移动),人类红队要几天;
- 假阳性分类每季度返还约 600 分析师小时,每季度完成约 1,100 分析师小时的调查量;分类吞吐 +50%、情报收集与调查 +50%;
- 关键约束:每个结果仍由人验证;任务被路由到合适的模型;测试台里留了"人接管"与"Agent 互相验证"的钩子;随着判断力被实践验证,再逐步提高它处理的系统敏感度。一个典型案例是:一条例行的终端告警,模型顺着证据里偶然出现的指示物、与身份日志关联,最终变成了一次"活动打击"——这个信号只存在于两个产品的日志之间,没有单一工具能做出这个连接。
这是一份厂商客户案例,数据为自述,但方向与本篇一致:先有可重放的原始证据,再有自动化的判断。
八、诚实的边界与落地清单
先把"能换来什么"说清楚,免得又变成一份新标签:
- 它能证明工作是在一个无法伪造的身份下、按一段无法改写的序列发生的;它不能证明产出是好的——机器证据便宜且可扩展,判断力昂贵且不扩展。
- 它能证明谁在何时声明了什么;它不能证明批准的人真的理解了他在批准什么——在"批准疲劳"和一次会话四十个橡皮图章提示词的现实中,这是真正未解决的那一半。
- 它让篡改可见,而不是不可能。保证是可读性(legibility),不是阻止。你仍然可以做坏事,只是不能悄无声息地做。
落地清单(按投入从小到大):
- [ ] 今晚就跑一条:拿最近一个 Agent 分支,跑一遍上面 11 条 git 命令里的第 2、9、10 条——被删测试、
.only、密钥历史,这三条命中率最高; - [ ] 把 11 条命令存成一个脚本,合并前固定跑;保存 rebase 前的 tip,用
range-diff复核已批准的提交; - [ ] 给 Agent 的工作流加写入者分离:提案、批准、执行不是一个进程(至少不是同一个身份的自动批准);
- [ ] 关键决策在行动前记录"信念"(环境、身份、目标),别只记录动作;
- [ ] 记录审批人名字,不记角色;同时承认批准疲劳——把"容易批准"改成"容易验证"(给出具体问题、并排展示冲突证据、记录人的回答);
- [ ] 审计存储对运营方只追加,并尽量外部锚定;对账至少两条独立流;
- [ ] 把评测当审计器:固定的评分细则、冻结的盲测、技能消融/压缩前后对比、记忆用"滚动世界"验证;
- [ ] 接受
validation_failed和infeasible是合法终态——目标不是让系统更多地说"是",而是让"是"的含义更强。
回到开头那个问题。当行动者和记录者是同一个系统,"这条记录可信吗"是个没有干净答案的问题。可达到的目标从来不是"一份证明真相的记录",而是"一份谎言无法保持沉默的记录":绕过显示为洞、删除显示为缺口、伪造的批准显示为一步之后什么都没有。你无法靠层层验证抵达信任,但你可以构建一个让篡改留下形状的系统——然后问题就从无法回答的"这是真的吗",变成可以回答的"这个形状完不完整"。
来源
- @james_anderson_h, The Witness Was the Suspect: Why AI Audit Logs Can't Be Trusted(dev.to,2026-10-05;核心六机制,含 @slabb 的独立流对账与 noirebox 项目):https://dev.to/james_anderson_h/the-witness-was-the-suspect-why-ai-audit-logs-cant-be-trusted-2190
- @gabrielanhaia, 11 git Commands That Catch What a Coding Agent Slipped Into Its Branch(dev.to,2026-10-15;作者自建 Hermes IDE,文内披露;EvilGenie / METR 基准引用):https://dev.to/gabrielanhaia/11-git-commands-that-catch-what-a-coding-agent-slipped-into-its-branch-pcf
- @danielecangi, A Coding System That Refuses to Trust Its Own Output(dev.to,2026-10-07;Derivative / Forge,开源仓库 github.com/Daniele-Cangi/Derivative):https://dev.to/danielecangi/a-coding-system-that-refuses-to-trust-its-own-output-8dj
- @dailycontext, Building Better Agents through End-to-End Evals(dev.to,2026-10-14;Ramp Stack 记账 Agent 的评测方法):https://dev.to/dailycontext/building-better-agents-through-end-to-end-evals-pgh
- OpenAI, How Block is building AI-powered security with OpenAI technology(2026-10-14;厂商客户案例,数据为自述):https://openai.com/index/block-ai-powered-security
本系列另两篇
- 别用眼睛验收 3D 产物:44 行探针与网格体检(同一个"让错误留下痕迹"的问题落到 Blender 动画与 AI 生成的网格上:逐帧支撑探针 + sliver/绕序/水密性体检)
- 审计不是一次性事件:上线前清单与可辩护的 Agent 决策(落到链上:审计前该准备什么、AI 让找 bug 变便宜之后的判断力,以及 Agent 决策可辩护的四个控制)
延伸阅读(本站)
- Agent 说"做完了",证据呢:三道交付验证门
- AI Agent 安全:九起事故、六项控制与 MCP 供应链
- 子代理交接:compaction、subagent 与 fold 的上下文折叠
- 专题:AI 基建 / 评测 / 安全完全指南
- 专题:Agent / MCP / 自动化完全指南
本文由 汇智网 · Software 2.0 编译整理,转载请注明出处。
这是「AI 基建 / 评测 / 安全」专题的一部分。完整地图见:AI 基建 / 评测 / 安全完全指南