同样一个 agent,贵的那个反而省 65%:账要算到人头上
一个任务 6,150 个输入 token 对 1,000 个,3 轮对 1 轮——多出来的每一轮都要把变长的历史重发一次。价目表上永远看不到这四个成本。
两个模型,跑同一个 agent 任务:读一封 750 词的客户邮件,抽实体,调 API 查账户状态,输出严格 JSON。
模型 A 的牌价是 $0.50 / 百万输入、$1.50 / 百万输出;模型 B 是 $1.00 / $3.00,整整贵一倍。
实际每个任务的账单:A 花 $0.0042,B 花 $0.00145。贵的那个省 65%。
这是 AWS 在 2026-11-12 那两篇 Bedrock 成本博文里给的算例(Part 1 讲怎么归因到人,Part 2 讲怎么把成本和产出对上)。它想说的只有一句话:价目表上的单价不是你付的钱,你的账单是"完成一个任务"的钱。
一、先把"任务"这个词定义清楚
一个任务 = 你的应用让模型做完的一件完整的事:回一封客服信、从一张发票里抽字段、回答用户一个问题。从请求开始,到拿到可用结果为止,中间调了几次模型都算同一个任务。
单价便宜的那个模型,跑到你的负载上不一定便宜。便宜模型可能:
- 把你的文本切得更碎(同样的内容,多得多的 token);
- 用废话填满回答;
- 读不懂工具 schema,来回纠错多跑几轮;
- 在给出 200 token 答案之前,先烧掉几千个推理 token。
这四件事,在价目表上一条都不写。
二、四个隐形成本
| 成本 | 为什么它会咬人 | 对应的杠杆 |
|---|---|---|
| Tokenizer 效率 | 每个模型族的词典不同,同一段文本/代码/JSON 切出的 token 数不同。A 的牌价低 15%,但它的 tokenizer 对结构化 schema 和数字数组要多 40% 的 token,B 就更便宜。非拉丁文字更夸张:很多 tokenizer 会把中文切成英文等价的 2–3 倍 token | 先用 CountTokens 比 tokenizer,再谈价格 |
| 输出对齐与啰嗦 | 输出 token 通常比输入贵 3–5 倍。模型不遵守"只返回原始 JSON",你就要为填充词付这份溢价 | 工具 schema + maxTokens 上限,比用自然语言求它少废话更可靠 |
| Agent 循环效率 | 工具调用天然是多轮:分析 → 决定调工具 → 等观察结果 → 生成答案。每一轮都把完整历史和工具结果重发一遍作为输入 | prompt caching、模型路由 |
| 推理开销 | 扩展思考的 token 按输出计费:先想 2,000 token 再答 200 token,你付 2,200。有些模型还会隐去推理过程但照样收钱 | 默认关,除非基准证明它赚得回来 |
三、那个 65% 是怎么来的
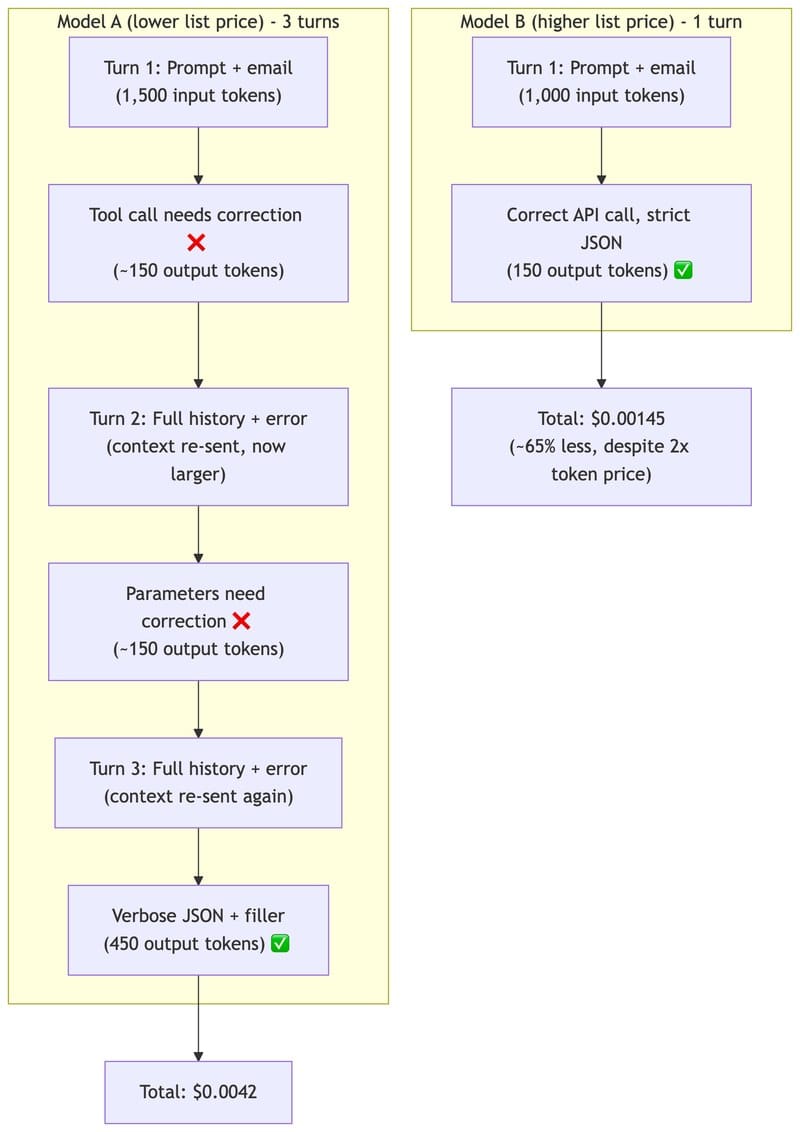
(图源:AWS ML Blog,同一篇。)
| 指标 | 模型 A(牌价低) | 模型 B(牌价高一倍) |
|---|---|---|
| 输入牌价 | $0.50 / 1M | $1.00 / 1M |
| 输出牌价 | $1.50 / 1M | $3.00 / 1M |
| 第 1 轮输入 token(tokenizer 效率) | 1,500 | 1,000 |
| 最终回答输出 token(啰嗦度) | 450 | 150 |
| 需要的轮次 | 3 轮(纠错) | 1 轮(zero-shot) |
| 累计输入 token | 6,150 | 1,000 |
| 累计输出 token | 750 | 150 |
| 单任务成本 | $0.0042 | $0.00145 |
算式只有两行:
A: (6,150 × $0.50 + 750 × $1.50) / 1,000,000 = $0.0042
B: (1,000 × $1.00 + 150 × $3.00) / 1,000,000 = $0.00145
三个复利因素叠在一起:tokenizer 把邮件切成多 50% 的 token(每一轮都放大)、输出填充词把输出量翻了 3 倍、与工具 schema 不齐导致两轮纠错而每轮都重发更长的历史。
四、把"失败"和"缓存"也算进去
上面假设两个模型最终都成功。生产里不是这样,而失败很少免费:
重试到成功型:单成功任务成本 = 单次成本 / 成功率
失败即升级型:单成功任务成本 = 单次成本 + (1 - 成功率) × 升级成本
开启 prompt caching 之后,输入还要拆成三桶计价:未命中缓存的输入(基准价)、缓存读(低于基准)、缓存写(高于基准)。
官方提醒一句很实用的:缓存检查点会漂——三个月后你的工具集变了、写进缓存的东西更多了,所以缓存命中率要持续复测,不是一个设完就忘的参数。
五、在自己数据上量,别信样例
CountTokens:不算推理就能拿到"这个模型对这段载荷会收多少输入 token",是最便宜的横向比价工具;- 模型响应里的
usage块:inputTokens/outputTokens/cacheReadInputTokens/cacheWriteInputTokens。坑在这里:开了缓存后inputTokens只算未命中部分,真实输入量是三者之和,但计价要分开; - 模型调用日志:每次调用的 token 数落到 S3 或 CloudWatch Logs,可以按 team / feature / 实验打标切分。但它是日志字段,不是成本分配标签,永远不会出现在 Cost Explorer 或 CUR 里;乘以牌价得到的是近实时估算,不是发票(承诺用量、批量、预留吞吐都不会体现);
- 应用推理配置(application inference profile):能进 Cost Explorer 和 CUR,但粒度是"每天一个用量类型"——做内部计费够用,做单任务成本太粗。
六、从"有人花了钱"到"这是谁的账"
这一半是 Part 1 的内容,路径很短,但要按顺序:
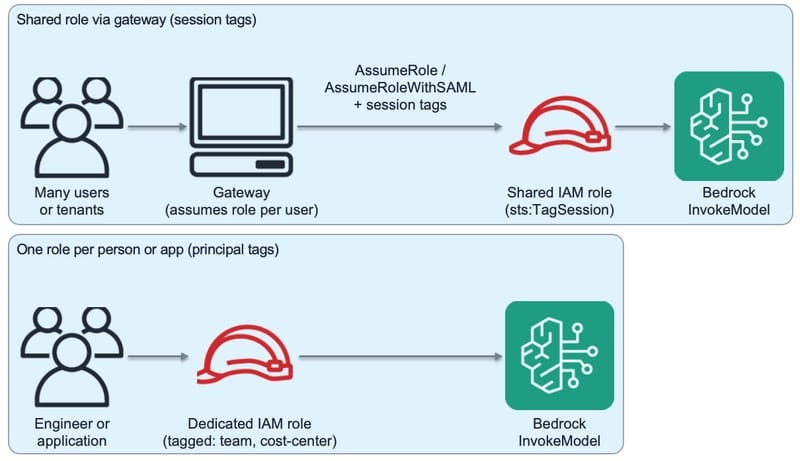
① 归因数据是白送的。 Bedrock 对每个推理请求都记 IAM principal(user 或 role),你不需要改任何推理调用。
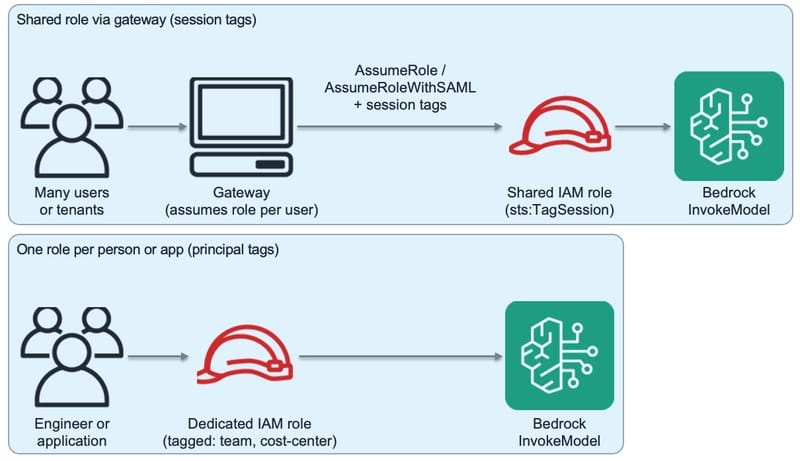
(图源:AWS ML Blog《Tokenomics at scale》。)
② 一人一 role → 打 principal 标签。 静态标签,对该 principal 的每个请求都生效:
aws iam tag-role \
  --role-name BedrockDeveloperRole-alice \
  --tags Key=user,Value=alice@example.com Key=team,Value=platform Key=CostCenter,Value=CC-1001
③ 多人共用一个 role(或走网关)→ 必须用 session tags。 principal 标签区分不了共用 role 里的人,因为每个会话带的标签一样。session tags 在承担角色时传入,动态、可变化;同 key 时 session 标签赢。前提是 role 的信任策略允许 sts:TagSession,三条传法:sts:AssumeRole --tags、OIDC 的 https://aws.amazon.com/tags claim、SAML 的 PrincipalTag:* 映射。上限 50 个标签。
注意一个坑:你已经采集了 saml:sub 不等于它能用——IdP 那边要单独把它映射成 PrincipalTag:* 属性语句,信任策略要允许 sts:TagSession,两者是独立配置的。
④ 激活成本分配标签。 标签不打勾不会进账单数据。Billing → Cost allocation tags → 类型选 IAM principal → 选中激活。组织里只能在管理账户(payer)激活。两个时间点:标签 key 要等该 principal 至少调过一次 Bedrock 才出现;新 key 最多 24 小时才可激活,激活后再 24 小时才开始填数据;默认不回溯——想用之前就得激活。
⑤ 建 CUR 2.0 导出。 Data Exports → 新建 CUR 2.0(Standard)→ Additional export content 里勾 Include caller identity (IAM principal) allocation data → Time granularity 选 Hourly → Report data integration 选 Amazon Athena(输出 Parquet,并顺带给你一个建 Glue 表的 setup 脚本,这个脚本得你自己跑一次,控制台不会替你建)。列名前缀:principal / session 标签是 iamPrincipal/,资源标签是 resourceTags/(比如 team 这个 key 会变成 iamPrincipal/team)。AWS 有个现成查询集:aws-samples/sample-cur-iam-principal-bedrock-tracking。
⑥ 执行:Budgets + Deny。 建一个作用域为 Bedrock、过滤到某个身份或标签值的 Budget,挂一个 budget action:到阈值就应用一条 Deny IAM 策略。这是"能限住"的部分,不需要写应用代码。
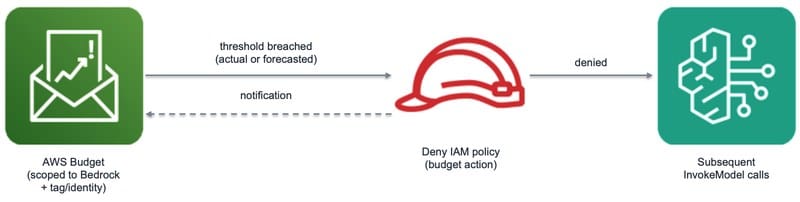
(图源:同上。)
真正能用的 Deny 策略是只拒贵的那档,便宜模型留着让人继续干活:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Deny",
      "Action": ["bedrock:InvokeModel", "bedrock:InvokeModelWithResponseStream"],
      "Resource": ["arn:aws:bedrock:*::foundation-model/[HIGHER-COST-MODEL-ID]"]
    }
  ]
}
分级不是靠多个预算,而是一个阈值挂多个动作、一个预算挂多个阈值:80% 拒高价款、100% 拒中档、低价款始终不拒。可以选择自动执行,也可以要求人工在 Alert 页面点批准;但至少配一条通知,告诉被限的人为什么访问变了。
连坐陷阱:budget action 挂在 IAM user / group / role 上。如果大家共用一个 role,Deny 一挂,整组人一起被掐,不只是超支那个。所以"账算到人头上"的前提是一人一 role(或网关按人下发 session tags)。联合身份、没有常驻 IAM 身份的,要用前一篇文章那套按用户的执行方案。
6.1 七个坑(做之前先看)
| 坑 | 实际影响 |
|---|---|
| AWS Budgets 不是近实时 | 数据最多每天刷新 3 次,可能超支之后动作才跑 |
| 成本分配标签不回溯 | 新 key 要 24h 才出现,激活后再 24h 才填数据;想用就得提前激活 |
| CUR 没有按请求的明细 | 经典 CUR 和 CUR 2.0 都按小时/天、按用量类型聚合 |
| IAM principal 字段只在 CUR 2.0 | 老格式根本没有这些列 |
| session tags 在 AssumeRole 时绑定 | 一个会话里所有调用值相同,而且不写进模型调用日志;要按人区分,得用 per-user RoleSessionName 或请求元数据 |
| 共享网关 role 会把归因塔缩 | LLM 网关场景下,记录到的是网关自己的执行角色 |
| 新模型要单个确认 | 用量类型是按模型分的,开新模型后要确认它出现在你的查询和预算过滤里 |
6.2 选哪条路,看你要什么
| 需求 | 推荐路径 |
|---|---|
| 快速看数 | Cost Explorer 按身份分组 |
| 按团队报表 | Cost Explorer + 已激活标签 |
| 逐行明细分析 | CUR 2.0 导出(含 caller identity) |
| 真正执行限制 | AWS Budgets + budget actions |
七、证明这个 agent 值不值
省下来的钱不等于价值。决定预算的那个问题是:这个 agent 比原来的人做得更好吗?
先把人工流程写下来。 什么触发这个工作、涉及哪些角色、交接点在哪、什么算完成。这听起来像官僚,其实是测量设计——下游所有埋点(什么算一次运行、什么算成功、人的时间花在哪)都从这段描述里掉出来。
在上线前测基线。 完成时间、排队时间、实际投入、重开率、升级率、单任务成本、产出质量。基线必须是上线前测的,事后回忆重构出来的基线会系统性偏袒 agent:人记得平均情况,忘了那些特别快的。
把工作流当实验来埋点。 每次运行一个 trace ID,一条 run 记录把模型调用之外的东西也聚成一个可分析单元:
{
  "runId": "run-8f3a2c",
  "workflow": "renewal-risk-summary",
  "principalArn": "arn:aws:sts::123456789012:assumed-role/BedrockRuntimeRole/gw-alex",
  "team": "sales-ai",
  "experiment": { "variant": "treatment", "holdout": false, "promptVersion": "v14" },
  "ops": { "latencyMs": 41200, "retries": 1, "toolCalls": 6, "humanApprovals": 1, "humanMinutes": 35 },
  "econ": { "inputTokens": 48210, "outputTokens": 3105, "cacheReadTokens": 31500, "estCostUsd": 0.87 },
  "outcome": { "status": "success", "accepted": true, "reopened": false, "revenueEventId": "opp-44121" }
}
三个字段值得单独说:experiment 块在运行创建时打戳并传入 Bedrock 请求元数据,让模型层和工作流层的记录能干净地 join;humanMinutes 是最多团队漏掉、又最需要的——不记它,"agent 干了这活"就悄悄排除了人审的那 35 分钟;revenueEventId 现在记不要钱,事后补不回来。
把成本和结果 join 起来。 日志记的是 token 不是美元,所以先建一张视图把每次调用按 run ID 定价,再在 Athena 里算三个数——单成功任务成本、每次成功的重试次数、每次成功消耗的人工分钟。这三个数能扛住 CFO 的追问;"单次调用成本"只会美化那些爱循环的 agent。
对比 agent 和人要用 A/B 或 holdout。 面向客户/营收相关的,按访客、线索、账户或工单随机;内部流程(客服、编码助手)用匹配队列(团队、仓库组、pod)。四个维度看:效率、质量、成本、业务价值——一个维度涨、另一个明显掉,结论就是模糊的,得继续调。
最后落到五维记分卡(官方给的起点阈值,不是标准):
| 维度 | 指标 | 绿 | 黄 | 红 |
|---|---|---|---|---|
| 采用 | 活跃 / 目标用户 | >70% | 40–70% | <40% |
| 质量 | 无返工完成的任务 | >90% | 75–90% | <75% |
| 效率 | 每周省下的小时 | >目标 | 目标的 50–100% | <50% |
| 成本 | 单成功任务成本 | ≤预算 | 1–1.5× 预算 | >1.5× 预算 |
| 业务 | 对比基线的 KPI 提升 | 显著 | 边际 | 无或负 |
绿 = 扩;黄 = 调;红 = 停或重做。真正敢把红的 agent 下线,这套记分卡才有公信力。
八、我们的整理
8.1 从账单到人,四步就够
| 步 | 动作 | 判据(做完怎么知道成了) |
|---|---|---|
| 1 | 每个使用者一个 role(或网关按人传 session tags) | Cost Explorer 里 Bedrock 能按 iamPrincipal/user 分组出人 |
| 2 | 激活 IAM principal 成本分配标签 | 24h 后 CUR 里出现 iamPrincipal/ 前缀列 |
| 3 | CUR 2.0 导出(Hourly + caller identity + Athena) | Athena 能跑出"某人某天多少 token / 多少钱" |
| 4 | Budgets + Deny | 手动把阈值调低,该身份的 Bedrock 调用真的被拒 |
8.2 四个杠杆,按性价比排
- prompt caching——agent 路径上最大的一笔,因为它砍的是"每轮重发";
- 工具 schema +
maxTokens——比在 prompt 里求它"别废话"可靠; - 模型路由——同族里把简单请求丢给便宜模型;
- 批量推理——批量单价近似砍半,但不支持工具调用和多轮,只适合单轮批量活。
推理开关放在最后:先关,等基准证明它赚得回来再开。
8.3 和我们既有几篇的关系
- Agent 成本体检:92,413 个 token 的启动账(10-15)讲的是"上下文预算"这一个角,这篇补的是"任务级"的账;
- LLM 成本预测 和 哪些编程语言的 Token 效率最高 是同一个 tokenizer 效率问题在编码场景的实测版本——AWS 这篇把它的商业含义说清了:牌价低 15% 的模型,可能因为多切 40% 的 token 而更贵;
- LLM 成本控制简明教程 是手段清单,这篇给了验收口径(单成功任务成本 + 每次成功的人工分钟)。
九、三步动作
- 今天:拿你最贵的那条 agent 流水线,用
CountTokens把 2–3 个候选模型跑一遍,比的是 token 数不是价格。 - 本周:在你的 run 记录里补
humanMinutes和runId两个字段——没有这两个,后面所有 ROI 都是猜。 - 下次评审:只拿三个数上报——单成功任务成本、每次成功的重试次数、每次成功的人工分钟;其他都不要。
本文由 Software 2.0 编译整理,转载请注明出处。
Sources
- 原文:Majd Arbash、Ajit Mahareddy、Aswath Ram A Srinivasan《Optimizing cost per task and proving agent ROI on Amazon Bedrock》,AWS Machine Learning Blog,2026-11-12 https://aws.amazon.com/blogs/machine-learning/optimizing-cost-per-task-and-proving-agent-roi-on-amazon-bedrock/
- 前一篇:Arun Chandapillai 等《Tokenomics at scale: Track and cap Amazon Bedrock spend per IAM principal with CUR 2.0 and AWS Budgets》,AWS Machine Learning Blog,2026-11-12 https://aws.amazon.com/blogs/machine-learning/tokenomics-at-scale-track-and-cap-amazon-bedrock-spend-per-iam-principal-with-cur-2-0-and-aws-budgets/
同主题阅读