Agent 记忆 9 种格式互不相认:它缺一次 OpenTelemetry 时刻
AGENTS.md、/memories、Copilot 的仓库事实、MCP 图谱:四种形状,谁也读不懂谁。九种格式对照表,和一份记录该长什么样的骨架。
数一数你机器上有几种记忆格式。
数一数你机器上有几种记忆格式
列出编码工具会“记住”点什么的所有地方。今天一套典型配置是这样的:
- 大多数仓库里有一份
AGENTS.md或CLAUDE.md,少数仓库里有.cursor/rules/*.mdc; - 一个 agent 通过 Anthropic 的记忆工具往
/memories目录写文件; - Copilot 把每个仓库的事实存在 GitHub 那边;
- 一个记忆 MCP 服务器维护着一份 JSONL 格式的知识图谱。
这是四种不同的形状,而它们谁也读不懂谁。你的 CI agent 学到的一条经验,会留在写下它的那个东西里。你的编辑器 agent 读不到它,你下一个试的工具也读不到。
单看每一种格式,都是合理的。可合在一起,它们在反复重建同一个很小的想法:一条 agent 留给未来自己的笔记,存在某个地址上,在一段时间内为真。
而且这张名单还在变长。逛逛 r/ClaudeAI、r/LocalLLaMA 或 r/cursor,你会看到源源不断的“我给自己的 agent 做了一个记忆层”的帖子,每一个都有自己的存储、自己的 schema、自己的 MCP 工具。这恰好证明问题是真的:人们被它绊得太狠,以至于非造点什么不可。但每一个新方案都又多出了一种别人读不懂的格式。问题不是缺工具,是缺一份约定——而约定只能由社区一起做出来。
我自己就在造这类工具中的一个:开源的 LoreKit。这不是在推销“LoreKit 已经解决了记忆问题”。它的格式只是若干提案之一,自己也有缺口。重点是:现在正是该就一个共享形状达成一致的时刻,而另一个领域已经演示过该怎么做。
这一幕我们见过
2019 年之前,每一家可观测性厂商都提供自己的 agent、自己的埋点库、自己的数据格式。换一家厂商,你就得把代码重新埋一遍。两个开源项目 OpenTracing 和 OpenCensus 想解决这个问题,却又互相竞争。
2019 年,它们合并成了 OpenTelemetry。真正重要的,是各家厂商同意不再竞争的那些东西:
- 一个数据模型:span、metric、log record 分别是什么。
- 语义约定:
service.name、http.*这类共享命名。 - 一个协议:OTLP,发送数据的唯一方式。
- 参考实现:共享的 SDK 和 Collector。
厂商保留竞争的是它们拿数据做什么:存储、查询、分析。用户只埋一次点。我每天在 Dash0 和 OpenTelemetry 打交道,正是那纸约定,才让整个生态里的工具能互相读懂彼此的数据。
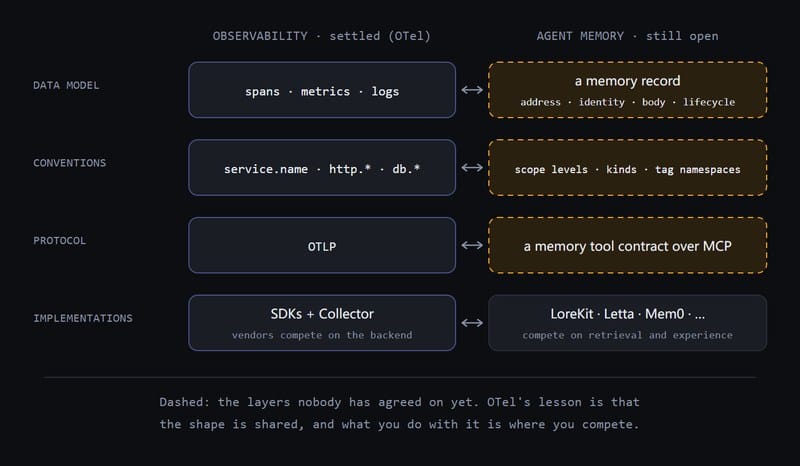
同样是这四层。可观测性领域在上面达成了一致,然后把竞争留到数据到达之后。Agent 记忆有的是实现,但它下面什么都没约定。
Agent 记忆正处在可观测性 2019 年之前的位置。时机也不坏:这些格式还年轻,改得动;而且已经有一个中立的、收留 agent 标准的地方——MCP 和 AGENTS.md 都归在 Linux 基金会下的 Agentic AI Foundation。
形状巡礼
这些东西变得很快,所以请把这些细节当作 2026 年末的一张快照。
| 家族 | 例子 | 记忆的单位 | 用什么寻址 | 遗忘方式 |
|---|---|---|---|---|
| 指令文件 | AGENTS.md、CLAUDE.md、Cursor 的 .mdc 规则 |
一整份 Markdown 文件 | 文件路径(Cursor 还要加 globs) |
永不遗忘。由人编辑它 |
| Agent 自管文件 | Anthropic 的记忆工具 | /memories 下的一个文件 |
模型自己挑的路径 | 永不遗忘,除非模型删掉它 |
| 托管仓库事实 | GitHub Copilot Memory | 一条带代码引用的“事实” | 一个仓库 | 28 天未使用即删除 |
| 上下文块 | Letta 的 core memory | 一个带字符 limit 的命名字块 |
agent 上的一个 label |
永不遗忘。永远在上下文里 |
| 抽取式事实 | Mem0 | 服务从消息里抽出的一条事实 | user_id / agent_id / run_id / app_id |
可设过期日期 |
| 命名空间存储 | LangGraph BaseStore |
一个 JSON value 字典 |
一个 namespace 元组 + key |
可设 TTL,默认在被读取时重置 |
| 知识图谱 | MCP 参考记忆服务器 | 实体、关系、观察 | 实体名 | 永不遗忘 |
| 时序图 | Graphiti / Zep | 图边上的一条事实 | 实体 + 边 | 事实不是被删除而是被宣告失效,且在两条时间线上分别记 |
| 可寻址记录 | LoreKit | 一条带作用域、key 和生命周期的记录 | 一个作用域字符串 + key |
永不遗忘,除非设了 TTL |
其中几种做对的地方,共享规范应该保留下来。Copilot Memory 把“可以对着代码核对的引用”和“默认遗忘”配在一起,可惜它被锁在一个产品里。LangGraph 展示了内核能有多小:put(namespace, key, value)。Graphiti 把时间建模对了:一条事实何时为真、何时被记录,两条时间线分开。而 AGENTS.md 证明了一件事:一个放在已知路径上的纯文本文件,可以成为标准。
已经存在的提案
已经有人开始动手了。MacPaw Research 的 Portable Memory 是一个 .mem 包,序列化字节可复现,带删除墓碑和可选签名;作者说它还没被广泛采用。Open Memory Protocol 是 2026 年 4 月的一份草案,用带清单的 ZIP 在平台之间搬运对话和由对话衍生出的记忆。Cognee 的 COGX 格式能从 Mem0、Letta 和 Zep 导入。
这些主要解决的是导出:把一个人的记忆从厂商 A 搬到厂商 B。而编码工具还有第二个、尚未解决的问题:实时寻址。当一个 CI 任务、一个编辑器 agent、一个评审 bot 同时在同一个仓库里干活时,它们怎样读写同一个位置,并对它的含义达成一致?一份完整的规范需要同时覆盖两件事。
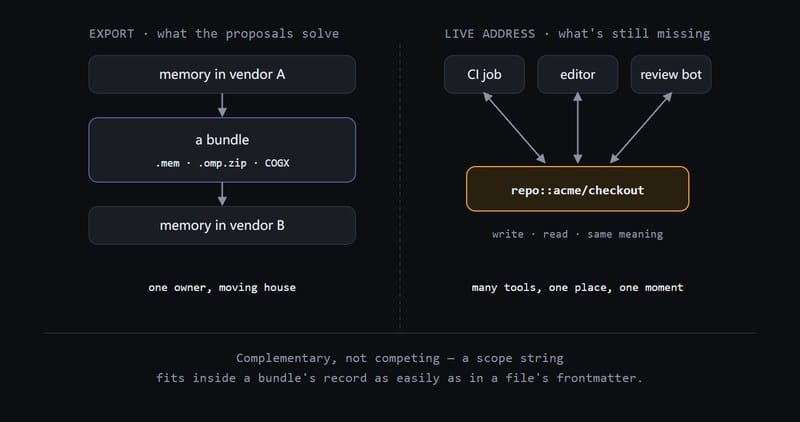
导出在厂商之间搬运一个人的记忆。实时寻址让多个工具在同一时刻共用一个位置。现有提案都聚焦在第一个上。一个共享的地址可以塞进它们的记录里,把第二个也覆盖掉。
一份共享规范可以长什么样
把品牌名剥掉,每一种格式其实都在回答同样四个问题,只是答案不同:一条记忆在哪里为真、它的身份是什么(第二次写入是更新它还是复制一份)、它说了什么、它何时不再为真。没人否认这四件事重要。工具们只是在答案上不一致——OpenTelemetry 最开始也是这样。
只有一个真分叉:谁写这条记忆。在指令文件里是人。在记忆工具、Letta 和 LoreKit 里是模型。在 Mem0 和 Graphiti 里,是一个服务从对话中抽取事实。规范不必从中选一个,它需要记录是哪一个,好让读取方知道该多信它读到的东西。
一条记录如果落成文件,大致可以长这样。它用来说明数据模型;字段名不是提案:
---
spec: agent-memory/0.1
id: 8f0c2a6e-4b1d-4c7a-9e2f-3a5b6c7d8e9f
address: { level: repo, value: github.com/acme/checkout }
key: tests-need-local-postgres
kind: lesson
written_by: { type: agent, name: claude-code }
content_type: text/markdown
lifecycle: { expires_at: null, extended_by: write }
attributes: { vcs.pr: 482, ci.run_url: "https://ci.example/runs/123" }
---
Integration tests fail with `ECONNREFUSED 127.0.0.1:5432` unless Postgres
is already running. Start it before `pnpm test`:
docker compose up -d db
The test setup does not start it for you.
front matter 是信封:address 和 key 说明它在哪里为真,id 是它的身份,lifecycle 说它何时失效,written_by 回答那个真分叉。下面的 Markdown 是记忆本身,content_type 告诉读取方该怎么处理它。工具需要的其它东西都放进 attributes,挂在别的工具可以忽略的命名空间下。同一条记录同样可以序列化成 JSON,给一个想把它通过网络发出去的工具用。
围绕这条记录,一份规范会照搬 OpenTelemetry 的分层:
- 约定:地址层级(
global、project、repo、branch,以及 monorepo 需要的东西)、种类的名称、属性命名空间(vcs.*、ci.*、agent.*)的共享命名,收在一个带版本的注册表里。 - 一份契约:几个操作(写、读、列、搜、归档),输入输出固定,通过 MCP 暴露。现在很多记忆服务器都提供 MCP 接口,但各自暴露的工具不同、含义也不同。
- 一致性测试,用来替代参考实现:把一条记录往返一次,检查什么都没丢;检查未知属性在一次重写后是否存活;检查过期行为是否符合声明。
同样重要的是把什么留在外面:存储、排序、向量、用户界面。那些才是工具该竞争的地方。而规范本身应该放在中立的地方,不在 LoreKit 的仓库里,也不在任何单一厂商的仓库里。
怀疑者会说什么
“你自己就在做记忆工具,当然想要一个照着它捏的标准。” 说得对。这也是为什么在表里 LoreKit 只是其中一行,而不是模板。如果一份共享规范长得不一样,LoreKit 也应该照样采用它。
“MCP 已经是标准了。” MCP 标准化的是调用,不是记录。OpenTelemetry 既需要协议,也需要数据模型。记忆两样都需要。
“共享记忆就是一条提示注入通道。” 是的。agent 读到的任何东西都能操纵它,而共享记忆扩大了谁能写它。规范应该把这件事变得可见:记录每条记忆是谁写的、允许签名(Portable Memory 已经这么做了)、让一条记录能指向它依赖的代码,这样读取方可以检查那段代码有没有变。没有任何格式能让投毒变得不可能。
“再多一个标准也治不好碎片化。” 这就是 xkcd 927,也是最有分量的反对意见。我的回答走 OpenTelemetry 的路:一致是在既有项目合并时出现的,而不是在有人又加了一个的时候。这里要做的事一样:把现有提案和工具各自做对的部分拿出来,在它们共有的部分上达成一致。
开放问题
这些问题的答案我不知道,我更愿意公开地一起想:
- 地址层级该有哪几级? Monorepo 需要
repo和branch之间的一级。层级应该是固定清单还是约定? - 遗忘该是默认行为吗? Copilot 默认遗忘,LoreKit 不遗忘,LangGraph 在读取时延长寿命。
- 一条记录该不该指向它依赖的代码? 这是对抗过期记忆最好的手段,但它把记录绑在了某个代码托管平台上。
- 该由谁来协调? 工作组、基金会,还是一份大家往上提修改的草案规范?
如果你在做表里任何一个工具,或者写过那些提案中的一份,我很想对一下笔记。LoreKit 的 schema 和磁盘格式以 MIT 许可开放,作为一份具体的输入。想看真实的记录长什么样,LoreKit 的离线存储会写普通的 Markdown 文件,你可以直接打开、grep、diff:
npx @lorekit/cli install
把它们和你其它工具写出来的东西比一比,然后告诉我:一份共享格式还需要什么,而这些工具一个都没有。
来源
- 原文:Agent memory needs its OpenTelemetry moment(LoreKit 博客,2026 年 11 月)
- 文中提到的项目:Portable Memory(MacPaw Research)、Open Memory Protocol(2026 年 4 月草案)、Cognee 的 COGX、LoreKit、Dash0
- 基金会归属:Linux Foundation Agentic AI Foundation(MCP 与
AGENTS.md所在)
编者补充
原文作者是 LoreKit 的作者,他在文里明确披露了这一点,也明确说“LoreKit 只是表里一行”。我们的整理补两件他没展开的事,都是给做选型的人用的。
第一,这九个“家族”其实可以按失效方式压成三类,选型时比按存储形态分类更好用:
| 失效方式 | 家族 | 你要付的代价 |
|---|---|---|
| 永不失效,靠人编辑 | 指令文件、上下文块、知识图谱 | 上下文成本固定,且会随规模腐坏 |
| 有生命周期 | 托管仓库事实(28 天)、抽取式事实(过期日)、命名空间存储(TTL)、可寻址记录 | 要有人定 TTL,定错了就丢经验 |
| 只宣告失效、不删除 | 时序图(Graphiti / Zep) | 存储只增不减,换来可回溯 |
第二,“实时寻址”这一半,MCP 社区其实已经在别的地方做过一次:MCP 的 resources 和 prompts 就是“多个客户端共用一个地址”的最小版本。差别在于它们没有约定“这个地址上东西的含义”,所以三个工具读到同一份文件,可以得出三种解释。这正是原文说“MCP 标准化了调用,没标准化记录”的意思。
边界:原文所有数字(Copilot 的 28 天、LangGraph 的 TTL 语义、Portable Memory 的“尚未广泛采用”)都是作者在 2026 年末的快照口径,没有独立验证;表里的“永不遗忘”指的是默认行为,不是能力上限。
本文由 汇智网 · Software 2.0 编译整理,转载请注明出处。
这是「Agent / MCP」专题的一部分。完整地图见:Agent / MCP / 自动化完全指南