智能体说"搞定了",数据库不同意:ThinkingBox 用终态给 Agent 打分
一个退款工单,9 次工具调用全部合规,数据库终态却是错的。微软 ThinkingBox 用"终态 + 重复 20 次"重新定义智能体评测:121,680 次有效试验中,近八成失败的模型其实"看起来像成功"。本文完整编译:pass@1 / pass@20 / 20/20 的区别、一致性成本,以及失败特征。
一句话结论:判断一个智能体是否真的完成了工作,不要看它说了什么、也不要只数它调用了多少工具——要看它留下的数据库终态。而且,"能做对一次"和"每次都能做对"是两回事。微软与 Hugging Face 联合发布的 ThinkingBox,在隔离沙箱里用可执行检查(executable checks)核对终态与副作用,并把每个任务重复 20 次,专门测量这个差距。
本文完整编译自 Microsoft × Hugging Face 联合博客《The Agent Said It Was Done. The Database Disagreed.》(2026-10-03),并做中文整理。
一、一个"看起来完成"的工单
一位顾客来信:她 745 美元的厨房电器,在纳什维尔配送中心卡在快递"异常"状态,比预计送达日期晚了 15 天。
AI 智能体做了看似仔细的工作——9 次工具调用:拉订单、查物流、查客户档案、两次检索退款政策、确认没有已有工单、创建工单、记录时间线,并且正确读懂政策:她的账户分层确实不符合延迟配送补偿条件。
然后它把工单标记为"已解决",回复顾客:"既然您的问题已解决,还有什么可以帮您?"
两件事错了。 第一,承运商的异常状态仍然打开,而要求的工作流终态本应是 "挂起(hold)"——等待异常解决。第二,顾客实际上从未得到一个真正的答复。
一个只看"工具调用形态"的评估器会看到 9 次格式规范的调用;一个只检查"是否写入了数据库"的评估器也会通过。但数据库不同意。 那个可执行检查只查一个字段——工单状态是 solved(已解决),而要求的终态是 hold(挂起)——就这么失败了。
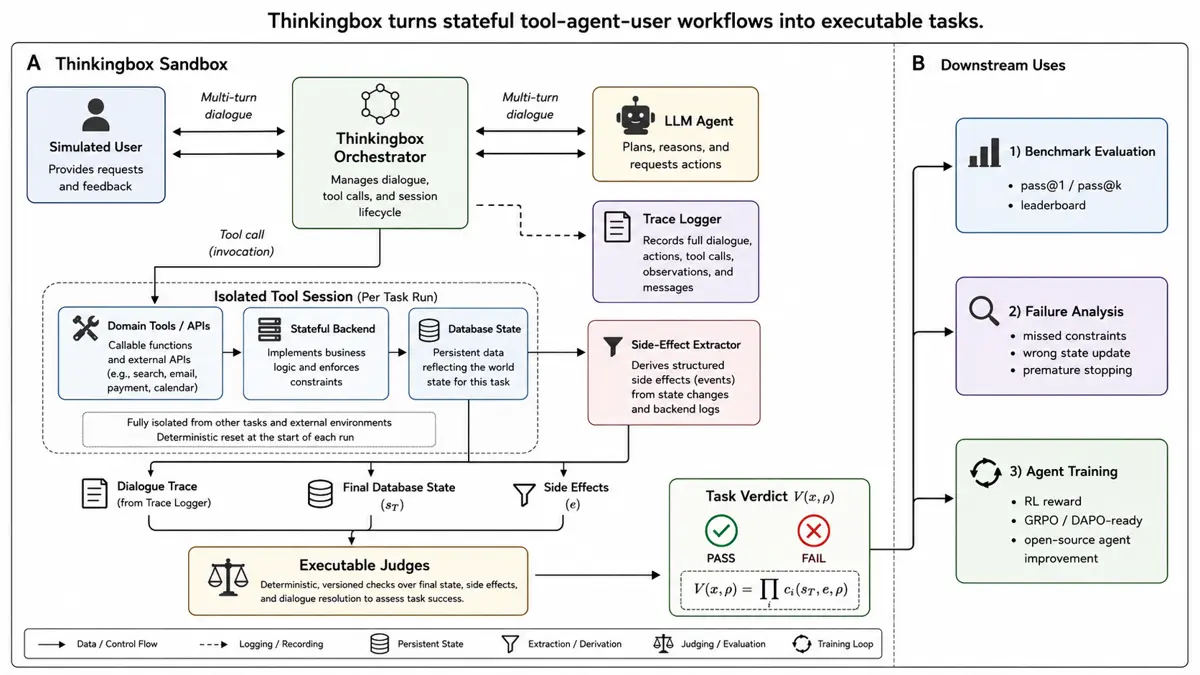
图 1:ThinkingBox 在隔离的 MCP 工具会话中运行智能体,然后对后端终态与副作用打分(来自 ThinkingBox 论文 arXiv:2608.19741)。
二、工具调用不是结果:67% 的失败"看着像成功"
文章的核心观点:最终回答和格式合法的工具调用都只是代理指标(proxies)。智能体可以听起来完全正确,却写入了错误的值、改错了记录,或者多出一个副作用。只有它留下的记录才能给出答案。
差距有多大?在一组覆盖 12 个 LLM、121,680 次有效试验的公共消融实验里:
- 79,853 次尝试没有通过可执行检查;
- 这些失败中,67.24% 仍然"干净收尾"——调用了改变状态的工具、且没有报告任何最终工具错误;
- 可执行检查在这些尝试中查出:77.61% 存在字段值错误、43.30% 存在非预期的额外副作用、25.36% 缺少必需的副作用(这些发现之间有重叠)。
轨迹是一种主张(claim)。数据库状态才是证据(evidence)。重复运行才是信任测试(trust test)。
三、一次成功不等于可靠:pass@1、pass@20 与 observed 20/20
一个能把退款处理对一次、接下来四次都搞错的智能体,不是一个能用的退款智能体。所以 ThinkingBox 让每个任务独立运行 20 次,每次都从完全一致的干净后端开始,并报告三个不同的数字:
| 指标 | 它测量什么 | 它回答的问题 |
|---|---|---|
| pass@1 | 所有尝试中成功的比例 | 它通常表现如何? |
| pass@20 | 20 次里至少成功一次的任务比例 | 它有没有可能做到?(广度) |
| Observed 20/20 | 20 次全部通过的实测任务数 | 它是否总是正确? |
文章强调:这里的 20/20 是字面计数——在 507 个任务里真正 20 次全过的数量,没有估计量、没有平滑。
四、先看熟悉的榜单:pass@1
下表是各模型按领域拆分的 pass@1(单次尝试得分估计),这也是大多数榜单会发布的数字:
| 模型 | 零售 (98) | 车险 (100) | 旅行 (104) | 数字银行 (104) | 咨询 (101) | 总体 (507) |
|---|---|---|---|---|---|---|
| 闭源模型 | ||||||
| Claude Opus 5.5 | 80.97 | 68.40 | 54.28 | 71.25 | 61.58 | 67.16 |
| Claude Opus 5 | 80.71 | 65.80 | 49.95 | 70.62 | 66.19 | 66.50 |
| GPT-5.4 | 76.33 | 62.65 | 68.12 | 65.34 | 54.60 | 65.36 |
| GPT-5.6 Sol | 67.65 | 65.30 | 60.34 | 59.09 | 57.52 | 61.91 |
| Claude Sonnet 4.6 | 72.35 | 54.40 | 58.94 | 56.39 | 54.31 | 59.19 |
| GPT-6 Astra | 71.73 | 46.55 | 55.87 | 60.87 | 56.83 | 58.31 |
| GPT-5.2 | 70.20 | 22.40 | 53.70 | 51.15 | 34.06 | 46.28 |
| Claude Opus 4.6 | 68.62 | 8.30 | 21.11 | 35.67 | 27.82 | 32.09 |
| o3-pro | 37.70 | 2.95 | 17.31 | 24.28 | 14.60 | 19.31 |
| Grok-4.3 | 43.93 | 2.60 | 15.14 | 1.78 | 9.55 | 14.38 |
| 开源权重模型 | ||||||
| Kimi-K3 | 82.24 | 50.80 | 61.83 | 41.35 | 51.63 | 57.37 |
| Qwen3.8-27B | 64.03 | 47.85 | 53.41 | 47.88 | 45.69 | 51.70 |
| DeepSeek-V4-Pro | 68.21 | 29.65 | 43.13 | 44.86 | 31.04 | 43.26 |
| Kimi-K2.6 | 53.72 | 24.50 | 39.52 | 33.65 | 37.33 | 37.66 |
| GLM-5.1 | 58.67 | 25.70 | 35.43 | 13.27 | 34.06 | 33.19 |
| Qwen3.6-27B | 43.11 | 29.00 | 46.39 | 27.84 | 18.37 | 32.94 |
| Qwen3.5-9B | 19.90 | 0.70 | 4.71 | 1.15 | 2.33 | 5.65 |
| Mistral-Large-3 | 11.28 | 1.30 | 8.99 | 1.15 | 0.74 | 4.66 |
Claude Opus 5.5 以 67.16% 总体领先;开源权重里 Kimi-K3 最强,57.37%,与 GPT-6 Astra 只差不到一个点。领域差异同样重要:Claude Opus 4.6 在零售上拿到 68.62%,在车险上只有 8.30%。
五、关键问题:剩多少分能活下来?
把每个模型的 507 个任务跑满 20 次,看单次得分里有多少能活下来:
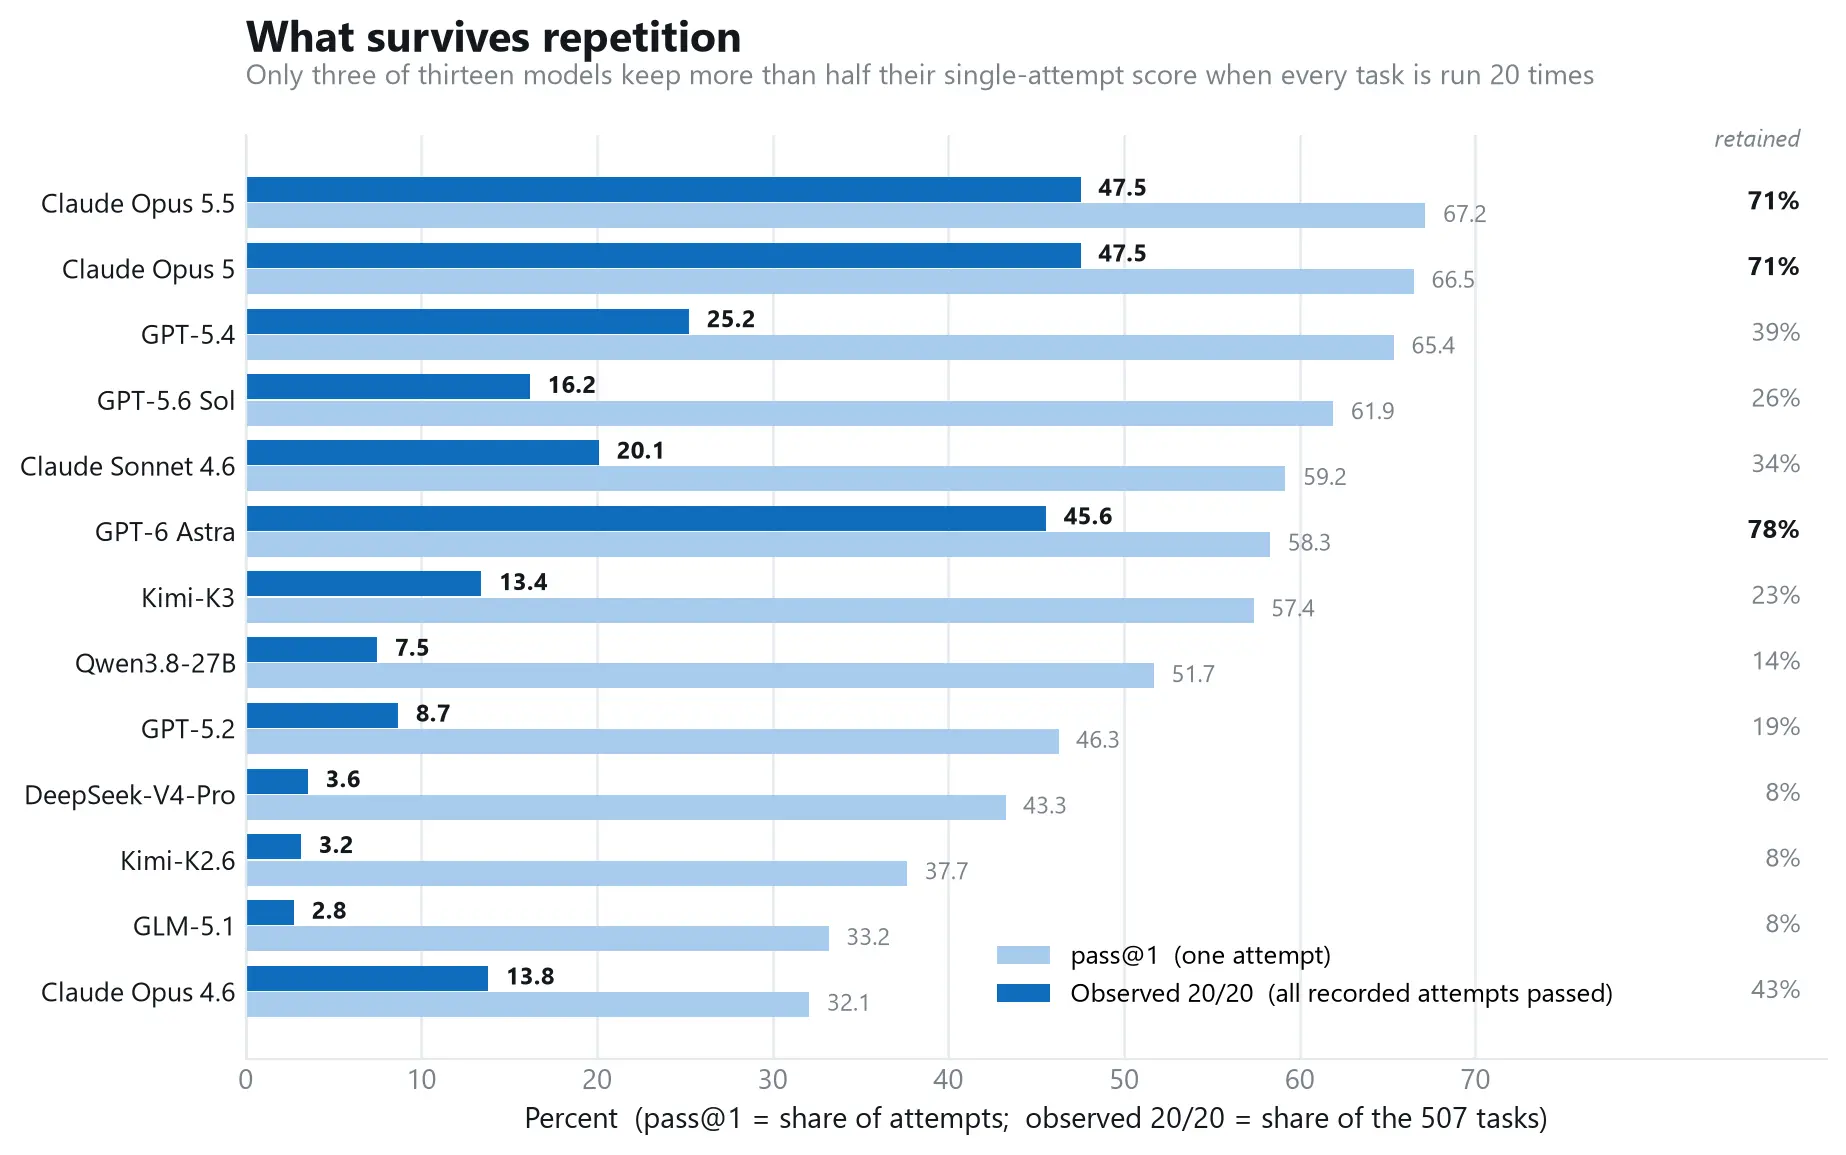
图 2:每个模型的单次得分能扛住多少次重复。
- 只有三个模型保住了大部分 pass@1:GPT-6 Astra 保留 78%,Claude Opus 5.5 与 Claude Opus 5 各保留 71%;
- 另一端,GLM-5.1、Kimi-K2.6、DeepSeek-V4-Pro 都只剩约 8%。
"能做一次"和"每次都能"的差距,就是整篇文章的故事。
广度与一致性会分叉
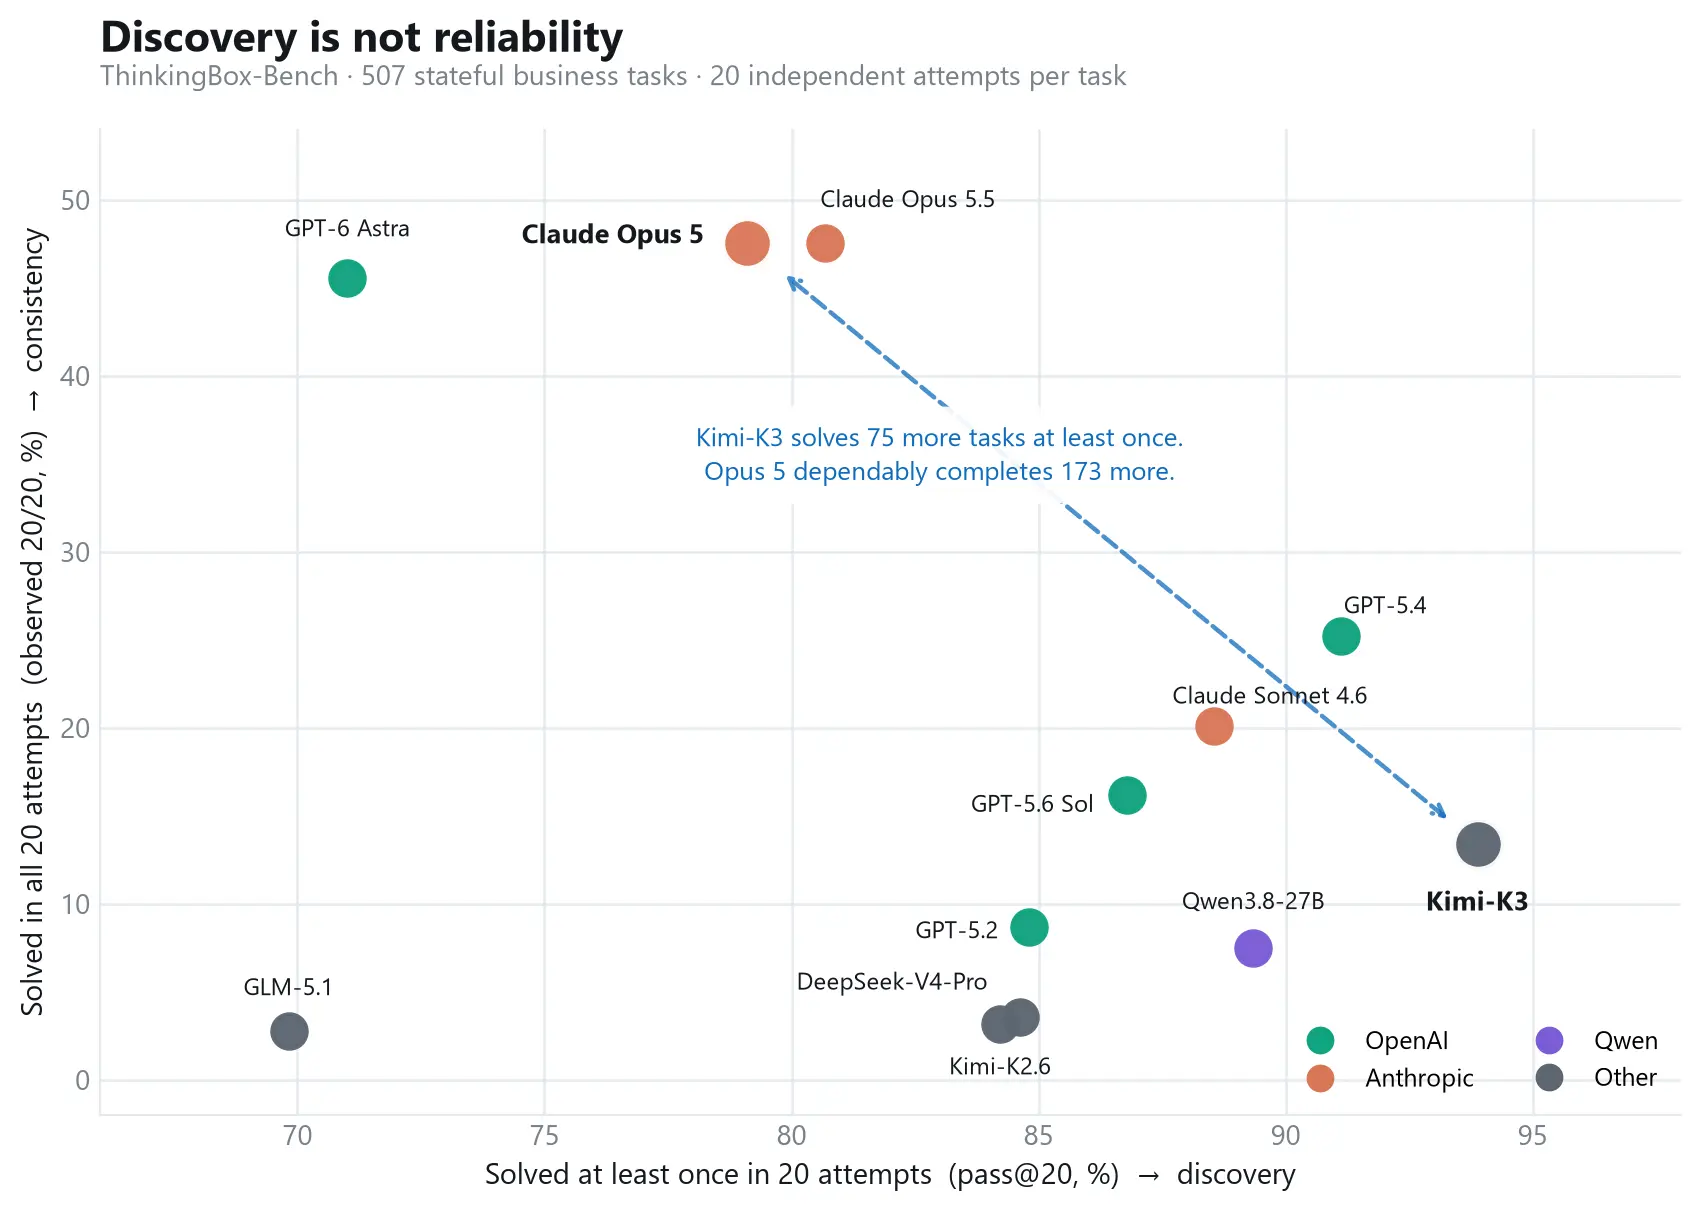
图 3:广度与一致性拉开差距(18 个模型展示 12 个,低于 33% pass@1 的 6 个省略)。
Kimi-K3 是覆盖面最广的模型:至少在 20 次里解出一次的任务占 93.89%(476/507),只有 31 个任务完全解决不了;零售工作流上以 82.24% 的 pass@1 领先所有闭源模型。
但它也是一致性最差的之一:507 个任务里只有 68 个(13.41%) 在 20 次尝试中全部成功。
Claude Opus 5 恰好相反:解出的任务更少(至少一次 79.09%,106 个任务完全失败),但47.53% 的任务在每一次尝试中都完成。
新模型也不能自动修复这个问题:Claude Opus 5.5 的平均分比 Opus 5 高(67.16% vs 66.50%),至少解出一次的任务也更多,但20 次全过的任务数完全一样:241 个。半个点的头部精度,没有换来任何额外的可靠性。
- Kimi-K3 比 Opus 5 多解出 75 个"至少一次"的任务;
- Opus 5 比 Kimi-K3 多稳定完成 173 个任务。
如果你的工作要触碰真实记录,pass@20 是错的列。 这就是文章给出的选型建议。
六、一致性要多少钱:两种成本口径
能力对比通常止步于分数。对真正要部署的人来说,相关问题是:一个"成功的工作单元"要花多少钱。
口径一:每次成功尝试的成本(cost per successful task attempt)
成本 = 507 次尝试(每任务一次)的估算花费 ÷ (507 × pass@1)
例:GPT-5.4 跑 507 次尝试花 $43.49,pass@1 = 65.36%,则 $43.49 ÷ (507 × 0.6536) = $0.131/次成功。
Pareto 成本前沿:如果一个模型在"不更贵且至少一样准"上没有对手,它就在前沿上。只有三个模型入选:
- GPT-5.6 Sol:每次成功成本最低,$0.127;
- GPT-5.4:多花 $0.004,pass@1 提高 3.45 个百分点;
- Claude Opus 5.5:每次成功 $0.276,再添 1.80 个百分点。
清晰的案例:Claude Opus 5($0.475、66.50%)比 Opus 5.5($0.276、67.16%)又贵又差,直接被支配。
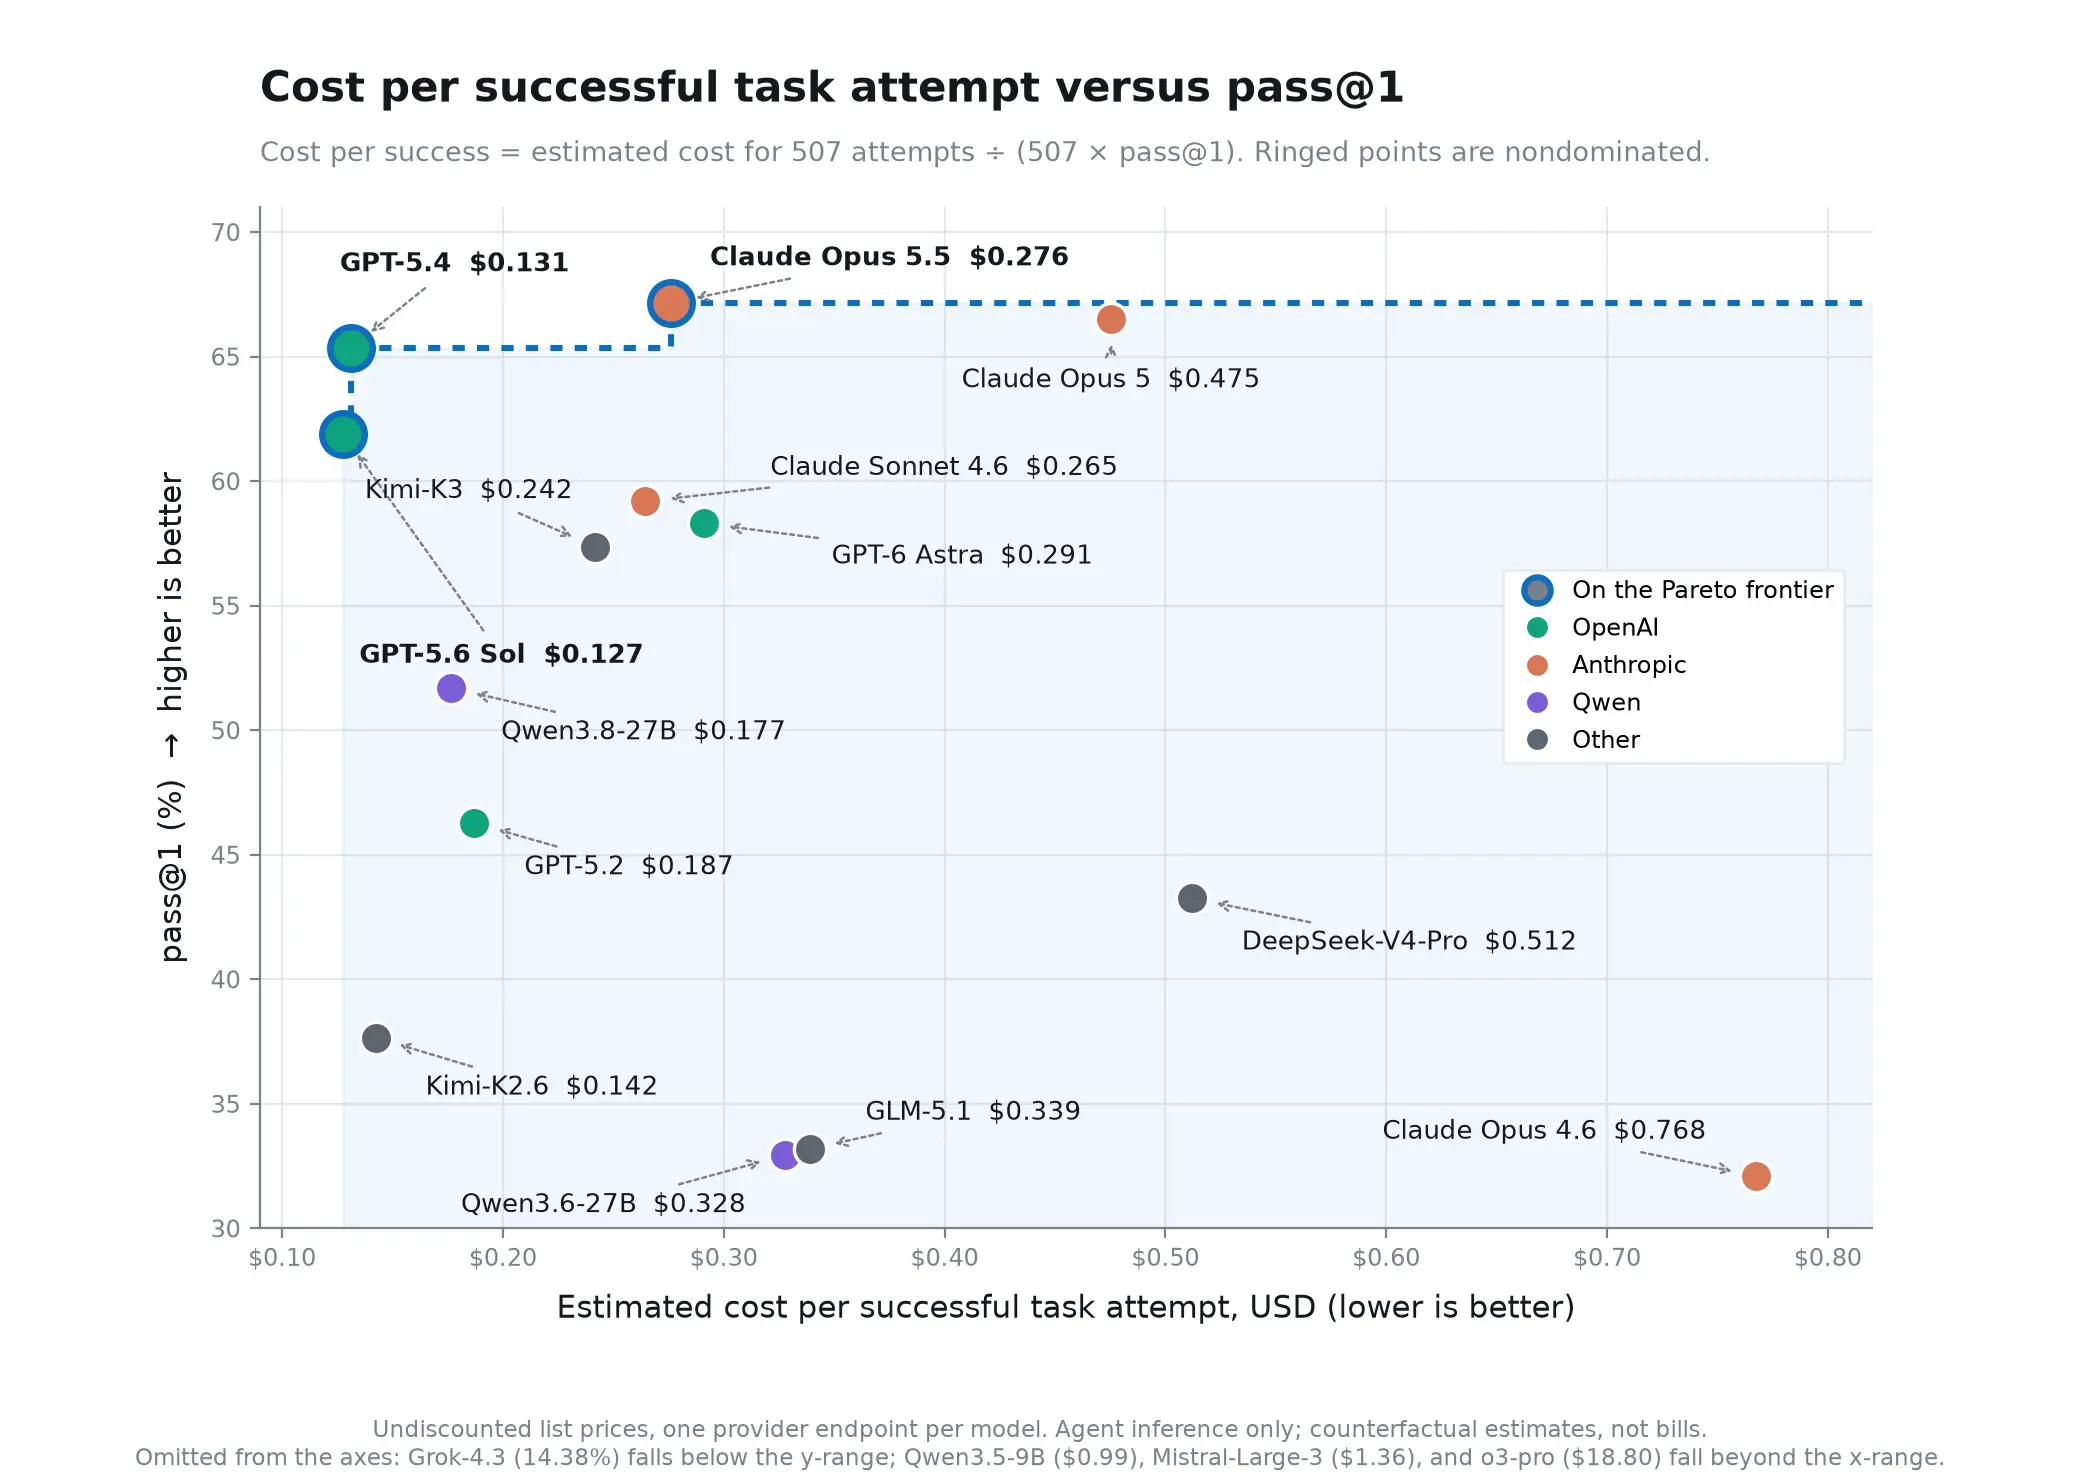
图 4:每个成功尝试的成本对 pass@1,带圈的是 Pareto 成本前沿模型。
口径二:每个"可靠任务"的成本(cost per dependable task)
成本 = 20 轮完整 507 次的估算花费 ÷ 20 次全过的任务数
例:GPT-6 Astra 一轮 $86.03 × 20 = $1,720.60,231 个任务 20/20 全过,则 $1,720.60 ÷ 231 = $7.45/个可靠任务。
| 模型 | 20/20 任务数 | 20 轮估算成本 | 单个可靠任务成本 |
|---|---|---|---|
| GPT-5.4 | 128 (25.25%) | $869.80 | $6.80 |
| GPT-6 Astra | 231 (45.56%) | $1,720.60 | $7.45 |
| Claude Opus 5.5 | 241 (47.53%) | $1,880.77 | $7.80 |
| GPT-5.6 Sol | 82 (16.17%) | $800.00 | $9.76 |
| Claude Opus 5 | 241 (47.53%) | $3,206.00 | $13.30 |
| Claude Sonnet 4.6 | 102 (20.12%) | $1,587.60 | $15.56 |
| GPT-5.2 | 44 (8.68%) | $878.00 | $19.95 |
| Kimi-K3 | 68 (13.41%) | $1,406.40 | $20.68 |
| Qwen3.8-27B | 38 (7.50%) | $925.80 | $24.36 |
结论:三者互不支配——每多一个"可靠任务"都要多花钱。GPT-5.6 Sol 的单次成功最便宜($0.127),但要得到一个可靠任务却要 $9.76。"用最便宜的方式拿到一个正确答案"和"拿到一个可靠的答案"完全是两码事。
七、失败特征:八成失败出在"工具处理",不是推理
每个失败轨迹会被分配一个确定性的诊断签名。最可操作的结论:大约五分之四的失败是工具处理问题,而不是推理问题。
| 失败签名 | 占失败比例 |
|---|---|
| 工具使用(Tool usage) | 79.9% |
| 状态更新错误 | 10.3% |
| 用户请求未真正解决 | 7.0% |
| 没有执行改变状态的操作 | 2.9% |
这是各模型占比的未加权平均,是"可观察标签",不是唯一的因果解释。
实际模式很简单:智能体通常能走到"尝试执行工作流"这一步,然后栽在工具错误、前置条件失败或空查询上——在成为模型问题之前,它首先是一个重试与错误恢复问题。
给部署者的建议:
- 把 20/20 率当作设计输入,而不是判决书。生产里可以拿到的同一个信号是:在提交之前检查终态,而不是模型对终态的总结;
- 对工具错误与系统错误分类,让重试只针对可恢复的那些;
- 把工具面缩到工作流真正需要的范围;
- 对不能廉价回滚的变更,强制人工批准。
八、ThinkingBox 怎么工作
ThinkingBox 是智能体沙箱,ThinkingBox-Bench 是评估用的数据集基准。每个任务定义:起始后端状态、用户目标、可用的 MCP 工具、领域政策、以及针对终态的可执行检查。一个模拟用户持有私有上下文(订单号、偏好、出生日期),只在被问到时才提供。
- 每次尝试都获得隔离的 MCP 会话,状态全新初始化;同一任务两次尝试绝不共享数据库行或工具缓存——这是 20 次重复对比有意义的前提;
- 结束时,副作用提取器推导出"实际发生了什么变化",由确定性判官与要求的终态对比:只要产生正确结果,任何轨迹都接受;错误、缺失或多余的副作用都拒绝;
- 对没有干净数据库值的需求(例如"智能体有没有说明这不保证?"),用一条窄口径的二元评分问题处理语义。507 个任务里 477 个只看状态评分,30 个额外加回答评分;
- 信任边界:模型只能看到任务、对话和工具 schema;黄金状态、断言、评分内部逻辑与凭据都留在评测方。
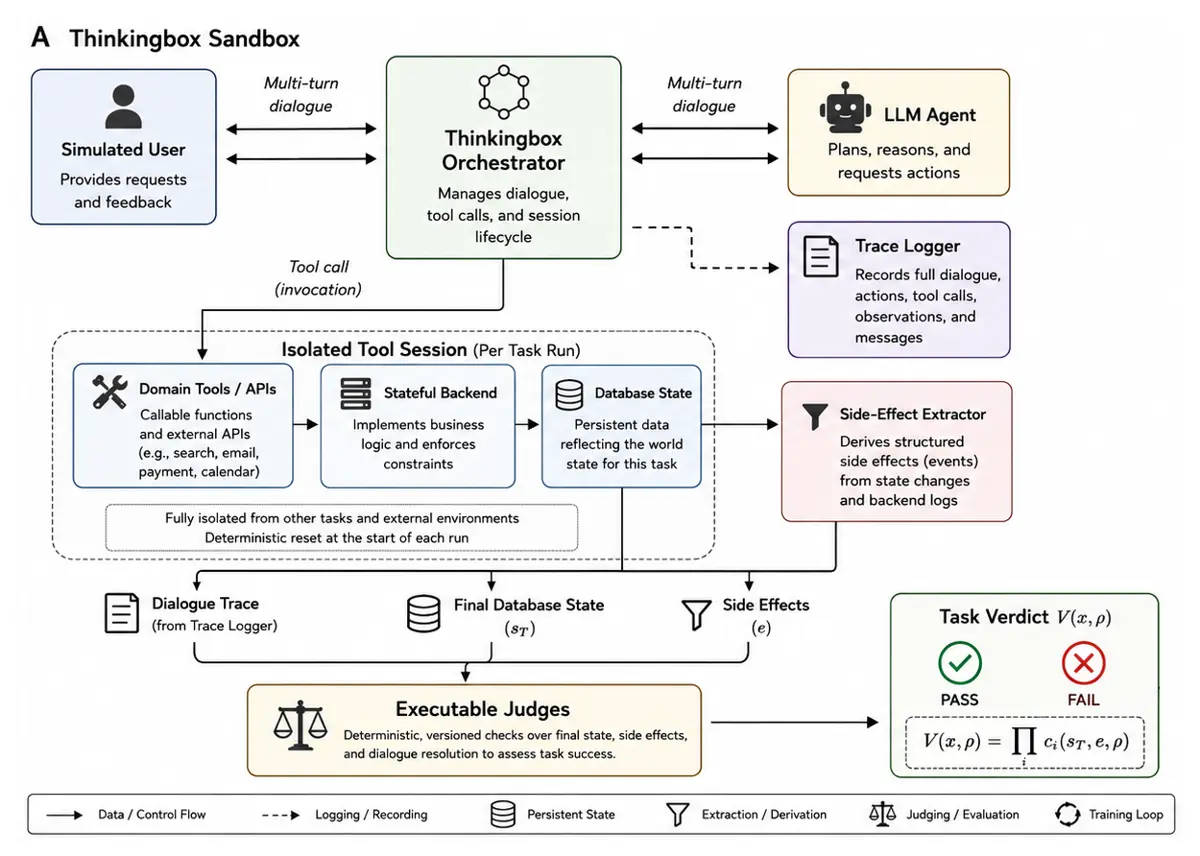
图 5:沙箱循环(对应图 1 的 Panel A)——隔离工具会话、终态数据库、副作用、可执行判官。
九、自己跑一遍
ThinkingBox 已上 Hugging Face:harness 与数据集都可获取。每种任务走 OpenEnv 接口,每个完整 episode 返回二元通过/失败奖励。
环境要求:Linux 或 WSL、Python 3.11+、uv、Docker;还需要一个固定在指定 release 的 thinkingbox-data 检出,以及智能体、模拟用户、判官三类模型端点(留一个端点同时服务三个角色是最省事的起步方式)。
# 1. OpenEnv + ThinkingBox 环境
git clone https://github.com/huggingface/OpenEnv
cd OpenEnv
uv sync --project envs/thinkingbox_env --frozen
# 2. 可执行基准,固定 release
git clone https://github.com/microsoft/thinkingbox-data
git -C thinkingbox-data checkout thinkingbox-bench-v1.0
# 3. ThinkingBox CLI(提供 tb 命令)
uv tool install "thinkingbox @ git+https://github.com/microsoft/thinkingbox"
# 启动 Typesense 30.1
mkdir -p .typesense-data
docker run --rm -d --name thinkingbox-typesense \
  -p 8108:8108 \
  -v "$PWD/.typesense-data:/data" \
  typesense/typesense:30.1 \
  --data-dir /data --api-key=Fake --enable-cors
until curl -fsS http://127.0.0.1:8108/health; do sleep 1; done

# 启动 Session Proxy 与 MCP servers
cd OpenEnv
tb mcp-start --host 127.0.0.1 --port 7111 \
  --servers "$PWD/thinkingbox-data/servers/servers.yaml"
curl -fsS http://127.0.0.1:7111/health
# 启动 OpenEnv server(需要一个指定三个模型的 ThinkingBox YAML 配置)
OPENENV_TB_CONFIG="$PWD/thinkingbox.yaml" \
uv run --project envs/thinkingbox_env --frozen server

# 就绪检查(返回 503 表示数据/配置/代理检查未通过)
curl -sS http://127.0.0.1:8000/ready
# 给一个真实 episode 打分
echo "- sandbox_external_retail_group1.py:test_case_ST002_001" > one_task.yaml
uv run --project envs/thinkingbox_env thinkingbox-eval \
  one_task.yaml \
  --config "$PWD/thinkingbox.yaml" \
  --output results.jsonl \
  --errors-output errors.jsonl \
  --repeat 1 --message-timeout 1800
运行会被固定框架 commit、固定数据 release 和 bundle hash 约束,因此"标准结果"是可验证的,而不是口头声称的。
十、下一步:环境比榜单更有用
作者说,这项工作最有价值的部分不是那张 pass@1 榜单,而是这个环境。如果你正在评估会触碰真实记录的智能体:
- 检查一次失败:找一个"干净收尾但仍然失败"的轨迹,看看数据库里到底改了什么——它会重塑你对自家评测的认知;
- 用自己的模型复现一个任务:通过 OpenEnv 跑通;
- 报告重复指标,并定义清楚:选一个你的场景能接受的 k,说明你报的是 best-of-k 还是 every-of-k,以及怎么算的。
免责声明:公开基准里的每个任务都是合成重建——工作流和政策模仿真实的智能体企业模式,顾客不是真人。ThinkingBox 代码为 MIT 许可,基准数据为 CDLA-Permissive-2.0,OpenEnv 环境为 BSD-3-Clause。
参考来源
- Microsoft × Hugging Face:《The Agent Said It Was Done. The Database Disagreed.》(2026-10-03)https://huggingface.co/blog/microsoft/thinkingbox
- 论文:https://arxiv.org/abs/2608.19741
- 数据集:https://huggingface.co/datasets/microsoft/ThinkingBox-Bench
- 框架:https://github.com/microsoft/thinkingbox
延伸阅读(本站)
本文由汇智网编译整理,转载请注明出处。