AI 编程评测复盘:推理档位开满,36 题 196 个检查点
同一套题跑 10 遍:档位开满贵 2–4 倍,通过数却没跟着涨;检查点过了,最后的代码还是挂着一两千个失败用例。
一句话结论:把「分阶段改需求」当考卷时,前沿 Agent 的严格通过率只有 12.2%–16.3%——也就是说,绝大多数检查点上,它们没能做到「新功能做对、旧功能全不挂」。而把这套题跑满十遍之后,最反直觉的一条是:推理档位(effort)开满,花的钱多 2.1–4.2 倍,通过数却没有跟着涨。Opus 5.5 甚至从 Medium 的 28 个降到 XHigh 的 25 个。
披露:本文编译自 HumanLayer 仓库 advanced-context-engineering-for-coding-agents 的公开记录《SlopCodeBench update 10/2026》(Dex Horthy 撰写,2026-10-15,Gabe Orlanski 与 SlopCodeBench 团队参与)。基准本身由 SlopCodeBench 团队维护,论文见 arXiv:2603.24755。该仓库长期发布 agent 上下文工程相关实践,作者与所测模型厂商无隶属关系;文中成本均为估算值而非发票,作者也明确写了「单次运行不能归因」。本文未做独立复测,数字以原文为准。
一、这份考卷到底在考什么
多数代码基准是「给一个题目,看能不能写出来」。SlopCodeBench 换了个更接近真实开发的方式:分阶段给需求。
Agent 先写一版程序;然后需求变了,它要在已有代码上改;再变,再改。后一个检查点既测新行为,也测前面所有行为有没有被改坏。原文的比喻是:这对应软件真实的样子——需求在建设过程中不断变得清晰、也不断变化。
于是分数分成两档,这两档的差距是全文的骨架:
| 口径 | 判定 | 这轮区间 |
|---|---|---|
| Strict(严格通过) | 每个测试类别全过,含 Regression | 12.24%–16.33% |
| Core(核心通过) | 非空 Core 类别全过即可;前面检查点挂了也不影响后面算分 | 65.8%–74.0% |
一句话读法:core 高、strict 低,说明「这一步要做的事」经常能做出来,但「之前做对的事」在改需求的过程中被弄坏了。作者的原话是——「Agent 把主行为做对的次数,远远多于它把所有已测行为在需求变化中保持可用的次数」。
对比一下时间线也有意思:2026 年 5 月,gpt-5.5 的 strict 是 14.8%;9 月这轮最高的 gpt-6 astra 是 16.3%。四个月涨了 1.5 个百分点。
二、这轮怎么跑的(复现口径)
想反驳或复现,先对齐这几项:
- 36 道题、196 个检查点(每个设置下);每个检查点等权计入通过率,所以检查点多的题权重更大
- 每个检查点基于上一个检查点留下的代码继续改,不是每题从零开始
- 10 个完整 campaign(完整跑完 36 题);另外两个(Opus Max、GPT-6.1 XHigh)在采集时未跑完,被排除
- 固定:
v1.0题库、官方just-solve提示、seed 42、any-case运行器判定、Docker + Python 3.12 + uv - 每个「模型 × 档位」只跑一次
最后这条要先记住:后面所有关于档位的结论,边界都在这里。作者自己写得很清楚——「一个设置只跑一次,区分不了多少是运行间的波动」。
三、结果:十次完整 campaign
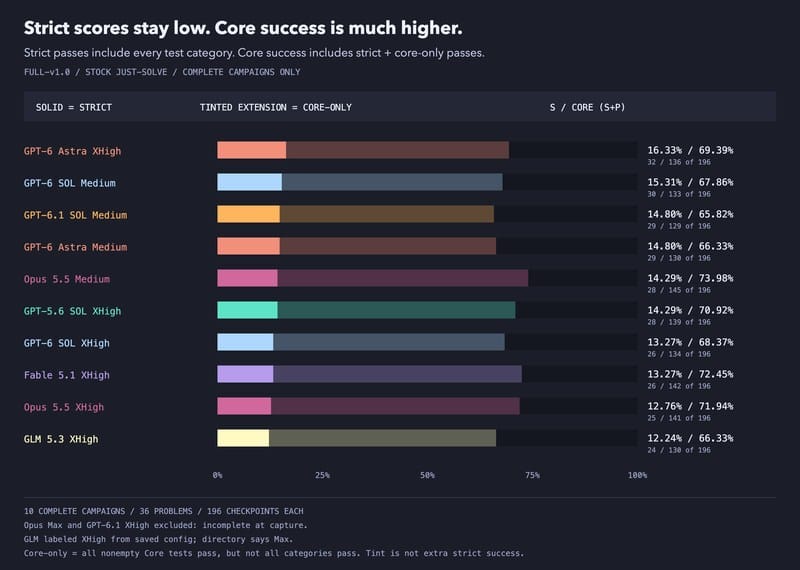
图 1:strict 24–32 / 196,core 129–145 / 196。浅色段不是额外的严格通过。原图见文末来源。
| Campaign | Strict | Strict 率 | Core 率 | 估算成本 |
|---|---|---|---|---|
| GPT-6 Astra XHigh | 32/196 | 16.33% | 69.39% | $758.62 |
| GPT-6 SOL 6 Medium | 30/196 | 15.31% | 67.86% | $245.69 |
| GPT-6 SOL 6.1 Medium | 29/196 | 14.80% | 65.82% | $178.51 |
| GPT-6 Astra Medium | 29/196 | 14.80% | 66.33% | $261.05 |
| Opus 5.5 Medium | 28/196 | 14.29% | 73.98% | $193.47 |
| GPT-5.6 SOL XHigh | 28/196 | 14.29% | 70.92% | $753.30 |
| Fable 5.1 XHigh | 26/196 | 13.27% | 72.45% | $1,550.07 |
| GPT-6 SOL XHigh | 26/196 | 13.27% | 68.37% | $517.32 |
| Opus 5.5 XHigh | 25/196 | 12.76% | 71.94% | $817.04 |
| GLM 5.3 XHigh | 24/196 | 12.24% | 66.33% | $365.13 |
两个值得记住的细节:
- 榜首的领先幅度很小。Astra XHigh 是 32 个,比 SOL 6.1 Medium 只多 2 个检查点。
- core 榜首和 strict 榜首不是同一个。Opus 5.5 Medium 的 core 最高(145/196),但 strict 只有 28/196——它「该做的常做对」,但「不该坏的容易坏」。
四、发现一:档位开满,不保证更准
三个模型同时跑了 Medium 与 XHigh,这是全文最有价值的一组对照:
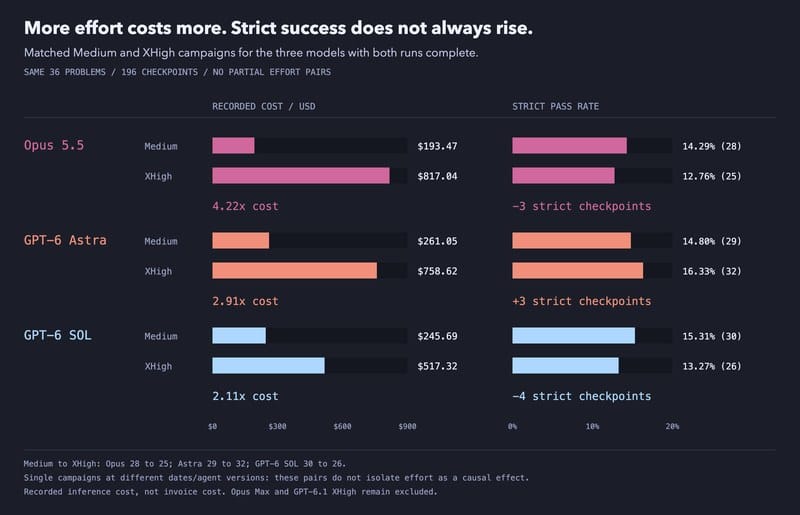
图 2:三对完整 campaign 的成本与 strict 通过数。XHigh 在三对里都更贵,只有 Astra 的 strict 上升。
| 模型 | Strict:Medium → XHigh | Core:Medium → XHigh | 成本倍数 |
|---|---|---|---|
| Opus 5.5 | 28 → 25 | 145 → 141 | 4.22× |
| GPT-6 SOL | 30 → 26 | 133 → 134 | 2.11× |
| GPT-6 Astra | 29 → 32 | 130 → 136 | 2.91× |
三个模型里只有一个(Astra)在提档后变好;Opus 5.5 和 GPT-6 SOL 都变差了,且 Opus 的代价最高——贵 4.22 倍,少 3 个检查点。
作者对这条结论的措辞很克制,值得照抄:
这不能证明「更多推理会伤害编程」。它说明的是:在这几轮里,更高的档位不是买严格通过率的可靠手段。
同时他也留了口子:单轮运行区分不了涨跌是模型效应还是波动;不同档位是不同日期、不同 agent 版本跑的,因此不能当成因果实验。
五、发现二:成本与分数几乎无关
十次 campaign 的估算成本横跨 $178.51–$1,550.07,而 strict 通过率只横跨 12.24%–16.33%。
- 最便宜的一次:GPT-6.1 SOL Medium,$178.51,29 个 strict——和 Astra Medium($261.05)同分
- 最贵的一次:Fable 5.1 XHigh,$1,550.07,26 个 strict——是前者的 8.68 倍成本,少 3 个检查点
这也解释了为什么「换更贵的档位试试」通常不是解法:它买到的确定性远低于直觉。反过来说,把档位当默认值而不是调优旋钮,在这个基准上更容易复现出稳定结果。
六、发现三:检查点过了,≠ 最后代码能跑
这一节最容易被排行榜忽略。作者只统计每道题的最后一个检查点:
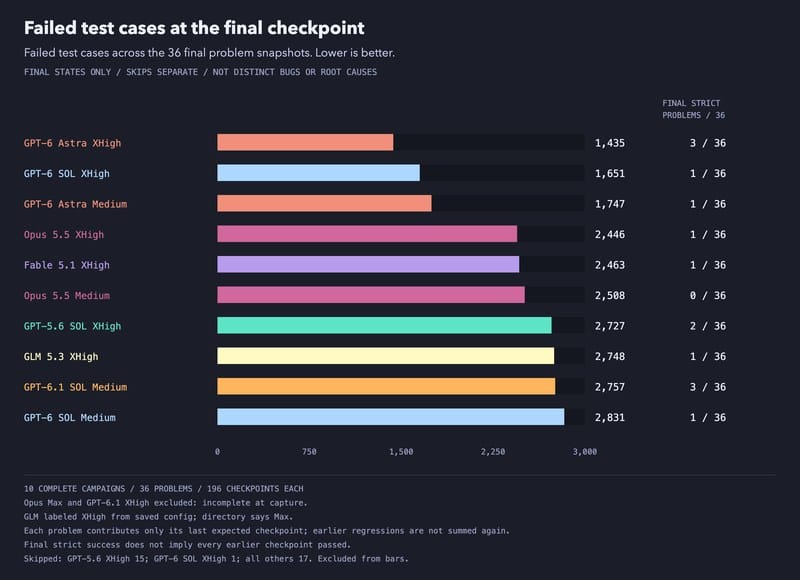
图 3:36 个题面快照里,最后一步仍在失败的测试用例数,1,435–2,831 个;右列是「最后一步 strict 通过」的题数,0–3 个。
| Campaign | 最后一步 strict(共 36 题) | 最终失败用例 | 其中 Regression |
|---|---|---|---|
| GPT-6 Astra XHigh | 3 | 1,435 | 1,178 |
| GPT-6 Astra Medium | 1 | 1,747 | 1,516 |
| GPT-6 SOL XHigh | 1 | 1,651 | 1,366 |
| GPT-6 SOL Medium | 1 | 2,831 | 2,479 |
| GPT-6.1 SOL Medium | 3 | 2,757 | 2,404 |
| GPT-5.6 SOL XHigh | 2 | 2,727 | 2,376 |
| Fable 5.1 XHigh | 1 | 2,463 | 2,126 |
| Opus 5.5 Medium | 0 | 2,508 | 2,206 |
| Opus 5.5 XHigh | 1 | 2,446 | 2,123 |
| GLM 5.3 XHigh | 1 | 2,748 | 2,311 |
三个读法:
- 没有一个 campaign 能让多数题「最终全绿」——上限 3/36。
- 失败的大头是回归。每行里 Regression 占七到九成,意味着「新需求做完了,旧行为塌了」。
- 作者提醒:失败用例数不是独立 bug 数,skip 单列,不同题权重也不同,别横向当排行榜用。
七、为什么回归是主战场
这不是靠猜。把三档分数摆在一起,因果链其实很直:
- 每个检查点都要求 Agent 在上一版代码上继续改,而不是重写;
- 需求变化往往动的是数据流(新字段、新分支、新的切换条件),不是孤立函数;
- 只要它顺手重构了一下「看起来该整理」的部分,旧断言就有机会挂;
- 而 core 只统计本步的 Core 类别,这部分损失在 core 里根本看不见。
所以 core 65.8%–74.0% 与 strict 12.2%–16.3% 之间的那道 50 多个百分点的沟,基本就是「改需求时把旧行为弄坏」的量。这也解释了为什么作者把结论压在那一句上:Agent 把主行为做对的次数,远多于它把所有已测行为保持可用的次数。
对工程团队的直接含义是:验收口径要写「旧的全过 + 新的做过」,不能只写「新的做过」。前者才是用户感知到的「没坏」,后者只是「这次做完了」。
八、代码质量:slop 覆盖率 78%–94%
除了「过没过」,这轮还量了「留下了多少垃圾」。先说方法上的一个决定,这个决定本身值得学:
作者的第一反应是把随机临时文件从质量分里剔掉。Gabe 反驳得很到位——基准应该量模型在代码库里留下多少垃圾;如果我们不读这些代码,那就更该把它量出来。测试、草稿代码、生成副本,不该因为「不是主程序」就免费放行。
统计口径:扫描器在每个文件里标记 slop 模式与重复代码,「覆盖率」= 被标记的源码行占比,同一行被多条规则命中只算一次;对 28 道可测题(8 道因扫描器测不全被排除,所有模型统一排除)按 SLOC 加权汇总——这一点与本系列前两篇「按题平均」不同。
结论一,覆盖率差异比想象大:
- Opus 5.5 XHigh 最低:77.75%;Opus 5.5 Medium 最高:94.25%
- 把固定的临时目录过滤掉(
_work、tmp、temp、scratch、generated、build、dist,以及*_pb2.py这类生成文件)之后,Opus Medium 降到 92.90%,仍是最脏 - 这次过滤只命中了一处:Opus Medium 的
dynamic_buffer里 45 个文件、41,265 行,总量从 216,881 行降到 175,616 行;对其它模型没有任何影响
结论二,更反直觉:同一个模型,XHigh 写出的代码干净约 5 倍,strict 却更少(25 vs 28)。作者没有把这条当因果,只提出一个可能解释:新模型会产出新的可维护性反模式,而论文那套 200+ linter 是在 2026 年 3 月/5 月基于当时的 agent PR 手工整理的,还没覆盖到它们。
结论三,关于复杂度:Fable 5.1 的平均圈复杂度最低(3.57,8,967 个可调用体),GPT-6 SOL Medium 最高(11.70,1,083 个)。但作者提醒——把代码拆成更多小函数,可以拉低平均复杂度,并不等于更好改;代码更少也不等于更好。
九、这轮复盘在方法上改了什么
这篇文章真正的价值不在排名,而在它承认并修正了什么:
- 把残留垃圾计入评分,而不是「不算主程序就不算」。理由:不读代码,就必须量代码。
- 覆盖率改成 SLOC 加权。此前是「每题算一个百分比再平均」,会让小题和小文件获得不成比例的权重。
- 只报 28 道题的一致子集。8 道测不全的题在所有模型上一起排除,宁可缩小样本也不引入偏差。
- 每次结论都写明「单轮不能归因」。这条最容易被排行榜搬运时删掉。
十、拿回自己仓库,怎么用这五个数
不上排行榜,只做工程决策的话,我会这么用:
- 默认档位从 Medium 起。这轮唯一稳定的模式是「提档更贵」,而不是「提档更准」。要提档,用自己的题量出依据。
- 选模型看 strict,不看 core。core 高只说明「这次要求的事做到了」;strict 才是「没把旧行为弄坏」。
- 把「最后一个检查点」当验收。检查点连胜不等于收尾可用,这轮 0–3/36 就是证据。
- 单次运行不下结论。至少要重复 3 次,或者同设置跑两次看波动,再决定换不换模型。
- 成本是约束,不是目标。8.68 倍成本换来 3 个检查点的反向差距,足以说明「贵」和「准」是两个独立的轴。
三句常见说法,用这组数据校一下
- 「档位拉满就完事了」:三对完整对照里只有一对变好,最贵的那一对(Opus 5.5)是 4.22 倍成本、少 3 个检查点。正确姿势是先定 Medium 跑基线,再用自己的题量决定要不要提。
- 「贵的就是好的」:$1,550.07 的 Fable 5.1 XHigh 拿 26 个 strict,$178.51 的 GPT-6.1 SOL Medium 拿 29 个。在 12%–16% 这个窄带里,成本几乎不携带信息。
- 「榜一就能用」:榜首 Astra XHigh 与第五名的 SOL 6.1 Medium 只差 2 个检查点,而后者便宜 4 倍多。这种量级的差距,换一个随机种子、换一天跑,都可能翻转——所以原文才坚持写「单次运行不能归因」。
十一、在自己仓库搭一个小号版本(半天到一天)
不需要 36 道题,也不需要跑十个模型。想验证「我的 Agent 是不是也在回归上翻车」,最小可行版本是这样:
- 挑 6–10 个已经合并的真实 PR,每个都从「改之前的提交」出发;
- 把每个 PR 的意图拆成两段需求(先做 A,再说「另外还要 B」),第二段必须碰到第一段的代码;
- 每段跑完都执行仓库现成的测试套件,记录:新需求的断言过没过、旧断言挂了几条、花了多少 token;
- 只报两个数:strict(新+旧全过)与 core(新过);两者之差就是回归损失;
- 同一设置至少重复 3 次,否则你无法区分模型效应和波动——这也是原文反复强调的边界。
这套东西的价值不在于得出「哪个模型第一」,而在于用你自己仓库的代码形状回答三个决策问题:默认档位定在哪、验收要不要卡回归、换模型前需要多少重复次数。原文的 36 题之所以有说服力,靠的也是这三件事做得干净:题库固定、口径固定、把不能测的题一起排除。
十二、边界
- 每个「模型 × 档位」只跑了一次;所有档位对比都受此限制,作者本人也这么写。
- 估算成本按推理用量推算,不是发票;不同日期、不同 agent 版本之间不可直接横比。
- 题库是 36 道合成题面,覆盖的是「分阶段需求 + 回归」这一类能力,不等于你仓库里的真实任务。
- 质量分只对 28 道题有效;slop 规则集是 2026 年上半年的手工整理版本,对新模型可能漏检。
- 本文为 Part I;SlopCodeBench 团队关于 slop 模式的定性分析(Part II)尚未发布。
对做 Agent 工具的人来说,最该带走的一句是作者自己的总结:「我们在维护代码库这件事上确实在变好(14.8% → 16.3%),但没有宣传里那么快。」
相关阅读:AI 基建 / 评测 / 安全完全指南 | 默认模型是没锁的依赖:15 天三变,评测怎么记 | AI 生成的测试会跟 bug 一起"通过":变异测试与评委校准 | Agent 说"做完了",数据库说没有:交付验收的三道门 | Claude Code 团队怎么做代码评审:7 层防线
Sources
- Dex Horthy(w/ Gabe Orlanski), SlopCodeBench update 10/2026 — Opus 5.5 update, Astra improves by 1.5% over gpt-5.5, xhigh considered harmful, 2026-10-15:https://github.com/humanlayer/advanced-context-engineering-for-coding-agents/blob/main/benchmarking-new-models-on-slop-code-bench.md
- SlopCodeBench 论文:https://arxiv.org/abs/2603.24755
- 本篇图表来源同上仓库
images/scb-3-*.png,已转存站内
本文由 hubwiz 编译整理,转载请注明出处。
这是「AI 基建 / 评测 / 安全」专题的一部分。完整地图见:AI 基建 / 评测 / 安全完全指南