AI SRE 现在能做什么:查故障更快,但没人敢让它动生产
AI 让发布翻倍,告警跟着翻倍。三家 AI SRE 厂商的深访说清了同一件事:代理能替你查,还不能替你扛。
发布频率翻倍,告警就跟着翻倍。这是 2026 年运维团队最直接的体感:AI 代理把改动量推上去之后,事故率的分母变了——不是模型变笨了,是"变更次数 × 单次出错概率"里的第一项被拉高了。
于是"AI SRE"成了热门词。Pragmatic Engineer 的 Gergely Orosz 与 Jessica Salmon 在 2026-10-27 的深访里把话说得很直:这个品类目前卖的是调查速度,不是自主处理故障。三家最主流的厂商(Rootly、incident.io、ResolveAI)都被问到了同一个问题——有没有哪个 AI SRE 真的在工程师睡觉的时候值过班?
一、为什么突然火了:一条可靠性公式
运维的可靠性可以写成两行字:
事故率 = 变更频率 × 单次变更引入故障的概率(i = c × p)
过去这条公式之所以稳定,是因为变更少(c 低)、每次发布的把握大(p 低)。AI 代理进来之后,c 直接翻倍——原文的说法是"几乎所有科技公司过去一年 PR 频率都翻倍了"。c 上去,i 就跟着上。
Rootly 的数据补上了另一半证据:告警量比一年前更高,非工作时间的告警接近翻倍。这就是"AI 让工程师更忙"的具体形状——白天写出来的代码更多,半夜炸的东西也更多。
降低 i 只有两条路:压低 p,或者事后让系统更有韧性。厂商大多在做第二条(从事故里学习、把处置经验沉下来),而"AI SRE"这个产品词,本质是在卖第一条路上最耗时的那个环节——调查。
二、"AI SRE"这个词,没人喜欢但都在用
原文有一句很好笑也很真实的话:这个品类正在变成 AI 增强 on-call 工具的通用名,"尽管我们访谈的每一个人都不喜欢这个名字——我们也同意"。
理由也简单:SRE 这个岗位远不止接告警。可靠性建设的大量工作发生在故障之前和之后。把 on-call 工具叫成 AI SRE,是一种术语上的偷懒。
但术语之争掩盖不了工具真正有用的地方:故障已经发生、工程师刚开始查的那段时间。传统上这段时间花在四件事上——看告警细节、翻自定义看板、查 runbook、翻日志和可观测性系统。AI 工具在这四件事上已经做得相当好——前提是给它足够的数据访问权限。
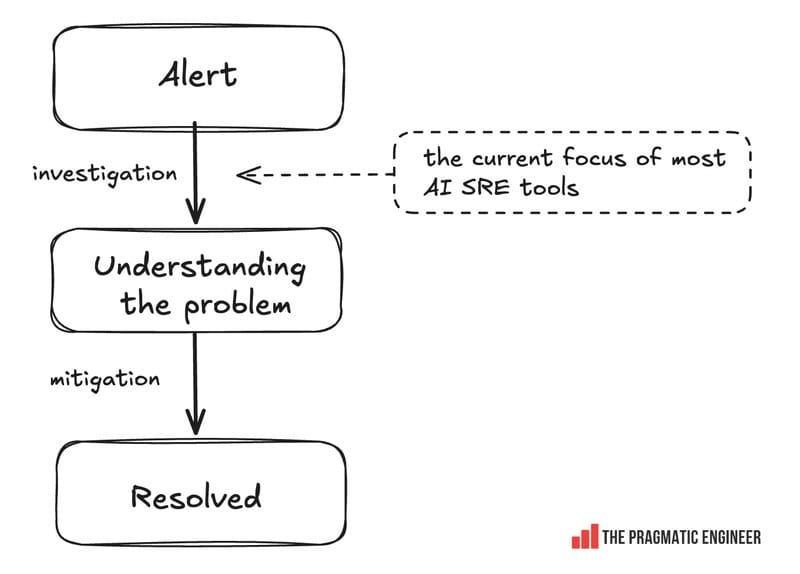
图 1:三家厂商的共同选择是把代理放在"调查"环节,决策权留给工程师。(图源:原文)
三、一次故障调查的七步骨架
三家厂商的流程高度相似,可以拆成七步:
| 步骤 | 做什么 | 需要拍板的取舍 |
|---|---|---|
| 触发 | 告警响起,或工程师宣布事故 | 给代理固定分桶(需人工/可等上班/噪声),还是先让它推出假设再叫人 |
| 定向 | 拉遥测与日志,找最近变了什么(发布、feature flag) | 先估算影响面(会增加延迟),还是按服务类型走不同规则 |
| 展开 | 并行启动多个调查代理 | 按假设分片,还是按"能开多少就开多少";长跑代理要不要等 |
| 验证 | 挑战调查代理的结论 | 对抗代理的成本 vs 误判成本 |
| 汇报 | 更新 Slack 等渠道 | 更新频率与颗粒度 |
| 转向 | 工程师在 Slack 里给输入,触发新一轮展开 | 人机接口的形态 |
| 交接 | 由人或 coding agent 执行缓解动作(改代码、重启系统) | 是否允许代理自己动生产 |
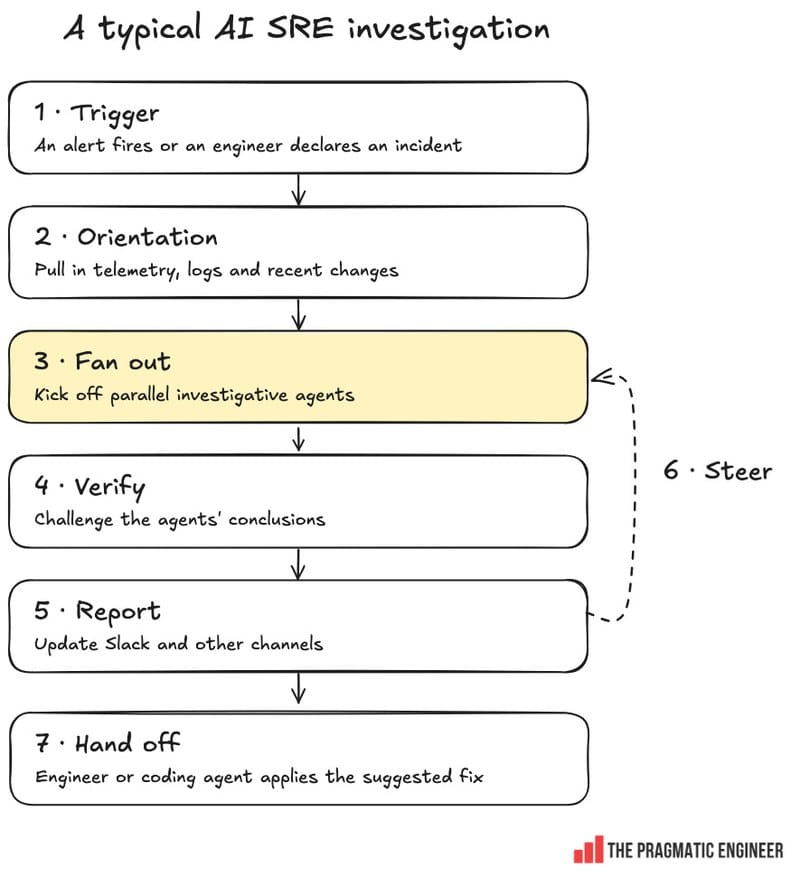
图 2:触发、定向、展开、验证、汇报、转向、交接——每一步都藏着延迟/准确/成本的三选二。(图源:原文)
注意最后一步的措辞:执行。原文提到的分歧点正在这里:AI SRE 该只做缓解(mitigate),还是也做修复(remediate)?三家的答案不一样——
- incident.io 把事故上下文交给工程师已有的 coding agent,自己做 PR 的自主能力做过演示,但客户更愿意用自己的 agent;
- ResolveAI 走混合路线:简单 PR 自己写,大改动交给客户的 coding agent;
- Rootly 的愿景最激进:一个 agent 起草 PR,另一个 agent 判断能不能合并,安全就自动合,有风险才叫醒值班工程师。
四、三种架构,两次翻车
ResolveAI 两年内重写了三次调查代理,这段历史比任何 demo 都有信息量。
第一代(2024):脚本化流水线。 那时模型还不能可靠地串联工具调用,于是拆成一串固定提示:「分类告警」→「收集日志与指标」→「抽取线索」→「给假设排序」。常见故障处理得不错,一旦故障"不按剧本走"就崩。
第二代(2025):单代理 + 知识图谱。 工具调用可靠之后,一个主代理接告警,查服务/依赖/runbook/发布的知识图谱,再决定下一步。准确率上来了,但冒出三个新问题:
- 上下文腐烂:长时间、跨多服务的事故里,代理上下文饱和,进入所谓"变傻区"——开始反复索要已经拿到的数据,并且自相矛盾;
- 自我确认:让代理给自己提出的候选根因打分,它几乎总是确认第一个猜想,不去真正检验;
- 没有记忆:上一次调查学到的教训带不到下一次。
第三代(2026):多代理分工。 三个角色:调查者一个个追假设;验证者结构上独立于调查者,专门挑战结论(避免自我确认);沟通者负责对外更新。团队认为这是最可靠、最有韧性的一版。
这三个坑值得抄下来,因为它们是通用的:上下文腐烂、自我确认、无记忆——任何长跑 agent 系统都会撞上,跟用哪家厂商无关。
五、上下文层:知识图谱 + 记忆 + 工具
三家都有自己的"上下文层":Rootly 叫 Atlas,incident.io 叫 Nexus,ResolveAI 叫 HiveMind。抽象一下,都是三件东西:
知识图谱——服务、数据存储、云资源、发布、runbook、历史事故之间的关系。这不是厂商专利:Uber 内部就有一个被几乎所有 AI 系统共用的知识图谱(Context Graph)。
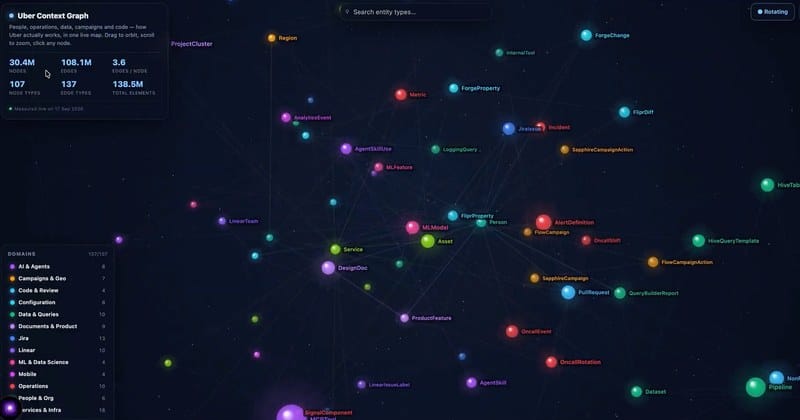
图 3:Uber 的知识图谱,服务、依赖、运行手册都在图里。(图源:原文)
记忆——存"上一次这类故障是怎么解决的"。比如"支付延迟飙升,多半是连接池的问题",或者"这条告警在某个服务发布后一小时内基本都是噪声"。Rootly 的实现里有两个细节值得学:激活式记忆(一条笔记在事故里起过作用、或被手动激活,才升到更重要的层级)和隔离式记忆(被证伪的笔记进隔离区,不再喂给代理)——后者是防止"喂过期信息"的具体机制。
工具——连接器、插件、MCP 接口、给 Claude Code/Codex 的插件。这块已经标准化了。
有一处争议原文没有回避:要不要把客户的故障数据池化? 三家里面只有 Rootly 让客户选择加入(opt-in),换来"更聪明的代理",内部目标是做一个"AI SRE 的 Stack Overflow"——A 公司的复盘脱敏后帮 B 公司更快解决同类事故。联创 JJ Tang 的说法是:"这个领域大部分厂商承诺数据永远隔离,我们认为对运维数据来说这是错的默认值。一个坏掉的 Redis 配置引起的中断,不是什么商业机密。"
原文的态度很克制:从知识库受益是好事,但往厂商共享库贡献数据要谨慎;负责任的厂商会把贡献做得容易且透明。贡献之前先脱敏。
六、Slack 才是人机接口
AI SRE 大多在 Slack 里跟工程师交互(Teams 三家都支持,Rootly 还支持 GChat)。这件事本身有意思:Slack 正在变成技术公司"人对代理说话"的默认场所。
两个必须解决的体验问题:
更新长度。incident.io 在这个问题上反复试:太简短,工程师不信(信息太少);太长,烦。这个平衡点没有通用答案。
什么时候开口。Rootly 把代理设计成"大部分时间闭嘴",只在四种情况下说话:频道里的问题一直没人回;有人进来但不知道上下文;有人宣布"已缓解"但没有证据;宣布了一个没有回滚方案的高风险操作。
后两条其实是审计规则伪装成了产品功能。
七、自建派:Monzo、OpenAI、Stripe、Google
中大型公司自建 AI SRE 的最大好处是上下文可以放得更开。原文的判断是:自建版本的能力和结构与厂商版最后会很像。
- Monzo:AI SRE 是云代理 Agent Chip 的一个子集。事故发生时切到"Incident Mode",跨系统汇总上下文、给出可能原因、起草修复。
- OpenAI:工具叫 Sevbot。收集细节、判断可能的缓解手段(但从不执行)、在 Slack 里回答工程师的问题、被明确指示时才去执行。
- Stripe:每次故障都跑调查代理。偏简单的一轮(通常只是把调查所需的信号收齐)平均 3 分钟;更彻底的深度调查平均 14 分钟。
- Google:SRE 用 ProdAgent,在 Gemini CLI 里调用
get_incident_details、causal_analysis、timeseries_correlation、log_analysis这类能力。它不生成代码,只通过 MCP 暴露的工具提建议,比如重启 Borg 任务。它带策略执行与审计轨迹。原文对它的评价很有意思:看起来没那么精致,但"更多脚本、更少 LLM 的随机性"正是为了把搞坏生产的风险压到最低。
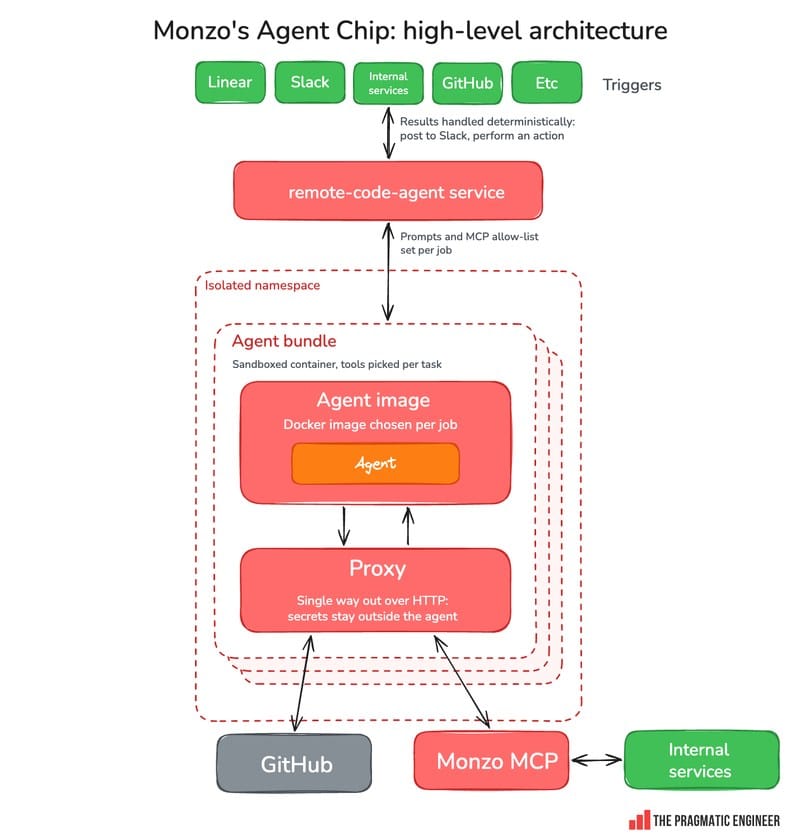
图 4:Monzo 的 Project Chip:一个通用工程代理,事故时切到 Incident Mode。(图源:原文)
八、原文付费部分说明
这篇原文是 Pragmatic Engineer 的付费稿。我们读到并编译的是公开可见的前半部分(第一节到"让代理准确"之前)。后半部分——如何量化代理的准确率、怎么把延迟和成本压下来、自治代理还有多远、on-call 工程师的岗位会怎么变——在付费墙内,本文没有编译,也不会替原作者猜。
所以下面这一节是我们自己的整理,不是原文观点。
九、编者补充:三条能立刻用的判据
原文给出的最强信号不是"AI 能查故障",而是"没人让 AI 直接动生产"。OpenAI 的 Sevbot 会算缓解方案但不执行;Google 的 ProdAgent 不出代码、只调带策略和审计的工具。这不是能力问题,是责任问题。
判据一:看它有没有"验证者"。 如果一个系统让同一个代理提出假设又给自己的假设打分,那它在结构上就会自我确认——ResolveAI 的第二代就是这么翻的。合格的实现里,验证者必须与调查者独立,最好连模型都换一个。
判据二:看记忆有没有"隔离区"。 系统在变,昨天对的因果今天可能错。没有"被证伪就隔离"的机制,记忆层会慢慢变成谣言库。
判据三:看它能不能证明自己查过什么。 一次调查的产出应该是可复核的证据链——查了哪些指标、看了哪个时间窗、排除了哪些假设——而不是一段读起来很顺的结论。这和站内交付验收门是同一个道理:代理说"找到了",不构成证据。
如果你在做这类系统,建议先按"只查不改"上线:让它把上下文和假设摆到 Slack 里,任何写操作都走人。等它连续几个月在同一类事故上的结论都被验证为正确,再考虑把"缓解"这一步交出去——而且交接对象应该是已有的变更流程,不是它自己的 shell。
边界:本文是媒体深访,不是对照实验。厂商的能力自述、Rootly 的客户数据池化方案、各家架构说法都需要按"厂商陈述"读。原文也明确提示它持有 incident.io 的投资(文内披露)。涉及生产变更的场景,请按内部变更规程执行。
来源:Gergely Orosz & Jessica Salmon,《AI SRE: what is it, how could it change on-call – and does it work?》, The Pragmatic Engineer, 2026-10-27。原文链接:https://newsletter.pragmaticengineer.com/p/ai-sre(付费稿,本文编译其公开可见部分)。
本文由汇智网编译整理,转载请注明出处。
这是「Agent / MCP」专题的一部分。完整地图见:Agent / MCP / 自动化完全指南