给你的编程 Agent 一份"自己的记忆":本地、可移植、可溯源的 funes
每个编程 Agent 见到你的项目都像陌生人:会话结束,推理就没了。funes 把 Agent 本机已有的会话轨迹建成记忆——单二进制、本地嵌入与重排、写入 Lance 数据集,一条 funes add 命令即可让 Claude Code / Codex / pi / Hermes 互相"记得"彼此的决策,并能发布成你私有的 Hugging Face 数据集跨机器跟随。实测中,recall 比手写交接便宜 4~8 倍,且是三种长会话出口里唯一两个任务都成功的。
一句话结论:编程 Agent 已经写出了"记忆"——它们搜索代码库、试错、读文档、转向,留下了一份不仅记录改了什么、也记录为什么改的轨迹。但轨迹只是潜在的记忆:会话日志仍是一份归档,你没法在上万轮对话里 grep 出"我们当初为什么放弃了流式解析器"。Hugging Face 的 funes 做的就是把它变成 Agent 真正能用的记忆:单二进制、本地嵌入、可溯源、可跨 Agent、可跨机器。一条 funes add 就能接入 Claude Code / Codex / pi / Hermes,而它的 recall 在实测里比"手写交接"便宜 4~8 倍。
本文完整编译自 Hugging Face 博客《Give Your Coding Agents a Memory You Own》(2026-09-03,作者 David Corvoysier),并做中文整理。
一、问题:每个 Agent 见你的项目都像陌生人
作者的工作方式很典型:横跨多台机器,按任务切换编程 Agent。而每一个 Agent 都把项目当成第一次见——会话一结束,"上周二"的推理就消失了;每换一个 Agent、每换一台主机,都从零开始。
今年早些时候,Hugging Face 的《Software Forgets: Agent Traces Are the Memory》已经指出:编程 Agent 早就在生产我们不断丢失的那份记录。当一个 Agent 检索代码库、尝试方案、撞上报错、读文档、改变方向时,它留下的不只是"改了什么",还有"为什么"。
诊断是对的,但轨迹只是潜在记忆。Agent 的会话日志仍然只是归档。索引、检索、排序、精确溯源这几件事不做,Agent 在工作时就用不上它们——这正是 funes 要补的缺口。
图 1:接入 funes 后,回忆发生在对话内部——Agent 自己伸手去取记忆,并点名支撑答案的那次会话。
funes 是一个面向 Agent 的持久记忆层(支持 Claude Code、Codex、pi、Hermes),由你机器上已有的会话构建,本地运行,一条命令即可成为 Agent 常规工作流的一部分;需要时,它还能同步到你名下、默认私有的 Hugging Face 数据集。
二、一条命令,给你正在用的 Agent 加记忆
funes 是单个二进制文件。它的默认推理后端不依赖任何 ML 运行时,嵌入与重排都发生在你的机器上。
安装:
curl -fsSL https://huggingface.co/buckets/huggingface/funes/resolve/install.sh | sh
然后把它加到一个 Agent 上:
funes add claude # 或:codex、pi、hermes
这一条 add 命令会:建立第一个索引、给 Agent 提供 recall 和 get 两个工具、并安装自动化去索引每一个完成的轮次(turn)。索引是增量的——新的运行只追加新的轮次,而不是把整段历史重新嵌入一遍;更早、更深的内容可以分步回填(backfill)。
之后你正常干活就行。当任务触及过去的某个决策、理由或发现时,Agent 可以自己去调 recall——你不必记住旧会话,也不必把它的上下文粘进新会话。
recall 返回的是原文,不是摘要
recall 返回原始文本而非概括,并显示它来自哪里(哪个 Agent、时间戳、哪次会话、哪一轮)。每条结果都附一个 get 命令,用来打开完整的轮次及其周边上下文。
底层是一条确定性的流水线:把每一种受支持的轨迹解析成同一种"轮次 / 块(turn-and-block)"结构,切块,用固定版本的本地模型做嵌入,写入本地 Lance 数据集。一次查询会:融合向量检索 + BM25 的结果、用交叉编码器(cross-encoder)重排候选、按时间新近度重新加权,并把相邻的块一并带上。
这套设计给 funes 三个重要特性:
- 跨 Agent 的一份记忆:Claude Code、Codex、pi、Hermes 都写同一种结构,
recall横跨它们的历史,每个命中都会标明是哪个 Agent 产生的; - 原始证据保持完整:写入时不把任何东西蒸馏成"事实",结果永远能回到产生它的那一轮;
recall默认本地:不需要账号,也不需要 Hub 仓库;托管模型不会处理你的会话用于索引,嵌入与重排在本机运行,推理由你的编程 Agent 完成。
"Agent 即陌生人"的问题,在一台机器上已经被解决了。但当下一个 Agent 跑在别处时,记忆才更有用。
三、记忆是一个数据集,不是一项服务
要让记忆跟着你的工作走,就在把 funes 加给 Agent 时绑定一个数据集:
funes add codex acme/funes-memory
绑定会发布你当前的记忆到那里。此后 funes 会保持它最新:本地索引每一轮,在会话边界发布;Agent 全程从它回忆。在另一台机器上跑同一条命令,记忆就跟着你到了那里。
底层上,本地记忆是一个 Lance 数据集,共享记忆是一个你拥有的 Hugging Face 数据集(默认私有)。
安全方面有几个关键点:
- 在任何内容到达 Hub 之前,机密凭据已经在索引阶段被脱敏;
- 发布时还会对每个块再扫描一次,把任何看起来仍像密钥的内容扣下不发布;这套扫描器的覆盖范围(以及它不覆盖什么)都写在仓库的
SECURITY.md里; - 当 Agent 读取远端记忆时,funes 会在本地缓存数据集文件,所以热查询能回到本地速度。
Hub 提供的是它本来就擅长的东西:归属、访问控制、版本管理与分发。你的记忆不会变成某个独立记忆服务里的一个账号,你也不必通过 API 把它"租"回来。
四、先把问题问出去:ask 与 recall
recall 是为 Agent 设计的。当你想自己向记忆提一个问题时,用 ask——它默认读你的本地记忆:
funes ask claude "what did we decide about the streaming parser"
也可以指向一份共享记忆。官方发布了一份 funes 自身开发过程的记忆,所以你可以不必先建自己的记忆,就能追问 funes 为什么这样设计:
funes ask claude "why is funes append-only" --memory huggingface/funes-memory
图 2:funes ask 是 funes add 的只读、单问题版本。它取回相关段落、交给编程 Agent,返回一个点名了来源的有据回答;它不会安装集成,也不改动 Agent 的持久配置。
值得注意的是:检索不到时它不会糊弄过去。如果取回的段落支撑不了答案,Agent 会直说。你可以换个问法,或者把 funes 加给 Agent,让它在正常工作过程中迭代式地搜索记忆。
五、换 Agent 也不丢线索
共享记忆不绑定创建它的 Agent 或模型。你可以在 Claude Code 里开始一个任务,下周在 Codex 里继续,第二个 Agent 能回忆起第一个 Agent 的推理;也可以先用 pi 搭配本地模型、或经 HF Router 提供的模型,再切回 Claude。
图 3:Claude 做出一个决定,钩子把它索引下来,Codex 在另一次会话里回忆起它。演示里较早的命中是同一实验更早的录制——append-only 的记忆把"彩排"也记住了。
这在几种范围内都有价值:
- 跨你的多台机器:把每个 Agent 绑定到同一份记忆,无论用哪台主机都能回忆历史;
- 跨团队:新同事的 Agent 第一天就能检索到数月来的决策,包括那些从未进入 Pull Request 的死路与理由;
- 配合开源项目:维护者可以发布某个 release 背后的会话,在 push 时点名它们。可以把它想成一份可搜索的
CLAUDE.md——它承载的是"项目为什么长成这样"的历史,而不是一个需要有人不断重写的页面。任何人都可以用--memory阅读公开记忆。
已发布的记忆带有数据集卡片和 funes 标签,因此可被识别,也能在 Hub 上被发现。Hub 已经承载了开放权重与数据集;funes 补上的是"开放工作记忆"——它保存一个项目背后的决策、失败方案与理由,可被另一个 Agent 查询,也能追溯到产生它们的那些会话。
六、长会话最便宜的出口:recall 对比 compaction 与 handoff
一次漫长的排查会把会话撑爆,直到每一轮携带上下文的成本超过了干活本身。通常有两种解法:让 Agent 压缩(compaction)后继续,或者写一份交接(handoff)然后重开。Recall 是第三种,于是作者在一份 handoff-vs-recall 基准上把三者做了对比——用的是两个不靠会话先前知识就无法重建答案的任务。
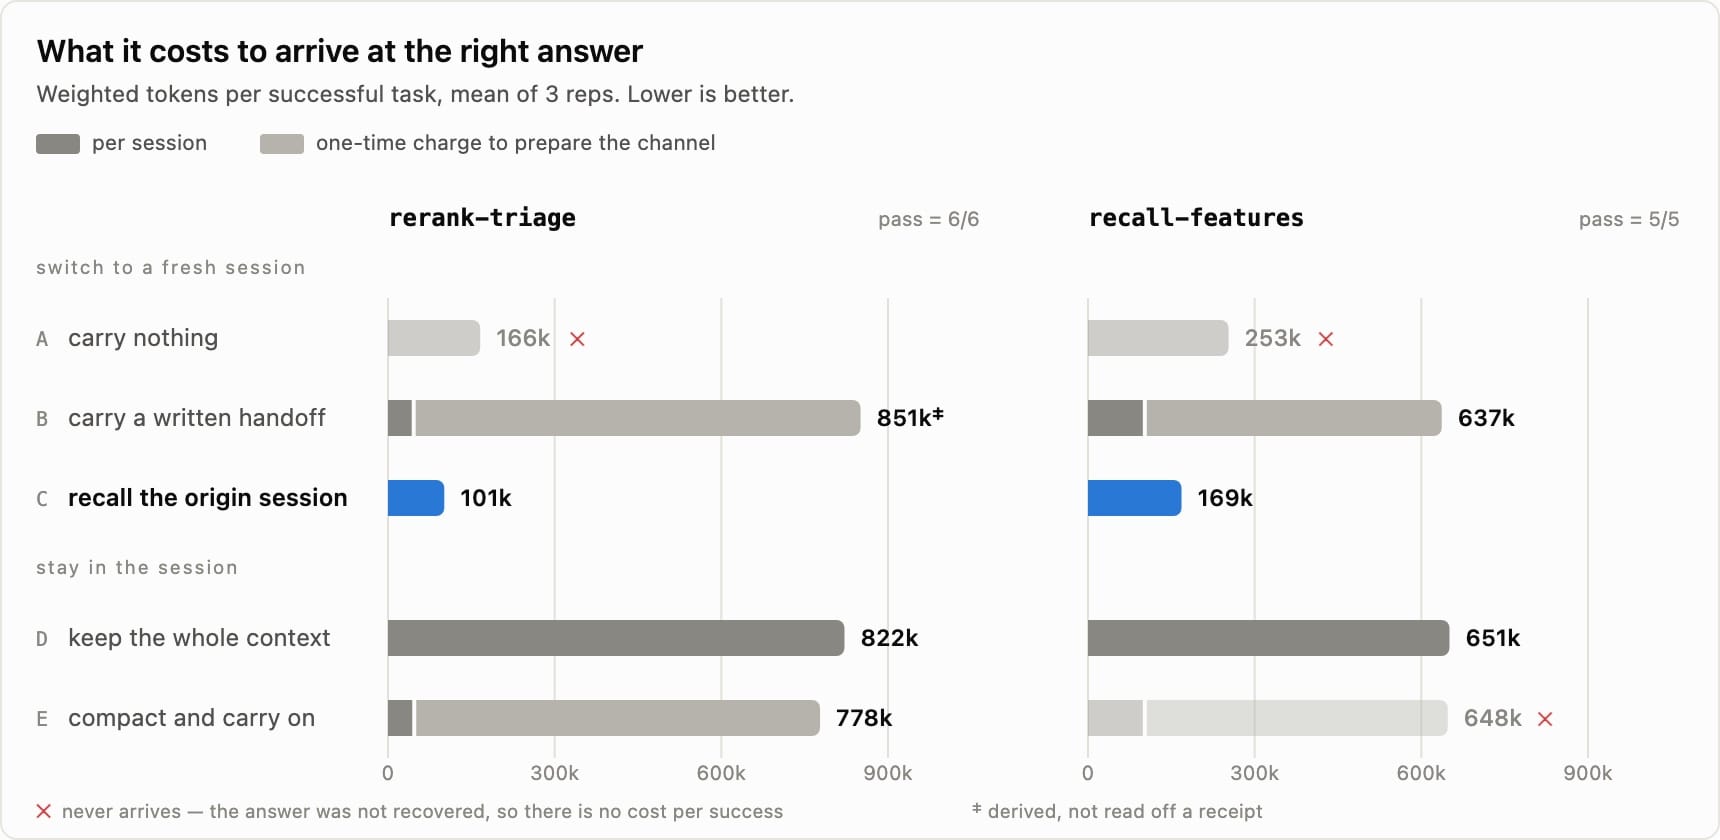
图 4:每根柱子里较浅的一段是准备该通道的一次性开销(交接或压缩),在问第一个问题之前就付掉、只计一次。叉号表示该通道始终没能到达,因此按"每成功一次的成本"计算时没有成本可算。
结果很直接:
- compaction 是三者中唯一结果分裂的:它在其中一个任务上答出来了,在另一个任务上始终没答出来;失败的那次,它的摘要把真正重要的发现压平了。而 recall 返回的是段落本身,所以一个发现不必先活过摘要这一关;
- recall 在两个任务上都是三者里最便宜的:在一个任务上比手写交接便宜 8 倍,在另一个上便宜 4 倍。
七、别再从头开始
"思考,就是遗忘差异、进行概括、做出抽象。" —— 豪尔赫·路易斯·博尔赫斯《博闻强记的富内斯》
你的 Agent 早就写好了那份记录。funes 就住在 github.com/huggingface/funes——距离"把这份记录变成下一个 Agent 能读的记忆",只差一条命令,无论你手边是哪台机器。
八、建立在开源之上
funes 几乎没有重新发明什么。它依赖的是:足够好、能在本地跑的开放嵌入模型;Lance 的 append-only 数据集(增量写入成本低);以及 Hub 对数据集的缓存与内容去重。真正的工作量在于把它们拼成一个 Agent 真能用的记忆。
funes 本身也是开源的。无论是安装卡住、某次 recall 漏了东西,还是想支持某个新 Agent,都可以去提 issue。
九、给工程团队的落地建议与边界
结合官方描述,几点判断值得写下来:
- "记忆即数据集、而非服务"是关键取舍:它避开了"把你的历史租给第三方记忆 API"的模式,代价是你需要自己承担版本、访问控制与分发(funes 借 Hub 来做);
- 本地优先适合数据敏感场景:默认嵌入与重排在本机,托管模型不处理会话;但要记住发布前必须评估脱敏与合规——扫描器是兜底,不是免检;
recall的强项是"可溯源",不是"会概括":它适合回答"我们当初为什么这么做",不适合替代你主动整理决策文档;- 长会话出口要按任务选:当关键发现在长会话里容易被摘要压平时,recall 比 compaction 更可靠,也可能更省 token;
- 跨 Agent 共享前先想清楚"记忆的边界":一个团队共用一个记忆很方便,但也意味着死路、临时结论与错误尝试都会一起被检索到——append-only 的好处是诚实,代价是不会自动遗忘。
对做本地/自托管 LLM 的团队来说,funes 的更大启示或许是:Agent 时代"上下文工程"的下半场,是数据的持久化与可溯源。把会话当流处理掉很省事,但把它当可查询、可版本化、可携带的资产留下来,才会在下次换 Agent、换机器、换同事时真正帮上忙。
参考来源
- Hugging Face:《Give Your Coding Agents a Memory You Own》(2026-09-03,David Corvoysier)https://huggingface.co/blog/funes
- 前作:《Software Forgets: Agent Traces Are the Memory》https://huggingface.co/blog/huggingface/agent-traces-as-memory
- funes 仓库:https://github.com/huggingface/funes
- 安全说明(脱敏与扫描覆盖范围):https://github.com/huggingface/funes/blob/main/SECURITY.md
- handoff-vs-recall 基准:https://huggingface.co/datasets/dacorvo/funes-handoff-recall-benchmark
- 公开的 funes 记忆数据集:https://huggingface.co/datasets/huggingface/funes-memory
延伸阅读(本站)
- AI 编程 / Vibe Coding 完全指南
- Codex CLI 的记忆是怎么工作的
- AI 记忆,本质上是一个数据库问题
- Claude Code Memory 2.0
- 4 个流行的 Agent 记忆系统横向对比
- 本地 & 自托管 LLM 完全指南
本文由 汇智网 · Software 2.0 编译整理,转载请注明出处。