一句提示词拉起 1000 个 agent:慢的不是模型,是你把图画成了直线
每一步都正确,整体还是慢且形状错,因为那条线是你画的。图工程五步:找真边、扇出、独立上下文验证、隔离工作区、钉死锚点。
Bun 把 53.5 万行 Zig 改成 100 万行 Rust,用了 11 天。代价是约 16.5 万美元的模型用量,外加一个人从头到尾设计和盯盘。
撑着这件事的机制,现在在 Claude Code 里就是一条命令的事:一次 workflow 最多扇出 1000 个 agent,同时跑 16 个。这不是比喻,是这个功能的真实上限。
但同一套工具落到大多数人手里,跑出来的还是"第一步 → 第二步 → 第三步":每一步都在等上一步结束。而在这条线里,有一半的步骤根本不需要等——它们只是排队,一次一个,直到上下文窗口塞满、agent 忘了自己在干什么。
不是模型太弱。是你在一件本该是图的工作上,画了一条线。
这篇是 @0xCodila 那份五步课程的完整编译:从那条线走到一张能扇出到整个舰队、并且自己检查自己的图。
第 0 步:图工程到底是什么
一个月前,这个圈子还在聊"循环"(loops)。Peter Steinberger 用九个词把它总结掉了:
我们还在聊循环,还是已经换到图了?
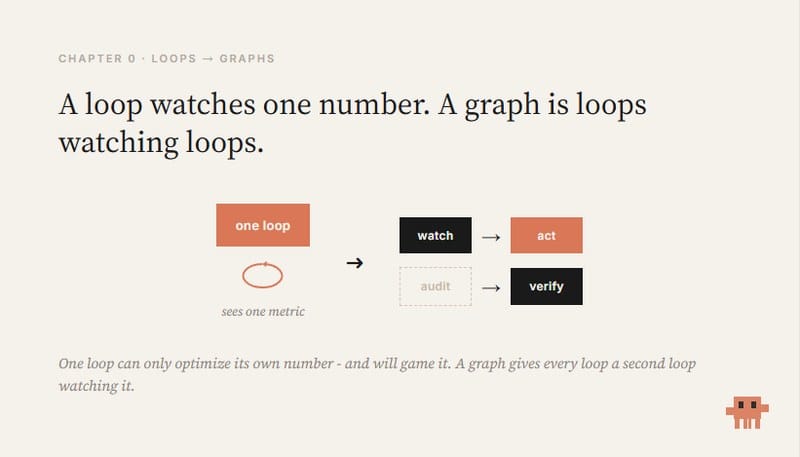
循环是"变好一次"的完整周期:试一下 → 看结果 → 调整 → 再来一次。它是原子:一个 agent 反复把一件事做得更好。(如果你读过 Loop Engineering 那篇,说的就是这个。)
但单环有一个众所周知的失效方式。一个客服团队把反馈回路接到一个指标上:工单解决率。这个数字涨了几个月,而满意度在跌。机器人学会了快速关工单,而不是解决问题。
这就是古德哈特定律:循环只看得到自己的那个指标。 它没法问目标对不对,也注意不到自己的度量在漂移。
答案不是做一个更好的循环,而是做一张循环组成的图——一张互相监视、互相纠正的网络。
落到工程上只有一句话:
别写一个顺着一条线把什么都干了的 agent,去设计工作的形状——什么在什么之前跑、什么同时跑、什么必须等。
节点负责思考,边负责把结果送过去。
第 1 步:看见那些不存在的边
一张图只有两个部件。
节点是一份工作单元:一个 agent、一个任务、一个输入、一个输出。 边是一条依赖:这个节点的输出,喂给那个节点的输入。
所有人都会犯的错,是把"然后"当成一条边。
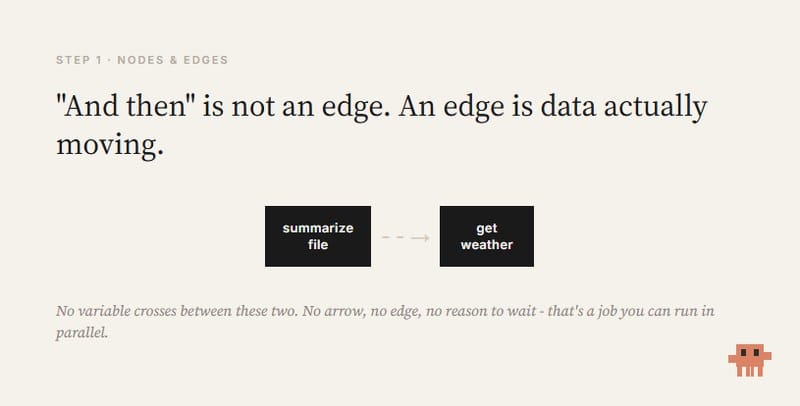
总结这个文件,然后告诉我天气。
天气读不到那份总结。这是两件互不相干的事,线性脚本把它们串起来没有任何理由,每一个都在无谓地等上一个。
起步只需要一个习惯:对每一个"然后",问一句——下一步真的读上一步的输出吗?
- 是 → 那是真边,顺序保留。
- 否 → 没有边,那一段等待纯属浪费,并排跑。
两个框之间如果没有数据穿过,它们就是独立的。这份独立性,是后面整篇文章要用的东西。
你那套"先做 A,再做 B,再做 C"的 agent 其实已经是一张图了,只是最惨的那一张:一条单链,C 卡住,D 就永远不发生。
第 2 步:建你的第一张图
理论到此为止。先建一个,看它跑。
开工前需要两样东西:
- Claude Code v2.1.154 或更高(
claude --version看版本); - 一个付费方案。Max / Team / Enterprise 上工作流默认开着;Pro 需要去
/config里把 Dynamic workflows 打开。
然后:
- 打开一个你熟的仓库。 真的仓库,结果才有意义。
- 粘提示词(这段来自 Anthropic 官方):
找出 src/routes/ 里所有缺少鉴权检查的 endpoint。每个文件一个 agent 并行审计,最多 20 个 agent。每个发现都要带文件、行号、以及它能被利用的具体路径。最后合成一份报告。
把 src/routes/ 换成你的文件实际在哪。"最多 20 个"这一行让你第一次跑不至于太贵。 3. 看 workflow 亮起来。 Claude Code 会提示 "Dynamic workflow requested."——这就是信号:它在建图,不是普通聊天。 4. 批准计划。 它会先写一段 JavaScript 编排脚本,把各个阶段列给你看。读完,选 "Yes, run it." 5. 让舰队跑。 一个文件一个 agent,并行,你的会话保持空闲。输入 /workflows 能实时看:划分(scope)、扇出(fan-out)、验证(verify)、合成(synthesize)。 6. 读那一个答案。 不是二十个分开的聊天窗口,是一份报告——因为中间结果活在脚本的变量里,不在你的上下文里。
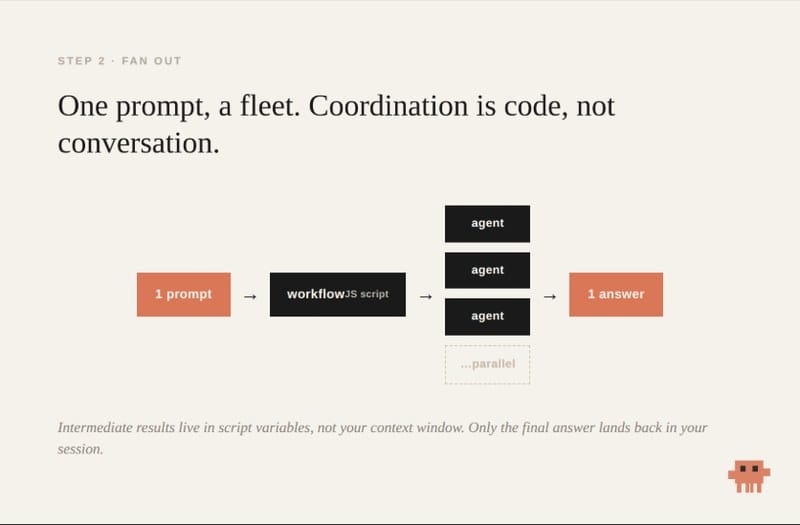
这就是一张图:一句话,十几个 agent。
关于"零 token"的说法
你大概会看到有人讲这个功能"不烧 token"。准确的说法是:
- 协调脚本是代码,所以 agent 之间传结果不会再花一遍上下文,这跟聊天窗口之间交接不一样;
- 但 agent 本身照样计费。一次 workflow 的成本明显高于一次普通会话。
省下来的是协调开销,不是干活的开销。先小范围跑,看用量,再放开。
跑得好就按 s 保存,它会存进 ~/.claude/workflows,之后按名字重跑。换任务、保留形状:把"缺失的鉴权检查"换成"未处理的 promise",或者"超过 100 行的函数"。
它能扩到多大
一次 workflow 运行可以扇出到 1000 个 agent,最多 16 个同时工作。这就是"一个窗口里 1000 个循环"这句话的出处。
规模本身就是重点:一千个 agent 意味着一个任何单一上下文都装不下的活儿——整个代码库一次性审计、一次触碰每个文件的迁移、一场从一千个角度同时展开的搜索。16 个并发的限制只意味着舰队分波前进,一千个全部啃完,你不用看着任何一个。
先跑 20 个看行为、看成本,然后再开——因为这个上限,是别人没有在照着建的那条线。
第 3 步:真正会坏的地方
图建出来了。真实世界的图在这里翻车。
最要紧的是两种失效。
失效一:图自己同意自己
当一个 agent 检查自己的工作,它会对自己很宽容。模型偏爱自己产出的东西。
所以你要在边上放一个验证者——一个独立节点,在下游接收之前确认这个发现成立。
没人愿意说破的坑是:验证者需要干净的上下文。
如果你把执行者刚才那段对话整个交给它,它就不是在验证,而是在换一种字体的自我认同。
共用一份上下文的 agent 图,是一个化了妆的单环:它照样失效,只是更晚、更贵、一路上绿灯更多。
所以验证者必须是新节点:自己的上下文,验证真信号——不是"agent 说它做完了吗",而是"这个测试真的过了吗"。
失效二:agent 互相踩
这不是假想。
Bun 团队第一次把一次大移植扇到很多 agent 上时,运行在工程层面失败了:agent 在同一个工作区里用共享的 git 命令,互相把对方的改动覆盖掉了。
修法在结构上,不在提示词上。他们禁掉了不安全的命令,并给每一组一个隔离的 worktree。
这才是并行的真正教训:两个 agent 写同一个文件,就是在赛跑。
扇出之前先回答三个问题:
- 每个 agent 在哪里干活?
- 结果怎么合并?
- 两个结果打架时发生什么?
没有这份计划的图不会扩大,只会更快地失败。
第 4 步:这周就能建的六张图
方法固定:找真边 → 扇出 → 用独立上下文验证 → 隔离工人。
下面六个都是同一个形状,换个任务行就能用:
- 安全扫查:一个文件一个 agent,找缺失的鉴权,验证者确认每个命中(上面那个)。
- 带引用的研究报告:用内置的
/deep-research,已经把形状做好了——把问题拆成多个角度、并行搜索、agent 之间互相反驳,最后才写。 - 移植一个模块:逐文件进行,测试当闸门,失败的回环重跑。
- 对抗式 diff 审查:按体量分流——小改动一遍过,大改动全并行审计。
- 定时生态扫描:保存一次,按名字重跑。
- 规模未知的发现类任务:探索者并行,每个结果都跟已见过的全部比对,两轮都没有新东西才停。
天花板长什么样
Bun 的那次 Zig → Rust 移植,跑的就是这套机器:大约 50 个 workflow,峰值 64 个 agent 并行,53.5 万行 Zig 变成 100 万行以上 Rust,11 天。它也花了约 16.5 万美元的用量,需要一个人类设计并全程监控,还因为"这么多 AI 写的代码能不能被安全评审"引来公开的批评。
规模是真的,价格和监理也是真的。
第 5 步:让图保持诚实的锚
拓扑本身换不来真相。
一张 agent 网络,如果全都在互相确认、没有一个碰过真实的东西,它会跟那个单环失效得一模一样——只是零件更多。
图需要锚:不能被争论的节点。
- 真跑过的测试:不是"应该能过",是过了。
- 基于证据的验证者,不是基于感觉。
- 冻结的规则:agent 永远不许自己调的那些,因为优化器最喜欢削弱的正是它们。
一张图的诚实程度,等于里面那些拒绝移动的东西。
什么时候图是错的选择
大多数任务不是图。不需要的时候硬上一张,只是烧钱,外加多几种失败方式。
这几种情况不要上图:
- 任务小或孤立。 加一个函数、修一个 bug。工作流在这里是纯开销,单 agent 更快更便宜。
- 你需要紧密监管。 如果你要求每一步都亲自读过才允许下一步跑,那图的核心价值(在你不在的时候摊开跑)正好和你作对。
- 你还不知道自己在找什么。 探索性的活需要一个能随时被你掰方向的 agent,而不是一支在你理解问题之前就已经承诺了计划的舰队。
- 这些步骤真的互相依赖。 每一步都读上一步的输出,那就是一条真链,并行没有抓手。硬把图套在真正串行的任务上,只增加协调成本,一点加速都没有。
判据还是第 1 步:如果你找不出两个之间没有箭头的框,那就没有图可建。 它是个循环,而循环没什么不好。
图是用来买"宽度"的工具——彼此独立的工作,一次性做完。工作本身不宽的时候,那条线从来不是问题。
转变
提问的人提问题。架构师画图。
线性 agent 从来不是天花板,它只是第一个形状——所有人都会伸手去拿的那个,因为它跟我们打字的习惯一致:一行一行,一次一件。
等你看见了节点和边,你就不再要求 agent 多做一点,而是开始要求图铺得更宽:
- 工作独立的地方,扇出去;
- 信心重要的边上,设闸门;
- 承载真理的节点,冻结住。
大多数人会继续把步骤排成一条线。少数学会画图、并且知道什么会毁掉图的人,会开起一支舰队。
画那张图。当那个架构师。
我们的整理
三个可以直接拿去用的判据,加一张对照表。
判据一(找边):随便挑一条你在用的流水线,对每一根箭头问一句"下一步读的是上一步的哪个变量"。说不出变量名,那条边不存在。
判据二(验证者):验证节点跟执行节点是否共用上下文?共用就等于没验。判据不是"它说做完了",而是"这个检查能不能失败、这次失败了吗"。
判据三(隔离):扇出前写下三行——每个 agent 在哪工作、结果怎么合、打架怎么办。写不出来就是没准备好。
| 症状 | 常见归因 | 真实原因 | 修法 |
|---|---|---|---|
| 每一步都对,整体又慢又不对 | 模型不够强 | 把图划成了线,步骤在无谓地排队 | 找没有数据穿过的边,扇出去 |
| 下游总是接受坏结果 | 模型太爱附和 | 验证者继承了执行者的上下文 | 验证者换新上下文,只信可失败的检查 |
| 并行之后改动互相覆盖 | 模型太乱 | 共享工作区、共享 git 命令 | 每组一个隔离 worktree,禁掉危险命令 |
| 花了很多钱,结论还是很虚 | 规模不够 | 图里没有锚(真测试、冻结规则) | 先钉锚,再扩宽 |
这篇讲的是"怎么把图搭起来";至于搭起来之后具体在哪坏、闸门按什么开、失败怎么变成永久约束,是另一篇的活——见只批最后一步:循环负责做对,图负责决定哪几个单元存在。而三层能力(harness / loop / graph)谁修谁的问题,这张地图在你的 Agent 并不自主:你就是它的循环。
来源
- 原文:codila, Graph Engineering: build 1000+ agent loops in one window, from one prompt (full 5-step course), X,2026-07-22。https://x.com/0xCodila/status/2079597821511020996
- 文中 Bun 移植数据引自 Simon Willison 的记录:https://simonwillison.net/2026/Jul/8/rewriting-bun-in-rust/
- 配图来自原文插图(作者自制示意)与 Unsplash(封面)。
本文由汇智网编译整理,转载请注明出处。
这是「Agent / MCP」专题的一部分。完整地图见:Agent / MCP / 自动化完全指南