AI 写出的代码怎么不烂:给 coding agent 配可维护性传感器
AI 只靠 lint、依赖规则和变异测试的反馈写代码,能写出可维护的代码库吗?一份逐项实测,附她自己踩的坑。
一个 AI 生成的代码库开始烂,最早的信号不是 bug,而是改一个小地方要动的文件越来越多,或者改动开始弄坏原本好好的功能。
这两个信号来自 Birgitta Böckeler(Thoughtworks 杰出工程师、AI 辅助交付专家)2026 年 5 月 27 日发在 martinfowler.com 的实测文章。她用一个内部数据分析看板做了场对照实验:应用是 TypeScript + Next.js + React,数据来自几个外部 API,前端展示聊天空间活跃度、参与度和人口数据。这个应用原本已存在多年,但为了这次实验,她让 AI 从零重建了一遍,并且刻意几乎不给任何 markdown 指南——没有代码质量与可维护性的说明文件,看 AI 只靠"传感器"反馈能走多远。
这里的"传感器"指的是:观察 agent 实际产出了什么、并把结构化信号还给它的工具。代码正确性(按预期工作)、架构适配性(够快/够安全/够可用)与可维护性是我们通常在代码库里要守住的三个维度;本文只谈第三维。她把可维护性定义为"让代码库在未来也容易改、且改起来风险低",也就是常说的"内部质量"。
她补了一句很关键的话:内部质量问题对 agent 的影响,和对人类开发者的影响是一样的。在一个纠缠不清的代码库里,agent 会去错误的地方找已有实现、会因为没发现重复而造出不一致、会被迫加载远超任务所需的上下文。
五个传感器该装在哪:一张全景图
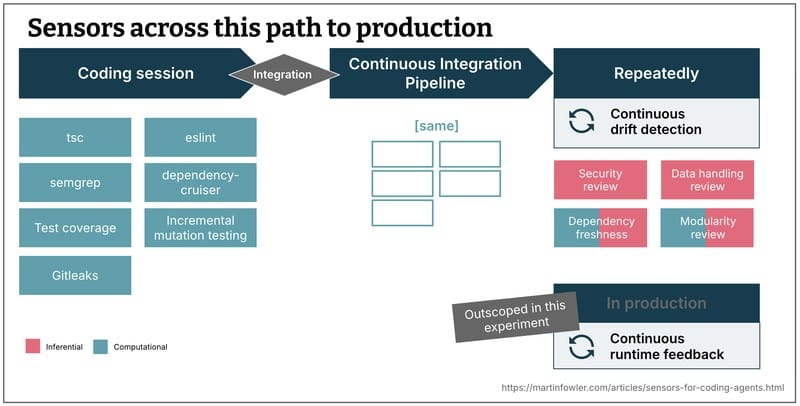
她按运行位置分了四类:
编码会话期间(连续运行、快速反馈,全部是计算型/确定性工具):
- 类型检查器;
- ESLint;
- Semgrep——内部 AppSec 团队指定的 SAST 工具;
- dependency-cruiser——跑结构性规则,检查内部模块依赖;
- 测试套件结果与测试覆盖率(计算型;但测试本身是 AI 生成的,因此"生成方式"是推断型的);
- 增量变异测试;
- GitLeaks——跑在 pre-commit 钩子里,也算传感器,因为它会在 agent 试图提交时给出反馈。
集成之后(CI 管线):同一批计算型检查在干净的基础设施上、集成之后再跑一遍。会话内的传感器给 agent 早期反馈,CI 负责确认结果。
反复运行(更慢的节奏,抓"随时间累积的漂移"而不是当下的错误):
- 安全评审:提示词来自内部应用的 AppSec 检查清单(推断型);
- 数据处理评审:提示词里写明"任何用户名都不许发到前端"这类约束(推断型);
- 依赖新鲜度报告:先跑脚本拿到依赖的年龄与活跃度,再让 AI 产出升级/弃用建议(计算 + 推断);
- 模块化与耦合评审(计算 + 推断)。
基座:全程混用 Cursor、Claude Code 和 OpenCode(按使用频率排序)。默认模型通常是 Claude Sonnet,规划与分析类任务用 Claude Opus,实现类任务常用 Cursor 的 composer-2。
基础 lint:四条规则治住 AI 的典型短板
ESLint 这类基础 lint 主要盯单个文件、单个函数层面的可维护性风险。
在她看来,最适合用静态分析抓的 AI 失败模式有四类:函数参数数量上限、文件长度、函数长度、圈复杂度。但麻烦在于——这四条在 ESLint 的默认预设里根本没开,得先自己配上阈值。她顺带吐槽:希望静态分析工具将来能针对 agent 场景给出更好的预设。
另一个进展是:已经有人开始发布专门针对已知 agent 失败模式的 ESLint 插件,比如 Factory 的规则集,里面包含"必须有测试文件""必须用结构化日志"这类规则。
让报错信息教它自我纠正
传感器的意义在于给 agent 反馈、让它自我纠正。理想情况下,还要在反馈里塞进额外上下文——"一种好的提示词注入"。
为此她写了一个自定义 ESLint formatter,覆盖一部分默认消息(当然是让 AI 帮忙写的)。以 no-explicit-any 为例,改写后的提示大意是:
我们希望代码有类型,这样更容易避免错误,尤其是关键概念。但也不希望代码库被不必要的类型塞满。请自行判断。如果你选择不引入类型,用这条注释抑制它:// eslint-disable-next-line @typescript-eslint/no-explicit-any -- (写明理由)也就是说:判断交给模型,但抑制必须留下理由。
警告管理为什么现在可行了
静态分析存在了几十年,很多团队就算装了也不用——因为管理成本高。要用好它,团队得长期"保持干净",否则指标就变成噪音。而 no-explicit-any 这类警告恰恰很麻烦:不是每次都要修,得看情况;一条条抑制又很枯燥,看起来也像噪音。
有了 coding agent,干净基线第一次变得可能。上面那段指引让 agent 自己做判断、允许在代码里抑制警告,抑制因此是可数、可见、可评审的。
对阈值类规则(最大行数、最大圈复杂度),她的做法是在 lint 消息里告诉 agent:如果它认为某处的重构没必要或做不到,可以小幅上调阈值。这不是永久静音——只是把线抬高一点,将来更糟时规则还会再响。这样既保住了约束,又不用在"要么抑制、要么照做"之间二选一。
观察:唯一失控的那一类,恰好没写指引
她看 AI 产生的"例外"(被抑制的警告、被上调的阈值)作为代码评审的起点。结果发现:AI 经常选择上调圈复杂度阈值,而只有当她再推一把时才会给出不错的重构方案。
而且——这是唯一出现这种行为的类别,因为她恰好没给这一类写自我纠正指引,没有任何地方说明"上调阈值应该是绝对例外"。这反过来成了证据:自定义 lint 消息确实能带来相当大的差别。
同样的机制还能处理"不同目录不同规矩"。比如 no-console:后端要求改用 logger 组件,前端可能压根不想直接打日志、或者必须用另一个日志组件。这类语义判断正好交给 AI。
规则之间的冲突,已经开始出现
她一直在留意规则互相拉扯的例子。目前只看到一处,来自 max-lines 与 max-lines-per-function:这两个传感器确实让 AI 做了不少有用的拆分重构,但在 React 前端,她看到一个令人担心的趋势——组件被拆得越来越碎,属性(props)沿着一条越来越长的链条层层透传。
AI 能不能在这种权衡里做出一致决策,她还没有足够观察。
这一节的主要收获
总体是正面惊喜:静态分析能覆盖的东西比她预想的多。她几次提醒自己:为什么过去用得不够?成本收益平衡变了。
成本降了,因为用 AI 写自定义脚本和规则便宜得多;收益也涨了,因为这些分析结果帮她快速摸到很多卫生指标——那些她自己写代码时都不一定会出现的问题,正好把 AI 的常见错误先清掉。
但她也直接说了担心:这可能带来虚假的安全感和"质量幻觉"。过去 linter 用得少,另一个原因就是它们有边界,大家怕把它当成质量的简化指标。有很多更偏语义的质量维度是静态分析抓不到的,AI 能否与这些工具配合补上这个缺口,还有待观察。
另一个具体担心是反馈过载:每启用一组新规则,她都会在代码里"发现"一批新问题,其中总有一部分无关紧要、一部分真要紧。如果全都丢给 agent,可能把它推进过度工程化重构的漩涡。
依赖规则:把分层写进工具,而不是写进 markdown
基础 lint 关注文件/函数内部。下一层是跨文件、跨模块的可维护性——这块的分析工具,历史上比基础 lint 用得更少。她试了三件事:依赖规则(确定性)、耦合分析(确定性 + 推断)、模块化评审(推断)。
依赖规则用的是 dependency-cruiser。她在实现到一半时和 agent 一起定了一套分层模块结构,然后让 AI 帮忙把这些层次写成规则。例如其中一条规定:clients 目录里的代码永远不许 import services 目录里的东西:
{
  name: "clients-no-services",
  comment: "API clients must not depend on the orchestration layer above them."
    + LAYERS,
  severity: "error",
  from: { path: "^server/clients/", pathNot: "/__tests__/" },
  to: { path: "^server/services/" },
}
和 ESLint 一样,她把错误消息扩写成了自我纠正指引,把整套分层概念复述一遍:
ERROR clients-no-services
API clients must not depend on the orchestration layer above them.
[Layers: routes -> services -> clients + domain;
 Services orchestrate: fetch data via clients, compute via domain
 -- no I/O, no SDKs, no knowledge of data fetching.]
观察:没有 AI,这套规则她不可能这么快落地——这个工具的配置语法入门成本很高,而 AI 几乎把这部分成本全吸收了。规则引入后 agent 违规过几次,然后基于 dependency-cruiser 的反馈自我纠正了,所以确实帮她把目录概念守住了。
她还用同样的办法给前端 React hooks 的结构立了规矩,另外补了一条兜底规则:任何新文件都必须落在预定义的目录结构里,否则 AI 会开始在结构之外自己开新目录。
主要收获:引入这些规则时,代码的目录结构已经有点乱了;规则帮 agent 清了一遍,之后持续执行。她认为这是用 markdown 指南描述代码结构的一个不错的替代品。但边界也明确:这类工具只能表达"能被 import、文件名、目录结构表达出来"的东西。
耦合数据:给 agent 一个 CLI,而不是一张图
接着她从代码库里抽常见的耦合指标:每个文件的入向/出向 import 与调用数量。她没用现成工具,而是让 coding agent 写了一个应用,借助 TypeScript 编译器产出这些指标,方便她随便折腾。
它有两个界面:
- 一个 Web 界面,用多种可视化给人看;
- 一个 CLI,把同样的指标喂给 coding agent。
给人看的那部分:大多是成熟概念,比如依赖结构矩阵(DSM)。她觉得这些图很难解读——虽然图是 vibe coding 出来的、肯定还能改进,但她认为主要问题在数据本身:太细,需要大量上下文和经验才能读出来,再映射回高层的最佳实践。她的感觉是,这类工具短期内帮人类减轻评审负担的作用有限,尤其是评审 AI 改过的代码库时。
给 AI 的那部分:她给 agent 开放了这个自建 CLI(coupling-analyser),让它基于数据写报告并给出改进建议。她特意贴出当时的提示词,说明自己并没告诉它什么叫好的/坏的模块化,基本把判断全交给模型:
针对目标 TypeScript 代码库产出一份模块化与耦合质量报告,必须基于npx coupling-analyser的真实输出,不要凭静态浏览猜。
收集证据(跑 CLI):执行 CLI 并捕获 stdout,按问题需要组合使用报告子命令……
写报告:用小标题;尽量引用 CLI 输出里的具体模块 ID / 路径与数字。 建议章节:背景 → 执行摘要(2–5 条:整体姿态、前 1–3 个系统性问题)→ 工具发现(热点、主要风险、值得注意的环或相互依赖)→ 解读(用模块化视角把指标和软件设计挂钩:内聚 vs 变更扩散、稳定性 vs 依赖方向、fan-in/fan-out、环的影响)→ 对每个 high/critical 问题深挖(它是什么、今天的职责、为什么有害、2 个以上设计选项、为什么新设计更好、未来变更风险)……
观察:LLM 主导的分析指出的耦合热点,和她看图得出的结论一致,只是格式更容易消化;而且要求它基于确定性工具的输出,让她更有信心,大概也比让 agent 自己扫代码库更省时间和 token。
但发现本身"相当一般"(用的 Claude Opus 4.7):
- 它说最大的问题之一是"初始化所有组件的那个 factory"——可那是她故意引入的、充当轻量依赖注入框架的组件;
- 它把前后端共享的 zod schema 判为"god module"——但这恰恰是给前后端建显式契约的常见做法,尤其在她的场景里前后端本来就一起演进、甚至同仓;
- 唯一有点意思的发现:
domain目录下的一个index.ts无差别地导出了./domain下所有文件,又被很多地方 import。这也是给一层建显式契约的常见做法,有利有弊,至少值得查一下是否适合这个代码库。
她的结论是:合理的高耦合"枢纽"需要能被抑制,否则这类分析只会制造更多噪音。
主要收获:相比基础 lint,这里"好与坏"更没有清晰定义,关键是是否合适;而合适与否依赖大量上下文,不只是调用/import 图。所以她不认为这种耦合数据单独喂给 AI 有多大用。更实际的用法是代码评审时的风险分级:评审 AI 的改动时,知道被改文件的影响半径很有用——比如某个有 10 个以上调用方的文件被改了,就该多看两眼;或者让 AI 评审 agent 用这些数据来决定 token 花在哪。
让 AI 做模块化评审:比耦合数据好用得多
耦合数据那轮结果一般,可能有三個原因:提示词不够具体、耦合数据对 AI 没用、或者数据太浅、缺少完整代码的上下文。
于是她干脆走纯推断路线:用 Vlad Khononov 的 "Modularity Skills" 让 AI 分析代码库设计、找模块化问题。这一步非常有效,给了她很多能明显降低未来变更风险的重构方向。
她又跑了一遍,这次把耦合分析 CLI 也给它。结果是:AI 主要在数据里找印证,没有新增发现;反过来,它指出了 CLI 漏掉的很多东西。另外,第二次运行(看不到第一次的上下文)又冒出了第一次没发现的问题——她的提醒是:真正重要的时候,值得把基于 LLM 的分析多跑几遍。
发现的样本(同样用 Claude Opus 4.7):
- 重复的路由代码:三个后端端点各有自己的路由文件,实现几乎一样。要改后端 API 的通用原则(加 request ID、改错误处理、改日志方式),就得改好几个文件。她刚加第三个端点,没抽象还算合理;但她的经验是AI agent 通常不会主动重构——同一段代码重复到第三、第四次时它照样乐呵呵地复制粘贴。
- 调用后端不一致:三个页面要用同一组参数(选中的聊天空间、分析的日期范围)调后端。前两个页面用同一个 hook、同一套做法,AI 做第三个页面时偏离了,自己另写了一套。这会导致错误处理不一致,或者后端 API 原则一变就要动多处。
- 核心参数处理低效:所有页面都要把聊天空间 ID 和日期范围传给后端。她之前改日期范围的选择方式时,AI 动了 40 多个文件——分析确认了问题:"请求参数在每一层重复",建议是把这些参数包成一个对象。AI 其实已经这么做了,但从没贯彻使用,成了一个不一致的烂摊子。
- 职责放错位置:评审发现一段认证代码塞在只负责"接线"的 factory 里,实现了"用户未登录时回退到 mock 数据"。这种意外位置的风险是:将来加新路由时很容易被漏掉。
有意思的是,前一轮耦合分析把那些高 import 数"枢纽"当成 god class,这一轮也注意到了,但两次都很好地指出它们在这个应用语境里有存在的目的。她推测原因是这些 skill 的提示词写得好,或者是因为这轮分析真的读了代码内容,而前一轮只让它看耦合数据。
主要收获:
- dependency-cruiser 这类依赖解析器是有效的实时传感器,能守住基本的目录结构与依赖方向,但也就到此为止;
- AI 模块化评审是很好的"垃圾回收",前提是提示词足够强;把它锚定在耦合数据上没看出多少差别;
- 理想是让它针对一次提交里改动的文件跑,把这一步提前到流水线里,但她还没试;
- 她是在代码库基本建完之后才第一次做这种评审,结果发现了相当有说服力、也确实令人担心的问题,这些问题未来会抬高风险。这说明:没有人工评审、没有耦合方面的专业判断、也没有这类额外的 AI 评审时,agent 确实在复利式地累积无意的技术债。
总的来说:代码库设计与模块化这类关切,计算型传感器单独帮不上太多忙,需要 AI 补上语义解释与权衡。
测试套件作为回归传感器
测试有很多用途:帮助思考与驱动设计、记录期望行为(测试就是最终规格)、以及检测回归——告诉你这次改动弄坏了原来能用的功能。有效的回归测试对可维护性作用很大,它让"改代码"这件事安全得多。
所以这一节讲的是测试套件在"回归传感器"这个角色上的表现。
当一条旧测试失败,我们必须问自己一个问题:"是我意外弄坏了什么、需要改实现?还是我确实有意改变行为、测试应该跟着改?" 一条失败的测试给了 AI 提出这个问题的机会——虽然它不一定总做对。但一个好的测试套件,能显著降低 AI 弄坏期望行为的概率。
在这个聊天分析应用里,所有测试都是她让 agent 随时间写出来的,除了手动测试和盯着覆盖率之外没什么监督。她想要一个全 AI 生成的测试套件,好在事后分析它的回归有效性。
这样做有两个主要风险:
- 覆盖率不足以指示测试有效性;
- 测试可能在测错误的行为——这个问题比评估测试有效性难得多,属于另一篇文章。
本文只谈测试有效性:假设代码实现了期望行为,我们有没有能抓住破坏性改动的测试。
她列的工具箱与成本:
| 手段 | 能发现什么 | 成本 |
|---|---|---|
| 覆盖率 | 哪些代码被测试执行过,也就是哪些部分对测试"可见/不可见" | $ |
| 属性测试 | 通过从性质生成大量输入组合,发现缺失的逻辑用例 | $ |
| 模糊测试 | 用意外/畸形输入打系统,发现输入健壮性方面的缺失用例 | $$ |
| 变异测试 | 往代码里注入小变异,看测试套件能不能抓住,从而发现缺失的断言 | $$ |
她的应用里用了覆盖率与变异测试;属性测试与模糊测试不太适合这个场景。
变异测试:一个 100% 覆盖却没断言的例子
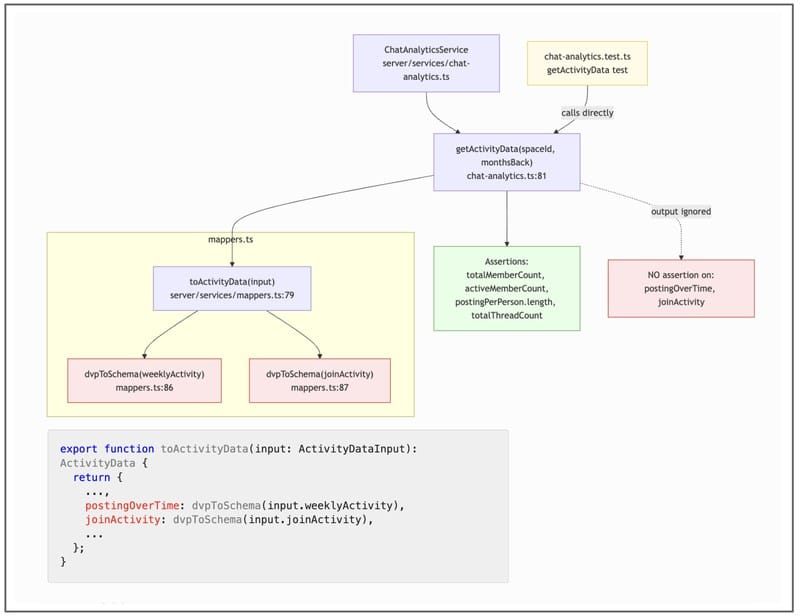
mappers.ts 报告了 100% 语句覆盖、75% 分支覆盖,但实际上它没有任何单元测试,Stryker(她用的变异测试工具)报告了 13 个 survivor——也就是在 13 处代码变异之后,测试套件依然是绿的。
覆盖率之所以高,是因为代码库里有个大的验收测试最终调用了这些函数:覆盖率只说明某一行被执行过,不说明它的影响被验证过。如果那个小工具函数 dvpToSchema 将来被改动,可能会让 UI 里的一张数据图显示错误。
观察:AI 在分析变异热点、制定"先补哪里测试质量"的优先级上很有帮助。Stryker 会写一个巨大的 JSON 结果文件,为避免把上下文窗口塞爆,她让 AI 写了个自定义脚本 query_stryker.py 来高效查询结果:
"""从命令行查询 Stryker 变异测试 JSON 报告。

用法:python query_stryker.py <report.json> <command> [options]
命令:
  summary   整体状态统计、变异分数、阈值
  files     按文件拆解,默认按变异分数升序
  hotspots  存活变异 / 未覆盖变异最多的行
  tests     测试有效性:弱测试、未使用测试、最能杀死变异的测试

示例:
  python ./query_stryker.py reports/mutation/mutation.json summary
  python ./query_stryker.py reports/mutation/mutation.json files --top 10 -v
  python ./query_stryker.py reports/mutation/mutation.json files --changed -v
  python ./query_stryker.py reports/mutation/mutation.json hotspots \
      --file server/services/ai-summaries.ts --top 30
"""
她说这只是"AI 帮我帮 AI"的众多例子之一。
主要收获:
- 现在有股"往端到端验收测试倾斜"的趋势。AI 写测试已经很强,开发者让它批量生成、几乎不评审也成了常态;而逐个评审单元测试非常枯燥。她不是主张完全不看,但承认现实:指望人工评审所有测试不可持续,指望人们真去做也不现实。
- 在找到 AI 编码时代该有的测试金字塔形状之前,像"已批准场景(approved scenarios)"这类技术正在变流行。
- 验收测试提高覆盖率,但断言往往不多,会带来测试有效性的虚假安全感——变异测试正好用来监控这个缺口。
- 变异测试的实际限制是资源开销大。她的做法是不连续跑,而是手动触发增量运行。
结论与开放问题
计算型传感器在文件和函数层面给她的印象最好。跨文件的模块化与耦合是另一回事:原始数据本身噪音很大,没有 LLM 的语义解释(也就是推断型传感器)就没那么有用。但配上好提示词之后,产出和建言之好、以及"同样的信息可以按不同经验水平呈现"的潜力,都让她印象深刻。
她还没在实验里看到、但怀疑会成为问题的是传感器之间的冲突:max-lines 与 max-lines-per-function 已经显出张力,函数被拆得越来越小,复杂度被推到了组件属性链上。更多这类权衡大概还藏着。
这次实验她完全没用指南(guides),就是为了更纯粹地看传感器的作用。她好奇的是指南与传感器如何配比:
- 一旦对一套传感器有信心了,哪些指南可以删?
- 传感器是不是让"用更弱的模型"变得现实?
- 怎么保证指南和传感器彼此一致,能不能把它们打包在一起维护?
在回归测试这块,她的原话是:看到"把大部分测试交给 AI"之后变异测试变得多关键,眼睛真的被打开了。她同时强调:还有一整个关于测试正确性的话题没谈——有些传感器确实提高了她对产出的信任,但它们不是把人完全移出循环的魔法方案。不过作为伙伴,计算型和推断型传感器确实改善了她的评审体验和信任度。
(致谢:特别感谢 Chris Ford 与 Matteo Vaccari 关于传感器的讨论,以及 Thoughtworks 同事的反馈。)
我们的整理:哪些能交给 lint,哪些不能
原文按"传感器类型"走,这里换成按你能落地的东西重排一遍,方便直接对照自己的仓库:
| 层次 | 具体传感器 | 原文结论 | 落地成本 |
|---|---|---|---|
| 文件/函数内 | ESLint + 四条阈值(参数数、文件行数、函数行数、圈复杂度) | 最有效,但默认预设不开,要自己配 | 半小时 |
| 文件/函数内 | 自定义 formatter,把报错文本改成"判断 + 带理由抑制" | 有效;缺指引的那类规则明显失控 | 半天(可让 AI 写) |
| 跨文件结构 | dependency-cruiser 分层规则 + 目录兜底规则 | 有效,能替代"用 markdown 描述目录结构" | 半天到一天 |
| 跨文件结构 | 耦合指标(自建 CLI) | 单独给 AI 用处不大;更适合给评审做风险分级 | 一天以上,性价比看团队 |
| 设计层 | AI 模块化评审(强提示词 + 读代码) | 效果最好的一类"垃圾回收",值得定期跑,且跑两遍 | 低(提示词成本) |
| 回归 | 覆盖率 | 只能说明"执行过",不能说明"验证过" | 已有 |
| 回归 | 变异测试(增量跑) | 补住"验收测试断言少"的缺口;资源开销大 | 中 |
三条可直接照做的动作:
- 先把四条阈值打开,并且只在 lint 消息里写"可以小幅上调阈值,但不要抑制"——原文里唯一失控的行为,就是发生在没写这句的地方。
- 给每条规则写一句"为什么"和"怎么做",让报错文本本身成为提示词;抑制必须带
-- 理由。 - 跨文件的判断别指望 lint:目录结构交给 dependency-cruiser,设计与耦合交给"带强提示词的 AI 评审",而且要跑两遍。
边界:这是一个单人、单技术栈(TypeScript / Next.js / React)、单应用的实验,所有数字都是这一份代码库的观察,不是基准测试;模型版本(Claude Opus 4.7、Sonnet、Cursor composer-2)会变,结论里"AI 经常上调圈复杂度阈值"这类行为也可能随模型更新而变。原文也明确说,传感器不能替代人工评审。
两条延伸:如果你是规范本身写清楚了、但 agent 记不住,那问题在反馈回路而不在规则,见三条指令没拦住 Claude;至于"lint 全绿之后还剩下哪几层风险",见lint 不够用。
来源
- Birgitta Böckeler, Maintainability sensors for coding agents, martinfowler.com, 2026-05-27:martinfowler.com/articles/sensors-for-coding-agents.html
- 文中代码片段、提示词、图表与观察结论均译自原文;图 1 为原文 Figure 2 的转载
- 感谢原文作者与 Thoughtworks;本文为中文编译,版权归原作者
本文属于「AI 编程 / Vibe Coding」专题,由汇智网编译整理,转载请注明出处。
这是「AI 编程 / Vibe Coding」专题的一部分。完整地图见:AI 编程 / Vibe Coding 完全指南