后训练革命:RL 是新的护城河
反转是真实的——前沿实验室的后训练计算量已超过预训练
博途PLC工程智能体 | AI智能体博途网关 | 博途PLC程序知识图谱 | 梯形图转SCL | 自然语言生成梯形图 | 自然语言生成SCL | 逆向生成程序块文档 | 梯形图在线查看 | 博途编程文档MCP | AI模型价格对比 | AI工具导航 | ONNX模型库 | Vibe Coding教程 | PLC在线仿真器 | Tripo 3D | Meshy AI
Cursor 披露 Composer 1.5 在 RL 后训练上的计算投入超过了预训练基础模型。OpenAI 的 o 系列、Anthropic 的 Constitutional AI 和 DeepSeek-R1 都指向同样的转变。SpaceX × Cursor 的 600 亿美元期权是一笔 RL 计算基础设施交易。前沿护城河已经转移到这里。
未来 12 个月将由 RL 计算整合定义。 更多 600 亿美元级别的基础设施交易可能发生。能够负担持续 RL 飞轮的实验室——专有任务分布、奖励模型和大规模运行循环的计算——正在超越只能在预训练上竞争的实验室。
1、反转:当后训练计算超过预训练时
传统的模型开发经济学是单向的:将大部分计算预算花在互联网规模数据上预训练大型基础模型上,然后应用相对廉价的对齐流程(SFT 后接 RLHF)使模型可用。后训练是最后一道漆,而不是结构性工作。
这个比例在前沿已经反转。基础模型现在是一个起点——一个良好的权重初始化。真正的差异化发生在之后你对它做什么:你在什么任务分布上训练、设计什么奖励信号、使用什么 RL 算法针对该信号进行优化,以及为这个循环分配多少计算。InstructGPT 论文(Ouyang et al., 2022)将 SFT → 奖励模型 → PPO 流程产品化。但那篇论文中描述的计算比例与前沿实验室今天运行的情况完全不同。
值得追踪的信号不是哪个实验室拥有最大的基础模型——随着高效架构的传播,这些数字正在趋同。信号是哪个实验室能在最精心策划的任务分布上运行最强大的 RL 后训练循环。能力差距正在那里拉开。
为什么这很重要
在相同公开网络语料上训练的基础模型正在能力上趋同。当两个实验室使用相似的预训练数据和相似的架构时,后训练流程成为主要差异化因素。没有专有 RL 基础设施的实验室实际上是在一个正在被商品化的维度上竞争。
2、Cursor Composer 1.5:清晰的锚点
2025年9月,Cursor 发布了 Composer 1.5 公告,披露了其他任何前沿实验室在编号模型发布上都没有做过的事。来自 Cursor 博客的关键句子:投入 Composer 1.5 后训练的总计算量甚至超过了预训练基础模型所用的计算量——这是典型模型开发经济学的惊人反转。
除了这一声明性说法,Cursor 还量化了 RL 扩展:Composer 1.5 是通过在为 Composer 1 提供动力的同一预训练模型上将强化学习进一步扩展 20 倍构建的。这是公开记录中唯一一个前沿编码实验室对特定模型发布同时给出方向性披露(后训练 > 预训练)和定量倍数(20 倍)的案例。其他每个实验室都在研究论文或财报电话会议中笼统地讨论这一转变。Cursor 给出了一个数字。
后训练计算超过预训练不是理论上的反转——这是发货给数百万开发者的公司中有据可查的产品决策。
3、SpaceX × Cursor:$60B的RL基础设施交易
2026年4月21–22日,SpaceX 披露了以 600 亿美元收购 Cursor 的期权,分手费 100 亿美元,可在 SpaceX 计划的 IPO(目标 2026年6月12日,估值 1.75 万亿美元)后约 30 天行使。TechCrunch、Fortune 和 CNBC 报道了这笔交易。
大多数报道将这笔交易框定为 Cursor 估值故事——一家价值 600 亿美元的初创公司是值得注意的事件。更重要的解读是结构性的:该合作使 Cursor 能够接触 xAI Colossus 的 GPU 集群(广泛报道约 100 万块 H100),用于 Composer 2.5 的训练循环。SpaceX 收购的不是一个编码工具,而是运行在其计算基底上的 RL 后训练管道。
这重新定义了 600 亿美元这个数字。溢价不是为了 Cursor 当前的收入或其 IDE 分发。至少部分是为了 Composer 1.5 和 2 构建的专有 RL 训练循环和智能体编码任务分布的估值。当计算规模是差异化因素时,能够接触最大 RL 集群和最有针对性的任务分布的公司拥有通往下一个基准跳跃的最清晰路径。这就是 SpaceX 所押注的。
4、Cursor Composer 2.5:在 Colossus 上训练
Cursor 的 Composer 2.5 计划于 2026年5月18日发布——从本文发布日期算起的明天。根据 Cursor 博客,发布前的厂商发布的基准测试声称在 CursorBench v3.1 上达到 63.2%(厂商控制的基准——方法论注意事项适用),在 SWE-Bench Multilingual 上达到 79.8%(厂商发布,尚未第三方验证)。定价为每百万 token $0.50 输入 / $2.50 输出(标准),$3.00 / $15.00(快速变体)。
Colossus 基底是使 Composer 2.5 成为 SpaceX 交易论点最直接演示的原因:面向智能体编码的 RL 后训练,以以前只有最大 AI 实验室才能获得的规模运行。Composer 系列是 Cursor RL 研究的主要产品面,Composer 2.5 是该系列中第一个使用 xAI Colossus 计算进行训练的模型。这如何转化为真实世界的智能体任务性能,在明天发布和第三方评估之后会更加清晰。
5、OpenAI o 系列:两条扩展曲线,不是一条
OpenAI 在 2024年9月12日的 o1 公告引入了一个后来成为行业参考点的框架。来自 o1 博客:"我们发现 o1 的性能随着更多的强化学习(训练时计算)和更多的思考时间(测试时计算)而持续提升。"
该博客发布了两张扩展图。两者都显示准确率随各自的计算轴呈对数线性提升。传统的预训练轴——模型参数作为训练 token 的函数——被视为第三个已成熟的维度。OpenAI 发现的是存在两个新的独立扩展轴,两者都可以单独优化:训练期间花费多少 RL 计算,以及测试时分配多少推理计算。Snell et al.(2024年8月)同时形式化了测试时维度,证明对于某些问题类别,扩展 LLM 测试时计算可能比扩展模型参数更有效。
测试时轴的产品面现在在整个行业可见:OpenAI 的 GPT-5.2 推出了第五个推理努力级别 "xhigh",分配最大测试时计算,Anthropic 的可见扩展思考功能为 Claude 暴露了相同的轴,DeepSeek V4 的 Think Max 模式基于相同的原理运行。
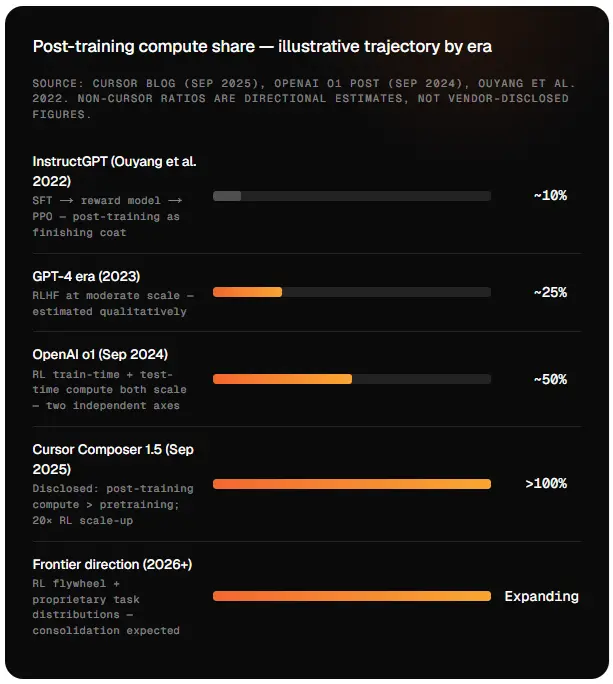
上面的柱状图明确说明了哪些是有来源的,哪些是方向性的。只有 Cursor Composer 1.5 行是厂商披露的数字。其他行代表研究论文和产品公告支持的转变定性方向,而不是编造的百分比。我们标记这一点,因为 RL 报道中主要的捏造模式是"自信而具体的编造百分比"(例如"Anthropic 将 70% 的计算花在 RLHF 上")——这是一个没有任何实验室公开做出过的声称。
6、Anthropic:驱动 Opus 4.7 的 RLAIF 脊梁。
Anthropic 的后训练方法锚定在 Constitutional AI(CAI)上,由 Bai et al.(2022年12月)引入。该方法使用基础模型对照书面的"宪法"原则进行自我批评和自我修正,用 AI 反馈取代奖励建模管道中的人类偏好标注步骤。这就是 RLAIF — 来自 AI 反馈的强化学习 — 截至 2026 年它仍然是 Claude 对齐训练的规范方法。CAI 论文仍然是有效的参考;我们不制造未发表的更新。
后训练作用的产品级证据来自 Opus 4.7,于 2026年4月16日发布。根据 Anthropic 的公告,Opus 4.7 在 SWE-Bench Verified 上达到 87.6%(从 Opus 4.6 的 80.8% 提升),在 SWE-Bench Pro 上达到 64.3%(从 53.4% 提升)。Verified 提升 6.8 分,Pro 提升 10.9 分。Anthropic 将这些提升归因于后训练 — CAI 加 RL — 而不是基础模型规模的增加。
Anthropic 于 2026年2月完成的 300 亿美元 G 轮融资(投后估值 3800 亿美元)包含了通过 AWS Bedrock 和 GCP 分配的大型 RL 计算承诺资金。Anthropic 不公开披露其预训练和后训练之间的计算分配。它披露的是结果:后训练管道驱动的基准改进,以及完全依赖后训练的产品路线图(Claude Code、扩展思考、通过 Claude Agent SDK 的智能体)。
7、DeepSeek R1:来自纯 RL 的推理 ,更便宜。
DeepSeek 的 R1 论文(arXiv, 2025年1月22日)证明了 RL-in-LLM 文献中理论上但未在规模上清晰展示的东西:推理能力可以从应用于预训练基础模型的大规模 RL 中涌现,只需对推理格式进行最少的监督微调。R1-Zero,最纯粹的变体,使用 GRPO — 组相对策略优化 — 没有对推理轨迹格式进行监督预训练。模型将思维链行为作为 RL 目标的涌现属性发展出来。
GRPO 之所以重要,是因为它比标准 PPO 管道更便宜。PPO 需要一个与策略网络并行运行的单独 critic 网络来计算优势估计,使内存和计算开销翻倍。GRPO 通过为每个提示采样多个输出、计算组相对奖励(这个样本比组平均好多少)并将其用作优势估计来取代 critic。没有单独的 critic;没有价值函数训练。对于在 DeepSeek 计算预算下运营的实验室来说,这是每个 RL 训练步骤的显著成本降低。
更广泛的意义是,前沿质量的 RL 后训练不再是拥有无限计算的实验室的专属领域。GRPO 以及 DPO(Rafailov et al., 2023, NeurIPS 最佳论文)和 KTO(Ethayarajh et al., 2024)等类似算法正在降低有竞争力的后训练的计算门槛。DeepSeek R1 是 RL 轴可以独立于预训练参数量进行优化的最清晰证明——这使得下面算法系列图中的计算效率故事与评估后训练路径的团队直接相关。
算法对比
- RLHF / PPO — 经典流程
SFT → 奖励模型 → PPO。InstructGPT 时代的标准。在人类偏好上训练的单独奖励模型;PPO 针对它优化策略。需要 critic 网络,高内存开销。OpenAI 仍以修改形式使用。
- DPO — 直接偏好
单一偏好损失目标。消除显式奖励模型和 PPO 循环。直接在(选择,拒绝)偏好对上以闭式损失训练。NeurIPS 2023 最佳论文。在较低计算下广泛用于指令跟随微调。
- KTO — 二元标签优化
仅好/坏标签。Kahneman-Tversky 优化。每个样本只需要二元好/坏信号——不需要配对偏好数据。数据成本低于 DPO;许多任务的对齐质量相当。
- GRPO — 组相对
组采样优势,无 critic。DeepSeek 的算法。为每个提示采样多个输出,使用组相对奖励作为优势估计。消除 critic 网络——在相当的策略质量下大约是 PPO 一半的内存。使 R1-Zero 的纯 RL 推理成为可能。
- RLAIF / CAI — AI 反馈
自我批评 + 宪法修正。Anthropic 的 Constitutional AI。基础模型对照书面宪法自我批评,无需人工标注即可产生偏好数据。按比例扩展偏好数据生成步骤,无需成比例的人工成本。
- RLAIF / RLHF 混合 — 混合信号
人类 + AI 偏好标签。大多数大型实验室的生产标准。人类标签在细微案例上提供高质量信号;AI 标签扩展数量。确切比例是实验室专有的,不公开披露。
8、披露矩阵:每个实验室实际说了什么
每篇关于"RL 是新的扩展轴"的报道都孤立地引用 o1 博客或 Composer 1.5 博客。下面是第一份汇总矩阵,列出所有五个前沿参与者公开披露的后训练计算情况——附有来源,并明确标记未披露的内容。没有编造的百分比。
Cursor — Composer 系列 — 已量化
披露:后训练计算超过预训练;Composer 1.5 实现 20 倍 RL 扩展(2025年9月)。方法:RL 用于智能体编码工具。基础设施:自有集群 + 通过 SpaceX 交易获得 xAI Colossus(2026年4月)。最新披露:Composer 1.5 博客 + Composer 2.5(2026年5月18日发布)。
OpenAI — o 系列 — 定性曲线
披露:o1 发布 RL 扩展曲线(训练时 + 测试时都呈对数线性扩展);未说明计算分配百分比。方法:RLHF + RL 用于思维链轨迹。基础设施:Microsoft Azure + 自有基础设施。最新:o1 博客,2024年9月12日。
Anthropic — Claude 4.x — CAI 作为支柱
披露:Constitutional AI 是规范的后训练方法(Bai et al. 2022)。Opus 4.7 基准提升归因于后训练。未披露计算分配。基础设施:AWS Bedrock + GCP(G 轮资金已承诺)。最新:Opus 4.7 公告,2026年4月16日。
DeepSeek — R1 + V3-V4 — 已发布训练曲线
披露:R1 论文发布 RL 训练曲线;R1-Zero 使用纯 RL(GRPO)训练,无 SFT。DeepSeek V4 使用 On-Policy Distillation 后训练。基础设施:自有数据中心。最新:R1 论文,2025年1月22日;V4 报告,2026年4月。
xAI — Grok 4.x — 基础设施已披露,方法未披露
披露:Memphis Colossus(广泛报道约 100 万块 H100)是 xAI 训练和 Cursor Composer 2.5(通过 SpaceX 交易)的计算基底。后训练方法:混合,具体细节未披露。最新:docs.x.ai,2026年5月17日重新验证。
这个矩阵显示了什么
Cursor 是唯一在编号模型上披露量化的计算分配的实验室。OpenAI 和 DeepSeek 发布了扩展曲线,但未将训练与后训练预算分开。Anthropic 命名了其方法但未量化预算。xAI 披露了其基础设施但未披露其方法。如果你看到一篇声称除 Cursor 外任何实验室精确后训练百分比的报道,请将这些数字视为编造的,直到引用了主要来源。
9、新的护城河:数据、基础设施及后续计算支出
反转的结构性含义是,AI 中可防御的护城河已经从预训练数据(大部分公开、大部分共享)转移到后训练资产:你可以生成的专有任务分布、你可以为特定领域构建的奖励模型,以及你可以运行循环的 RL 基础设施。在相同网络语料上训练的基础模型正在趋同。分歧正在后训练中发生。
这已经在市场上可见。对 Cursor 的 600 亿美元期权是对面向智能体编码的 RL 后训练的基础设施押注。Anthropic 的 300 亿美元 G 轮融资部分是通过 AWS 和 GCP 进行 RL 循环的计算承诺。OpenAI 2026年第一季度约 60 亿美元的收入,Codex 作为 PYMNTS 突出的增长驱动因素,反映了一个后训练专业产品的大规模创收。
展望未来 12 个月:轨迹表明将围绕四到五个能够维持持续 RL 飞轮的实验室进行整合——生成专有任务分布、针对它们训练奖励模型、在专用基础设施上运行大规模 RL 循环,并将产出作为产品发布。该集团之外的实验室可能面临仅靠预训练无法弥合的加速能力差距。RL 后训练的经济学有利于规模和专业化。更多 600 亿美元级别的计算合作和基础设施交易是可能的。以 DeepSeek 的 GRPO 工作为代表的开放权重路径可能作为特定领域的可行替代方案持续存在——但即使在那里,优势也会流向为目标任务分布拥有最佳专有奖励信号的实验室。
10、结束语
后训练是前沿护城河正在构建的地方。
计算曲线的反转是真实且有据可查的。Cursor 拥有唯一量化的披露。OpenAI、Anthropic 和 DeepSeek 各自以自己的方式确认了这一转变——通过扩展曲线、方法论文和无法仅用预训练解释的基准结果。SpaceX × Cursor 交易将估值故事转化为基础设施故事:溢价在于 RL 循环,而不是 IDE。
2026 年重要的护城河是后训练数据、领域特定的奖励模型,以及大规模运行循环的 RL 计算基础设施。基础模型正在趋同。差异化在于预训练结束后你对基础模型做什么。能够维持持续 RL 飞轮的实验室——目前有四到五个能够负担——正在复合曲线上领先。
在接下来的 12 个月里,预计会有更多 Colossus 规模的基础设施交易,后训练领导权将在少数实验室中进一步整合,这些实验室与仅在预训练上竞争的实验室之间的能力差距将扩大。
原文链接: Post-Training Revolution: RL Is the New Moat 2026
汇智网翻译整理,转载请标明出处