
TOOL
Labelbox 图像自动标注
在本指南中,您将学习如何通过利用 Labelbox 和基础模型来指数级提高标注速度和效率。
TOOL
在本指南中,您将学习如何通过利用 Labelbox 和基础模型来指数级提高标注速度和效率。

VLM
SAM3 + Grounding DINO + VLM — 并行运行多种策略,为你的物体选择最佳方案。

TOOL
现在可以使用 Roboflow Annotate 来标记和审查多模态视觉模型的数据。然后,你可以将这些数据导出为几种流行的格式,包括 GPT-4o 所需的格式,以用于微调大型多模态模型。

DATASET
本文介绍如何使用 Grounding DINO、SAM 和 AutoDistill 等模型/工具自动生成图像数据集的标注数据。
MODEL-ZOO
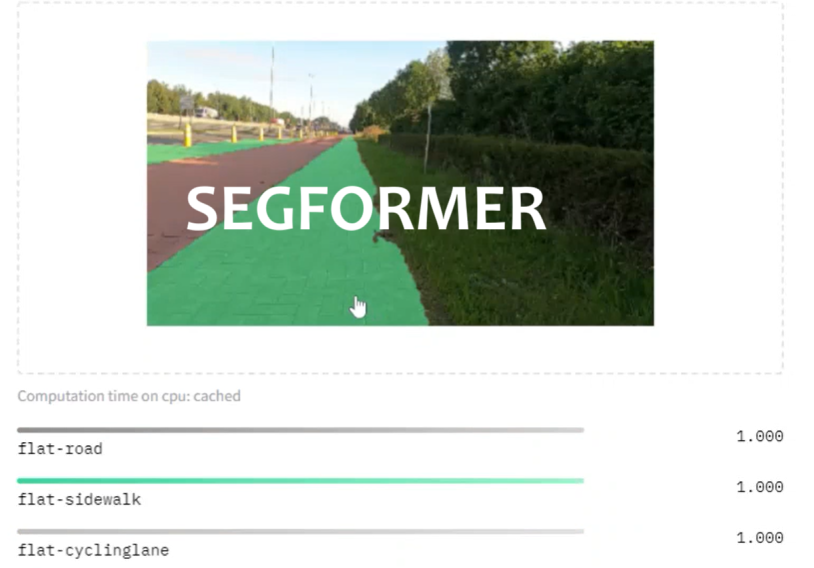
本指南展示了如何微调 Segformer,这是一种最先进的语义分割模型。我们的目标是为披萨送货机器人建立一个模型,这样它就可以看到要行驶的方向并识别障碍物 🍕🤖。 我们将首先在 Segments.ai 上标记一组人行道图像。然后,我们将使用 🤗 transformers 微调预先训练的 SegFormer 模型,transformers 是一个开源库,提供最先进模型的易于使用的实现。在此过程中,我们将学习如何使用 Hugging Face Hub,这是最大的开源模型和数据集目录。 语义分割是对图像中的每个像素进行分类的任务。你可以将其视为对图像进行更精确分类的方法。它在医学成像和自动驾驶等领域有广泛的用例。例如,对于我们的披萨送货机器人来说,重要的是要确切地知道人行道在图像中的位置,而不仅仅是是否有人行道。 因为语义分割是一种分类,所以用于图像分类和语义分割的网络架构非常相似。 2014 年,Long 等人发表了一篇开创性的论文,使用卷积神经网络进行语义分割。 最近,Transformers 已用于图像分类(例如 ViT),现在它们也用于语义分割,进一步推动了最先进的技术。