
LIBRARY
Docling+视觉AI增强
我用我的视觉解析器增强了 Docling,以实现视觉增强的解析和 RAG 分块
LIBRARY
我用我的视觉解析器增强了 Docling,以实现视觉增强的解析和 RAG 分块

AGENTIC RAG
作为研发工作的一部分,我需要尽可能准确地从 PDF 文件中提取文本数据。过去,我曾使用 PyMuPDF 或 OCR 引擎 Tesseract 从 PDF 文件中提取文本。

APPLICATION
本文展示了如何通过结合ExtractThinker、Ollama、Docling或MarkItDown来构建完全本地的文档智能解决方案。
APPLICATION
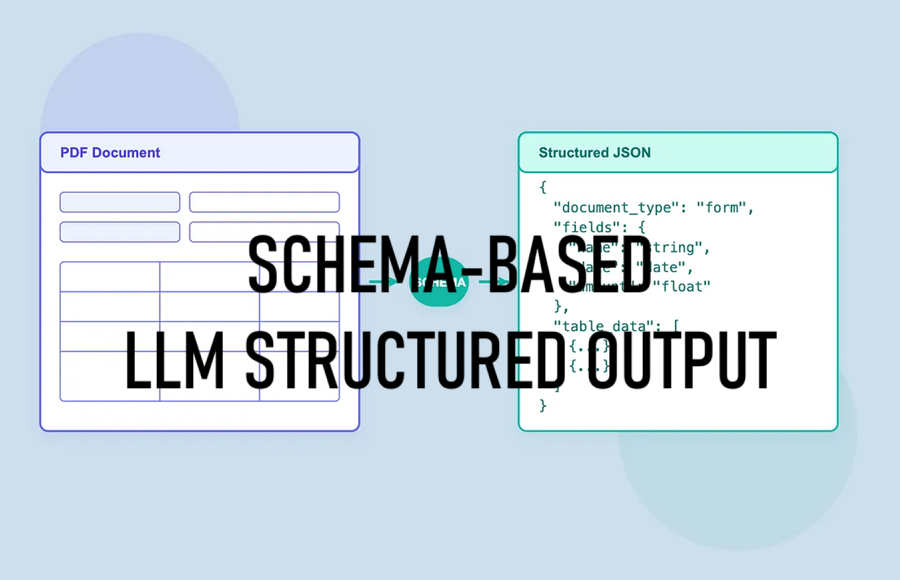
记者们通过文档转储和白皮书获得 PDF 作为对 FOIA 请求的回应。要使用 PDF,这些记者需要从文档中获取数据并将其转换为易于分析的格式,例如电子表格。该过程可能涉及费力的手动转录或将数据从一种格式复制并粘贴到另一种格式。 从理论上讲,大型语言模型可以协助文档处理,但幻觉等风险和 LLM 输出固有的不确定性使这种方法变得棘手。记者需要确保输出确实包含所需的数据、遵循所需的数据类型并采用可用的格式。 结构化输出为这些挑战提供了解决方案。像 Anthropic 和 OpenAI 这样的提供商以及像 Outlines 这样的开源库允许开发人员定义严格的模式,将 LLM 响应限制在特定字段、数据类型和格式。 结构化输出将原始的 LLM 功能转换为可靠的数据处理管道。例如,从多页 PDF 中提取表格时,模式可确保跨页面的列名和数据类型一致。虽然这种方法不能保证完全准确,但它降低了解析和验证 LLM 响应的工程复杂性,使文档处理工作流更加可靠和易于维护。 模式本质上是一个蓝图,它告诉模型要查找哪些信息以及如何组织这些信息。可以将其想象成一个标准化表格:记者不是让模型以任何格式返回数据,

LIBRARY
ParseStudio提供了一个统一的界面,支持多个解析后端,使文档解析一致、初学者友好且高效。无论你是处理 PDF、提取文本和图像还是分析表格,它都能确保你专注于目标,而不是工具。