ALGORITHM
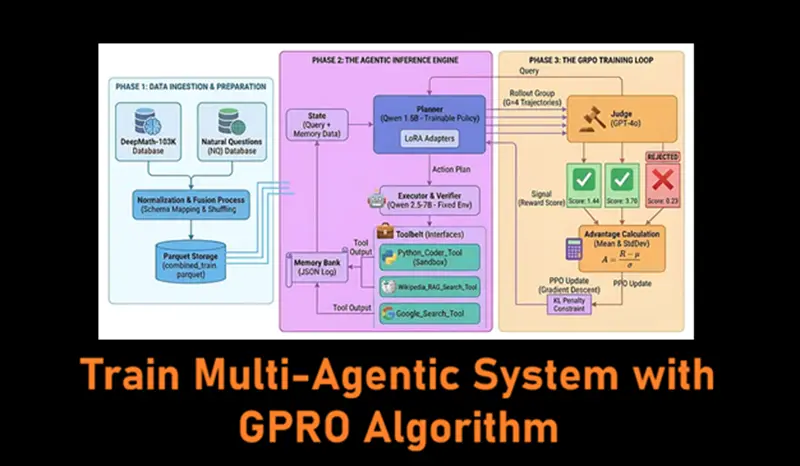
用GRPO算法训练多智能体系统
在这篇博客中,我们将学习和理解GRPO算法与AI智能体的关系,然后创建一个多智能体系统并使用GRPO训练它。
ALGORITHM
在这篇博客中,我们将学习和理解GRPO算法与AI智能体的关系,然后创建一个多智能体系统并使用GRPO训练它。

APPLICATION
即使是非常强大的LLM也可能很难可靠地完成复杂的多轮代理任务。有趣的是,我们发现使用一种叫做GRPO(群体相对策略优化)的强化学习算法来训练代理可以使它们更加可靠!

APPLICATION
大型语言模型(LLMs)与医疗保健的交叉点带来了令人兴奋的机会,但也带来了独特的挑战。在本教程中,我们将探讨如何使用分组相对策略优化(GRPO)——一种最近由DeepSeek团队引入的有前途的新强化学习技术——来适应阿里巴巴的Qwen-3B模型以用于医学推理。 为什么这很重要: * 🏥 患者安全第一:医学AI中的幻觉可能是危险的。 * 💡 领域专业化:通用LLMs难以处理临床推理。 * ⚡ 效率:我们的3B参数模型可以在消费级GPU上运行。 推理模型如O3和DeepSeek R1在许多具有挑战性的基准测试中显示了前所未有的改进。它们改变了监督微调的趋势,转向实际的强化学习(RL)。我们在深度学习领域的许多突破都来自RL,例如AlphaGo,因为模型能够通过与不同的现实场景互动来学习,而这些场景在监督微调中往往难以提供示例。 如果你想了解更多关于推理模型或更多历史细节,我强烈推荐Maarten的文章[2]。DeepSeek工作的美妙之处在于他们实现了一个实用的框架,用于使用GRPO对LLM进行微调。根据Maarten的文章: 这个算法背后的直觉是,它使所有导致正确或错
MODEL-ZOO
我们采用了一个微小的 0.5B 参数模型,在我们的家庭实验室中向它投入了一些 GRPO,并设法教会它一些相当不错的推理技能。
TOOL
DeepSeek 的 R1 研究揭示了一个“顿悟时刻”,其中 R1-Zero 通过使用群组相对策略优化 (GRPO) 自主学习分配更多思考时间而无需人工反馈。你就可以使用 Unsloth和Qwen2.5 (1.5B) 在仅 7GB 的 VRAM 上重现 R1-Zero 的“顿悟时刻”。

MODEL-ZOO
为了让一切变得简单,我们将使用手绘流程图和简单的计算来帮助从头开始澄清DeeoSeek-R1的核心概念。

MODEL-ZOO
DeepSeek 提出了一个模型,该模型的推理能力可与 OpenAI-o1 相媲美,尽管其参数只是 OpenAI-o1 的一小部分,训练成本也低得多。

MODEL-ZOO
DeepSeek使用简单的强化学习(GRPO)来训练像 DeepSeek-R1 这样的 LLM,本文将尝试了解GRPO与OpenAI使用的RLHF强化学习有何不同。
MODEL-ZOO
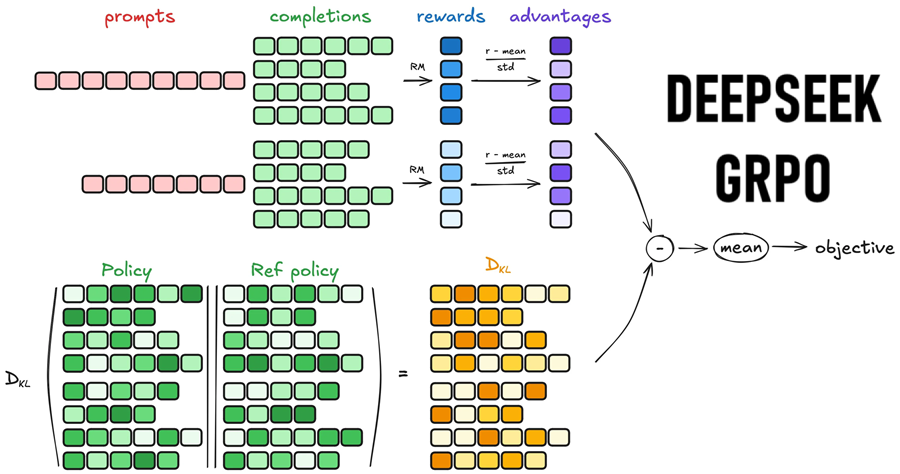
GRPO(组相对策略优化)是强化学习 (RL) 中使用的一种方法,通过比较不同的动作并使用一组观察结果进行小的受控更新来帮助模型更好地学习。
MODEL-ZOO
在这篇博文中,我们想使用群组相对策略优化 (GRPO) 和倒计时游戏重现 DeepSeek-R1 的小“顿悟时刻”。