
APPLICATION
基于GenAI的数据可视化
我们将学习如何迭代生成式AI提示来构建三个Plotly图表,然后将这些提示添加到PyCafe上的Vizro仪表板中,并添加一些交互控件。
APPLICATION
我们将学习如何迭代生成式AI提示来构建三个Plotly图表,然后将这些提示添加到PyCafe上的Vizro仪表板中,并添加一些交互控件。

APPLICATION
在本教程中,我们将构建一个车辆文档系统,从车辆图像中提取重要细节。这些细节将以结构化格式提取,以便进一步供下游使用。

APPLICATION
本文展示了如何通过结合ExtractThinker、Ollama、Docling或MarkItDown来构建完全本地的文档智能解决方案。

APPLICATION
在网络抓取过程中,通过集成 LLMs 可以在很大程度上优化流程。我们需要从网页获取 HTML 代码,并将其馈送到 LLM,LLM 从中提取出它所指的对象。

LIBRARY
本文介绍如何实用DSPy为自己的网站生成术语词汇表,这大大提高了工作效率。

LIBRARY
本文探讨 Google 的 Gemini 2.0 模型如何与 ExtractThinker结合使用,从而增强智能文档处理 (IDP)

APPLICATION
和大多数人一样,NotebookLM 及其从一组文档生成播客的能力让我大吃一惊。然后,我开始思考:“他们是如何做到这一点的,我在哪里可以获得这种魔力?”复制起来有多容易?
LIBRARY
PydanticAI是Pydantic作者推出的多代理开发框架,它利用Pydantic 验证静态和流式响应,确保可靠的数据处理,与 OpenAI、Gemini 和 Groq 模型兼容。
APPLICATION
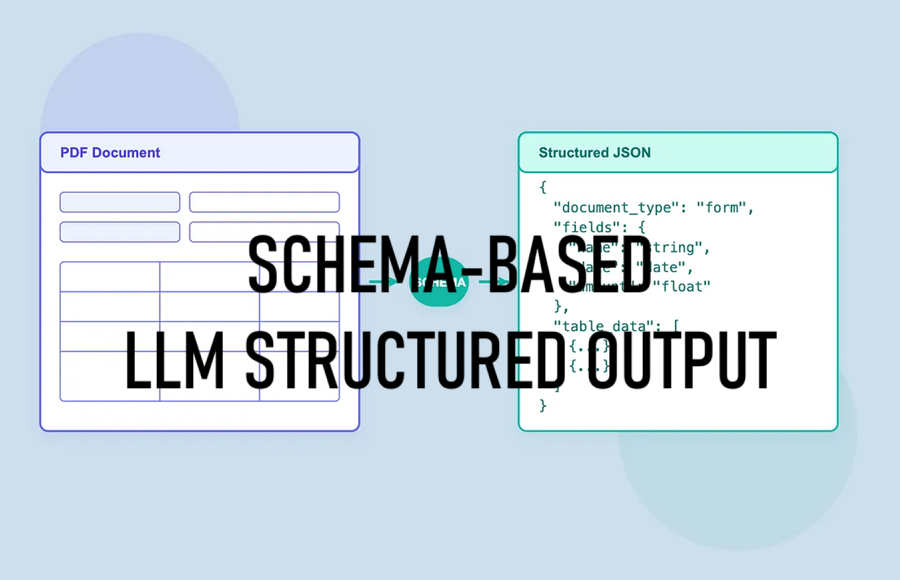
记者们通过文档转储和白皮书获得 PDF 作为对 FOIA 请求的回应。要使用 PDF,这些记者需要从文档中获取数据并将其转换为易于分析的格式,例如电子表格。该过程可能涉及费力的手动转录或将数据从一种格式复制并粘贴到另一种格式。 从理论上讲,大型语言模型可以协助文档处理,但幻觉等风险和 LLM 输出固有的不确定性使这种方法变得棘手。记者需要确保输出确实包含所需的数据、遵循所需的数据类型并采用可用的格式。 结构化输出为这些挑战提供了解决方案。像 Anthropic 和 OpenAI 这样的提供商以及像 Outlines 这样的开源库允许开发人员定义严格的模式,将 LLM 响应限制在特定字段、数据类型和格式。 结构化输出将原始的 LLM 功能转换为可靠的数据处理管道。例如,从多页 PDF 中提取表格时,模式可确保跨页面的列名和数据类型一致。虽然这种方法不能保证完全准确,但它降低了解析和验证 LLM 响应的工程复杂性,使文档处理工作流更加可靠和易于维护。 模式本质上是一个蓝图,它告诉模型要查找哪些信息以及如何组织这些信息。可以将其想象成一个标准化表格:记者不是让模型以任何格式返回数据,

LIBRARY
本文对比3使用 LLM 进行数据提取的开发库Instructor、Marvin 和 Guardrails的使用方法并通过对比介绍如何选择最适合你的库。