
MODEL-ZOO
10个最受欢迎的本地LLM
由于先进的量化和模型优化,你可以在笔记本电脑或台式机上运行强大的LLMs,即使你的RAM或VRAM不足8GB。
MODEL-ZOO
由于先进的量化和模型优化,你可以在笔记本电脑或台式机上运行强大的LLMs,即使你的RAM或VRAM不足8GB。

MODEL-ZOO
本文将检查一个手写数字数据集、对其进行标注,并使用它来创建一个专门用于提取手写文本的微调后的Qwen 2.5 VL。

APPLICATION
本文介绍如何使用Qwen-2.5-VL、vLLM和AWS Batch构建处理数百万份文档的文档解析管道。

MODEL-ZOO
我想看看这些LLM模型的进步程度,所以我让不同的AI模型构建一个简单的宝可梦游戏,结果令人惊讶。

APPLICATION
大型语言模型(LLMs)与医疗保健的交叉点带来了令人兴奋的机会,但也带来了独特的挑战。在本教程中,我们将探讨如何使用分组相对策略优化(GRPO)——一种最近由DeepSeek团队引入的有前途的新强化学习技术——来适应阿里巴巴的Qwen-3B模型以用于医学推理。 为什么这很重要: * 🏥 患者安全第一:医学AI中的幻觉可能是危险的。 * 💡 领域专业化:通用LLMs难以处理临床推理。 * ⚡ 效率:我们的3B参数模型可以在消费级GPU上运行。 推理模型如O3和DeepSeek R1在许多具有挑战性的基准测试中显示了前所未有的改进。它们改变了监督微调的趋势,转向实际的强化学习(RL)。我们在深度学习领域的许多突破都来自RL,例如AlphaGo,因为模型能够通过与不同的现实场景互动来学习,而这些场景在监督微调中往往难以提供示例。 如果你想了解更多关于推理模型或更多历史细节,我强烈推荐Maarten的文章[2]。DeepSeek工作的美妙之处在于他们实现了一个实用的框架,用于使用GRPO对LLM进行微调。根据Maarten的文章: 这个算法背后的直觉是,它使所有导致正确或错

TOOL
本文介绍如何利用本地开源LLM大模型免费使用Cursor AI编程工具。
TOOL
DeepSeek 的 R1 研究揭示了一个“顿悟时刻”,其中 R1-Zero 通过使用群组相对策略优化 (GRPO) 自主学习分配更多思考时间而无需人工反馈。你就可以使用 Unsloth和Qwen2.5 (1.5B) 在仅 7GB 的 VRAM 上重现 R1-Zero 的“顿悟时刻”。

MODEL-ZOO
我向这3个模型提供了一系列相同的提示,以测试它们从高级推理和编码能力到解决问题能力等各个方面。

APPLICATION
本文,介绍如何使用 HF的Code Agent和Qwen2.5–7B-Instruct 创建多代理 RAG 系统
MODEL-ZOO
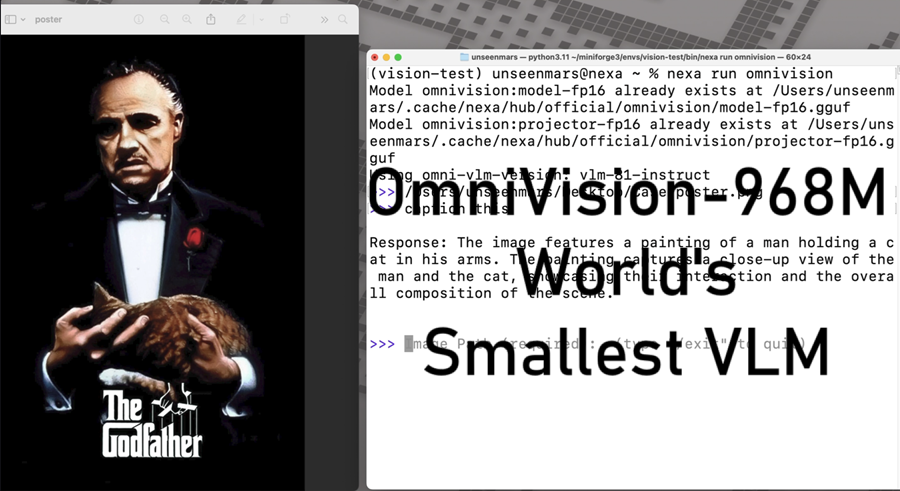
Omnivision 是一个紧凑的、不到1B (968M)参数 的多模态模型,用于处理视觉和文本输入,针对边缘设备进行了优化。