5个最受欢迎的开源数据科学工具
开源工具支持我们的AI辅助数据科学工作流
AI工具已成为当今许多数据科学家工作方式的一部分。我们可以使用ChatGPT、Claude、Gemini、Codex和其他AI工具来编写代码、分析数据、创建SQL查询或帮助我们理解结果。
然而,使用AI并不意味着我们只需要AI模型本身。
数据科学工作流中还有许多事情是AI工具无法单独处理好的。AI需要理解我们的数据,它所做的更改需要得到控制,我们还需要检查结果是否正确。
幸运的是,许多开源工具可以与AI一起工作来实现这些目的,我想探索它们,因为现在我们与AI助手和代理一起工作,它们变得更加有趣。
这些工具是什么?什么时候应该使用它们?让我们开始吧。
1、Microsoft Data Formulator
作为数据科学家,我们经常进行的一项活动是数据探索。
我们探索数据以了解分布、比较变量、查找异常观察并创建可视化。AI工具可以帮助这个过程,因为我们可以使用自然语言描述我们想要的内容。
Microsoft Data Formulator更进一步。
Data Formulator是微软研究院开发的开源AI驱动数据分析工具。该工具不完全依赖聊天界面,而是将自然语言交互与可视化数据探索相结合。
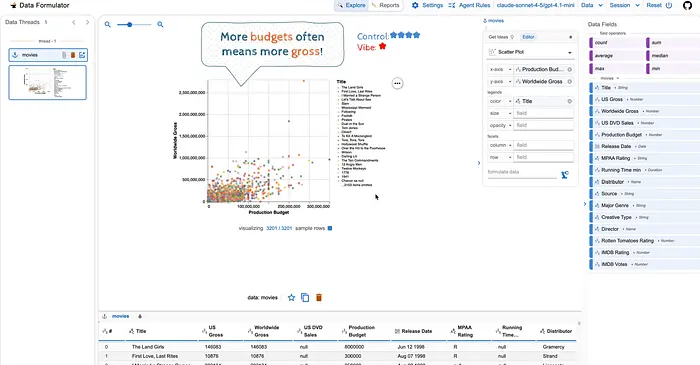
例如,假设我们有客户交易数据。
我们可以问:
显示每个客户细分市场的月度收入。
Data Formulator可以创建所需的转换和可视化。看到结果后,我们可以继续探索它、更改字段或提出另一个问题。对我来说,这就是Data Formulator变得有用的地方。
当我希望AI帮助进行探索性数据分析或可视化,但仍然想与结果交互而不是只接收AI生成的答案时,我会使用它。
然而,该工具仍在快速发展,我不会用它来替换我的生产分析管道。我更将其视为帮助我们更快探索数据的工具。
2、lakeFS
AI代理可以做的不仅仅是回答问题。
它们现在可以执行代码、修改文件、运行数据转换并执行多项任务,而无需我们手动运行每个步骤。
这提出了另一个问题:如果AI编辑了错误的数据怎么办?lakeFS在这种情况下会有所帮助。
lakeFS是一个开源数据版本控制工具,为数据湖提供类似Git的概念。我们可以创建分支、提交更改、合并它们并恢复到数据的先前版本。它在Apache 2.0许可证下可用。
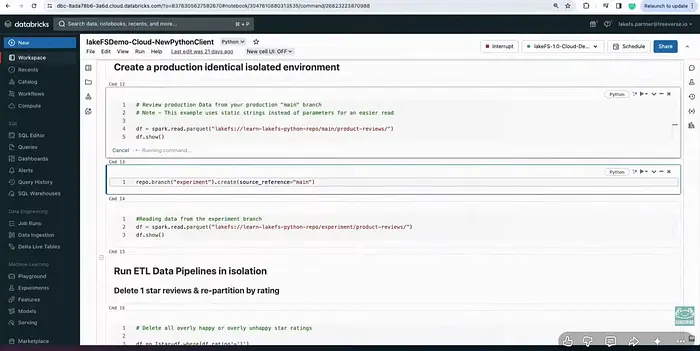
让我们举个例子。
假设我们希望AI代理清理数百万条客户记录。
通常,我们可以让代理直接在数据上运行转换。但是,如果生成的代码中有错误,原始数据也可能受到影响。
使用lakeFS,我们可以先创建另一个分支。
customer-data
main
|
+--- ai-cleaning-test
AI代理使用ai-cleaning-test,而主版本保持不变。
lakeFS使用零拷贝分支,因此创建分支不需要复制整个数据集。分支最初指向现有数据,只有更改的对象需要额外的存储。
此功能对正常数据工程已经很有用,AI代理使该用例变得更加重要。当前的lakeFS文档甚至描述了为每个AI代理提供隔离分支,以便在更改到达生产环境之前可以审查其工作。
当然,lakeFS并非每个项目都需要。如果我在本地分析几个CSV文件,我不会仅为版本控制添加另一个基础设施组件。
当数据存储在数据湖中且AI代理自动修改数据集时,我会考虑lakeFS。我们给予代理的自由度越大,拥有检查和逆转其更改的方法就越有用。
3、OpenMetadata
AI模型已经擅长生成SQL。
然而,生成有效的SQL和理解业务数据是两回事。
例如,假设我们的数据库包含以下表:
customer
customer_master
customer_profile
customer_profile_v2
AI应该使用哪个表?仅架构可能无法提供足够的信息。
可能还有AI不知道的业务定义。例如,名为active_customer的列可能意味着在过去30天内购买的客户,或者完全不同的含义。
OpenMetadata是一个开源元数据平台,收集有关组织数据的数据描述、所有权、沿袭、术语表、质量结果和其他上下文等信息。该项目使用Apache 2.0许可证。
OpenMetadata在AI时代有趣的地方在于其MCP服务器。MCP或模型上下文协议允许AI工具以标准化方式与外部系统交互。
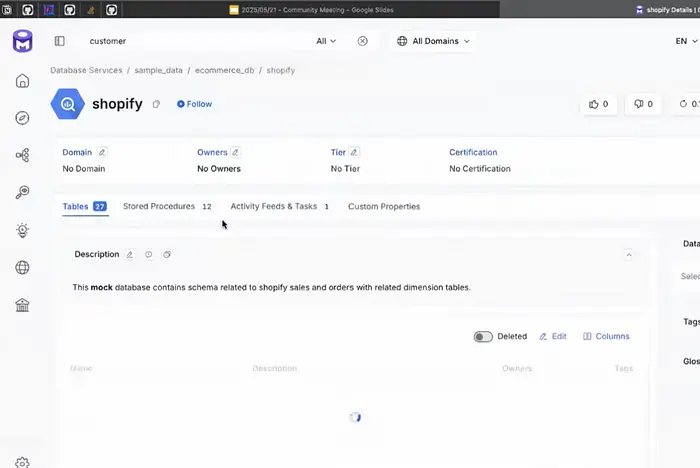
OpenMetadata可以通过MCP公开其元数据,以便Claude或其他兼容客户端等AI助手可以直接搜索组织的数据上下文。
例如,与其期望AI猜测哪个客户表是正确的,我们可以问:
哪个表包含当前的客户信息?
AI助手可以搜索OpenMetadata并检索可用数据。对我来说,这解决了公司开始将AI与内部数据连接时最大的问题之一。模型可能非常了解SQL,但它不会自动了解我们的公司。
仍然存在一个限制。OpenMetadata只有在元数据本身被维护时才有用。如果没有人编写表描述或保持业务术语表更新,AI将收到不完整的信息。
当公司有许多数据源,并且我们希望AI助手理解的内容不仅仅是原始数据库架构时,我会使用OpenMetadata。对于有几个明显表的小项目,它可能是不必要的。
4、WrenAI
OpenMetadata帮助AI助手查找有关数据的信息。
WrenAI专门专注于帮助AI代理理解业务数据以进行SQL和分析生成。
WrenAI是AI代理的开源上下文层。它允许我们描述实体、关系、计算和其他并不总是从数据库架构显而易见的业务信息。
让我们用一个简单的例子。假设我们有一个revenue列。
技术定义看起来很明显,但业务定义可能是:
Revenue =
已完成交易金额
减去退款
不含税
仅查看表架构的AI模型不一定知道这一点。
我们可以将所有这些信息包含在提示中,但当我们有数百个表和许多业务规则时,这变得很困难。
WrenAI将此类上下文存储在AI代理生成查询时可以使用的模型中。它可以包括关系、业务计算、指令、先前示例以及有关数据值的信息。
该项目还设计为与AI编码代理一起工作。其当前设置提供了可由Claude Code、Cursor、Codex等工具使用的技能。
对我来说,当我们构建文本到SQL或AI分析系统时,WrenAI变得有趣。文本到SQL的问题并不总是模型无法编写SQL。模型通常没有足够的信息来知道正确的SQL应该意味着什么。
当AI代理经常查询业务数据库且业务逻辑过于复杂无法在提示中反复解释时,我会使用WrenAI。如果我们只有几个简单的表,正常的架构上下文可能就足够了。
5、OpenLIT
最后一个工具与AI评估和监控相关。
当我们构建普通数据应用程序时,错误通常可能非常明显。应用程序崩溃;然而,AI应用程序是不同的。
应用程序可能成功运行并返回看起来完全合理的答案,但答案可能仍然是错误的。
OpenLIT是一个围绕OpenTelemetry构建的开源AI工程平台。它为AI系统提供可观测性、评估、提示管理、防护和监控。
例如,假设我们为公司文档构建一个RAG应用程序。用户问:
我有多少天年假?
应用程序返回15天。但为什么返回15天?
也许检索系统选择了过时的文档。也许提示导致模型忽略了正确的策略,或者模型本身生成了检索数据中没有的信息。
通过可观测性,我们可以检查最终答案之前发生的步骤。该项目不仅支持LLM跟踪。它包括评估、防护、提示管理,甚至GPU监控。
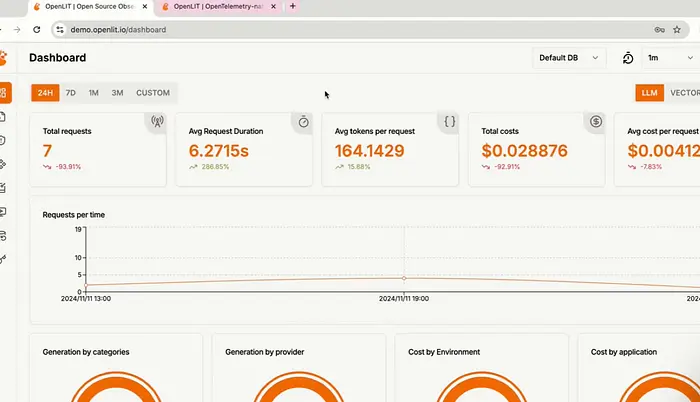
当AI应用程序开始变得难以调试时,我会使用OpenLIT。
一个只有一个模型调用的基础聊天机器人可能不需要这么多监控。但是,一旦我们添加检索、工具、代理或多个模型调用,知道每一步发生了什么就变得有用了。
限制是可观测性本身会创建更多的基础设施和数据需要管理。
我们还需要小心敏感信息,因为跟踪可能包含用户提示、检索的文档或模型响应。
6、结束语
AI工具正在改变我们作为数据科学家的工作方式,但我认为这并不意味着我们现有的数据问题会消失。AI仍然需要理解数据的含义。我们仍然需要控制它所做的更改并检查其输出是否正确。
在本文中,我们探索了其中五个:
- Microsoft Data Formulator用于AI辅助数据探索,
- lakeFS用于数据版本控制,
- OpenMetadata用于组织数据上下文,
- WrenAI用于业务感知的AI分析,
- OpenLIT用于AI可观测性。
希望它对你有帮助!
原文链接:5 Top Open-Source Data Science Tools for the AI Era
汇智网翻译整理,转载请标明出处
这是「RAG / 数据 / 文档智能」专题的一部分。完整地图见:RAG / 数据 / 文档智能完全指南