Transformers 现在能直接跑 llama.cpp 的 GGUF 量化模型了
本地推理最常用的 GGUF 量化格式,现在可以在 transformers 里直接加载了。Hugging Face 复用 llama.cpp 的 ggml Metal 内核并优化生成循环,在 MacBook Pro M2 Max 上把性能做到接近 llama.cpp——本文完整编译:三行加载代码、OpenAI 兼容服务、实测数字与当前限制。
一句话结论:GGUF 量化模型现在可以在 transformers 里高效运行了。 从 Hub 上挑一个 GGUF,用熟悉的 from_pretrained 加载,就能在自己的机器上生成——Hugging Face 通过复用 llama.cpp 的 ggml 内核并优化 generate 循环,把性能做到了接近 llama.cpp,目前优先支持 Apple Silicon 上的 Qwen3.5 架构。
本文完整编译自 Hugging Face 博客《Transformers now runs llama.cpp quants》(2026-09-22),并做中文整理。
一、GGUF 是什么,为什么本地推理离不开它
在本地跑模型这件事上,llama.cpp 是关键推手——Ollama、LM Studio、Jan 的推理引擎都是它。它和 MLX 一起,让本地推理成了普通用户日常可用的选项。
GGUF 是 llama.cpp 团队开发的格式,把一个模型所需的权重和元数据(包括 tokenizer 信息、可选的对话模板)打包在单个文件里,并支持不同的量化等级,用少量精度换更小的内存占用。以 Q4_K_M 这类变体为例:大部分张量用 4 bit,敏感张量保留更高精度。
量化对文件大小的影响(以 Unsloth 的 Qwen3.5-4B 为例):
| GGUF 变体 | 文件大小 | 取舍 |
|---|---|---|
BF16 |
8.42 GB | 未量化参照 |
Q6_K |
3.53 GB | 比小变体精度更高 |
Q5_K_M |
3.14 GB | 体积与精度之间 |
Q4_K_M |
2.74 GB | 本地推理的实用起点 |
官方的建议是:先从 Q4_K_M 开始,内存有余再上 Q5_K_M 或 Q6_K;更激进的量化能塞下更大的模型,但质量取舍取决于模型和任务——要在你真正要做的工作上评估。GGUF 在 Hub 上的下载量已达数百万次,ggml-org、Unsloth、LM Studio Community、bartowski 等都在持续发布各种量化版本。
二、在 transformers 里加载 GGUF
前置条件:
- 一台 Apple Silicon Mac;
- 一个被已发布的 ggml-quantization 内核构建支持的 PyTorch 版本(通常是最近两个 release);
- 最新版 transformers(当下需要 main 分支,直到下个 release)与兼容版本的
kernels。
pip install -U "git+https://github.com/huggingface/transformers.git" kernels
加载 GGUF 模型,只需给 from_pretrained 传入 Hub 的 model_id 和文件名 gguf_file:
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "unsloth/Qwen3.5-4B-GGUF"
filename = "Qwen3.5-4B-Q4_K_M.gguf"

tokenizer = AutoTokenizer.from_pretrained(model_id, gguf_file=filename)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    gguf_file=filename
)
不需要额外配置:当权重在 Metal 上保持打包状态时,transformers 会自动加载兼容的 ggml/Metal 层内核,并用 ggml-org/ggml-attn 作为注意力实现。如果这个内核拉不下来,模型会带警告回退到 "sdpa";也可以显式传 attn_implementation="sdpa" 强制回退。
之后的一切都是标准 transformers API:
messages = [{"role": "user", "content": "Explain why the sky is blue in a few sentences."}]
inputs = tokenizer.apply_chat_template(
    messages,
    tokenize=True,
    add_generation_prompt=True,
    return_dict=True,
    return_tensors="pt",
).to(model.device)

with torch.inference_mode():
    outputs = model.generate(**inputs, max_new_tokens=256)

print(tokenizer.decode(outputs[0], skip_special_tokens=True))
注意:如果没有兼容的量化内核,加载器会回退到反量化路径,内存占用会变高。
三、起一个 OpenAI 兼容服务,接到任何客户端
同一份 checkpoint 也可以用 transformers serve 起成 OpenAI 兼容 API:
pip install -U "transformers[serving] @ git+https://github.com/huggingface/transformers.git" kernels

transformers serve "unsloth/Qwen3.5-4B-GGUF:Qwen3.5-4B-Q4_K_M.gguf"
模型参数的写法是 <model_id>:<filename>.gguf——冒号前是 Hub 仓库,冒号后是要加载的文件,用于在一个仓库的多个量化版本中指定一个。
对话模板支持 thinking 的模型,可以加 --reasoning off 跳过、--reasoning on 启用;默认 --reasoning auto 跟随模板默认行为。
然后在客户端(如 Jan 或 Pi)里添加自定义 OpenAI 兼容提供方:
| 设置项 | 值 |
|---|---|
| Base URL | http://localhost:8000/v1 |
| Model ID | unsloth/Qwen3.5-4B-GGUF:Qwen3.5-4B-Q4_K_M.gguf |
transformers 在你的 Mac 上运行模型,客户端只提供对话界面。 任何支持该 API 的客户端都能接到同一个端点。
四、和 llama.cpp 比:几乎追平
参考基准是 llama.cpp 的 llama-bench(build 5f55650a7,release b10200,ggml 0.18.0 的 Metal 后端),命令为 llama-bench -m <file> -p 0 -n 128 -r 3,报告的是 tg128(解码 128 个 token 的生成速率,三次平均,不含 prompt 处理)。transformers 一列是同为 128 token 的 generate,从 12 token 的提示开始,三次热身后取最好成绩,包含 prefill。
测试环境:MacBook Pro M2 Max,32 GB 统一内存,macOS 26.6,PyTorch 2.12.1,kernels 0.17.0,插电状态。
| 模型(量化) | Transformers | llama.cpp |
|---|---|---|
Qwen3.5-4B Q4_K_M(2.74 GB) |
70.4 tok/s | 71.8 ± 0.4 tok/s |
Qwen3.8-27B UD-Q4_K_M(16.5 GB) |
15.9 tok/s | 13.4 ± 0.9 tok/s |
Qwen3.5-35B-A3B UD-IQ4_XS(16.3 GB) |
60.2 tok/s | 61.3 ± 0.5 tok/s |
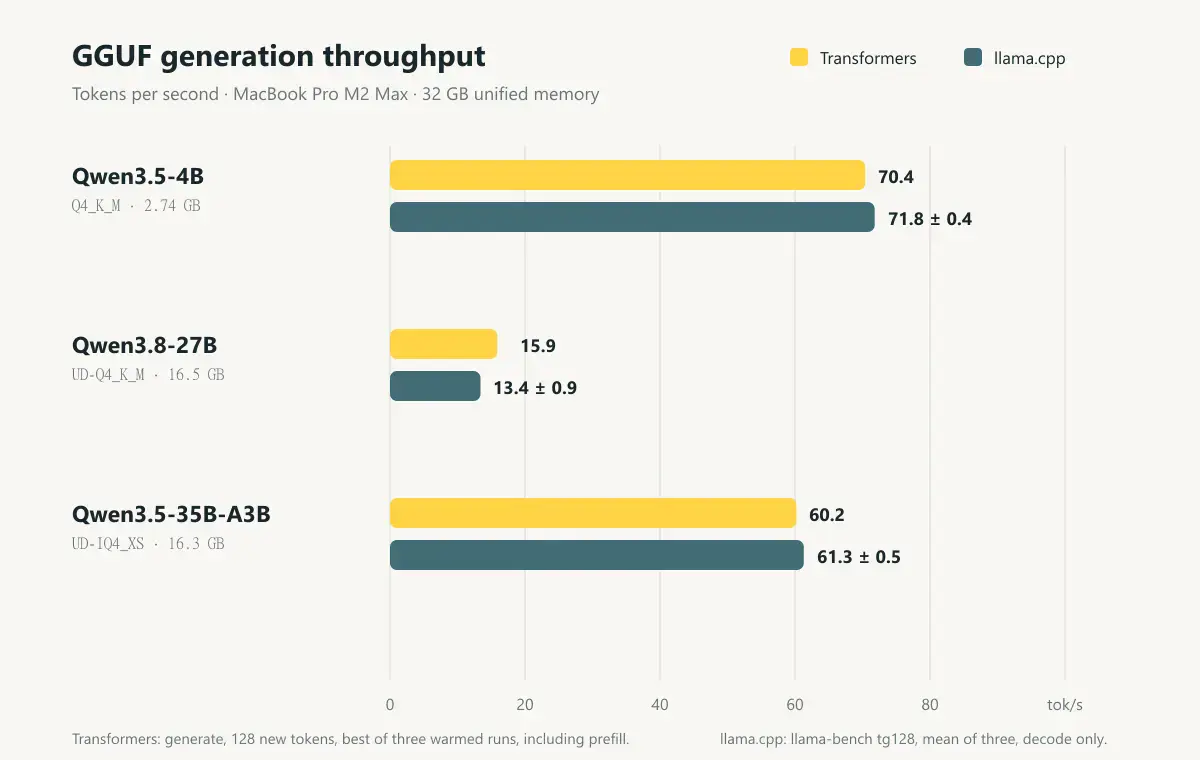
transformers 在三种 checkpoint 上都追得很近——4B 几乎打平,27B 因为包含 prefill 反而更快,MoE 的 35B 只差一个多百分点。官方也提醒:两者并非完全相同的基准条件(transformers 含 prefill,llama-bench 只算解码),所以不要把它当作严格的同条件对比。
但结论是清楚的:你可以在 Python/PyTorch 里直接跑 GGUF 量化模型,而不必切换运行时。
五、加速从哪来(一):复用 ggml 的 Metal 内核
内核(kernel)是在 GPU 上执行运算的小程序。PyTorch 给的是通用实现;专用内核可以少干活、合并多个运算,或者直接以存储格式读取量化权重。kernels 库让 ggml 的 Metal 内核可以发布在 Hub 上并从 transformers 调用——把 ggml 的成果带进 PyTorch 模型,而不是把模型换成一个独立推理运行时。
| 内核 | 作用 |
|---|---|
| ggml-quantization | 以打包的量化权重直接做矩阵运算,包括 MoE 模型中被选中的专家;避免每次解码前展开整个权重矩阵 |
| ggml-norm | 融合归一化运算,包括 Qwen3.5 / Qwen3.8 使用的 zero-centered RMSNorm |
| ggml-attn | 提供 ggml 的 Metal flash attention,用于 prompt 处理与 token 解码 |
| ggml-gated-delta-net | 加速 Qwen3.5 / Qwen3.8 混合架构线性注意力层的门控 delta 网络 |
| topk | MoE 中为每个 token 选择专家,融合 softmax 与 top-k 路由(transformers 自己的 Metal 实现) |
前四个基于 ggml 内核,第五个 top-k 解决 MoE 路由的另一个瓶颈。它们共同减少了每个生成 token 所需的 GPU 工作量。官方对比了"同样打包的 GGUF checkpoint,带与不带这些层内核"(两种配置都保持量化内核启用):
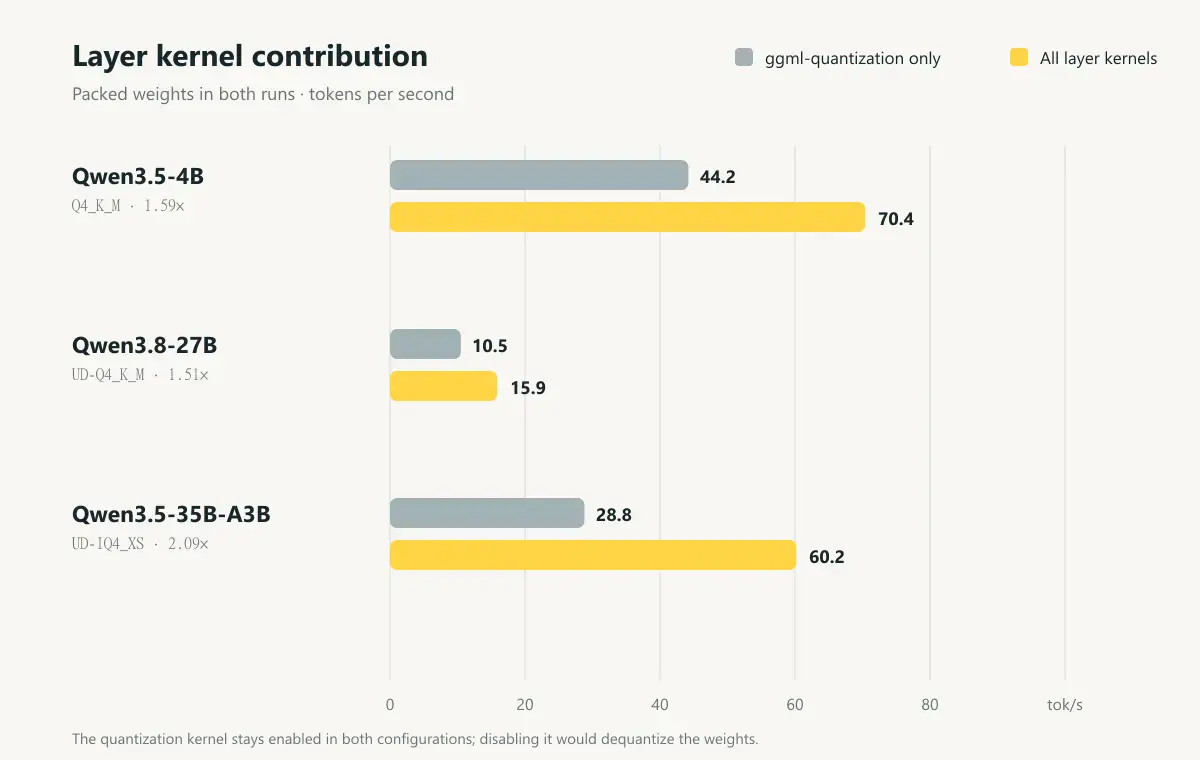
- Qwen3.5-4B:44.2 → 70.4 tok/s(1.59×)
- Qwen3.8-27B:10.5 → 15.9 tok/s(1.51×)
- Qwen3.5-35B-A3B:28.8 → 60.2 tok/s(2.09×)
MoE 模型的提升最大(2 倍以上)——这与"避免展开整个权重矩阵、只读被选中的专家"的设计直接相关。
六、加速从哪来(二):让 CPU 和 GPU 不互相等
内核再快,也得让 GPU 一直有活干。生成过程中,CPU 负责调度 GPU 操作、控制产出下一个 token 的循环;而把结果从 GPU 读回会迫使 CPU 等队列里的操作完成——哪怕每个 token 只等一点点,吞吐也会明显下降。
generate 里做了两处修改(对所有 transformers 模型都有收益,不只是 GGUF):
- 提前丢弃多余的注意力掩码(PR #48814):对没有 padding 的 decoder-only 输入,生成开始时就把全 1 的 padding mask 去掉,下游注意力代码不必反复检查能否跳过它;因果注意力仍然保留。
- 延迟停止判断(PR #47975):在支持的路径上,
generate异步复制停止决策、在下一步消费。CPU 可以在 GPU 运行时继续调度;流式输出采用同样做法,超出停止条件的多余一步会从结果中移除。
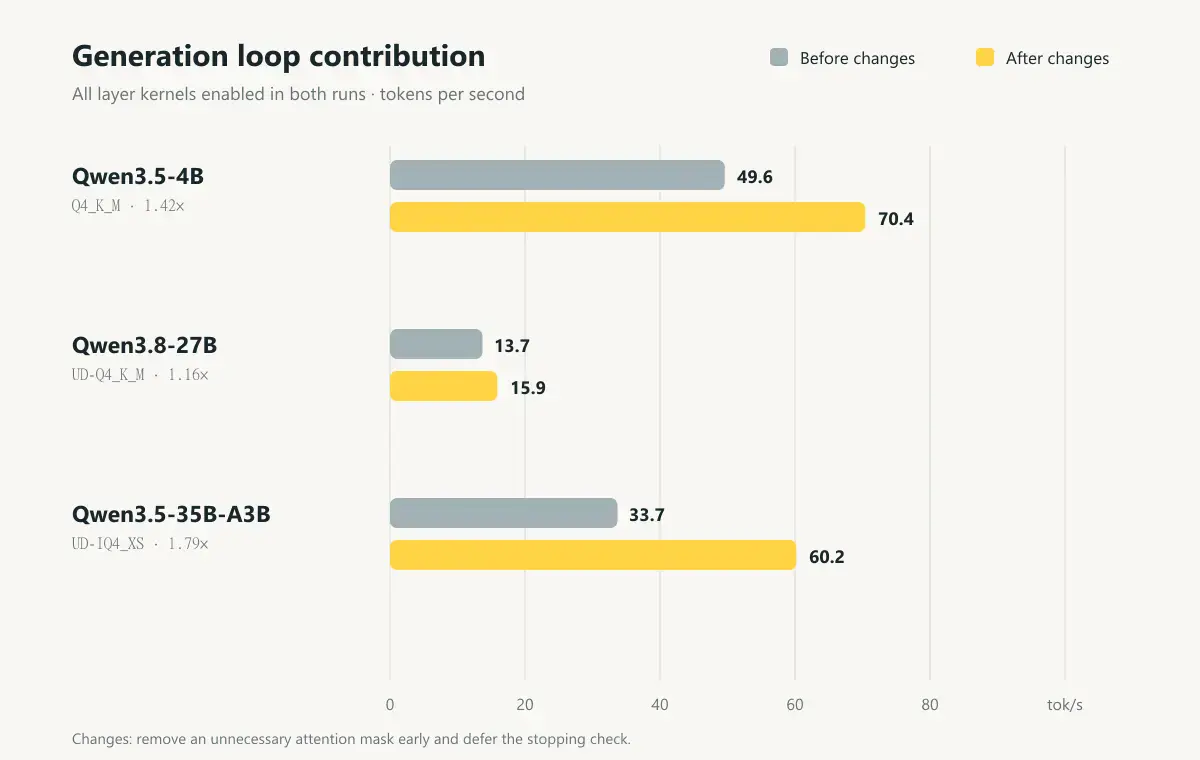
保持所有层内核启用,单独隔离生成循环的变化:
- Qwen3.5-4B:49.6 → 70.4 tok/s(1.42×)
- Qwen3.8-27B:13.7 → 15.9 tok/s(1.16×)
- Qwen3.5-35B-A3B:33.7 → 60.2 tok/s(1.79×)
内核减少单个运算的成本,更少的同步点让 CPU 调度与 GPU 执行重叠——两者互补。官方还特意强调:这些优化不需要 torch.compile,交互式使用没有编译停顿,输入形状变化也不会触发重编译。
七、GGUF 之外:把 ggml 内核带给更多模型
更大的机会在于:把 ggml 的性能带给 llama.cpp 不支持的模型。
transformers 已经有这些架构的 PyTorch 实现。有了 ggml 内核与 PyTorch 里的量化方案,就可以在不把整个模型移植进 llama.cpp 的前提下,先加速它们支持的那些运算——这对新架构、研究模型和可能永远不会有 llama.cpp 实现的定制变体尤其有用。
这条路径并不限于 GGUF 格式本身:内核操作的是张量,并不要求整个模型来自 GGUF 文件。同一套构建块可以整合进其他 transformers 模型和加载流程,也为计算机视觉、音频、多模态模型复用注意力、归一化、矩阵乘法内核铺了路。当然,每个架构仍需要集成与验证,目前的 GGUF 示例只覆盖文本生成。
八、当前限制与下一步
初始目标场景是 Apple Silicon 上的单轮交互式对话,边界需要说清楚:
- 打包推理路径目前仅限 MPS。通过反量化的 GGUF 导入是另一条独立路径——支持 GGUF 文件格式,不意味着所有设备都有打包内核;
- padding 与批处理仍需完善。无 padding 的输入能吃到掩码优化的红利;有 padding 的批次没有这个捷径,性能可能更低。官方计划把工作扩展到 MPS 上的
generate_batch; - 架构覆盖有限。打包加载器目前覆盖 Qwen3.5 的 dense 与 MoE 架构(含兼容的 Qwen3.8 checkpoint),新增架构支持"相对直接",会逐步扩大。
想让某个 GGUF 模型在 transformers 里可用,可以带上 checkpoint 和用例去 transformers 仓库提 issue,帮助官方排优先级。
想了解 GGUF 文件名里的量化标记怎么读,可以看本站的 GGUF 文件名解析;量化对精度的影响见 拯救量化 LLM 的准确性。
参考来源
- Hugging Face Blog:《Transformers now runs llama.cpp quants》(2026-09-22)https://huggingface.co/blog/transformers-llama-cpp-quants
- 文章源码(GitHub):https://github.com/huggingface/blog/blob/main/transformers-llama-cpp-quants.md
- GGUF 量化类型文档:https://huggingface.co/docs/hub/gguf#quantization-types
延伸阅读(本站)
本文由汇智网编译整理,转载请注明出处。