17 个最新的 AI 突破(202607)
从前沿模型、机器人技术、生成式 AI 工具到使用零 Nvidia 芯片训练的模型
一个 1.6 万亿参数的语言模型今年在大约 50,000 个中国制造的加速器上完成了预训练,整个过程中没有任何 Nvidia 硅片。权重在 Hugging Face 上以 MIT 许可证发布。仅 FP8 构建就超过两太字节,因此几乎没有人会在自己的机器上加载它。
过去几个月还带来了机器人技术、计算机视觉、视频生成和 AI 效率方面的进步。
以下是 17 个值得了解的发布。
1. MuSViT:像 BERT 阅读文本一样阅读乐谱
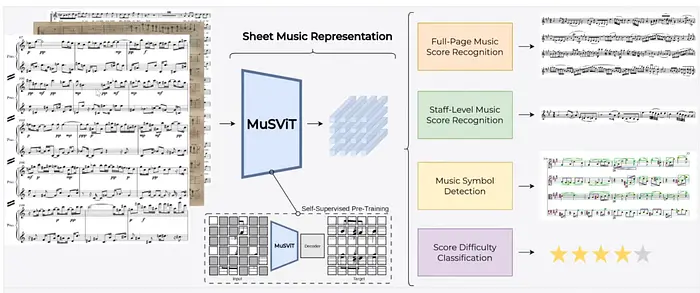
乐谱是音乐家阅读的印刷符号:五线谱、符头、谱号和休止符通过页面上的位置编码音高和时值。通用视觉模型处理得不好,因为它是密集的符号布局,而不是照片。
MuSViT 来自阿利坎特大学,是一个视觉 Transformer,使用掩码自编码器在 IMSLP 的 970 万页乐谱上进行预训练。补丁被隐藏,模型重建它们,这迫使它推断哪个符号属于哪个位置。
在使用冻结编码器进行整页识别时,它报告了 16.4% 的符号错误率,而 PaliGemma 2 为 48.6%。它以 85M 和 25M 参数版本发布,只需要 transformers 库。
光学音乐识别已经是一个学术领域三十年了;这是它的第一个可信的共享骨干,也是支持以下论点的一个数据点:狭窄的符号领域需要一个小的专用编码器,而不是更大的通用编码器。
2. LongCat-2.0:没用 Nvidia 硬件训练
SWE-bench Pro 分数比较(越高越好)
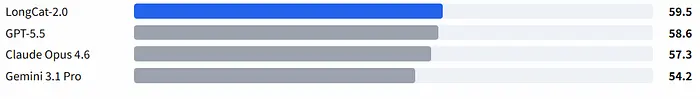
中国外卖公司美团运行了一个名为 Owl Alpha 的匿名模型,两个月来一直处于 OpenRouter 的顶部,然后在 6 月 30 日确认它是 LongCat-2.0:一个 1.6T 混合专家模型,每个令牌激活约 48B 参数,具有一百万个令牌上下文。
美团表示,该运行没有回滚,也没有不可恢复的损失峰值,这比听起来更重要,因为非 Nvidia 堆栈通常工具更少,故障更混乱。
根据其自身数字,它在 SWE-bench Pro 上得分为 59.5,刚刚超过 GPT-5.5 的 58.6,但落后于 Claude Opus 参考的 69.2。供应商报告,一个基准,亚点边际。
无论如何,许可证比分数更重要。在 MIT 条款下的万亿参数模型,训练于出口管制制度之外的硬件,施加了不同于另一个封闭 API 的压力。
3. LiveEdit:在播放时编辑视频
大多数扩散视频编辑一次处理一个片段。LiveEdit 以因果方式分块处理视频,报告 每秒 12.66 帧,每帧 79 毫秒,大约是广播速度的一半。
它处理服装更换、天气变化和对象移除,同时保持未触及区域静止,这是更难的一半。
两件事完成了工作:
- 一个蒸馏管道,将双向模型压缩为因果四步模型
- 一个缓存,重用静态背景的注意力特征
代码已发布,尽管速度数字没有附带硬件规格。目标是增强现实和直播,帧逐个到达,没有未来的镜头可以前瞻。
4. ViDiHand:追踪相机看不到的手
来自第一人称视频的手部追踪在遮挡下会中断,这在大多数情况下都会发生,因为手一生都隐藏在物体和彼此后面。
ViDiHand 借用了预训练视频扩散模型的内部结构,其逻辑是任何在互联网规模上训练以合成连贯视频的东西都已经知道手如何移动以及当它们消失时会发生什么。在已发布的比较中,大多数基线仅恢复可见的手或将隐藏的手放在错误的深度。ViDiHand 保留了两者。
这对人形机器人训练很重要,数据来自观察人类,有趣的时刻正是被遮挡的时刻。这是这里四个围绕同一瓶颈的项目之一:机器人学习需要比任何人手工收集的更多的操作数据。
5. Agents-A1 远超其规模
由 InternScience 以 Apache 2.0 发布,Agents-A1 是一个 35B 混合专家模型,每个令牌约有 3B 参数激活,256K 上下文。
它报告 Seal-0 上 56.4,BrowseComp 上 75.5,GAIA 上 96.0,与 GPT-5.5、DeepSeek-V4-pro 和 Kimi K2.6 竞争,但规模只有一小部分。量化构建约 20GB,将一个能够使用工具的代理放在一个消费级显卡上。
它在搜索、科学和指令遵循方面获胜,而不是编码。在 SciCode 上,它落后于 Kimi K2.6 和 GPT-5.5。该团队将这项工作描述为扩展视野而不是参数,这是许多开放模型努力已经转移的方向。
6. OmniContact:将人形任务链接在一起
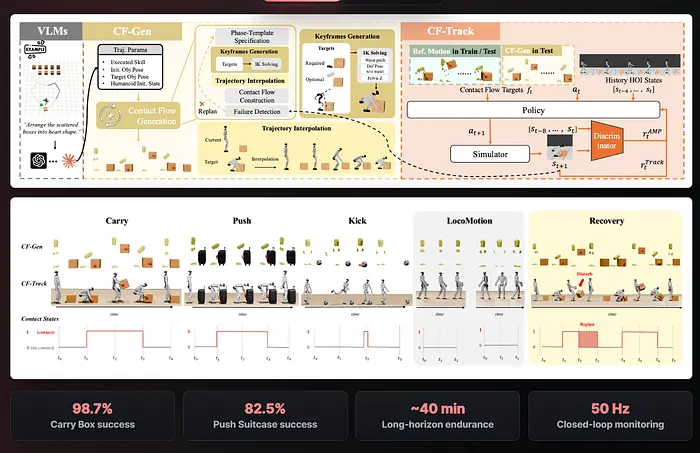
单个机器人技能现在大多可以工作。
将它们串联起来则不行,因为接缝是事情破裂的地方。如果箱子在搬运过程中移动,下一个技能就不知道。
OmniContact 提出接触流作为接口:关键身体轨迹加上二进制接触信号的时间序列,记录谁在什么时候接触了什么。规划器生成流,强化学习策略将其跟踪到运动中。
由于表示是稀疏的,重新规划实时发生,技能无需密集的逐帧参考即可组合。报告的链接成功率为 66.5%,代码和数据集已发布。
7. PhysiFormer:预测物体如何变形
视频世界模型从像素学习物理,这意味着它们学习相机的物理视图,并以难以诊断的方式错误地获取几何。
PhysiFormer 跳过像素。
它是一个扩散 Transformer,在给定起始位置、速度和材料是刚性还是弹性的情况下,直接在世界坐标中预测未来的网格顶点位置。
在超过 100,000 条模拟轨迹上训练,它泛化到未见过的形状和比训练中看到的更多物体,并且在弹性体上运行速度比传统模拟器快五倍。
熟悉的限制适用:模拟训练不会免费承受真实摩擦。
8. Nvidia ASPIRE:让机器人保留他们学到的东西
大多数机器人编码代理会丢弃每个修复。解决一个任务,丢弃修复,从头开始下一个任务。
ASPIRE 闭合了这个循环。
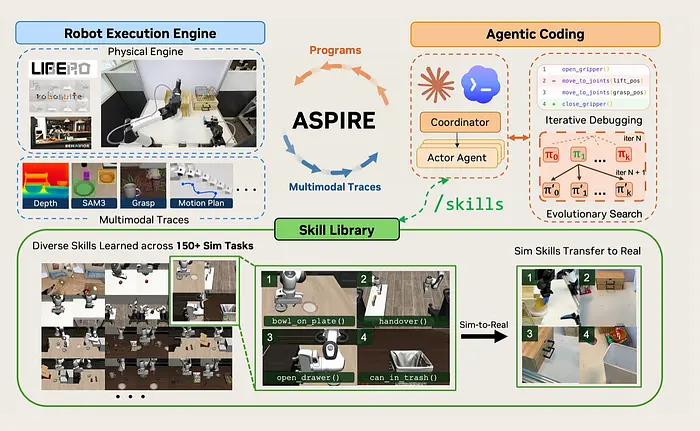
ASPIRE 在开放式学习循环中运行,有三个关键组件:闭环机器人执行引擎、不断扩展的技能库和进化搜索过程。
编码代理编写控制程序,运行它们,读取每步跟踪以找到哪个原始操作失败,修补它,然后将修复文件保存在带有失败签名和应用规则的文本技能库中。进化搜索同时运行多个候选,因此不会陷入完善一个损坏的想法。
在 Robosuite 中的双臂交接任务中,仅通过调试,成功率从 20% 提高到 92%,没有新的训练数据。Nvidia 的 Jim Fan 将这一转变描述为训练产生不断增长的技能库,而不是更新的权重。
作者坦率地表示,该循环每个任务消耗大量模型调用,因此扩展它需要比现有更便宜的推理。
9. Google 的廉价图像和视频模型
Nano Banana 2 Lite 在大约四秒内生成一张图像,而完整的 Nano Banana 2 大约需要二十秒。价格约为 每 1024x1024 图像 0.0336 美元,通过批处理 API 减半。
Gemini Omni Flash 与它并行处理视频,通过对话而不是重新提示从文本、图像、音频和视频输入生成和编辑,大约 每秒输出 0.10 美元。
两者都可以通过 Google Flow 免费试用,有每日限额。
10. UBTech 以 146,000 美元出售人形伴侣
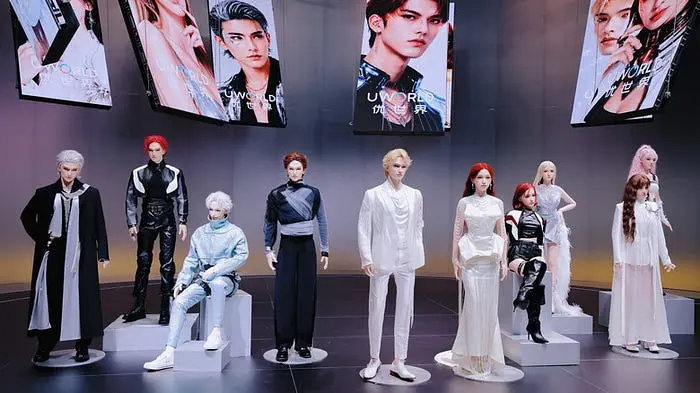
6 月 30 日在深圳,UBTech 推出了 U1 系列。价格从头和躯干单元的 119,800 元人民币(约 17,700 美元)到全尺寸型号的 990,000 元人民币(约 146,000 美元)不等。订单已超过 13,361。
宣传是情感性的而不是功能性的。UBTech 表示其情感语言模型可以识别超过二十种人类情绪,准确率超过 90%,这是一个没有公布测试条件的公司数据。机器人有 88 个自由度,明确没有家务能力。
发布现场的记者指出,行走看起来很机械,设备与早期渲染不同。UBTech 从未盈利,其股价在发布后下跌而不是上涨。
这是与 LongCat-2.0 相同的国内推动的消费端,市场对这一半明显不太信服。
11. Comfy MCP 让代理驱动 ComfyUI
ComfyUI 是大多数人用来运行本地图像和视频模型的基于节点的界面。它功能强大,确实令人望而生畏:你连接图,管理自定义节点,下载检查点,通常拥有一块 GPU。
Comfy MCP 自 6 月 29 日公开测试以来,消除了这个入门障碍。连接 Claude、Codex、Cursor 或其他兼容代理并描述你想要的内容。它搜索模型、节点和模板,选择工作流程,填充输入并在云 GPU 上运行。
它针对 Comfy Cloud 而不是本地安装运行,社区 MCP 服务器几个月来一直在做这个的版本。官方版本添加的是托管 GPU 和维护的目录,这是开放项目吸收其用户首先构建的内容的常见形式。测试期间免费,行为将会改变。
12. Meta 的脑到文本系统不需要手术
Brain2Qwerty v2 于 6 月 29 日发布,在人们打字时从 脑磁图解码输入的句子。
无植入物,无手术。
它报告 61% 的平均单词准确率,最佳参与者为 78%,而先前的非侵入性方法约为 8%,来自 9 名志愿者,每人记录 10 小时。
研究人员从每个人那里收集的训练数据越多,系统就变得越好。
缺点是硬件。
该系统不适用于你可以戴在家中的小耳机。研究人员只在健康人身上测试了该系统。他们没有在因疾病或 injury 而无法说话的人身上测试它。因此我们还不知道它对最受益的人效果如何。
脑植入物(手术放置在大脑内的设备)已经比这个新系统准确得多。它们已经好几年了。
那么为什么如果植入物效果更好,还要使用这个新系统呢?
因为这个系统是非侵入性的。
13. RDM 在单步中生成图像
标准扩散需要 30 到 50 个去噪步骤。
Turbo 变体将其减少到四个或十个。表示分布匹配在一个前向传播中生成图像。
其思想是直接追求目标:在冻结的编码器内匹配生成图像与真实图像的特征分布,没有教师、没有对手、没有要模拟的轨迹。任何单个编码器都可以被操纵以在明显虚假的图像上获得高分,因此该方法针对十四个编码器进行匹配。
它在 ImageNet 上设置了一步最先进水平,并将四步 FLUX.2 klein 转换为单步生成器。你仍然用细节换取速度。它属于与下面的 MrFlow 相同的转变,收益来自重构推理而不是更大的模型。
14. MrFlow 加速你已有的模型
MrFlow 不需要训练,也不需要特定于模型的更改。它在低分辨率下生成结构,使用轻量级 GAN 在像素空间中上采样,注入一点噪声,然后进行一次高分辨率细化过程。
在 Qwen-Image 上,延迟从原生 50 步推理的 49.32 秒下降到 4.77 秒,基准质量在未加速输出的 1% 以内。结合蒸馏权重,加速超过 25 倍。
早期的多分辨率技巧在潜在空间中上采样并产生可见的模糊;将该步骤移动到像素空间是修复它的大部分原因。ComfyUI 插件随存储库一起发布,这就是为什么它在几天内就在本地生成社区中传播,而类似的论文却被闲置。
15. SimFoundry 将视频转换为训练环境
手动构建模拟环境是机器人学习中安静的瓶颈。必须有人建模每个对象,调整每个参数,并检查没有任何东西漂浮。
SimFoundry 来自 Nvidia 的 GEAR 实验室,接收单个图像或视频并生成模拟就绪场景,然后生成作者所说的数字表亲:对象、布局和任务的变体,保持场景提供的内容同时改变具体细节。
以这种方式训练的策略转移到真实的多步和双臂任务,变体将模拟到真实成功率提高多达 50 个百分点。只有论文发布。
与下面的 CHORD 一起,Nvidia 赌的是超越数据瓶颈的方法是制造训练环境而不是收集它们。
16. CHORD 教手力量,而不是姿势
将人类手部姿势复制到机器人手上大多失败,因为两者有不同的手指长度、关节限制和驱动。姿势转移了;抓握没有。
CHORD 通过每个对手物体施加的力和扭矩来表示人类和机器人运动,然后在该空间中进行比较。由于表示是关于物体而不是手,它在手部设计变化时仍然有效。
在新的 4,739 个任务基准中的 1,831 个任务中,平均成功率为 82.12%。代码将作为 Nvidia 视频到数据管道的一部分发布。两者都假设演示已经存在于某个视频中,这也是为什么 ViDiHand 的遮挡工作比最初看起来更重要的原因。
17. Luna 无需骨骼即可动画化头像
逼真的 3D 头像一直依赖于线性混合蒙皮和参数化身体模型,这首先需要将身体拟合到人。拟合误差然后传播到每帧的抖动和伪影中。
Luna 由 Meta 开发,抛弃了骨骼。四张未摆姿势的图像重建一组规范的 3D 高斯,Transformer 将 2D 驱动信号直接映射到这些高斯的变形中。
视频、关键点或线条艺术草图都可以作为信号,模型将全局刚性运动与局部非刚性细节分离,使布料和软组织表现可信。有一篇论文,没有代码,没有模型。Meta 发布头像研究的速度比发布它快,即使按照这个标准,这也为时过早。
这一切指向什么
总而言之,这些发布展示了 AI 的发展方向。进步不再仅由更大的语言模型定义。机器人技术、计算机视觉、推理效率、模拟和多模态系统都在同时进步,通常以比另一个基准点更重要的方式进行。
其中一些项目今天就可以使用,而其他项目仅以论文或早期研究的形式存在。无论哪种方式,它们都值得关注,因为它们暗示了行业正在投资的时间——以及下一波实用 AI 可能来自哪里。
原文链接:17 Recent AI Breakthroughs Everyone Should Know About
汇智网翻译整理,转载请标明出处