Agent 记忆:写了 413 个文件的输给了写 9 个的
同一只 Pokémon:一个模型写 413 个记忆文件拿 1 枚徽章,另一个写 9 个拿 4 枚。Anthropic 把记忆拆成笔记、做梦、wiki 三层。
齐克果写过:生活只能倒着理解,却必须正着过。给 AI 智能体设计记忆时,我们遇到的是同一个困境。
人一生都在持续编码记忆。海马体在其中扮演核心角色:它把当下的经历抓下来,记忆因此成形得快、也立刻可用。但只有一部分经历会被巩固成长期知识。这种巩固大多发生在大脑"离线"的时候——睡眠中、安静休息时,海马体会把近期经历重放一遍,逐渐把它们提炼、整合进新皮层,也就是我们说的"知识"大部分存放的地方。
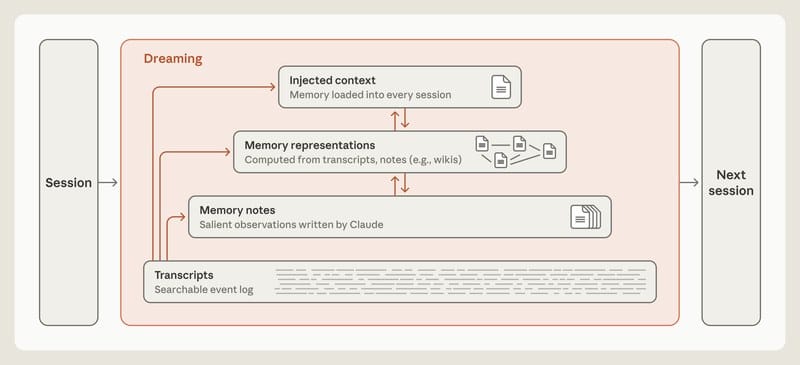
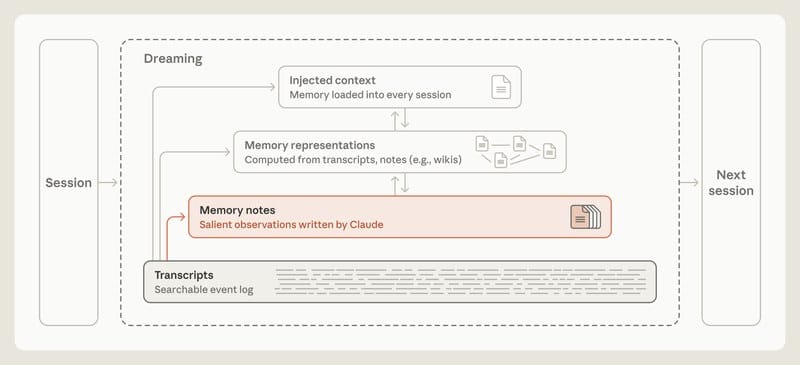
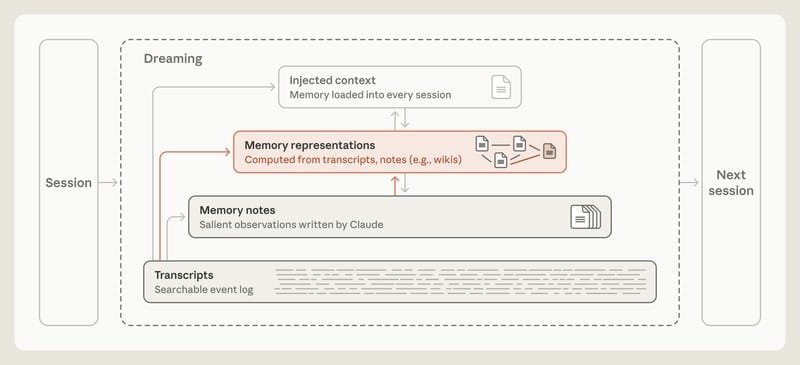
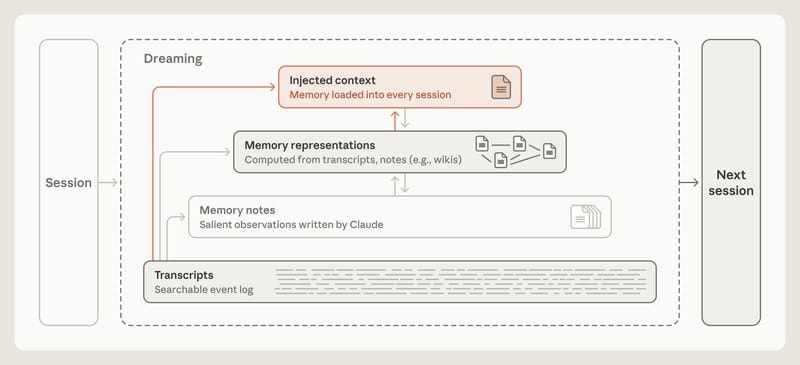
智能体的记忆可以采用类似的分工。智能体把大部分工作留在日志或会话记录里。Letta 与 UC Berkeley 的研究者提出「睡眠时间计算」(sleep-time compute):让模型在两次交互之间的空闲时间重新整理已有的上下文。同一个思路可以用来让智能体通过反思日志来整理记忆——修正错误,或产出新的笔记与表示。这个过程常被称为「做梦」(dreaming,图 1)。
我们发现,「做梦」在帮 Claude 获得有效记忆这件事上很有用。本文分享我们如何理解智能体记忆,并走一遍我们用来探索记忆的几组评测,包括做梦的用法,以及每个部件对记忆组织贡献了什么。
一、记忆笔记
所谓"智能体记忆",我们指的是 Claude 从经历中获得的知识——包括与用户的交互和它被指派的任务——并在会话之间保留下来,存成之后可以读取的上下文。它不包括模型学习或管理上下文的其他方式,例如改动权重(训练时设定的内部参数)、上下文内学习(in-context learning,单次对话内获得的知识)、以及压缩(compaction,由 Claude 写出摘要替换较早的轮次,好在新的上下文窗口里继续工作)。
在人脑里,一段经历之前、之中或之后释放的化学信号会给这段记忆"打标",表示它重要。打过标的记忆在离线期被重放的频率高于没打标的。这个过程叫重放(replay),帮助它们稳定下来、整合进长期记忆。
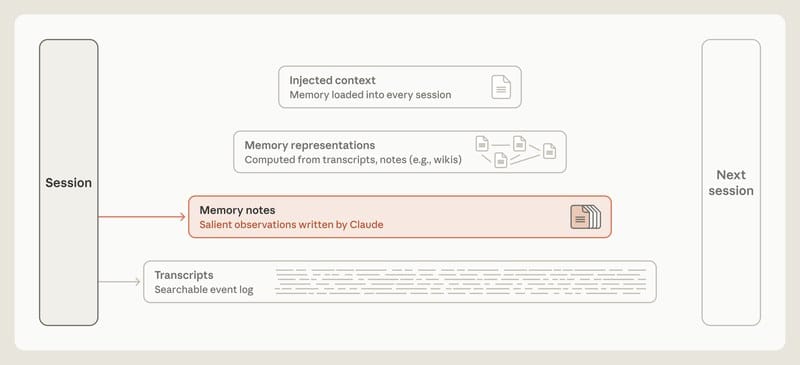
类似地,Claude 可以在会话日志里,把显著的事件在发生时就标记出来,方便以后找到;也可以把它们写进记忆存储,比如一个装着记忆笔记的文件夹(图 2)。但问题是:在还不知道接下来会发生什么的时候,Claude 怎么判断此刻什么算显著?
二、记忆可以是对未来需求的预测
记忆有时是一种预测。写下一条规则,等于智能体在预测它描述的这个模式以后还会出现。比如写下一条已验证的事实,是在预测未来某次会话里的智能体愿意直接依赖这条事实,而不必再核一遍。随着时间推移,Claude 做这类预测的能力好了很多。
拿 Continual Learning Bench (CL-Bench) 1.0 里的一个任务来说。这个基准测的是智能体利用记忆处理长跨度任务的能力。有一个具体任务是:让 Claude 通过在数据库里查资料,回答一连串问题。Claude 给出答案后,会被告知正确解,并且可以写一条记忆帮助回答后面的问题。
记忆在这里可以支撑一个学习闭环:答错了,可以把失败记下来,提出关于哪里错了的猜想,去验证这些猜想,再把发现变成以后答题的规则。
我们用 Claude Managed Agents 跑了 CL-Bench 1.0 的这个任务。每个问题 Claude 都在全新会话里开始,只有一个例外:它可以从一个跨会话保留的记忆目录里读取文件。
不同模型建立自己学习闭环的程度不同。Claude Sonnet 4.6 做到了生成"为什么答错"的猜想,它的记忆目录里散着一堆文件,每个列着几条没被验证的猜测。
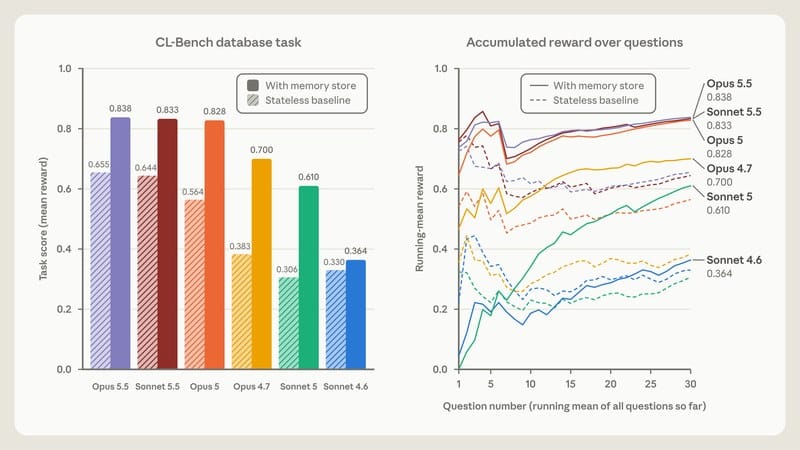
Claude Opus 4.7 把笔记合并成一份参考文档,并开始标注哪些事实已核对、哪些还没确认。Claude Sonnet 5 在评分器核对过答案之后,才把每个答案标为已确认;答错时写一条更正。
Claude Opus 5 是这几个模型里第一个把闭环合上的。它的大部分条目都含一条规则(以及它怎么知道这条规则成立)、对先前问题的回答,以及对沿途发现的陷阱的明确警告(图 3)。
和 Opus 5 一样,Claude Opus 5.5 与 Claude Sonnet 5.5 也都合上了闭环,用记忆把"以后怎么答题最好"的规则沉淀下来。带上记忆,这两者的得分和 Opus 5 大致相当,尽管它们无记忆时的基线略高。
三、Claude 学会了判断什么值得记
我们还评测了 Claude 玩《宝可梦 红》的能力——这个游戏要求它在复杂的长跨度任务里摸路,正好用来测它对"什么该写进记忆"的判断。每轮开始时,我们给每个模型一个记忆文件夹,它可以边玩边读写(图 4)。
我们比较了 Claude Sonnet 3.7 与 Claude Fable 5 各一轮、都在游戏进行到大约 10,000 步时的记忆文件夹。最关键的差别是:它们认为什么值得记。
Sonnet 3.7 假设什么都可能有用,不加区分地写。它的记忆文件夹是一份遭遇档案,往往为每一场战斗、每一件捡到的物品、每一个遇到的 NPC 各开一个文件。最终 Sonnet 3.7 写了 413 个记忆文件、放在 225 个文件夹里,拿到 1 枚徽章(徽章标记玩家在游戏里的进度)。
作为对比,Fable 5 写了 9 个文件、2 个文件夹,外加一个顶层文件 global.md,拿到 4 枚徽章。
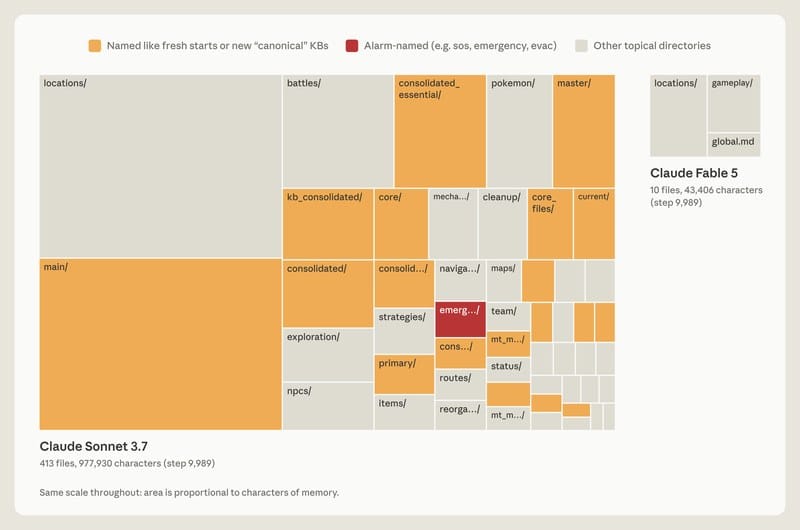
Sonnet 3.7 的做法之所以成问题,主要因为宝可梦的游戏状态一直在变——它那份详尽记录持续过期。结果是,随着进度推进,Claude 不得不花越来越多的时间和资源在记忆里翻找,而不是玩游戏。比如到第 10,000 步前后,Sonnet 3.7 开始建第四个"master"记忆文件夹;接下来 17 步里,它新建 6 个文件、删掉 9 个,游戏里一个动作都没做。
Fable 5 的做法是把记忆用在游戏没有明确告诉它的事情上。Sonnet 3.7 写进记忆的那类信息——玩家有多少钱、玩家在地图哪个位置——屏幕上每一回合都能读出来,存下来是冗余的。反过来,关于策略、计划和验证过的规则的那些记忆文件,只有 Claude 主动想出来才存在,也只有它写下来才不会消失。
Fable 5 就是按这个道理组织记忆的。它的 global.md 相当于一块仪表盘,放着当前目标、一份预先写好的打道馆(拿徽章的地方)计划,以及它自己定的记忆使用规则。一个 locations 文件夹放具体路线的行走计划,一个 gameplay 文件夹放基于"这游戏怎么运作"的策略。比如连续 7 个精灵球都没抓到鲤鱼王(最好抓的宝可梦之一)之后,Claude 写下:
如果连续 3 个以上球失败,就改变节奏(在菜单步骤之间插入额外的"等待"按键)——这样做之后立刻就抓到了。
记忆文件夹小得多,Fable 5 在游戏里走得远得多。Opus 5.5 用了类似做法:只维持一个小文件夹的记忆笔记,跟踪当前目标和下一步,边玩边重写,最后通关。
四、怎么引导 Claude 写记忆
我们发现,告诉 Claude 记忆是干什么用的有帮助,但不要告诉它怎么用。在 CL-Bench 上,我们只是告诉 Claude"有一个记忆文件夹可用"。这点泛泛的提示就足够 Opus 4.7 和 Opus 5 有效使用记忆,两者都有明显的性能提升(图 3)。
我们也试过给模型具体的规则,规定它们该往记忆里写什么,一次测一条规则。我们比较了每条规则下"有记忆带来的增益"与"没有这条规则时的增益"。当我们把规则设成「只记录失败」时,Opus 5 和 Opus 4.7 都丢掉了记忆带来的大部分提升(图 5 右)。对更强的模型来说,给它们判断显著性的自由,比提前给定固定规则更有效;而那些规则反而可能削弱性能。
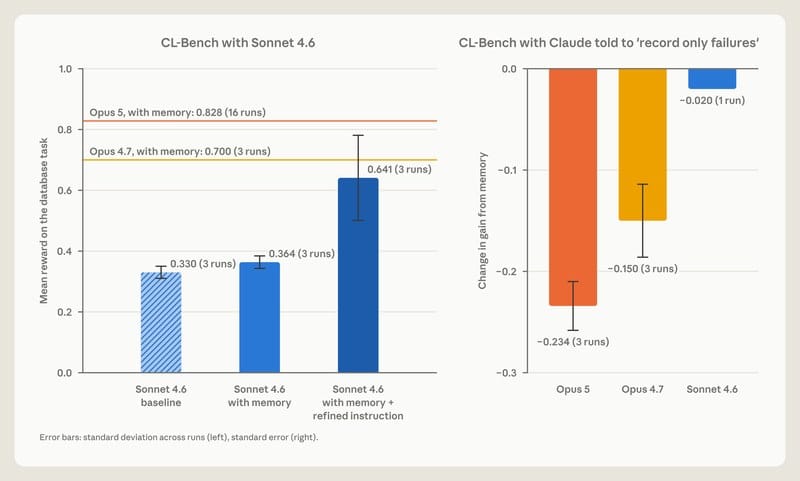
我们也注意到,引导对较老的模型帮助最大。比如 Sonnet 4.6 常常不去读记忆目录里的文件,也没有去验证它关于"为什么答错"的猜想。这种情况下,提示 Claude 在回答前先读记忆文件、然后显式验证它的猜想,几乎让它的基准分翻了一倍(图 5 左)。Sonnet 5 自己就会这么做:在没有被提示的情况下,它在 10 次里有 9 次先读了记忆;相比之下 Sonnet 4.6 不到一半。
对前沿的 Claude 模型,我们通常只给简单指引:当人要求时,或者当某件事明显值得记时,就写记忆笔记,把这个判断留给 Claude 自己做。
五、做梦可以纠正记忆
既然 Claude 是根据自己在会话中判断的显著性写记忆,那么一条一开始就错、或随着环境变化而漂移的笔记,就可能被之后会话里的 Claude 读到并信任。
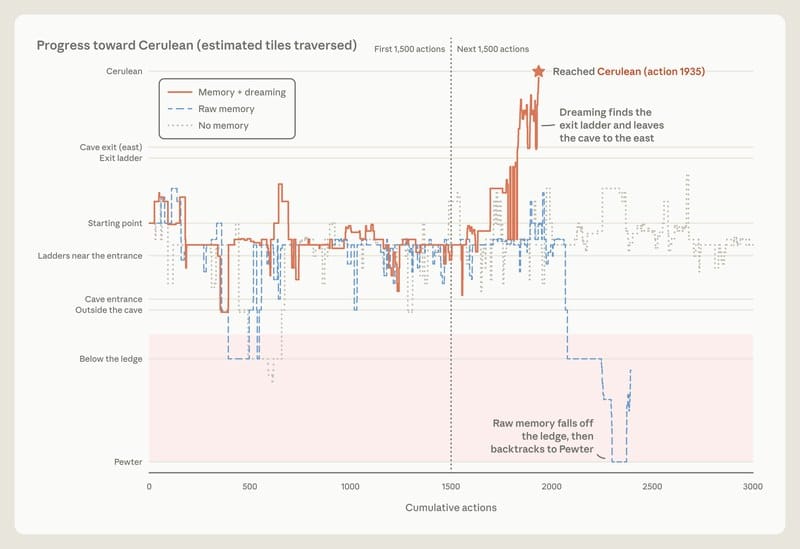
做梦给了 Claude 一个用自己的会话记录来校验笔记的办法(图 6)。我们在 Claude 用 Managed Agents 玩宝可梦、并挂载了记忆目录时,看到了一个正面例子。
游戏里有一段要让玩家穿过月见山(Mt. Moon),这个洞窟西边是入口、东边是出口。入口附近有个陷阱:一段单向的断崖,会把玩家丢回他来时的路上,而且没有明显的路能爬回去。Claude 拿山脚下的宝可梦中心(PokéCenter)当路标,所以它会不会走错断崖,取决于它认为宝可梦中心在山哪一侧。
某个时刻,Claude 写下(错误地)宝可梦中心在东侧。当它走出宝可梦中心时,它宣布「月见山在我身后了」,并更新笔记:「Mt Moon DONE」。但月见山并不在它身后。几步之后,Claude 越过断崖,落回它来时的路上(图 7)。它的导航工具没有显示这次跌落,于是 Claude 得出结论「我往西走过头太远了」,并认为它一直都在正确的一侧。并非如此。
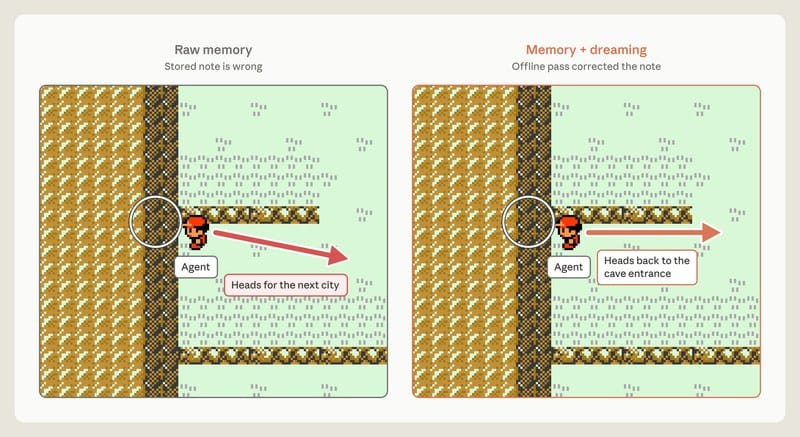
随后我们测试做梦能不能帮 Claude 避开这个陷阱。我们对那个存着错误宝可梦中心位置的记忆文件夹跑了一次做梦:Claude 把笔记和会话记录对照,抓到自己的错误,重写了它。会话记录给了 Claude 一个可以用来校验记忆的事实基准。带着修正后的笔记,Claude 直接回到月见山里,最终到达华蓝市(Cerulean City)。
而在笔记未修正的那轮,Claude 三次落回那条早先的路线上。第三次失败后,Claude 像是放弃了,写下「我要停下来,不再循环」。我们这套装置的自动回复指示它继续。于是它继续了,一路走回尼比市(Pewter City)——山之前的小镇,它希望在那里治疗和补给。这轮结束时,Claude 始终没能到达华蓝市。
六、做梦可以建立新的记忆表示
借助做梦,Claude 可以建立一些表示来帮助在记忆里导航(图 9)。它使用的一类记忆表示叫 wiki:由 Claude 自己撰写和维护的一组页面,收集某个主题上它已知的东西,并链接到其他笔记。这些链接实际上给了 Claude 一张地图,用它在记忆里筛找、在需要时高效定位。
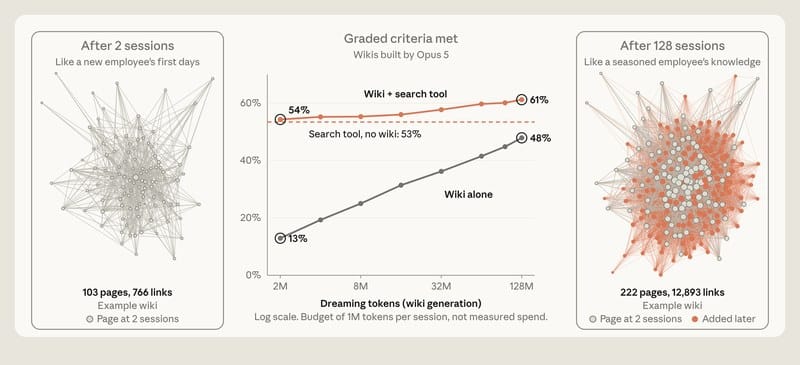
像 wiki 这样的表示能帮 Claude 遍历它不断增长的知识库。我们用了 Stainless——我们五月收购的一家软件公司——的内部文档语料(约 35 万个文件、大约 4.2 亿 token)来探索 wiki 作为记忆表示的收益。我们围绕这份语料做了一套 25 个问题的评测集,并给 Claude 一个搜索工具去探索它。我们还指示 Claude 用做梦基于这些文件建一个 wiki。在 128 次会话里,我们让 Opus 5 智能体去探索文件、撰写或修正互相链接的 wiki 页面、合并重复项、并对照来源核查断言。每次会话都在之前会话的进展上继续,用一个共享日志协调工作。当我们把做梦从 2 次会话扩到 128 次时,25 个问题上的表现从 13% 提升到 48%(按评分标准的满足比例,图 10)。
Claude 的 wiki 是增量长出来的。建好初版 wiki 之后,它用后续几轮做梦来增补、编辑、剪枝。在做梦的早期轮次里,Claude 的知识像一个新员工,单靠 wiki 答题的能力有限。做梦越多,它的知识地图越丰富,像一个老员工。在我们的测试里,wiki 帮 Claude 最多的时候,是我们同时给了它搜索工具的时候:当它同时用搜索和 wiki 时,随着 wiki 增长,它的总分从 54% 升到 61%,而只有搜索工具时是 53%。只用 wiki 答题时,Claude 的最好成绩是 48%。同时用搜索和 wiki 还每题省下约 20,000 token。
我们想测哪些任务能从 wiki 里受益。为此我们用了 Harvey LAB 基准,外加一批关于某桩并购的文件。这个基准给 Claude 一组文件,让它据此写一份法律摘要,再按一张标准清单给摘要打分。虽然大概没有玩宝可梦那么有意思,但这些评测提供了多样化的文件集合,可以拿来建 wiki。
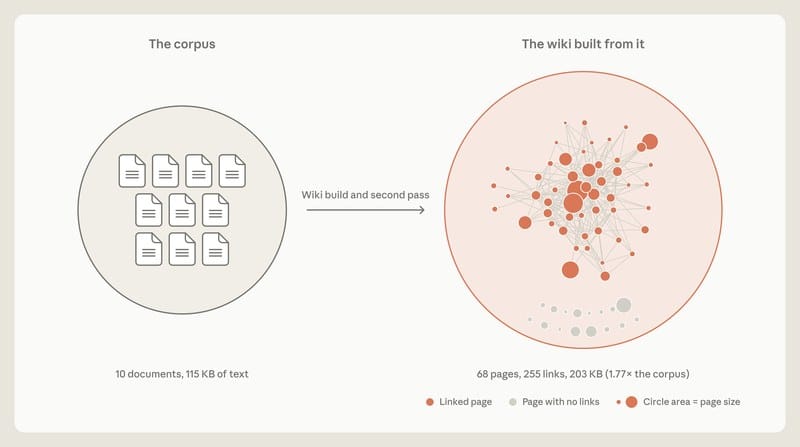
我们指示 Claude 用这些文件建一个 wiki。然后我们让 Claude 分别通过 wiki 和直接文件搜索,来回答(关于并购的)问题、或生成法律摘要(LAB 基准)。其中一个测试问了 24 个关于这桩并购的问题(图 11 左),其中一半以上需要 Claude 跨多份文件找信息,很多还需要它做判断或算数。这些条目上(红线和橙线),查 wiki 时 Claude 得 87%,只用搜索时 73%。
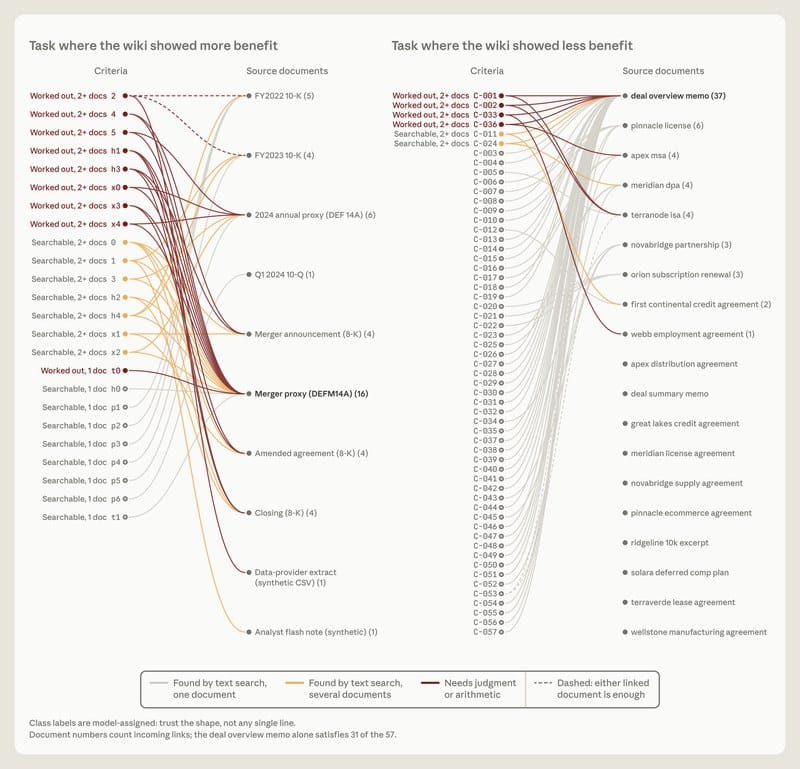
在另一些情况下,wiki 没那么有用。在一个 LAB 任务上(图 11 右),摘要的标准常常能从单份文件里用文本搜索检索到,wiki 相对搜索没有明显增益。在另一个 LAB 任务上,wiki 长得比原始文件本身还大(图 12)。就像博尔赫斯那篇一段话的短篇小说《论科学的精确性》里的制图师,画出的地图细致到和它代表的帝国一样大——Claude 做了一份极其详尽的 wiki,实际上什么也没抽象出来。
七、做梦可以把笔记提升到记忆层级的上层
做梦也可以把笔记浮动到记忆层级的上层,而智能体的 harness 可以在每次会话开始时,把它们预先加载进 Claude 的上下文(图 13)。这意味着 Claude 不需要去搜它们,甚至不需要知道有什么东西可搜。
把记忆提升进新会话(一种上下文注入)必须谨慎。注入的记忆会占掉宝贵的 token,而一条错误的笔记会被带进每一次会话。加载一条笔记也不保证 Claude 会照着做:我们关于 Claude Code 的文档就警告过,更长的指令文件会降低遵从度。所以记忆层级的最上层必须保持相对小,做梦在这里的大量工作就是维持这一点——把一些细节下移,只留下链接。
Claude Code 的自动记忆用同样的方式让注入层保持小,由 Claude 在会话期间维护。Claude 不会把它的全部自动记忆加载进每个会话的上下文窗口,只加载 MEMORY.md 的前 200 行或 25 KB。这个头部充当索引,告诉 Claude 它知道什么、去哪儿找。
八、做梦可以让记忆围绕特定目标生长
做梦也能塑造记忆如何生长。比如像 Claude Duet 这样的助手,往往受益于围绕它帮助的那个人来组织的记忆,而做梦可以被调校成服务于某个特定目标来构建记忆。
指导记忆如何生长的指令因任务而异,它告诉 Claude 哪些信息才重要。比如 LAB 基准里有一个任务模拟一桩公司收购,并提供一组合同,摘要的打分点是它是否正确描述了合同条款。
我们一开始用的建 wiki 的基础指令并没有告诉 Claude 该怎么用这个 wiki。这个任务高度依赖合同条款。在 wiki 建造过程中,有几个智能体同时往一张共享的合同条款表里写(图 14 左)。
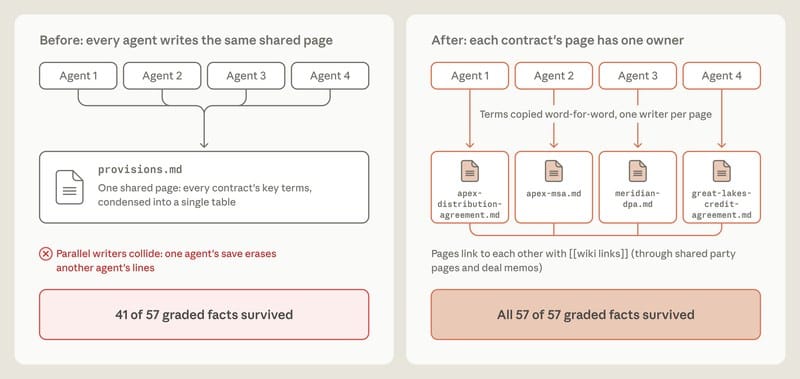
结果是一份缺了关键事实的 wiki。当我们给基于这份 wiki 生成的摘要打分时,Claude 只写进了 57 条事实中的 41 条(72%)。回头看哪里出了问题时,我们发现那张共享表把合同条款概括得很差,还漏掉了一些,因为智能体之间互相覆盖了对方的工作。
合同条款是这份 wiki 最重要的部分,但指令没有说明这一点。为了找出更好的指令,我们跑了一个循环:Claude 反思失败、提出对指令的改动、重建 wiki。这个循环让 Claude 发现了遵循合同条款有多重要,它据此重写了建 wiki 的指令。
每份合同在 wiki 里有了自己的页面,由单个智能体撰写,逐字引用条款而不是概括进一张共享表。当我们给基于这份改进后 wiki 生成的摘要打分时,100% 的标准都能满足,之前是 72%。
九、做梦可以补上单次会话留下的缺口
Claude 写记忆笔记时,只看到那一次会话的上下文。做梦可以跨很多会话搜索,找出通用模式或纠正常见错误。
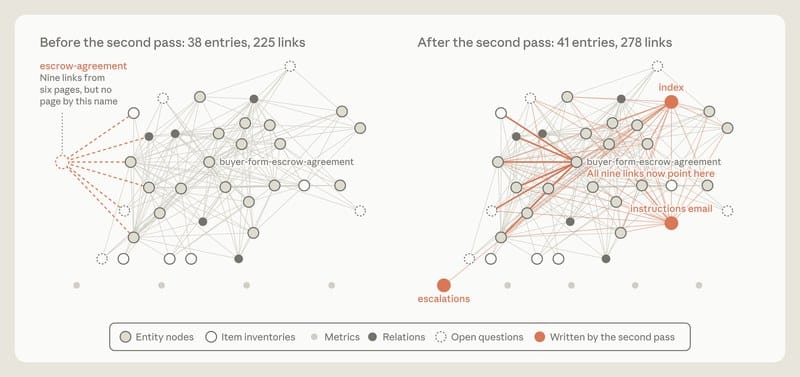
在为 LAB 基准建 wiki 时(示例见图 14),Claude 有时会链到还没建立的页面。第二遍做梦补上了不少这样的缺口。在一个任务上(图 15),做梦发现 wiki 里有 9 个链接指向一个不存在的页面,把它们改指向同一份文件的已有页面;它还新增了 3 个页面,包括一个索引,改进了 wiki。
十、往回思考,向前看
如何为智能体设计记忆系统,还有很多开放问题。
一个是 Claude 什么时候该创建记忆。Claude 做任务时,可以写进一个记忆存储(比如文件夹、文件或数据库),在源头捕获显著性,让重要细节在之后的轮次或会话里立即可用。但即时的记录必然会把 Claude 的注意力从主任务上拉走。相比之下,做梦可以把记忆创建推到后台,但做梦的产出可能不会立即被 Claude 用到。
另一个问题是怎么让记忆可靠地保持最新。Claude 可能做出错误的预测,或把一开始就错的规则写进记忆。环境变化时,记忆也会漂移、变得不相关。做梦是修正这些错误的一种办法(图 8),但它要花算力。让 Claude 持续检查它所有的记忆可能不现实。更重要的也许是让做梦集中在那些可能变化的信息上,或者仔细调校做梦的节奏(例如按记忆被访问的频率)。
把会话记录搜索当作 Claude 记忆的地基,也是一个合理的考虑。把表示(如 wiki)和搜索结合起来(图 10)有时确实有效。但 Claude 需要花算力去维护记忆表示,确保它们不积累错误或幻觉。
尽管 Claude 对显著性的判断已经变好,但没有模型能真正知道未来的轮次会发生什么。做梦给 Claude 一个机会往回看,用算力去组织记忆、纠正错误、维护那些让之后会话更容易取到记忆的表示。记忆系统会随 Claude 能力提升而演进,关于如何设计 Claude 的记忆系统,我们还有很多要学。
想上手做梦与知识 wiki,可以看 Anthropic 的 cookbook:用动态工作流做梦 与知识 wiki。
致谢
由 Lance Martin 撰写,编辑指导 Caitlin Love、Tom Chivers、Rebecca Hiscott、Jake Eaton 与 Blake Wilson。感谢 Barry Zhang、Theodora Chu、Daliang Li、Mahesh Murag、Jake Noble、Ravi Trivedi、Tina Vachovsky、Brad Abrams、Henry de Valence、Jeremy Fox、Matt Bell、Allen Li、Chris Gorgolewski、Eugene Yan、Artur Renault、Wei Zhang 与 Kevin Chen 的有益讨论与贡献,感谢 David Hershey 提供 Claude Plays Pokémon。图表由 Monika Tuchowska 制作。
我们的整理
原文把"记忆"拆成三层,每层解决不同的失败模式。按它自己的数字排一遍:
| 层 | 谁写 | 解决什么 | 原文证据 |
|---|---|---|---|
| 笔记(note) | 会话内的 Claude,按自己判断的显著性写 | 把"只有想出来才存在"的东西(策略、验证过的规则、发现的陷阱)存下来 | Opus 5 的条目含规则 + 它怎么知道规则成立 + 陷阱警告;Fable 5 的 global.md 只有目标、计划、自己的记忆规则 |
| 做梦(dreaming) | 后台算力,跨会话读日志 | 纠错(错的宝可梦中心位置)、补缺(9 个断链 + 3 个新页面)、把细节下移 | 三次落回旧路线 → 修正后直达华蓝市;57 条合同事实 72% → 100% |
| 表示(wiki) | 做梦批量产出,增量迭代 | 让"翻找"变成"有地图可看" | 128 次会话 13% → 48%;wiki + 搜索 61% vs 只有搜索 53%;每题省 2 万 token |
三条可以直接拿走的判断:
- 记忆的价值不在存量,在淘汰。413 个文件 vs 9 个文件、1 枚徽章 vs 4 枚徽章,差别不是记得多,而是记的是"屏幕上读不到的"还是"每回合都能读到的"。要检的判据是:这条记忆不写下来,下次会话还能自己算出来吗?能,就别写。
- 规则写死会伤前沿模型。「只记录失败」这条规则让 Opus 5 和 Opus 4.7 都丢掉了记忆带来的大部分增益(图 5 右)。给判断权、不给清单,是原文明确的结论。
- wikis 会长成地图而非地图。博尔赫斯那个比喻不是修辞:有一个 LAB 任务的 wiki 比原始文件还大。所以 wiki 该有体积上限或剪枝触发条件,别让它变成第二份原文。
一段边界:这是厂商自述的评测。CL-Bench、Pokémon、Stainless 语料、Harvey LAB 都在 Anthropic 自己的 harness 里跑,原文没给人类基线,也没给不同 harness 的对照;「做梦」在这里是产品机制名(Managed Agents 的 dreams),不是一个通用的学术定义。数字可以引,因果关系要留余地。
相关阅读
- 你的 Agent 并不自主:你就是它的循环——记忆层在七级 harness 里的位置
- 给 coding agent 一个你自己的记忆层——本地记忆层的另一种做法
- 子代理交接的三种做法——上下文交接与记忆的边界
来源
Anthropic,《The components of agent memory》,Engineering,2026-11-06(2026-11-06 21:15 更新):https://www.anthropic.com/research/components-of-agent-memory。正文图 1–15 与原文一致,已转存站内。
本文由 汇智网 · Software 2.0 编译整理,转载请注明出处。