AGENTS.md 该写什么:1,866 个项目的说明书实测
1,866 个热门项目里 34% 给 Agent 写了说明书:AGENTS.md 占 78%;61% 的规则可脚本检查,仅 3.7% 写了检查命令。
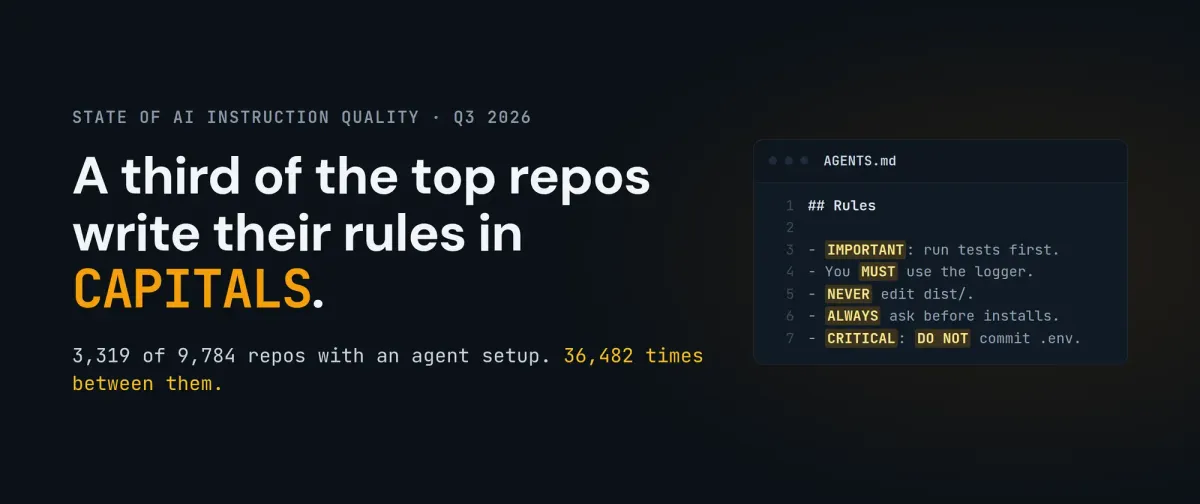
一句话结论:给 coding agent 写说明书,已经从"要不要写"变成"怎么写才有用"。1,866 个热门 GitHub 项目里 34% 已经在写;但两份不同口径的实测给出同一个反直觉结论——长说明书不会让 Agent 更聪明,只会更贵。真正把一行规则变成约束的,是它后面有一个"能失败的检查":1,866 项目样本里 61% 的规则本可由脚本检查,只有 3.7% 写明了检查是什么。
本文编译三组新近公开的数据:Rakesh Menon《What 1,866 Popular GitHub Projects Tell Their AI Coding Agents》(2026-10-15)、Reporails《State of AI Instruction Quality: A Third of Repos Shout》(dev.to,2026-10-15,Q3 报告覆盖 9,784 个仓库)与 @wolfejam《I argued with AI (Codex) about AGENTS.md》(dev.to,2026-10-15),并合入两组来源共同引用的 ETH Zurich 论文《Evaluating AGENTS.md》(Gloaguen et al., arXiv 2602.11988)、@lilnickyai《Stop Writing Prompts. Start Installing Skills.》(dev.to,2026-10-15)关于 Skill 化的部分,做中文整理。三份原始材料分别来自一本即将出版的工程手册作者、一个说明书诊断工具厂商与一位开源工具作者,都带有立场,本文按"数据与原文观点"分别标注。
一、三分之一的项目已经在给 Agent 写说明书
先看基础盘。研究者抓取了 GitHub Ranking 榜单(总星标前 100 + 24 种语言各自前 100,2026-10-15 快照)共 2,424 个项目,保留 2026 年有提交的 1,867 个、可读取的 1,866 个,逐个检查根目录与子目录里的 AGENTS.md、CLAUDE.md、GEMINI.md、Copilot instructions、Cursor / Windsurf 规则文件。
结论是:627 个项目(34%)至少给 Agent 写了一份说明书。这个比例在不同语言间差距巨大:
| 语言 | 有 Agent 说明书的比例 |
|---|---|
| TypeScript | 73% |
| Go | 58% |
| Rust | 52% |
| Python | 49% |
| JavaScript | 40% |
| C# / Java | 36% |
| Ruby | 33% |
| C | 24% |
| Haskell | 15% |
| Perl | 4% |
在写了说明书的 627 个项目里,AGENTS.md 已经是共同格式:78%(489 个)有 AGENTS.md,52% 有 CLAUDE.md,20% 有 GitHub Copilot instructions,Cursor rules 和 GEMINI.md 各 4%,Windsurf 1%;其中 214 个项目只有 AGENTS.md 一个文件。这个格局有背景:AGENTS.md 在 2025 年 12 月被捐给 Linux Foundation 旗下的 Agentic AI Foundation,成为开放标准;2026 年 9 月起,Claude Code 在没有 CLAUDE.md 时也会直接读 AGENTS.md——两个"阵营"在文件层面已经合流。
但合流不等于干净。209 个项目根目录同时有 AGENTS.md 和 CLAUDE.md:其中 157 个是一份指向另一份,5 个是完全相同的拷贝,约 30 个维护着两份真正不同的规则书。研究者对此的判断很直接:这是"同一块地的两张地图,没有任何东西让它们保持同步"——读 A 文件的 Agent 会执行 B 文件里另一个 Agent 永远看不到的规则。如果需要第二份文件,最省事的做法是让它只写一行,指向 AGENTS.md。
长度:中位数 106 行,一半超预算
对 582 个根目录主文件统计长度:中位数 106 行、约 850 词(按 4 字符 ≈ 1 token 估算约 1,600 token);302 个(52%)超过 100 行,87 个超过 300 行,最长 1,048 行。
100 行这个预算是 OpenAI Codex 团队给的喻:给 Agent "一张地图,而不是 1,000 页说明书"——约 100 行的 AGENTS.md,把细节指向文档。原因不神秘:说明书里的每一行,都在和当前任务真正需要的那一行竞争上下文。
按标题主题统计 585 个主文件,覆盖最多的是:命令与启动 60%、结构与架构 59%、代码风格 58%、测试 52%、Git / 提交 / PR 41%;而文档 22%、依赖 18%、安全 13%、错误与调试 12%、性能 6%——另一份 "Agent READMEs" 研究(arXiv 2511.12884)在别的样本里量到安全 14.8%、性能 14.5%,结论一致:安全与性能这两块最容易被漏掉。
规则不只在根目录
187 个(30%)项目把说明书放进子目录,中位数 3 份,最多一个项目有 190 份。对大代码库这其实是正确形状:根目录放一张短地图,细节放在细节该在的地方——Agent 在处理那个目录时才会加载。
二、61% 的规则本可脚本检查,只有 3.7% 写了检查
研究从样本里随机抽了 300 行"读起来像规则"的文本(含 must / never / always / avoid / should 等指令词、排除代码块),由独立 AI 标注员逐条分类,得到 257 条真规则。它们写的是:
| 规则主题 | 条数 | 占比 |
|---|---|---|
| 代码风格与约定 | 41 | 16% |
| Agent 行为与沟通方式 | 38 | 15% |
| 领域 / API 正确性 | 33 | 13% |
| 架构与代码放哪里 | 28 | 11% |
| 测试 | 24 | 9% |
| 构建 / 运行 / 工具命令 | 22 | 9% |
| Git / 提交 / PR | 21 | 8% |
| 文档与代码注释 | 17 | 7% |
| 错误 / 日志 / 性能 | 11 | 4% |
| 生成文件 / 受保护文件 | 7 | 3% |
| 安全与密钥 | 7 | 3% |
| 依赖 | 5 | 2% |
| 其他 | 3 | 1% |
没有哪个主题占压倒性多数:风格最多也只占 16%;安全、依赖、生成文件各自不到 3%。
然后是全篇最值得记的一组数字:对 257 条规则分别问两个问题——脚本 / linter / 测试 / CI 能不能抓到违规,以及规则有没有写明用哪个检查。结果是:
- 157 条(61%)至少能部分被脚本检查(64 条完全可查、93 条部分可查);
- 这 157 条里,只有 8 条写明了检查是什么;
- 换一个 200 行样本复核,174 条规则里同样只有 8 条写明;两个样本合计 16 / 431 = 3.7%;
- 剩余 100 条(39%)需要人的判断。
作者举了三条"便宜到离谱却没写"的例子:
“Don't use empty destructuring patterns.”        → 一条 lint 规则
“File names should be lower case with hyphens”   → 几行脚本
“Do not add Co-Authored-By: Claude …”            → 一个 commit hook
反过来说,最好的文件都在规则后面挂了"谁来抓"。Homebrew 的 AGENTS.md 只有 72 行:开头是"提问前先跑的那一条命令",列出每次提交前必须过的检查,很多规则直接写 enforcement——比如 Never use T.must (enforced by Sorbet/ForbidTMust);提交格式规则会告诉你,格式错了会被 GitHub Actions 拒绝。Kubernetes 的 AGENTS.md 只有 38 行;systemd 的则把 Agent 指到四份文档(架构、工作流、风格、贡献)。systemd 还有一条元规则值得抄:只有在实践中看到 Agent 真犯了某个错,才把对应规则加进文件——每一行都要挣得自己的位置。
地图过时的问题比想象中轻,但代价不对称:585 个文件里 10 个(约 2%)指向了已不存在的路径或脚本。研究者说出了一个关键点:当一行过时的指令出现时,Agent 不会跳过它,它会执行它——这正是"一个检查值那几毫秒"的原因。
作者给的 10 分钟自检清单可以照抄:
- 数行数:超过 100 行?把细节搬进文档,只留指针;
- 检查它提到的每个路径和命令:是否还存在;
- 逐条读规则,问"什么能抓到它被违反":能脚本化的,把命令写在规则末尾;测试已经覆盖的,指向测试;什么都抓不到、评审也看不出来的,考虑删掉;
- 如果维护多份文件,让其余只写一行指针。
三、9,784 个仓库的"提示词习惯史"
第二份样本更大,也更有意思。Reporails 扫描了 10,000 个高星仓库、15,237 个 Agent 配置,其中 9,784 个有说明书,逐条统计"习惯"。工具厂商做诊断、卖诊断工具——这点立场要先记住;但它的可观测量本身有参考价值。
最普遍的习惯是“喊”:3,319 个仓库(33.9%)在说明书里至少写过一个大写强调词(IMPORTANT / CRITICAL / MUST / NEVER / ALWAYS / DO NOT 等),合计 36,482 次。MUST 最多,其次 CRITICAL、NEVER、ALWAYS。有意思的是分布:CLAUDE.md / AGENTS.md 主文件里只有约 22% 用大写,而 Gemini、Cursor、Copilot 的说明文件里高达 31%–35%。
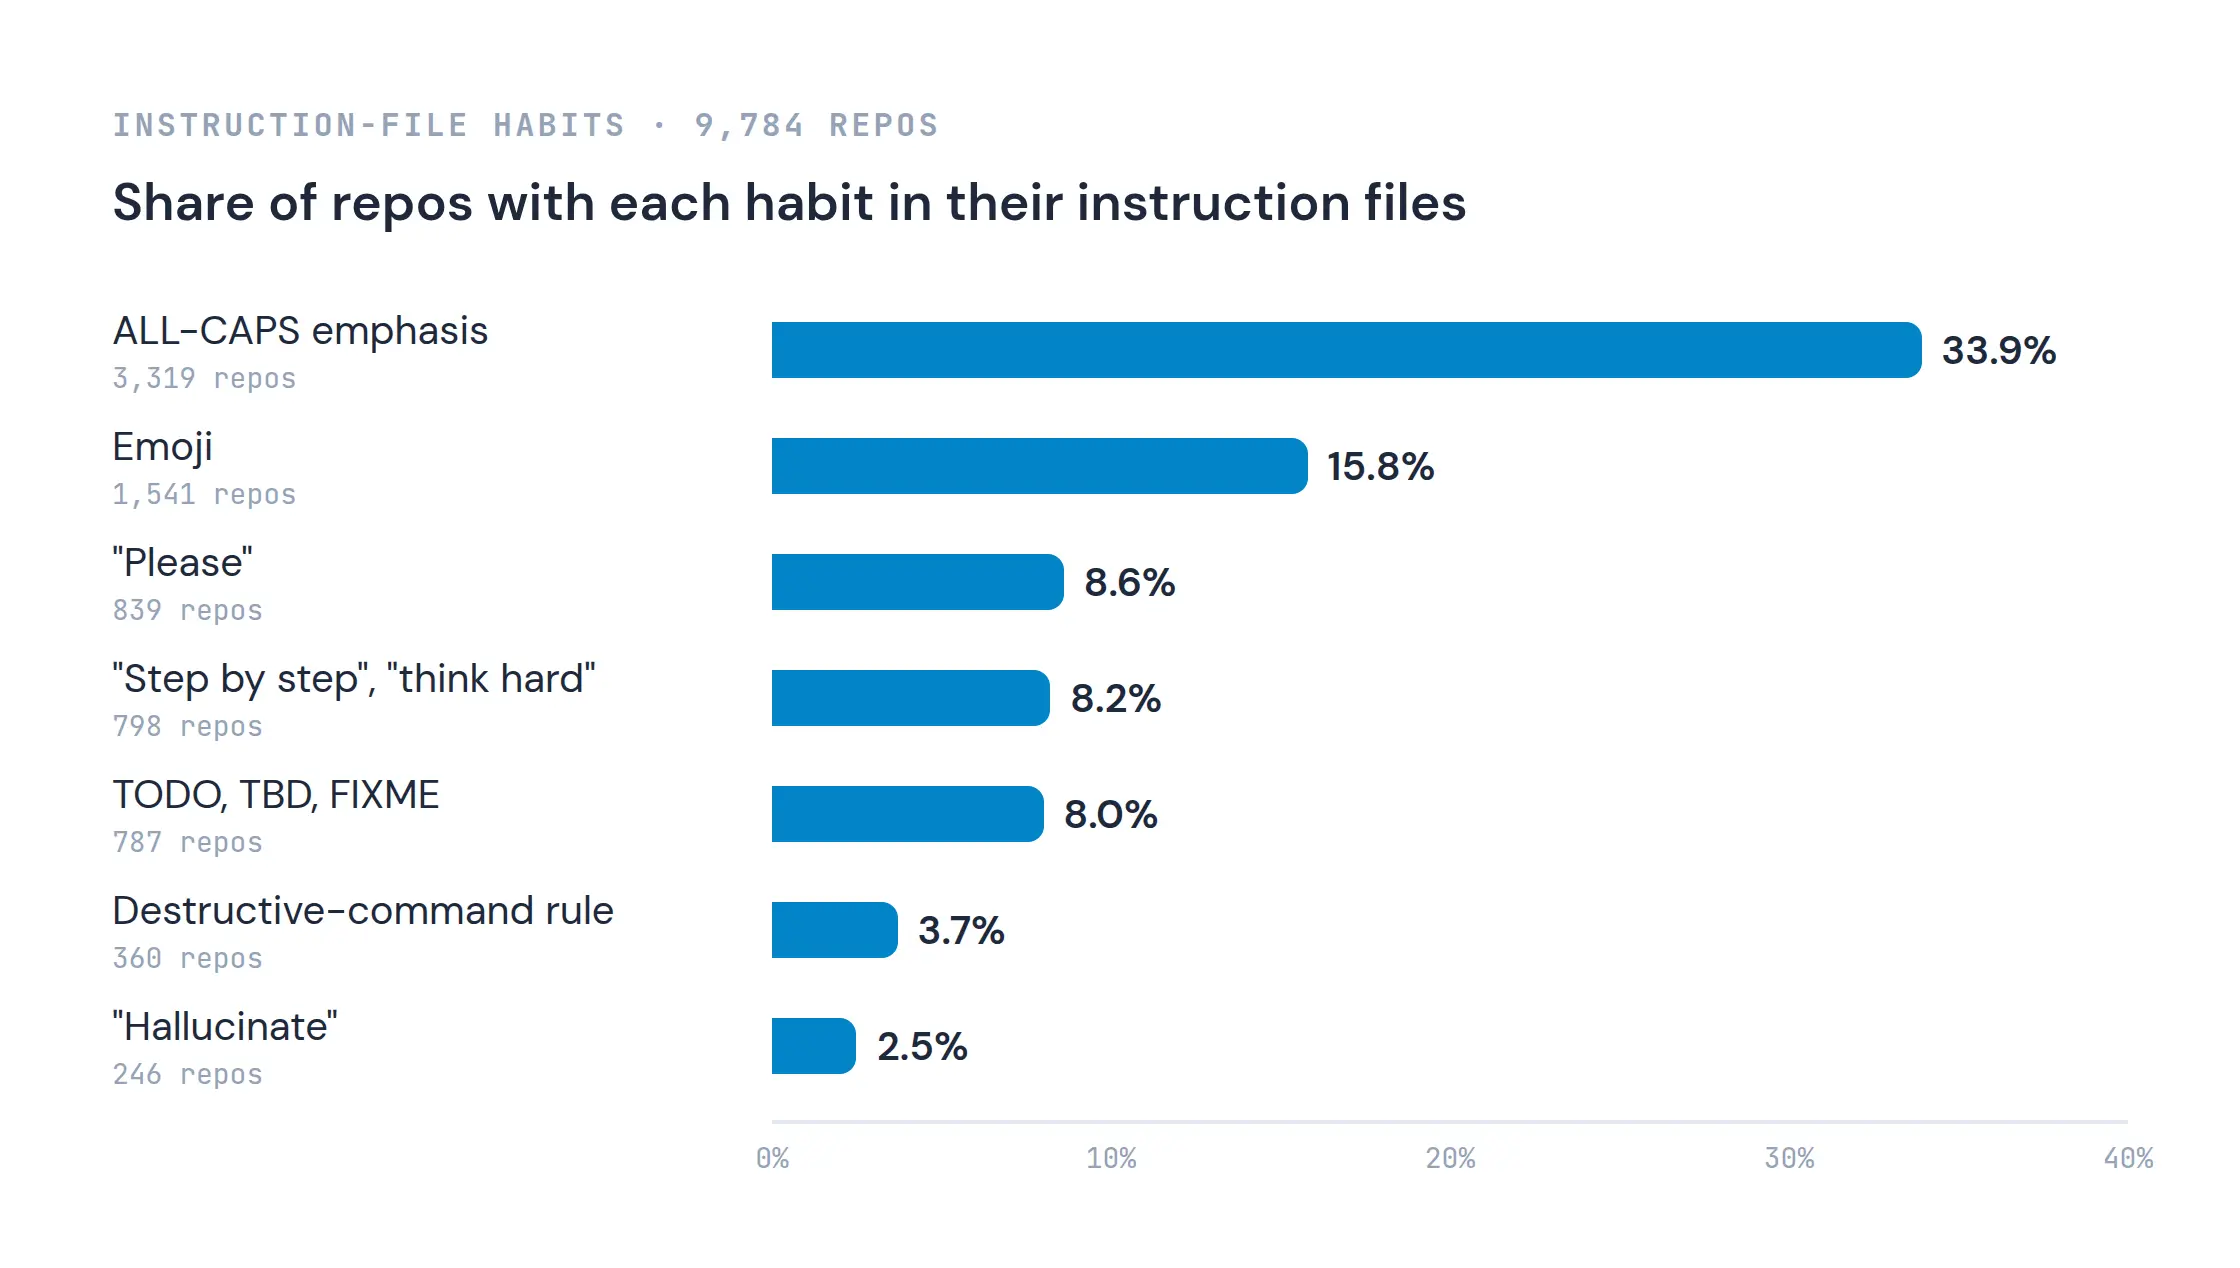
其余高频习惯像一部"提示词进化史":
| 习惯 | 仓库数 | 占比 | 出现次数 |
|---|---|---|---|
| emoji | 1,541 | 15.8% | 29,311 |
| “please” | 839 | 8.6% | 2,051 |
| “step by step” / “think hard” / ultrathink | 798 | 8.2% | — |
| TODO / TBD / FIXME | 787 | 8.0% | — |
禁止破坏性命令(force-push、rm -rf 等) |
360 | 3.7% | — |
| 提到 hallucinate | 246 | 2.5% | — |
这些习惯都住在"大配置"里:全体仓库的说明书中位数是 2 份,而带上述习惯的仓库中位数是 5 到 14 份。更多文件意味着更多文本,也意味着更多机会命中任何一个词。
厂商没有替厂商遮丑:Anthropic 和 OpenAI 的提示词指南都写了新模型不需要这些老写法——Anthropic 说新模型"对系统提示更敏感",老写法可能过度触发,"修法是收回激进措辞";OpenAI 的 GPT-5 指南举了反例:Cursor 那句 "Be THOROUGH when gathering information" 对旧模型有效,对 GPT-5 反而适得其反(它本来就倾向于主动收集上下文)。"think step by step" 对推理模型同样不再必要——它们本来就在内部推理。
"please" 与"别瞎编"这两条,问题不在礼貌,而在可执行性:在最小的四分之一仓库里,说 "please" 的仓库携带的模糊指令是其他仓库的两倍(8.7 vs 4.3 每 100 条);而一句光秃秃的 "don't hallucinate" 没有指向任何可以核对的东西——要能核对,得点名来源:schema 文件、API 文档页、列出实际对象的命令。
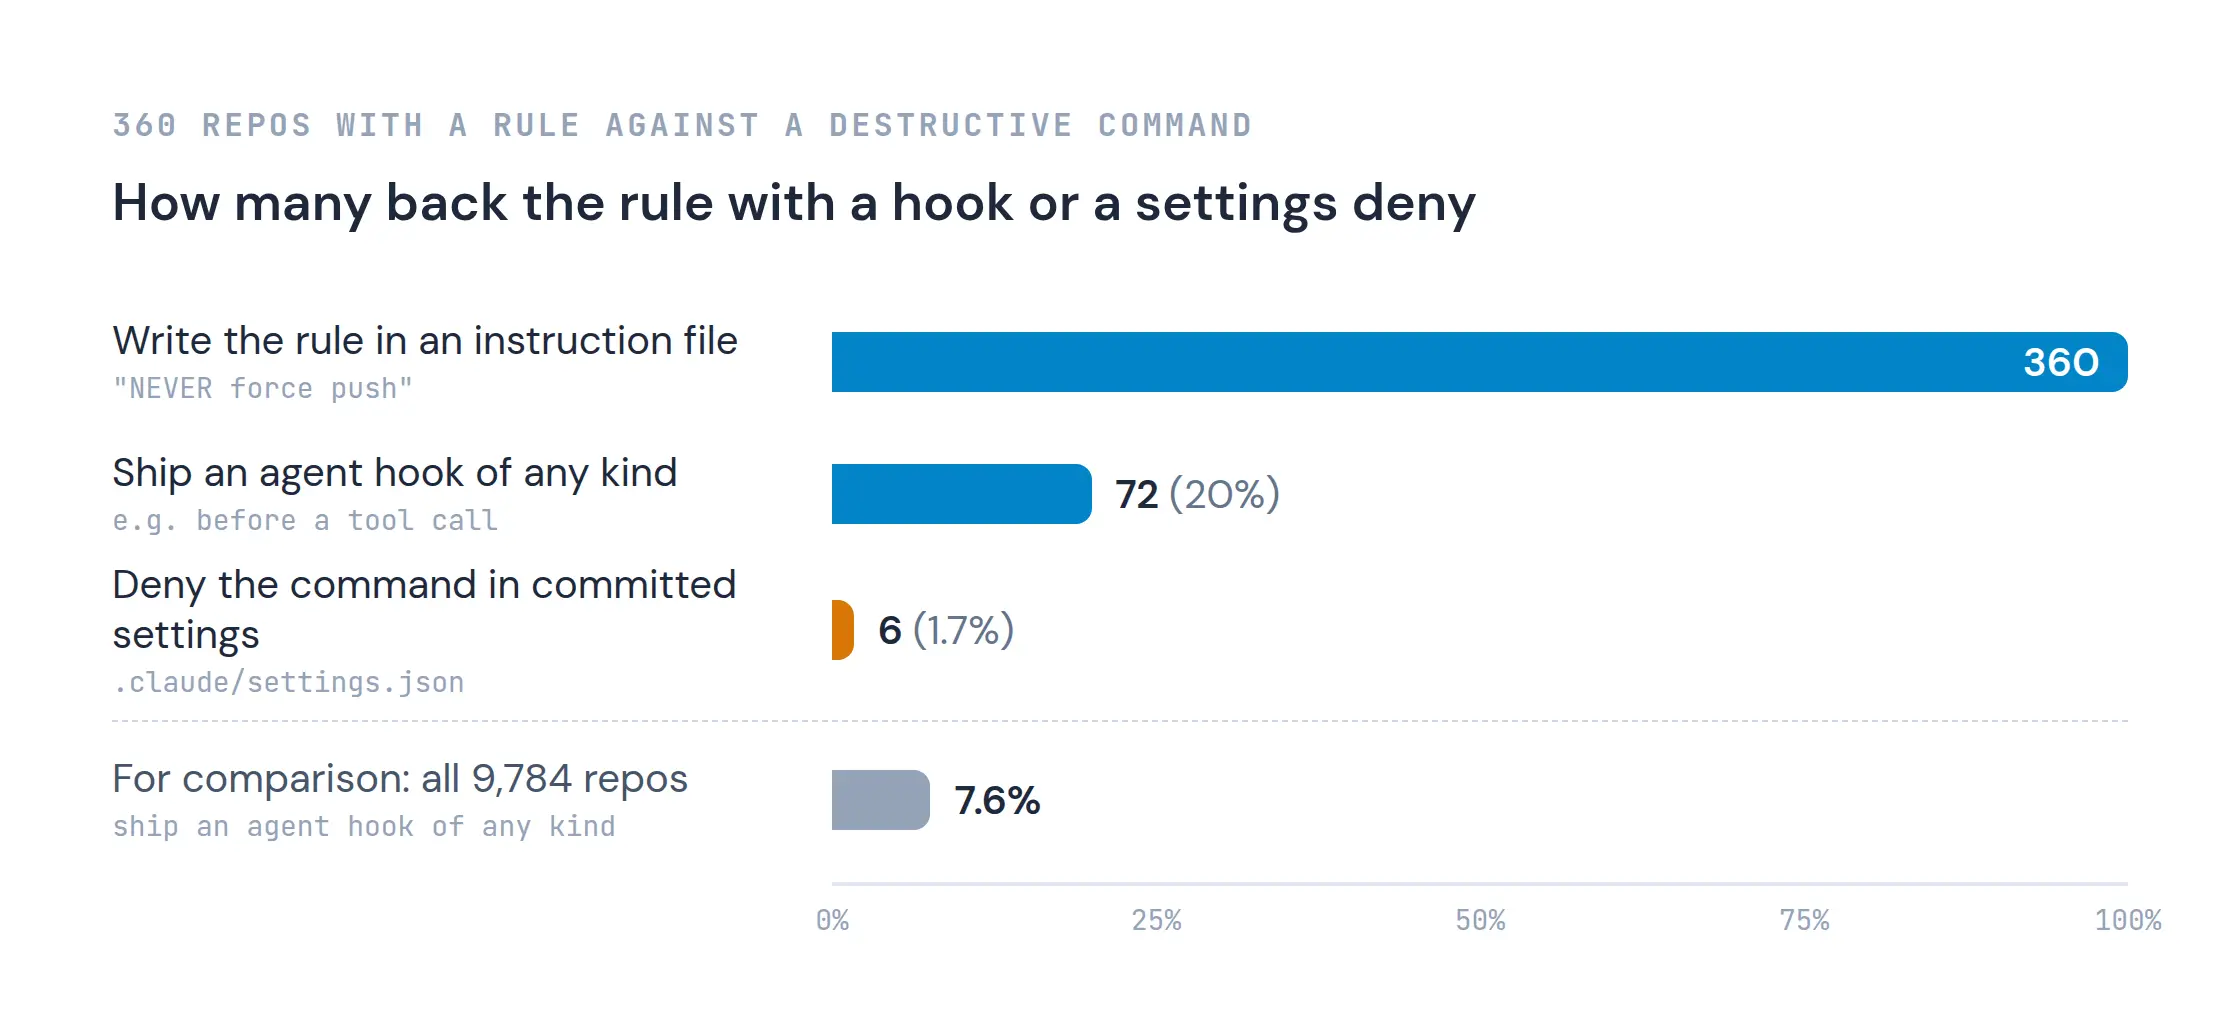
真正值得放大的是 hook 与提示词的差距。360 个写了"禁止破坏性命令"的仓库里:
- 72 个(20%)配了某种 agent hook(工具调用前运行的脚本),全体仓库只有 7.6%;
- 只有 6 个在提交到仓库的
.claude/settings.json里真正 deny 了这条命令; - 而 1,466 份已提交的 Claude Code settings 文件里,19 份允许任意 shell 命令,3 份完全关掉了权限提示。
一句话:提示词负责引导,hook 负责执行(Prompts steer, hooks enforce)。写 “NEVER force push” 是必要的,但如果只写不挂,它仍然只是一句愿望。
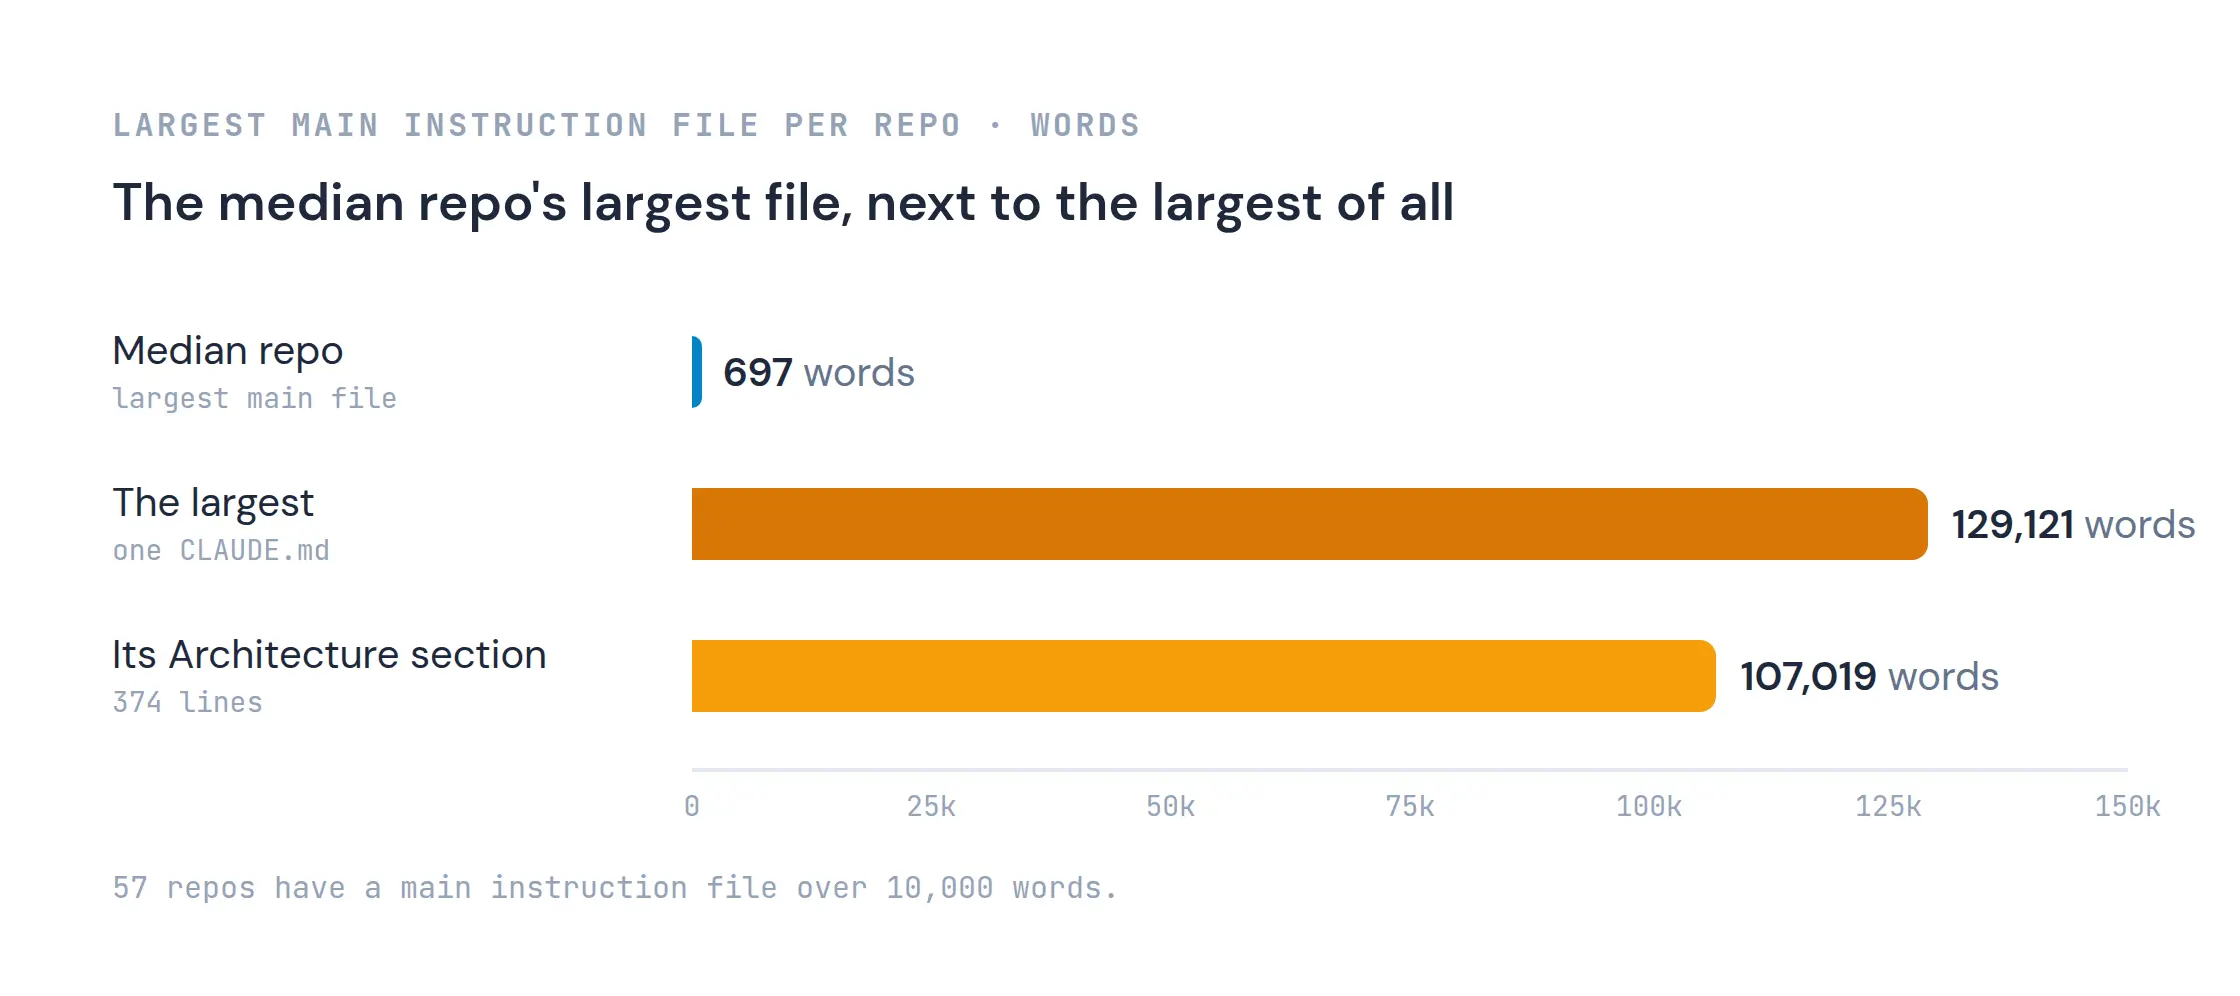
最后是一个极端样本:最大的 CLAUDE.md 有 129,121 词,其中 Architecture 一节 107,019 词、374 行(约 300 词一行);57 个仓库的主说明书超过 10,000 词;中位数仓库的主文件是 697 词。作为对照,Claude Code 官方文档的建议是“每个 CLAUDE.md 控制在 200 行以内,更长的文件消耗更多上下文、降低遵循度”。12.9 万词的文件,在 Agent 读到第一行代码前就已经超过 10 万 token。
四、两个反直觉结论:写不写 ≠ 有没有用
把上面两份数据和学术结果放在一起,会得到两个和直觉相反、但互相印证的结论。
第一,上下文文件不是免费的。 两组来源都引用了 ETH Zurich 的《Evaluating AGENTS.md: Are Repository-Level Context Files Helpful for Coding Agents?》(Gloaguen et al., arXiv 2602.11988):提供上下文文件总体上不提升任务成功率,却平均增加 20% 以上的推理成本(另一处的表述是"成功率只边际提升、成本增加至多 19%");论文建议"只描述最小必要需求",并且在更新版本里补了一条更细的发现:规则本身写得好的确实会被遵循,但"仓库概览"这类段落虽然流行、虽然模型厂商推荐,却没有帮助。1,866 项目研究的作者对此的解读是:概览终究是散文,而散文可能过时、不具体、自相矛盾,Agent 分不清哪种。
第二,写得好仍然有收益。 同一篇文章引用了一项 124 个 PR 的实验(arXiv 2601.20404):有 AGENTS.md 时,Codex 完成的中位时间缩短约 29%——同时,Agent 会走更多步骤、花更多钱。把两组放在一起,结论就清楚了:说明书的价值不在"多",而在"准"——省下的是"猜项目怎么跑"的时间,付出的是"读文件"的上下文。
@wolfejam 的实践给出了一种解法:把"事实"和"指令"分开。AGENTS.md 是给 Agent 的指令——怎么构建、怎么测试、有哪些约定、什么别碰;而"这个项目是什么、为谁做、基于什么、什么不适用"属于可验证的事实,应该由一个结构化文件(他用的 project.faf)承载,且每个事实只有两个来源:仓库本身(自动读取运行 / 构建 / CI / 托管)或人(写出并批准代码看不出来的目标与人群)。他的口号是 "FAF defines. AGENTS.md instructs. AI codes."——结构化数据管定义,Markdown 管指令,两者不互相冒充。这也解释了为什么"仓库概览"不提升任务:它既不是可运行的事实,也不是可执行的指令。
1,866 项目研究总结的"最好文件"四个习惯,可以作为写说明书时的总纲:
- 短,并指向别处(Kubernetes 38 行;systemd 指到 4 份文档,不是把文档抄进来);
- 命令放最前面(Homebrew 的开头就是"先跑这一条");
- 规则写明谁来执行("enforced by Sorbet/ForbidTMust";格式错会被 workflow 拒绝);
- 每行都挣得自己的位置(只在看到 Agent 真犯错之后,才加对应规则)。
五、下一步:从说明书到 Skill
如果说 AGENTS.md 解决的是"这个仓库的 Agent 该怎么干活",那么 2026 年这波 Skill 化解决的是"这类任务该怎么做才对"。@lilnickyai 的比喻很准确:提示词是你一遍遍复述的愿望,Skill 是一次安装、长期生效的能力。
一个 Agent Skill 的物理形态简单到没有悬念:一个包含 SKILL.md 的文件夹。文件分两半——前面是 frontmatter,只有 name 和 description,而 description 要写出触发场景与用户的说法("make my agent safe"、"stop it from deleting"……),Agent 靠它决定"什么时候加载这个技能";后面是正文,把原本写在提示词里的一次性段落变成结构化内容:步骤、规则、正反例、出问题时的处理。安装就是把它放进 Agent 的 skills 目录;下一会话自动可见,不需要记任何命令。
Skill 相比提示词的四个优势——持久(不用每会话重贴)、结构化(分区、有示例,Agent 更稳定地遵循)、可复用(跨项目)、可分享(它就是一个文件夹,可以放进 GitHub 甚至出售)。但作者也留了一句诚实的提醒:Skill 不会让 Agent 更聪明,只会让它更一致——一份写坏的 Skill 会"稳定地做错事",这比偶尔猜对更糟;而且它不替代人的判断:Agent 起草,你决定。
把这套标准用到专业领域是什么样子,可以直接看两个最近的例子:BimAnt 刚整理的开源 Skill Monument(给 Claude Code 一个建筑名,它按真实平面下载 OSM 轮廓、逐个年代"一砖一瓦"重建,并给每个日期和尺寸标注来源)——它把一个 8 步、带证据纪律的 3D 重建流程装进了一个 SKILL.md;而 DefiPlot 整理的交易 Agent 版本冲突复盘则给出了另一半警告:说明书会过期——当 RAG 里的静态规则落后于实盘配置,Agent 必须能发现版本冲突,并优先信任更新的运行时元数据。
六、写作检查清单(可直接用)
把三份材料合并成一张纸:
- [ ] 行数 ≤ 100:超了就把细节搬去文档,只留指针;
- [ ] 一份主文件:额外的文件只写一行指向它;
- [ ] 命令在前:构建、测试、跑起来的第一条命令放开头;
- [ ] 每条规则都能回答"谁来抓":写 enforcement,或指向已有测试;
- [ ] 事实与指令分离:项目是什么归结构化数据,怎么做归指令;
- [ ] 不写可被验证为空的话:不写 "don't hallucinate",写"以 schema 文件 / API 文档为准";
- [ ] 不用大写喊话(新模型不需要)、不写 "please + try to" 这类双重软化;
- [ ] 删掉 TODO:说明书不是待办清单;
- [ ] 定期修剪:只在看到 Agent 真犯错后加规则,没挣到位置的规则删掉;
- [ ] 高风险规则挂 hook:提示词引导,hook 执行。
来源
- Rakesh Menon / The Second Time Is a Bug, What 1,866 Popular GitHub Projects Tell Their AI Coding Agents(2026-10-15):https://secondtimeisabug.com/blog/what-projects-tell-ai-coding-agents/
- Reporails, State of AI Instruction Quality: A Third of Repos Shout(dev.to,2026-10-15;Q3 报告:10,000 仓库 / 15,237 个 Agent 配置 / 9,784 个有说明书):https://dev.to/reporails/state-of-ai-instruction-quality-a-third-of-repos-shout-39ei
- @wolfejam, I argued with AI (Codex) about AGENTS.md. Then I realized what it actually was.(dev.to,2026-10-15):https://dev.to/wolfejam/i-argued-with-ai-codex-about-agentsmd-then-i-realized-what-it-actually-was-5ee
- @lilnickyai, Stop Writing Prompts. Start Installing Skills.(dev.to,2026-10-15):https://dev.to/lilnickyai/stop-writing-prompts-start-installing-skills-149n
- Gloaguen et al., Evaluating AGENTS.md: Are Repository-Level Context Files Helpful for Coding Agents?(ETH Zurich,arXiv 2602.11988):https://arxiv.org/abs/2602.11988
- Agent READMEs(arXiv 2511.12884)与 124 PR 实验(arXiv 2601.20404),经上述来源引用:https://arxiv.org/abs/2511.12884 | https://arxiv.org/abs/2601.20404
- OpenAI Codex 团队关于 AGENTS.md "给地图、不给 1,000 页手册"的表述:https://openai.com/index/harness-engineering/
- Anthropic 与 OpenAI 提示词指南中"新模型不需要大写强调 / think step by step"的原文引用,见 Reporails 文章正文。
延伸阅读(本站)
- 子代理派活与上下文折叠:compaction、subagent、fold 三种交接实测
- 964 小时 Agent 自主循环复盘:GoodBarber 的 28 Agent 六天工作法
- MCP 工具该给几个?1,932 次实测:准确率不降,成本看客户端
- 专题:AI 编程 / Vibe Coding 完全指南
本文由 汇智网 · Software 2.0 编译整理,转载请注明出处。 想系统了解 Agent 的上下文、工具与工程化,见 Agent / MCP / 自动化完全指南。
这是「AI 编程 / Vibe Coding」专题的一部分。完整地图见:AI 编程 / Vibe Coding 完全指南