MCP 工具该给几个?1,932 次实测:准确率不降,成本看客户端
MCP 工具该给几个?1,932 次实测:5→100 个准确率一次没掉,唯一 89% 出在 Gemini 的分组工具;成本上,装载方式比数量更关键。
一句话结论:MCP 工具数量对准确率的影响,在前沿模型上被高估了。作者读完 91 份 MCP 设计资料(其中只有 10 份真正测过"工具数量 vs 准确率"),然后用 100 个仿真工具、18 个任务、3 个客户端跑了 1,932 次:从 5 到 100 个工具,全部运行都完全正确,包括 50 个刻意混淆的"近似工具"和模糊命名变体。唯一一次准确率下跌(89%)出现在 Gemini 的"7 个合并工具"变体上。真正被工具数量改变的是成本——而成本的大小,取决于客户端怎么把工具装进上下文,而不是模型本身。
本文完整编译 dev.to @yahhi《How many tools should an MCP server have? I measured 5 to 100 in Claude Code, Codex and Gemini》(2026-10-14),并合入 @zerokdevops《MCP at 90+ tools: the catalog breaks before the server does》(2026-10-04)中的平台化设计部分,做中文整理。
一、先说行业里没人测过的那部分
作者先做了一次文献调查:把 91 份资料每一篇都读完——21 份官方文档、28 篇厂商博客、20 篇独立博客、2 个论坛帖、20 篇论文。结论是"少而精"几乎是唯一建议:
- 38 份建议"精挑细选、少给工具";
- 22 份建议"通过搜索或延迟加载把可见工具集合压小";
- 8 份推荐 code mode(用一两个工具去执行代码);
- 没有任何一份建议把所有工具都暴露给模型。
其中 20 份给出了具体数字:5–8(Workato)、5–15(Phil Schmid)、每命名空间 <10、总数 <20(OpenAI)、10–20(Gemini、Speakeasy)、30–50(Claude 文档)、"40 是个拐点"(Archestra)——但 20 个数字里只有 3 个来自作者自己的测量。
两个流传最广的说法经不起溯源:
- "模型超过 30 个工具就会崩"——追溯回 RAG-MCP 论文,而那篇论文数的是提示词里的 MCP 服务器数量,不是工具数量;
- "Cursor 最多只接 40 个工具"——这条上限在 2026 年 1 月就已经取消。
91 份资料里,46 份是观点,8 份是转述别人的观点;37 份做了测量,但只有 10 份真正测量了"工具数量对准确率的影响":7 篇论文,加上 GitHub Copilot 的 40 → 13 个工具换来 +2–5 个百分点、LangChain,以及一个 1.7B 小模型的非正式测试。连"怎么分组"都是分裂的:15 份推荐工作流工具,15 份推荐分组工具,3 份推荐"一个操作一个工具"——而这 3 份的理由是权限提示,不是准确率。
二、实测方法:100 个假工具、18 个任务、3 个客户端
作者搭了一个假 MCP 服务器,里面有 100 个名字和 schema 都很真实的文件/文档工具,其中一些刻意做得极易混淆:
pdf_compress / pdf_optimize / image_compress
服务器还有两个变体:
- 分组变体:7 个工具覆盖原来 50 个操作;
- 模糊命名变体:同样的工具和描述,只把名字改成
optimize_file、optimize_document、process_image、combine_files、handle_pages。
关键设计:没有任何工具真的碰文件——服务器的调用日志就是裁判,记录每一步到底调了什么。任务集是 18 个有已知答案的任务(其中 10 个有歧义),分别在 N = 5、10 …… 50、75、100 个工具下各跑两次。三个客户端各用各的订阅:
| 客户端 | 模型 | 工具装载方式 |
|---|---|---|
| Claude Code | Opus 5.5 | tool search 开/关两种模式 |
| Codex CLI | GPT-6.1-sol | code mode |
| Antigravity | Gemini 3.1 Pro | names only |
所有原始数据(报告、results.csv、每次运行的原始日志)都公开在 GitHub:worklore/worklore-mcp/tree/main/research/tools-count。
三、5 到 100 个工具,准确率没有下降
在 5 到 100 个工具的所有运行里,每个客户端、每种模式下,准确率都是 100%——包括全部歧义任务,也包括 75–100 个工具时那 50 个多出来的近似工具。换句话说:在 Opus 5.5、GPT-6.1-sol、Gemini 3.1 Pro(2026 年 10 月)上,"工具越少越准"在这个区间里没有出现——这与文献调查里的提醒一致:性能退化高度依赖模型,小模型和旧模型才是需要警惕的地方。
作者还观察了 Claude Code 默认开启的 tool search:每一次运行都恰好先做一次 ToolSearch 调用,然后按精确名字选工具——模型在读到任何 schema 之前,先看到全部工具名,并仅凭名字在近似工具之间做选择。
四、真正的变量是成本:工具怎么进上下文
把所有运行(每种设置 36 次:18 任务 × 2 遍)的输入 token 平均下来,得到一张对比表(因为这些运行全部正确,所以表里只有成本差异):
| 客户端 | 工具如何到达模型 | 首次调用:5 / 50 / 100 个 | 每次运行:5 / 50 / 100 个 | 每多一个工具(首次 / 每次) |
|---|---|---|---|---|
| Claude Code(Opus 5.5),tool search 开(默认) | 只给名字,schema 按需用 ToolSearch 加载 |
3.9k / 4.6k / 5.4k | 13.8k / 17.4k / 19.9k | ~15 / 79 tokens |
| Claude Code,tool search 关 | 每次把全部完整 schema 放进提示词 | 4.1k / 11.7k / 20.2k | 9.3k / 27.9k / 48.6k | 169 / 429 tokens |
| Codex CLI(GPT-6.1-sol) | code mode:schema 从不进提示词,模型用代码搜索 | 13.2k(固定) | 45.3k / 61.4k / 78.2k | 0 / 408 tokens |
| Antigravity(Gemini 3.1 Pro) | 只给名字,schema 文件按需打开 | 3.8k / 4.1k / 4.3k | 15.7k / 20.5k / 18.6k | ~5 / 基本固定 |
几个反直觉的点:
- tool search 是 Claude Code 里真正的开关。它在默认开启时只把工具名放进提示词,schema 由一次
ToolSearch调用按需加载。在工具数低于约 19 个时,多出来的这次搜索调用让它更贵;超过之后开始省钱——100 个工具时每次运行省 59% 输入。但如果看按牌价的单次成本,100 个工具时"搜索开"是 $0.047,"搜索关"是 $0.038——因为缓存输入很便宜,而搜索多了一次调用。tool search 省的是上下文,不是钱。 - 作者自己踩的坑:他用的一个隔离 flag 顺手关掉了 tool search,导致第一版把"搜索关"的数字当成了常规数据来报告——一个 flag 就能让首次调用成本差 4 倍。
- Codex 的 code mode 首次调用成本是固定的 13.2k(schema 不进提示词),但每次运行随工具数增长最多(429 tokens/工具);Antigravity 则相反,每次运行基本平摊。
五、分组:在 Claude 里便宜,在 Gemini 里更贵也更差
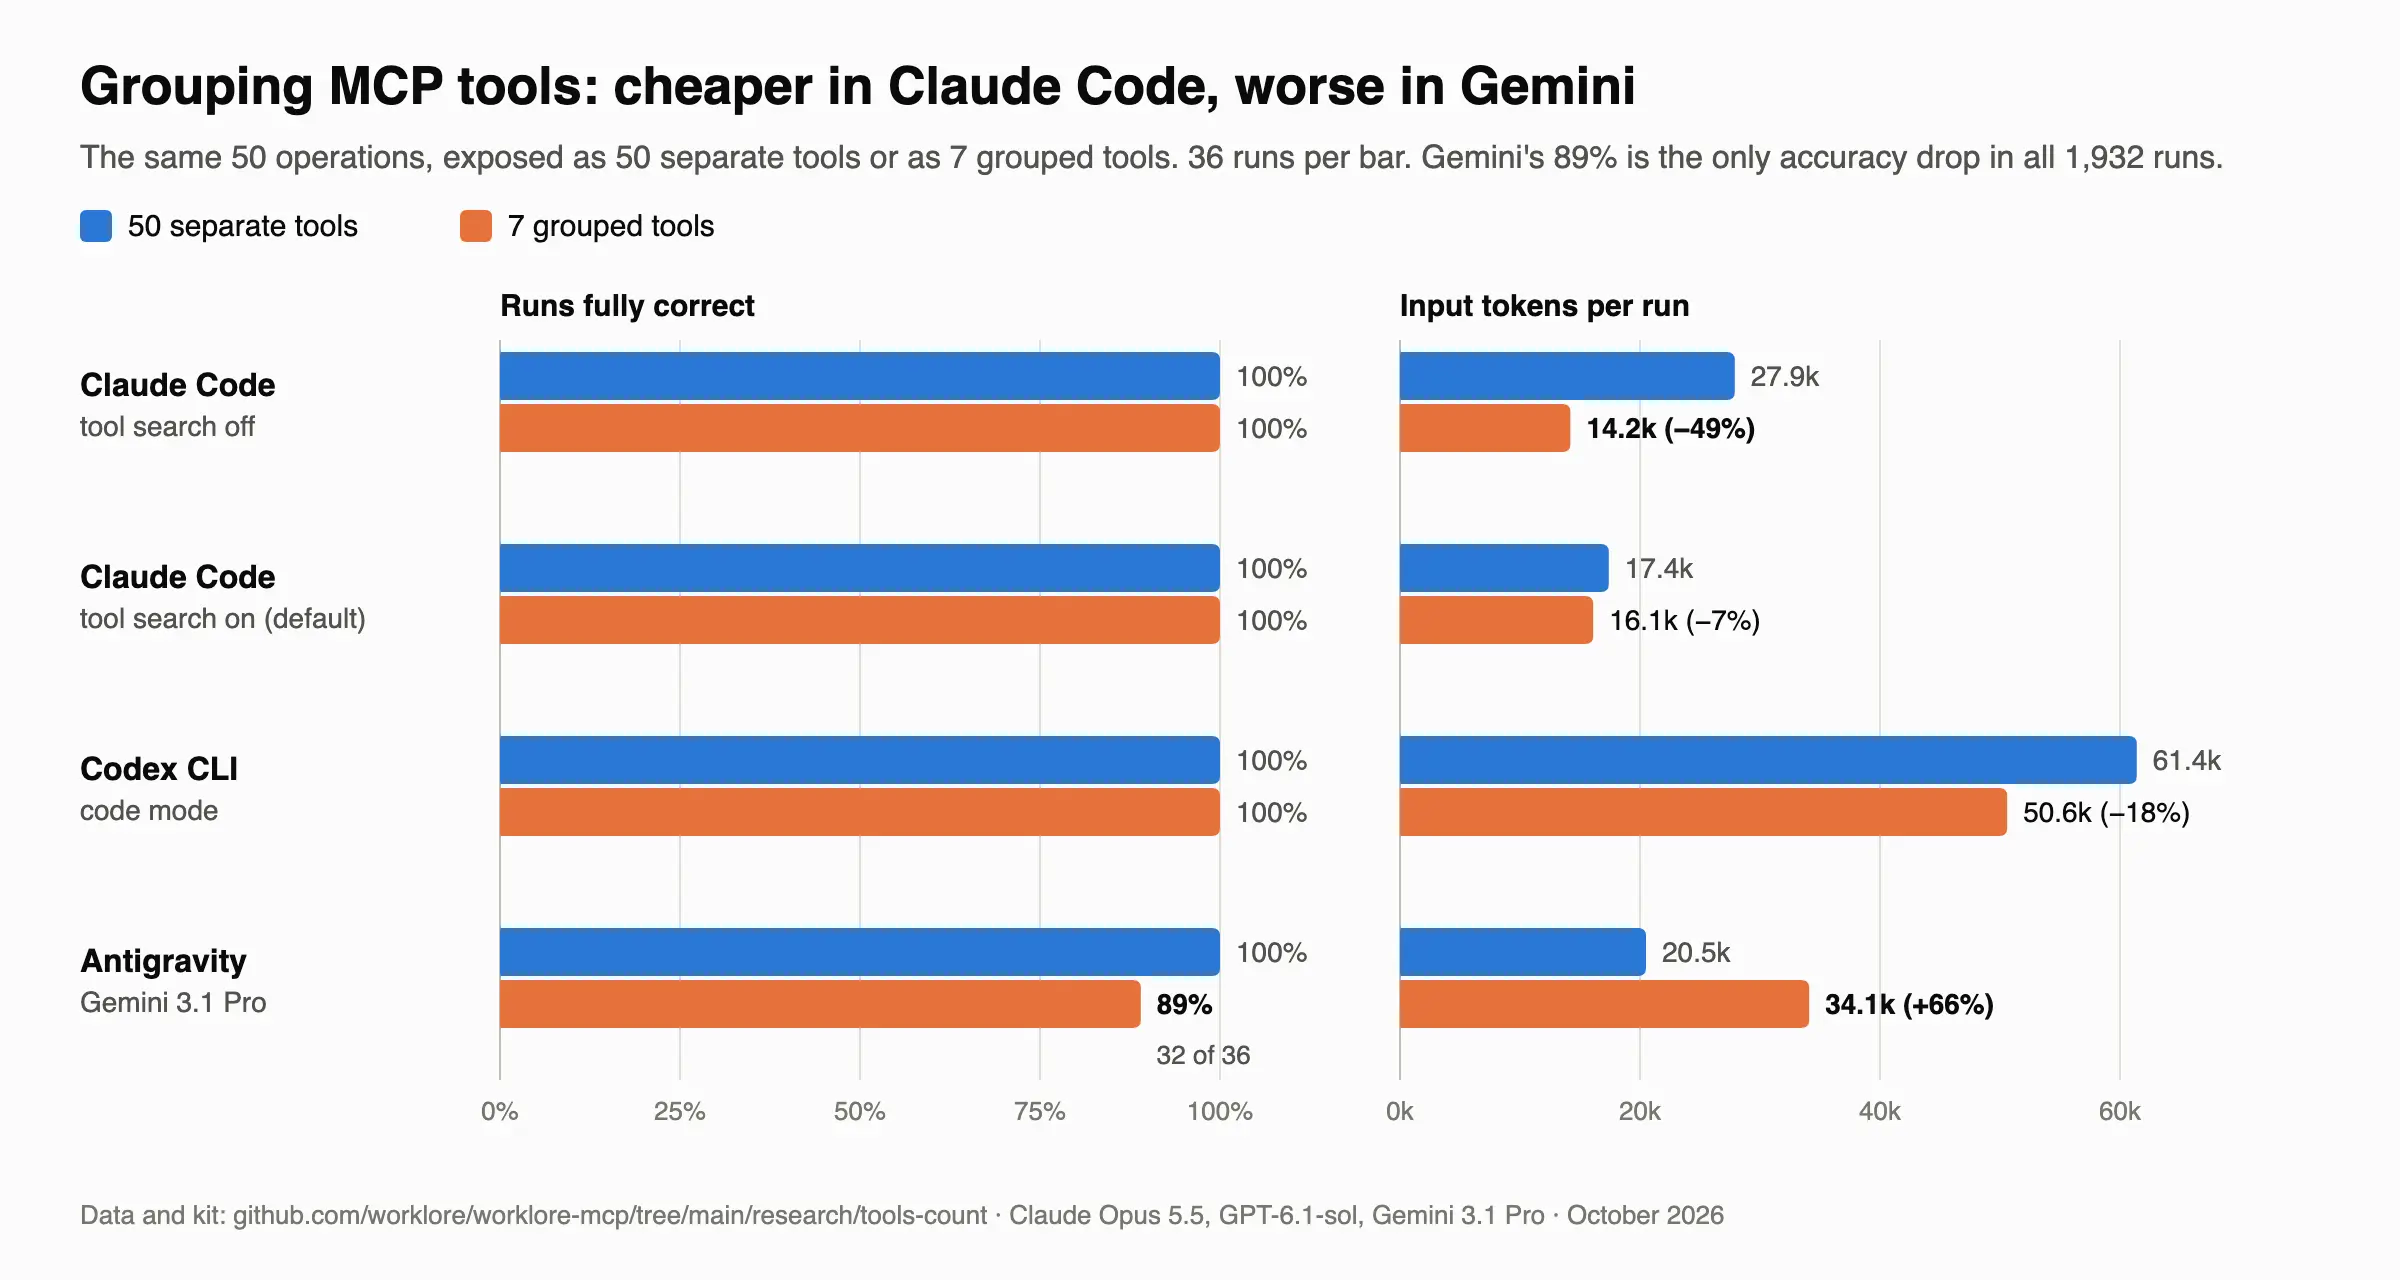
把同样的 50 个操作做成 7 个分组工具:
- 在全部 schema 都装载的 Claude Code(search off)里,7 个分组工具的成本约等于 14 个独立工具,准确率 100%;
- 在默认的 tool search 开启状态下,分组几乎没有意义:每次运行 16.1k vs 50 个独立工具的 17.4k(约省 7%);
- 分组只有在"每次都要加载全部 schema"的客户端里才划算。
而整个实验里唯一一次准确率下降就发生在这里:Antigravity(Gemini 3.1 Pro)掉到 89%(32/36)——Gemini 跳过了多操作工具 schema 的阅读,开始猜操作名(delete、help、fake_op),并且真的执行了错误的操作 3 次。
六、命名实验:模糊的名字不改准确率,改"找到答案的路径"
在模糊命名变体里(100 个工具、描述不变、名字改成上面那 5 个含糊动词):
- 准确率仍然是 276/276 全部正确,没有调错工具——描述决定了答案;
- 但在模型先看到名字的客户端里,名字决定路径:Claude Code(tool search 开)用诚实命名时,69/72 次直接加载到正确的 schema;换成模糊命名后只剩 7/72。它退化成关键词搜索,每次运行加载的 schema 数从 1.6 涨到 7.6(100 个工具时,最多的一次加载了 23 个),输入增加 21%;
- Gemini 在 34/72 次运行里先打开了错误工具的 schema,其中 10 次用空参数去试错工具。作者的服务器拒绝了这些空调用——但在真实服务器上,一个没有必填参数的工具可能真的会被执行。Gemini 的输入在 100 个工具时增加 38%;
- 反过来,在描述本来就全在提示词里的客户端(Claude search off、Codex 用代码搜定义),模糊命名几乎没有任何影响。
最容易误导的名字:"3 JPGs into one PDF" 会指向 combine_files——而它实际合并的是 PDF;"shrink a PNG" 会指向 optimize_image;pptx / docx 转 PDF 则在 convert_file 和 convert_document 之间混掉。
七、命名的硬约束:64 字符预算与点号
- 所有客户端都能调用的名字只能用字母、数字、
_、-,最长 64 个字符; - Claude API 拒绝点号,有些客户端会在本地重命名点号;
- 这 64 个字符是共享的:Claude Code 调用工具的形式是
mcp__<server>__<tool>——服务器名字太长,就会吃掉工具名的预算; - 另一个意外:Gemini 的 API 在某次"全量加载"运行里,拒绝了带整数枚举(integer enum)的 schema。
八、90+ 个工具时,崩的是目录不是服务器
另一篇工程实践把视角从"数量"抬到"平台":把一个内部工具暴露成 MCP 服务是周末项目,把 90 个工具同时暴露给人和 Agent,就是平台问题。作者给的定位是:把 MCP 服务器当成与 LLM 网关同族的"工具代理(tool broker)"——同一套身份规则(不用静态密钥)、同一套计量方式(每次调用都是一个事件)、同一套审计纪律;再多两件 LLM 网关不需要的东西:存放第三方凭据的信封和返回时的 PII 掩码。
可复用的规则:
- 按类别而非按工具组织目录:命名用
{category}.{verb}_{object}(如issues.create_ticket、ci.get_pipeline_logs);改名字是破坏性变更,要走弃用窗口; - 一个工具 = 一个权限单元 + 一个审计单元 + 一个测试单元。"什么都能干的工单工具"是给不出去的权限、读不懂的审计行、写不出的测试;
- 版本放在 schema 里而不是名字里(
issues.create_ticket@v2),弃用窗口内同时服务所有在用版本; - 授权的是"工具组"而不是整个宇宙:服务器对 94 个 schema 无感,客户端有感——一个把全部 schema 装进上下文的 Agent,光工具定义就能烧掉 30k+ token;
- 写操作要幂等键(重试的创建返回同一张工单,而不是两张);错误是契约的一部分(收敛成带
retryable标志的小分类,必要时给Retry-After);读便宜、写要响(写操作要最低角色 + 范围,审计事件带完整掩码输入,读只记形状);给每个列表设上界(默认limit=50、服务端上限 200、游标分页)——一个没有边界的列表工具就是一颗上下文炸弹; - 认证用 OAuth 2.1 + PKCE(IDE 和 Agent 运行时同样要 PKCE);token 的受众必须绑定 MCP 服务器;动态客户端注册不等于授权;用按工具组的 scope(
mcp:ci:read)让授权页可读;客户端 token 不要流向下游 SaaS; - 凭据用信封加密:KMS 里不出来的 KEK → 按类别的 DEK(AES-256)→ 值用 AES-256-GCM(每次写新 nonce);但真正的控制是除了 break-glass,没有任何角色能"读"密文——broker 只在一次调用内使用它,然后清零缓冲区,审计只记录调用与主体;
- 返回结果过一遍 PII 掩码(以及在写审计里存掩码后的输入),并且每个工具在目录里声明自己要哪种掩码。
九、可以照着做的清单
- 不要为了准确率在前沿模型上砍工具——但要为成本和上下文砍或延迟加载;
- 先搞清楚你用户用的客户端是"全量装载"还是"按需加载":同一个服务器,在 Claude 默认设置下是省 59% 输入,在 eager 装载下可能翻倍;
- 按"动作 + 对象"命名工具,不要用
process、handle、optimize这类万能动词——名字现在是模型读到的第一个信息; - 描述要写到"模型能互相区分":近似工具和模糊命名下,准确率靠的是描述;
- 不要凭直觉分组:在你用户实际使用的客户端里测过再决定;
- 量你自己的服务器——原始方法(报告、任务、日志)是可以直接复用的开源包。
原文作者自己列的局限同样要记住:工具是假的、只覆盖文件一个领域;只测了 3 个前沿模型;任务不涉及长推理;模糊命名只搭配了好描述;token 数包含客户端自身开销;部分规模没跑满;这只是一个时间点(2026 年 10 月)的快照。
来源
- @yahhi(Moein), How many tools should an MCP server have? I measured 5 to 100 in Claude Code, Codex and Gemini(dev.to,2026-10-14):https://dev.to/yahhi/how-many-tools-should-an-mcp-server-have-i-measured-5-to-100-in-claude-code-codex-and-gemini-3hap
- 原始数据与工具:https://github.com/worklore/worklore-mcp/tree/main/research/tools-count ;可复跑的故事页:https://worklore.dev/s/2026-10-07-benchmark-your-mcp-server-in-claude-code-codex-and-gemini-on
- @zerokdevops, MCP at 90+ tools: the catalog breaks before the server does(dev.to,2026-10-04):https://dev.to/zerokdevops/mcp-at-90-tools-the-catalog-breaks-before-the-server-does-3ibo
延伸阅读(本站)
- MCP 是什么?为什么它成了 AI 工具连接的标准
- 不是"有没有依据",而是"依据来自哪个源":MCP Agent 的来源感知验证
- 子代理、fork 与上下文折叠:Agent 交接的三种做法
- 专题:Agent / MCP / 自动化完全指南
本文由 汇智网 · Software 2.0 编译整理,转载请注明出处。 想系统了解 Agent / MCP 的上下文工程、评测与成本控制,见 Agent / MCP / 自动化完全指南。
这是「Agent / MCP」专题的一部分。完整地图见:Agent / MCP / 自动化完全指南