不是"有没有依据",而是"依据来自哪个源":MCP Agent 的来源感知验证
传统的忠实度检查(RAGAS / MiniCheck / AlignScore / SummaC)只问"证据池里有没有支撑";但 MCP Agent 会把搜索、病历、数据库、元数据的输出混在一起,于是"事实没错、来源错配"的 cross-source conflation 能轻松过关。ProvenanceGuard 保留来源身份贯穿整条流水线:专家判定应拦截的 139 条断言它拦下 138 条,来源选择准确率约 86%,在一项"来源调包"测试里 50 次全部检出。
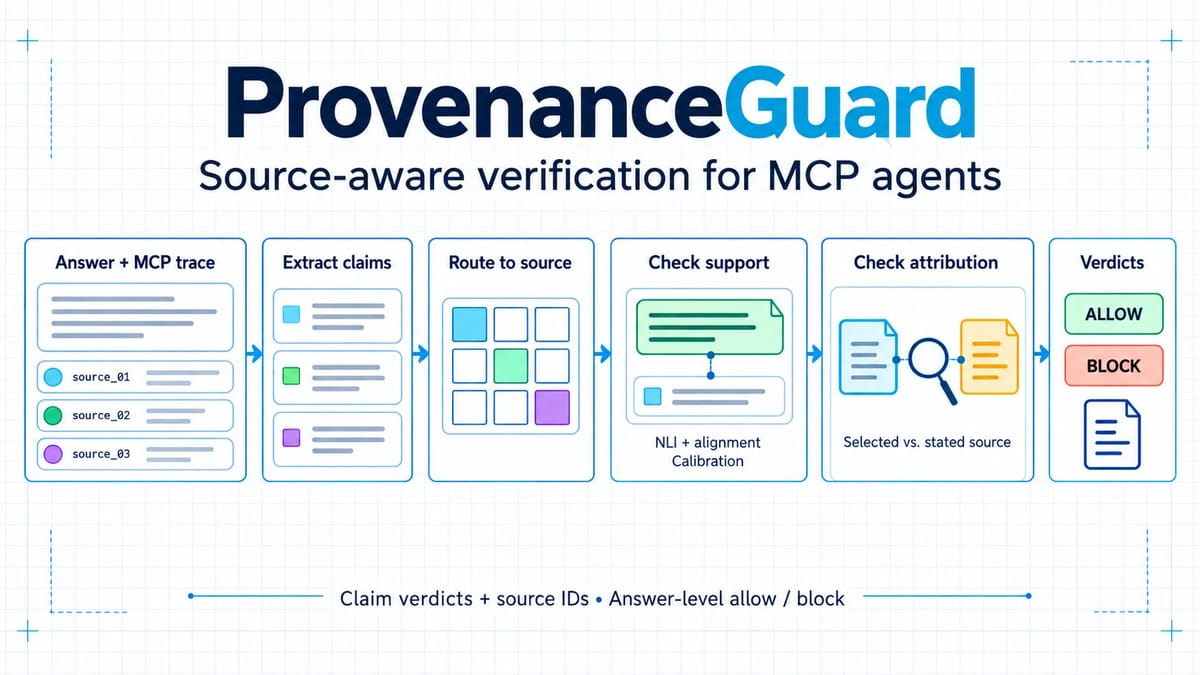
一句话结论:当 Agent 从"读一段检索结果"变成"通过 MCP 调多个工具"之后,事实性问题变得更微妙:一个断言在证据池里确实为真,却被归到了错误的来源上——Multiverse Computing 把它称为 cross-source conflation(跨来源混淆)。传统的忠实度/支撑度检查器把证据汇总(pool)后只问"有没有支撑",因此会放它过关。ProvenanceGuard 是一条生成后验证层:它把来源身份贯穿拆解、路由、支撑打分、归属核对与修复整条流水线,最终给出逐条断言的来源判定和整体放行/拦截。在医学 Agent 的 281 条真实轨迹上,专家认为应拦截的 139 条断言被它拦下 138 条。
本文完整编译自 Hugging Face 博客《Getting the Source Right, Not Just the Fact: Source-Aware Verification for MCP Agents》(2026-09-29,Multiverse Computing 团队),并做中文整理。
一、问题:"在某处有支撑"不等于"被正确的来源支撑"
使用工具的 LLM Agent 已经不再只读一段检索结果。通过 MCP(Model Context Protocol),一个 Agent 可以调用搜索工具、查看结构化的病历或账户记录、查询数据库、拉取元数据,然后把它们编进同一个答案。这让"事实性"这个老问题比看起来更微妙。
大多数用于检查 LLM 答案的系统——从 RAGAS 的 faithfulness 到 MiniCheck、AlignScore、SummaC 这类细粒度检查器——问的都是:当证据被汇总到一起之后,某个断言是否得到支撑。在它们的常规形态下,它们不会告诉你是哪一个 MCP 工具的输出支撑了每条断言,也不会告诉你那是否就是答案所声称的来源。
作者最新的论文《ProvenanceGuard: Source-Aware Factuality Verification for MCP-Based LLM Agents》(可在 Hugging Face 或 arXiv 阅读)瞄准的正是这个缺口。他们关心的失败模式叫作 cross-source conflation:一个断言在证据里某处为真,却被归因给了错误的来源。一个来源盲(source-blind)的验证器可能会放它过关,因为这个事实确实存在于那个池子里;而一个来源感知(source-aware)的验证器不应该。
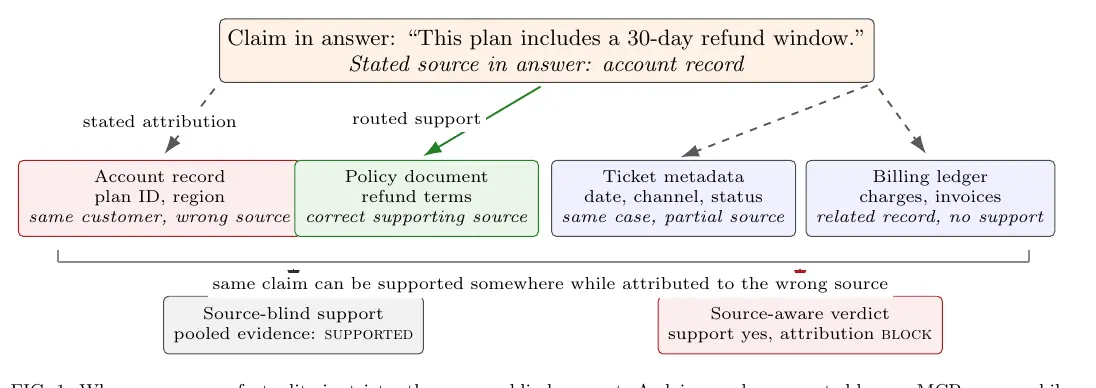
图 1:一条断言可能被一个 MCP 来源支撑,而答案却把它归给另一个。来源盲打分在汇总证据里看到了支撑,于是放行;ProvenanceGuard 会单独检查支撑来源是否与答案所述或暗示的来源一致。来源:论文 Figure 1。
一个客服场景
考虑一个客服 Agent 回答:"根据账户记录,这个套餐包含 30 天退款窗口。"退款窗口本身完全可能是真的,但它是写在政策文档里的,不是答案所指向的账户记录。把两者汇总到一起,这条断言看起来就有支撑;把它们分开看,归属就是错的——而在数据敏感的场景里,错误的归属可能和错误的事实一样有害。
同样的模式也出现在临床 Agent 里:一条从患者病史工具取来的、患者个体化的用药细节,一旦被答案呈现为"来自医学文献的发现",就会变得误导。
这就是为什么忠实度分数虽然有用,但对 MCP Agent 还不够。一个答案带有来源(provenance):有时是显式的("根据账户记录……"),有时是隐式的。ProvenanceGuard 要做的,是把"断言"与"来源"之间的这层连接保留下来,供人检查。
二、ProvenanceGuard 做什么
ProvenanceGuard 是一条生成后(post-generation)验证层,架在一个黑盒 MCP Agent 之上。它在 Agent 产出答案之后运行,绝不把证据塌缩成一个匿名的上下文;相反,它让来源身份贯穿整条流水线。它读取捕获到的 MCP 轨迹(包括工具输出及其来源 ID),无需重训 Agent。然后它按顺序做五件事:
- 拆解断言:把答案拆成一条条具体断言;
- 路由来源:为每条断言找到最相关的来源;
- 校验支撑:检查那个来源是否真的支撑该断言;
- 核对归属:把该来源与答案所述或暗示的来源做比较;
- 给出判定:输出逐条断言的来源判定,以及答案级的整体放行 / 拦截决定。
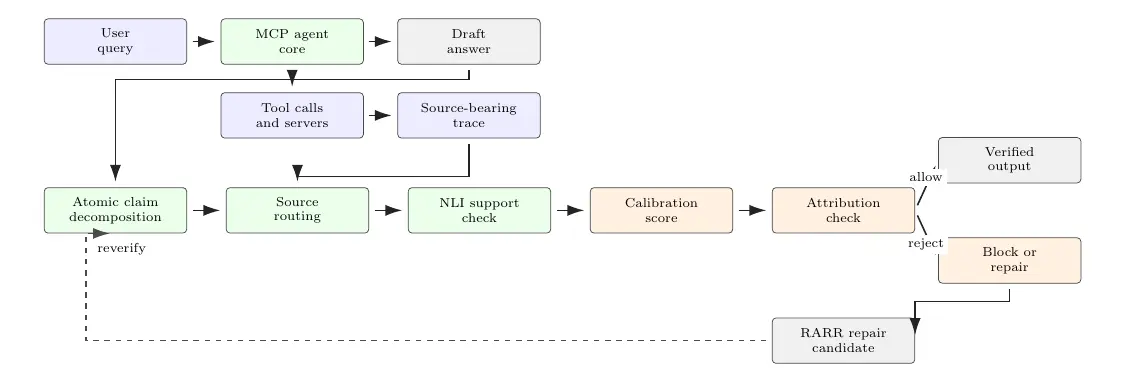
图 2:验证流程。来源身份在拆解、路由、支撑打分、归属核对与修复过程中被保留,而不是被汇总掉。被拦截的答案可以走 RARR 风格的修复并被再次验证。来源:论文 Figure 2。
有几个设计选择值得点出:
- 论文实验用本地模型,以便在受控、离线的环境里处理捕获到的轨迹:MiniLM 帮助找到相关来源,DeBERTa NLI 验证模型 检查该来源是否支撑断言,一个本地语言模型帮助把答案拆成断言;
- 验证器还会严格核对字面值:一个数字、日期或标识符如果在来源里不存在,就不能仅凭句子听起来合理而通过;
- 一个经过校准的决策步骤把这些信号合到一起;
- 如果答案被拦截,一个 RARR 风格的修复步骤会尝试有来源依据的改写或安全兜底,然后再次由验证器检查。
需要强调:上述模型是论文所评估的配置,而不是 ProvenanceGuard 的硬性要求。同样的"断言—来源—决策"步骤可以适配到团队更偏好的托管模型上,但新的配置需要各自做测试与校准。论文报告的结果来自本地配置;它偏保守的决策策略适合数据敏感的审阅——在那里,把来源弄对,比尽可能快地给出答案更重要。
三、实测结果
作者在一个医学 Agent 产出的答案上测试 ProvenanceGuard。该 Agent 用到了患者记录、研究文章以及其他工具,因此提供了 281 条真实轨迹可供研究。医学是很有用的测试场,因为来自患者记录的事实与来自通用研究的事实不能被视为同一个来源。只要一个 Agent 会记录它的工具输出与来源 ID,这套方法也能用在其他领域。
在主测试中,人工专家检查了从开发数据里留出的 40 个答案里的 361 条断言。最直接的结果是:
- 专家认为有 139 条断言不应通过,ProvenanceGuard 拦下了其中 138 条,只漏了 1 条;
- 它同时扣下了 67 条专家认为有支撑的断言,把它们送去复核或修复——这反映了所测试的谨慎设置:宁可让一些有支撑的断言多被看一遍,也不放过无支撑的;
- 对能识别出来源的断言,它在这项测试里约 86% 的时候选对了正确的来源。
作者还在同样的断言上跑了另外四个支撑检查器。在论文用来衡量"既能抓住应拦截的断言、又能避免不必要的拦截"的指标上,ProvenanceGuard 得分最高;而且对比里的其他检查器都不会告诉你是哪个工具输出支撑了每条断言——ProvenanceGuard 记录了这层连接,所以审阅者能看到每条断言检查了哪个来源、以及由此得出的决定。
| 验证器 | 拦截/拒绝 F1 | 是否输出"断言→来源 ID" |
|---|---|---|
| ProvenanceGuard(本文) | 0.802 | 是 |
| MiniCheck | 0.783 | 否 |
| RAGAS Faithfulness | 0.758 | 否 |
| AlignScore | 0.662 | 否 |
| SummaC-ZS | 0.436 | 否 |
表 1:在同一个留出断言包上的二分类支撑指标。ProvenanceGuard 在拦截能力上与来源盲基线持平或更好,同时还产出逐条断言的来源判定。来源:论文摘要与 Table III。
四、当多个来源"长得很像"
在一个更难的独立测试里,共有若干个相似来源,ProvenanceGuard 在"决定哪些断言该拦截"上拿到 0.846 F1,但精确识别出正确来源的比例只有 50.3%。区分相似来源仍然是一个重要的改进方向。
作者还做了一个聚焦错误归属的受控测试:在保持支撑证据不变的前提下,把 50 个案例里的具名来源改掉。结果 ProvenanceGuard 全部 50 次都抓到了。这说明它能发现明确的来源错误;而那个更难的多来源测试,则展示了在多个看似合理的来源之间做选择的挑战。
五、修复被拦截的答案
拦截只有在"拦截之后有事可做"时才有意义。 接入 RARR 风格的修复回路后:
- 在全轨迹(full-trace)运行中,173 条被拦截的答案全部被处理,不过其中 144 条最终落到兜底文本,而非实质改写——这是系统选择去避免一个无法验证的答案,而不是凭空造一个;
- 在重建的多来源测试轨迹上,一次新的修复运行把 59 条最初被拦截的答案全部处理,其中只有 2 条终态兜底;
- 作为离线闸门,开销不大:在论文报告的本地配置上,每条答案约半秒,其中 NLI 与路由调用本身只有几十毫秒。
六、为什么这契合 Multiverse Computing
当 Agent 从单段落 RAG 走向多工具 MCP,"一个事实究竟来自哪个来源"就不再是一个脚注,而成为"事实性"定义的一部分。ProvenanceGuard 把这层来源连接逐条断言地变得可见。对 Multiverse Computing 来说,这意味着一种既能检查现有 Agent、又能在需要时把敏感轨迹留在受控环境里的方式。医学研究只是其中一个用例;只要 Agent 的轨迹保留了它的工具与来源,同样的方法就可以被适配到别处。
这种适配已经出现了:NVIDIA NVFlow 合并了一个可选的 grounding 验证阶段给它的金融 Agent 使用——它把已完成的答案对照 Agent 检索到的 SEC 摘录进行检查,并单独保存判定,而不改动原始 rollout 或训练数据。NVFlow 的贡献采用了 ProvenanceGuard 的来源感知验证方法;而上文讨论的修复回路则属于更广泛的研究系统。
ProvenanceGuard 也在 UC Berkeley 的 Agentic AI Summit 2026 上以海报形式展示。
七、给 Agent 工程团队的启示
结合论文,几点判断值得记录:
- "忠实度"与"来源正确"是两件事:前者问证据池里有没有支撑,后者问支撑来自哪里。多工具 Agent 一旦被部署到金融、医疗、客服这类"来源本身就是语义"的场景,后者不能省;
- 验证要放在生成之后、且不能塌缩证据:把工具输出汇总成一段文本再做检查,恰恰会制造 cross-source conflation 赖以存在的土壤;
- 保守策略是特性,不是缺陷:它会让一部分有支撑的断言也被送去复核,但在数据敏感场景里,这个取舍通常是对的;
- 来源选择的难度远高于"拦不拦":在相似来源测试里,拦截判断 0.846 F1、但精确来源只有约一半——别指望它替你自动定责,把它当成给审阅者的放大器更现实;
- 修复回路要有兜底:全轨迹运行中大部分拦截最终走了兜底而非改写,这本身是一个诚实的信号——宁可说不确定,也不要编一个无法验证的答案。
对正在把 Agent 接进企业系统的人来说,这篇工作的核心可以浓缩成一句话:当 Agent 的证据来自多个工具时,"它说得对吗"必须变成"它说得对,而且用的是对的那个源吗"。
参考来源
- Hugging Face / Multiverse Computing:《Getting the Source Right, Not Just the Fact: Source-Aware Verification for MCP Agents》(2026-09-29)https://huggingface.co/blog/MultiverseComputingCAI/getting-the-source-right-not-just-the-fact-source
- 论文(arXiv):https://arxiv.org/abs/2606.18037
- 论文(Hugging Face Papers):https://huggingface.co/papers/2606.18037
- RARR(修复式改写):https://arxiv.org/abs/2210.08726
- NVIDIA NVFlow 集成 PR:https://github.com/NVIDIA/nvflow/pull/9
- Agentic AI Summit 2026 海报:https://github.com/aalvsz/provenanceguard
延伸阅读(本站)
- Agent / MCP / 自动化完全指南
- 什么是 MCP(Model Context Protocol)
- AI 智能体的验证器
- 智能体说"搞定了",数据库不同意
- RAG / 数据 / 文档智能完全指南
- 6 步把 RAG 幻觉率降到 1%
本文由 汇智网 · Software 2.0 编译整理,转载请注明出处。