AI 爬虫流量:11 个问答分清爬取、引荐与转化
AI 爬虫不是噪音,往往意味着刚有人向 AI 问起你。11 个问答讲清爬取流量与引荐流量怎么识别、分段和衡量。
一句话结论:AI 爬虫流量不是该被过滤掉的"噪音",它往往意味着刚刚有一个真人向 AI 问起了你的品牌、产品或品类。但它和"从 AI 回答里点进来的人"是两回事:前者说明 AI 在读你什么,后者说明谁真的转化。把两者合成一个"AI 流量"数字,是大多数团队测错的第一步。
披露:本文完整编译自 Scrunch 内容负责人 Eric Wendt 于 2026-05-18 发布的《Your AI bot traffic questions, answered》。Scrunch 是 AI 搜索监测厂商,原文是面向客户的问答合集,文中涉及的产品能力与效果均属厂商说法,我们无法独立验证;平台名单、界面与套餐也会变。译文保留了全部 11 个问答的要点,并在最后补上"不买工具怎么自建"和截至 2026-10 的进展。配图为原文截图。
原文的三条结论
- AI 爬虫流量不是垃圾。它常常是高意图信号:有人刚在 AI 里问过你的品牌或品类,AI 才来你站点取答案。测得对,它是最有价值的受众之一。
- 爬虫流量和引荐流量回答两个不同问题。爬虫访问告诉你 AI 在消费你站点的什么内容;引荐流量告诉你谁真的从 AI 回答里点进来并转化。
- 标准分析工具不是为 AI agent 准备的。专门做 AI 流量识别的工具,是目前把信号从噪声里分出来、并且能马上行动的最可靠方式——这条是厂商的结论,后文我们会给出自建方案能走到哪一步。
原文的素材来自三处:翻遍销售通话记录、扫了客服机器人的日志、再问了销售、支持和客户成功团队。下面这 11 个问题,是反复出现的那批。
一、怎么发现 AI 爬虫在访问我的站?
短答:AI 爬虫会在 user agent 里表明身份,所以从服务器日志里理论上抓得到。但规模一大,手工识别很快就崩,原文的建议是用工具把整个过程自动化。
长答:多数 AI 平台派出的爬虫有可识别的 UA:OpenAI 的 GPTBot、Anthropic 的 ClaudeBot、Perplexity 的 PerplexityBot,等等。理论上,解析服务器日志,或者在分析工具里按 UA 过滤,就能把它们找出来。
实践中这条路有问题。把几百上千个页面、几十种 bot 的访问拼成一张完整的图,正是那种"别的事情一多就被无限期推迟"的活。Scrunch 的 Agent Traffic 功能就是替你做这件事:实时识别并校验 AI bot 访问,然后在一个视图里给出趋势、bot 类型分布、真人 vs 爬虫的时间曲线、Top bot、Top 页面和最近的 bot 请求。结果是不用维护表格,也能看清 AI 爬虫的活动。
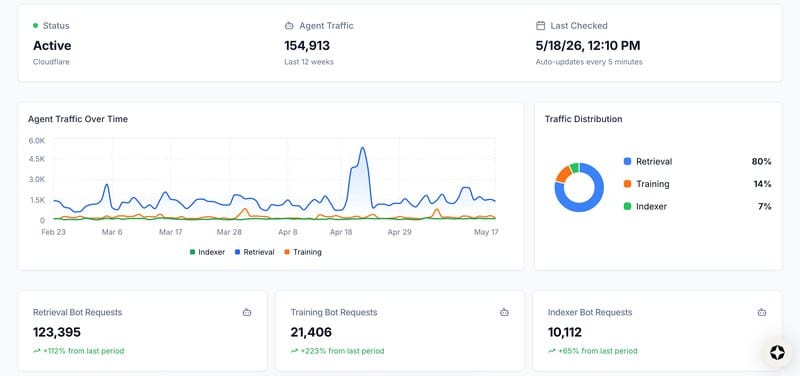
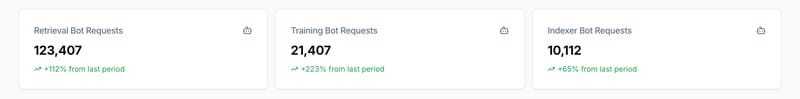
原文示例:Agent Traffic 总览。除总量外,还按用途拆成检索、训练、索引三类。来源:Scrunch。
二、哪些 AI 平台送来的爬虫最多?
短答:手工做法是在日志里分析,或按平台过滤;工具做法是直接看平台拆分。
长答:不同 AI 平台用不同的 bot,行为也不一样。ChatGPT 的 bot 可能一天来你站点几十次,而 Perplexity 几乎看不见;反过来也成立。知道这个分布,才能判断你的内容到底在哪里被消费。
手工做意味着解析日志、把 UA 映射到平台、再按时间聚合——能做,但又琐碎又耗时。Scrunch 的 Agent Traffic 直接按平台拆(OpenAI、Perplexity、Google 等),一眼就能看出你的 AI 足迹在哪里最强、在哪里几乎不存在。
平台级视图的真正价值,是帮你问出战略问题:
- 某个 AI bot 频繁来爬,但你在它的回答里从不出现——这是内容问题,不是抓取问题;
- 某个平台根本不爬你——这是另一个问题,需要另一种修法。
这两句话值得单独记住。很多团队把"AI 不引用我"和"AI 不爬我"混为一谈,然后去改错的东西。
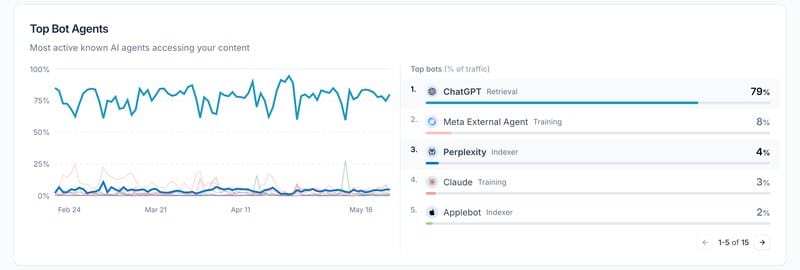
原文示例:Top bot 的平台与用途拆分。来源:Scrunch。
三、哪些页面被 AI 爬得最多?
短答:可以从服务器日志里自己数,也可以让专门平台给出全站页面级、按访问量排序的拆分。
长答:bot 访问不是均匀分布的。AI 的 UA 往哪些页面跑,既说明用户在问什么,也说明你站点上哪些页面被 bot 认为最相关。
这件事有三个用处。
第一,它告诉你 AI 认为你品类里什么内容相关。 某个产品页被反复访问,另一个门可罗雀,这个差异本身值得查。
第二,它帮你排优化优先级。 AI agent 来得最多的页面,才是"小改内容或技术"最可能有大回报的地方。
第三,它暴露缺口。 你预期会有 AI 流量、实际却没有的页面,可能存在访问问题、内容问题或挡住 AI 的结构性障碍。
Scrunch 会自动把这些摊开,让你快速看到 AI 的注意力集中在哪里、明显的盲区又在哪里。
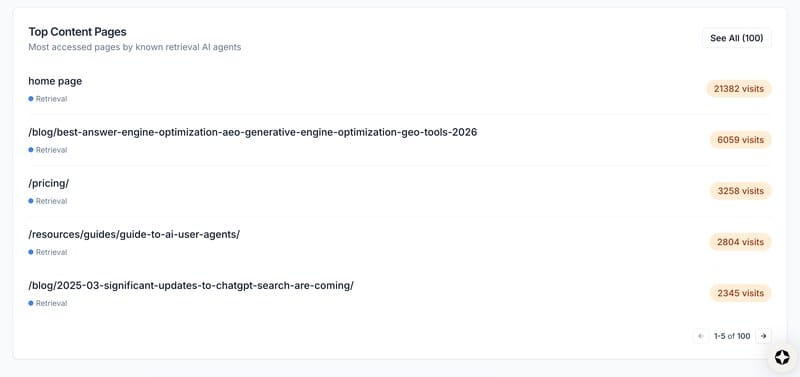
原文示例:Top Content Pages,按 retrieval agent 的访问量排序。来源:Scrunch。
四、AI 流量该怎么分段:按模型、按爬虫用途,还是别的?
短答:两种都值得分——按平台/模型,也按 bot 的用途。不同分段回答的是不同问题。
长答:最好的分法取决于你想知道什么。原文给了四个有用的镜头:
- 按平台:哪个 AI 平台爬你最多,平台之间的行为差在哪?适合判断内容在哪儿被消费、注意力该往哪儿投。
- 按 bot 用途:有的 bot 在训练模型,有的在索引内容,有的在做实时检索。实时检索类直接对应"此刻有一个真人正在提问",是最可行动的信号。
- 按页面:哪些页面被关注得最多,分别来自哪些 bot?这能看出哪些内容在扛事、哪些需要补。
- 按时间:AI 活动在几天、几周、几个月里怎么变?尖峰可能对应模型更新、新闻周期,或你自己改过的内容。
Scrunch 声称这四种分段都是原生支持,按平台、bot 类型、页面和时间范围看数据,不用导出到表格。
原文示例:同一批访问按不同维度切分。来源:Scrunch。
一个翻译上的提醒:"按用途分段"比"按平台分段"更接近可行动的信息。平台只说明"谁来了",用途才说明"它为什么来、这次访问离真人有多近"。
五、AI 搜索到底有没有给我带流量?
短答:可以用 GA4、HubSpot 这类工具去追与会话来源相关的 session,也可以让专门的工具把数据直接摊出来。
长答:AI 引荐流量——真人从 AI 回答里点进你网站——比爬虫流量难追,因为 AI 平台的 referrer header 并不总是稳定。
GA4 之类的工具能抓到一部分,但数据可能不完整或被归错类。比如 ChatGPT 来的访问,可能落进 "direct" 或 "other" 桶里,完全看不出它来自一次 AI 回答。
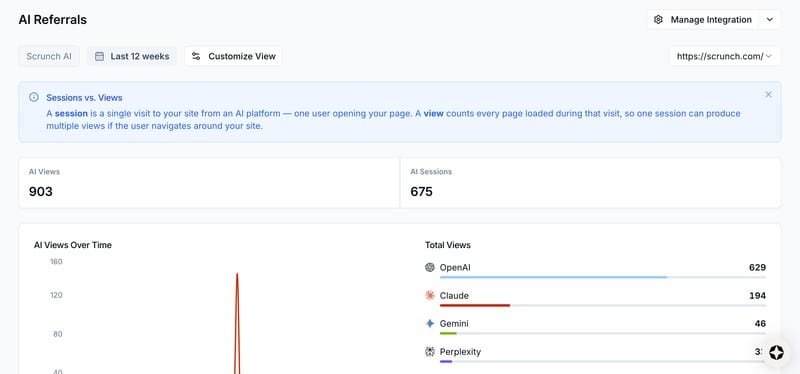
Scrunch 的 AI Referrals 声称能补上这些缺口:即使标准分析工具漏掉,它也能识别来自 AI 平台的流量;展示口径可以按浏览量、会话、交易、收入自定义,时间范围随意选。也可以按不同的筛选路径看数据,方便聚焦"哪些页面从 AI 拿到了最多真人流量"。
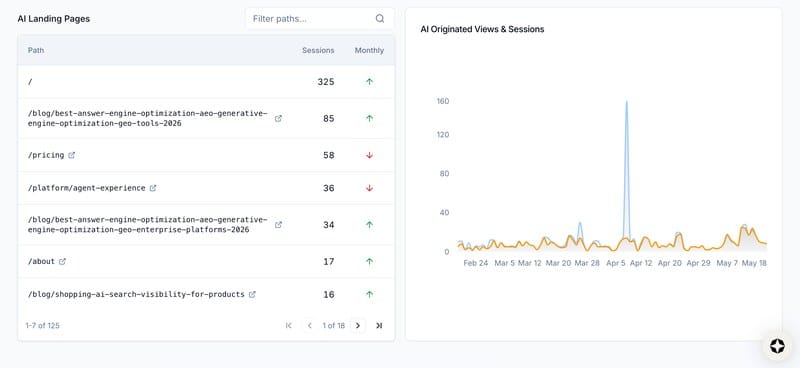
原文示例:AI Referrals 的会话与来源拆分。来源:Scrunch。
六、AI 引荐流量怎么长期跟踪变化?
短答:固定测量窗口、固定 KPI 集合,然后看周环比、月环比。纵向视图是专门工具的长项。
长答:相比传统自然搜索,AI 带来的引荐流量很可能只是饼上很小的一块。正因为它小,才更值得看它是怎么涨、怎么跌的。
Scrunch 的 AI Referrals 就是围绕这个设计的:自定义时间范围并对比——最近 30 天 vs 前 30 天、本季度 vs 上季度、一次优化上线后的一个月 vs 上线前一个月。
真实趋势以周为单位显现,不是以天为单位。 日粒度的数字往往太小,单看没有意义。浏览量、会话、交易、收入这些筛选条件要在各个窗口之间保持一致,才是拿同一个东西比同一个东西。
这样反馈闭环才成立:你改了一版内容、拿到一个第三方引用、修了一个技术问题,就能看到之后几周里,对应 AI 平台的引荐流量到底涨没涨。时间一长,规律会累积起来——哪些动作有用、哪些没用、下一次力气该往哪儿使。
原文示例:跨时间窗口对比。来源:Scrunch。
七、AI 流量为什么要和传统自然流量分开算?
短答:因为 AI 流量主体是 bot 而不是人,参照系和传统 SEO 不一样。有意义的 KPI 是:爬虫访问量、按爬虫访问排的 Top 页面、下游引荐流量。
长答:传统自然流量的测量,是围绕"人从搜索结果页点链接"建的。会话、跳出率、页面停留时间、转化——全都假设另一端是人。AI 流量不是这样。
你站点上由 AI 带来的活动,大头是 bot 活动,不是人的活动。AI agent 访问页面,是为了给一个在 AI 界面里返回给用户的答案收集信息,很多时候根本不会产生点击。
这就改变了"什么重要":
- AI 爬虫访问量告诉你站点拿到了多少 AI 注意力;
- 按爬虫访问排的 Top 页面告诉你 AI 认为什么相关(也就是人们在问什么);
- AI 引荐流量虽然少,但转化率往往高于传统自然流量,因为用户在点进来之前已经把功课做完了。
跟踪 AI 流量需要一次思路切换:AI 搜索基本是一个零点击渠道,bot 活动是它的先行指标。 按这个前提去设计测量,策略会清楚很多。
原文示例:把 AI 侧指标单独成面板。来源:Scrunch。
八、团队一般怎么把真人和 AI 爬虫分开?
短答:历史上 bot 流量被当作噪声,过滤掉就忘。但 AI agent 已经占到网站访问里不可忽视、且仍在增长的一块,这个习惯正在让团队损失真正的情报。做得早的团队,会把 AI 和真人分成两个视图看。
长答:互联网大部分历史里,标准打法是:识别 bot、从分析里排除、只分析剩下的人。bot 是垃圾、是爬内容的、是为排名来索引页面的。它们不告诉你任何关于买家的信息,所以也不值得分析。
这套逻辑现在不成立了。
AI bot 流量不是通用爬取。当 ChatGPT、Perplexity 或 Gemini 派 bot 来你站点,常常是因为刚刚有一个真人问过 AI 关于你品牌、产品或品类的问题。bot 是在为一条即将返回给买家的答案收集信息。那不是噪声,是高意图信号。
做得靠前的团队做两件事:
- 过滤:识别已知的 AI user agent,把它们当作一个独立受众来分析。
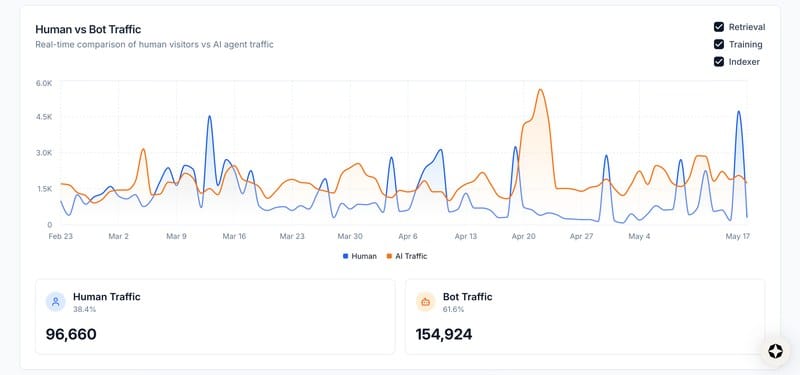
- 分段:识别 bot 类型,判断它是训练、索引还是检索。Scrunch 的 Agent Traffic 声称能实时识别并校验 AI bot,把它们作为独立于真人分析的数据流呈现,并给出量级、平台、bot 类型和页面上下文。
原文的立场很直接:先动这件事的团队,对 AI 驱动的需求会看得更清楚;继续把 bot 流量当垃圾的团队,会慢一步。
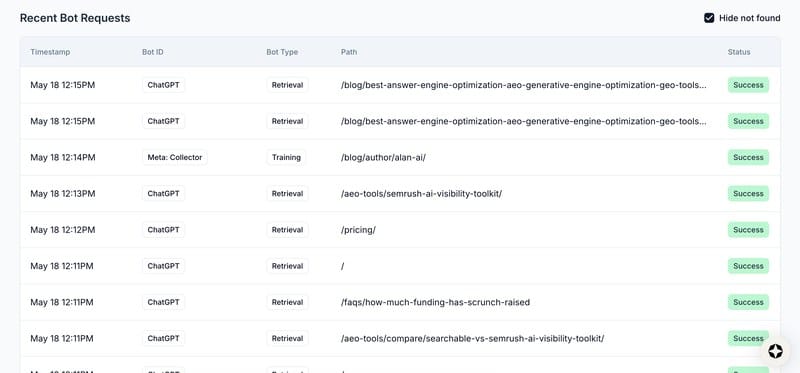
原文示例:真人流量与 AI 爬虫流量分线对比。来源:Scrunch。
九、Scrunch 现在覆盖哪些 AI 平台?
短答:原文列的名单是 ChatGPT、Perplexity、Gemini、Claude、Google AI Mode、Google AI Overviews、Grok、Copilot 和 Meta。新平台按用户使用量和客户需求增加。
长答:AI bot 识别是一个移动靶,跟上新平台、新模型本身就是一份工作。Scrunch 维护主流 AI 平台 bot 的覆盖,并在平台改规则时更新识别逻辑。
这项持续维护,是客户选择 Scrunch、而不是自建一套 bot 识别程序的主要原因之一。不是"基本识别"做不到,而是长期保持最新、还要规模化,做起来会让人怀疑人生。
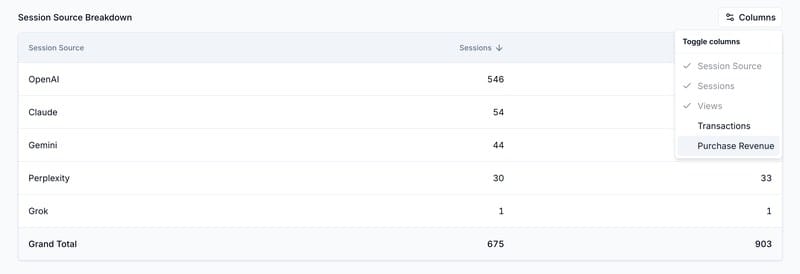
原文示例:平台覆盖与 Top bot。来源:Scrunch。
十、它和 GA4、服务器日志有什么不同?
短答:GA4 不是为 AI bot 建的,服务器日志则需要大量手工分析;Scrunch 是专门为 AI 流量检测做的,并且开箱就把数据摆成可行动的样子。
长答:GA4 是为真人流量建的,这意味着大量 AI 活动可能根本不出现。就算抓到了,那些仪表盘也不是为 AI 流量的关键指标设计的——按 bot 的量、页面级活动、平台拆分等等。
服务器日志有原始数据,但要把原始数据变成有用的东西,需要解析、IP 校验、把 UA 映射到平台、跨几千条请求聚合、再做可视化。可行,但这是一个大项目。
Scrunch 是从底层为 AI bot 建的:直接连你的 CDN 或托管服务商(Cloudflare、Akamai、Vercel、WordPress 等),实时监测 AI bot 的爬取。这样能抓到那些不触发 pageview、因而在 GA4 里常常不出现的 bot 访问。它识别并校验访问、按平台和用途分类、归因到具体页面,再把数据组织成围绕团队真正要回答的问题的仪表盘。
多数团队面对的是"自建还是购买"的取舍。技术深的团队自建一套有意义的 AI 流量分析是做得到的,但维护负担会快速累积。Scrunch 是那个开箱即用的选项。
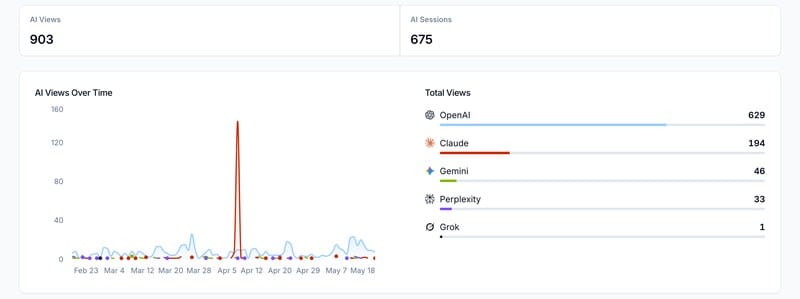
原文示例:从 CDN / 托管侧采集爬虫访问。来源:Scrunch。
十一、爬虫流量和引荐流量能分开吗?
短答:能,而且必须分开。它们是两条独立的数据流:一条来自 CDN 或托管服务商,一条来自网站分析,因为它们回答的是关于你 AI 存在的两个不同问题。
长答:爬虫流量是 AI bot 来你站点为答案收集信息;引荐流量是真人从 AI 回答里点进你的站点。两者都重要,但说的不是一件事。
- 爬虫流量是上游信号。 一个页面 bot 活动高,说明页面与用户查询相关,AI 在关注它。长期跟踪爬虫活动,可以提前判断你的内容在 AI 眼里是变得更相关还是更不相关。
- 引荐流量是下游信号。 AI 引用了你,用户读完回答,想了解更多,点了进来。这类访客比传统自然流量更稀少,但转化率往往更高,因为他们已经在 AI 界面里做完了大部分评估。
Scrunch 把两者分开追踪:Agent Traffic 从 CDN 或托管侧抓爬虫活动(量级、平台、Top 页面等),AI 引荐追踪从 GA4 这类网站分析里抓由 AI 回答带来的人类点击。并排看,才能把"AI 在消费什么"和"什么真正带来了业务结果"接起来。
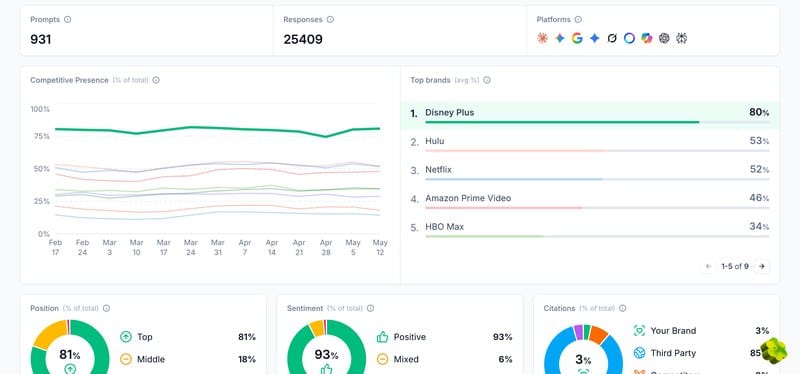
原文示例:爬虫数据流与引荐数据流并排。来源:Scrunch。
一张表:两类流量,别混着算
| 维度 | 爬虫流量(Agent Traffic) | 引荐流量(AI Referrals) |
|---|---|---|
| 谁在访问 | AI 的爬虫 / agent | 真人 |
| 数据从哪来 | CDN、源站或服务器日志 | 浏览器 referrer、GA4 |
| 回答什么问题 | AI 在读你什么、读了多少 | 谁从 AI 回答点进来、有没有转化 |
| 典型信号 | GPTBot、ClaudeBot、PerplexityBot 等 UA,按页面/平台聚合 |
referrer 命中 chatgpt.com、perplexity.ai、gemini.google.com 等 |
| 主要误差 | UA 可以伪造,日志只看到"自称是谁" | referrer 经常丢失,被归进 direct / other |
| 怎么用 | 判断内容相关性、排优化优先级、发现抓取障碍 | 判断渠道价值、做转化归因 |
十二、不买工具:用 nginx 日志能做到哪一步
原文的答案基本是"买工具"。它的框架是对的,但前半段完全可以用服务器日志自己实现。下面五步不依赖任何 SaaS,先把基线量出来——没有基线,后面所有优化都无从判断。
第一步,固化一份 UA 名单。 先把主流 AI 爬虫和实时抓取 UA 列成一张表,例如 GPTBot、OAI-SearchBot、ChatGPT-User、ClaudeBot、Claude-User、PerplexityBot、Perplexity-User、Google-Extended、Applebot-Extended、Bytespider、CCBot。新平台会不断出现,这张表要按季度复核。
第二步,切出爬虫请求。 在日志服务器上直接跑:
# 各 AI UA 的请求量
grep -aoiE 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|PerplexityBot|Perplexity-User|Google-Extended|Applebot-Extended|Bytespider|CCBot' access.log \
  | sort | uniq -c | sort -rn

# 被爬最多的 20 个路径
grep -aiE 'GPTBot|ClaudeBot|PerplexityBot' access.log \
  | grep -oE '"(GET|HEAD) [^ ]+' | awk '{print $2}' | sort | uniq -c | sort -rn | head -20
第三步,按平台和页面聚合。 UA 到平台的映射写成一张静态表(GPTBot → OpenAI,ClaudeBot → Anthropic,PerplexityBot → Perplexity……),再按"平台 × 页面 × 天"汇总。到这一步,你已经能回答原文第二、第三个问题。
第四步,单独标出 AI 引荐。 用 referrer 匹配 AI 域名:
grep -aiE 'https?://(chatgpt\.com|chat\.openai\.com|perplexity\.ai|gemini\.google\.com|copilot\.microsoft\.com|claude\.ai)' access.log | wc -l
注意这只是一个下限:referrer 丢失、被裁剪、被隐私策略处理过的访问都不会出现在这里。把它当成"至少有多少",而不是"一共有多少"。
第五步,和业务结果对账。 把引荐 landing page 与表单、注册、下载、询盘记录对上,才能判断哪类 AI 引荐真的带来了结果。UTM 只能覆盖愿意配合的平台,别指望它补齐全部。
自建和买工具的差别,大致是这样:
| 能力 | nginx 日志自建 | 专用工具 |
|---|---|---|
| UA 识别 | 能做,名单自己维护 | 厂商维护并更新 |
| 平台 / 用途归类 | 靠 UA 关键词,较粗 | 通常有分类模型 |
| 页面级排行 | 能做 | 能做 |
| 引荐归因 | 只能看 referrer,丢失即无 | 声称可补充归因 |
| 真人 vs 爬虫对比 | 能做(日志需含 UA 与状态码) | 自带面板与图表 |
| 验证爬虫真伪 | 难(要反查 IP / 官方列表) | 声称可实时校验 |
| 成本 | 服务器上跑脚本 | 订阅费 |
十三、截至 2026-10:这半年变了什么
原文写于 2026 年 5 月。之后这半年,AI 流量的问题从"要不要看"推进到了"拦不拦、收不收费":
- 收费从概念变成产品。 Cloudflare 在 2025 年 7 月推出 pay-per-crawl,让内容方可以按 AI 爬虫的抓取次数收费;AWS WAF 也增加了 AI 流量变现能力(基于 HTTP 402 的付费访问)。
- robots.txt 仍然只是自愿协议。 它的法律效力在个案里被检验(如 Ziff Davis v. OpenAI),但技术上它拦不住不遵守的爬虫。TollBit 的统计里,相当比例的
ChatGPT-User请求并不读 robots.txt。 - "伪造的 AI 流量"开始污染报表。 我们编译过的另一个案例里,一位博主的日读从 600 涨到 2,800,查下来 91% 的会话没有 referrer、浏览器一栏写着 BlackBerry、平均停留 0.1 分钟;AWS WAF 的 AI 活动面板显示 103.47K bot / 59.65K AI bot,其中只有 30.9% 通过验证。拦截后阅读下降 29%、平均时长上升 70%。
所以原文的"爬虫 / 引荐"二分法没有过时,它仍然是正确的起点。只是今天多了一步:先分清,再决定是优化、拦截,还是收费。
相关阅读:AI 基建 / 评测 / 安全完全指南 | AI 爬虫冒充读者:近 5 倍流量暴涨的取证与 AWS WAF 拦截 | Agent 成本体检:上下文预算与提示缓存
十四、边界
- 这是厂商内容。 原文来自 Scrunch,产品能力、界面与"实时校验"效果都是厂商自述,本文没有做独立测试。译文保留原意,不等于背书。
- 示例数字不是基准。 154,913 次访问、80% retrieval、675 个引荐会话,都是 Scrunch 自己客户面板里的截图;换一个站点、换一个时间窗口,结论可能完全不同。
- UA 是"自称"。 日志里写着
GPTBot不代表一定是 OpenAI;伪造 UA 的成本极低。要更硬的身份判断,需要 IP 反查或平台公布的 IP 段。 - GA4 会低估 AI 引荐。 referrer 丢失、AI 客户端内置浏览器、Google AI Overviews 的点击仍以
google.com为来源——这些都会让 AI 引荐被算进 direct / organic / other。方向是"实际比报表更多",不是更少。 - 爬取量不等于排名或引用。 爬虫来得多,只能说明 AI 在关注;它是否引用你、引用得对不对,是另一个要单独测的问题。
- 合规边界。 监测是一回事,拦截和收费是另一回事。robots.txt、平台条款、版权与合同约定都要看;不要因为"能拦"就越过法律与商业约定。
Sources
- Eric Wendt, Your AI bot traffic questions, answered, Scrunch, 2026-05-18:https://scrunch.com/blog/ai-bot-traffic-questions-answered
- Scrunch, Agent Traffic:https://scrunch.com/platform/agent-traffic/
- Cloudflare, Introducing pay per crawl:https://blog.cloudflare.com/introducing-pay-per-crawl/
- AWS, How to manage AI bots with AWS WAF and enhance security:https://aws.amazon.com/blogs/networking-and-content-delivery/how-to-manage-ai-bots-with-aws-waf-and-enhance-security/
- 本站,AI 爬虫冒充读者:近 5 倍流量暴涨的取证与 AWS WAF 拦截:https://www.hubwiz.com/blog/ai-bot-traffic-forensics-aws-waf/
本文由 hubwiz 编译整理,转载请注明出处。
这是「AI 基建 / 评测 / 安全」专题的一部分。完整地图见:AI 基建 / 评测 / 安全完全指南