AI 爬虫冒充读者:近 5 倍流量暴涨的取证与 AWS WAF 拦截
一次近 5 倍的流量暴涨,91% 会话无来源。作者用 WAF 面板揪出 69% 匿名 AI 爬虫,再用 CloudFront 分类拦截。
一句话结论:流量暴涨不一定是好事。作者的博客日读从约 600 跳到近 2,800,查下来 91% 的会话没有来源、浏览器一栏写着 BlackBerry、平均停留 0.1 分钟——花几天在 Google Analytics 4、AWS WAF 和 CloudFront 控制台里取证后,结论是:不是爆红,是被 AI 爬虫围住了。而真正拦得住的,不是 robots.txt,也不是 JavaScript 挑战,而是按类别设置动作的 Bot Protection,加上对未验证流量的行为判断。
披露:本文完整编译自 Ran Isenberg 于 2026-07-29 发布的博客文章《My Blog's Biggest Fans Are AI Bots. So I Fought Back.》。文中所有数字都是作者自己站点在特定时间窗口内的观测,不是行业基准;配图为原文截图,AWS 控制台界面与定价会变,操作前请以你当前看到的版本为准。
一、先看现场:600 到 2,800,涨的只有"新用户"
连续几天,我以为自己火了一把,而且是全新量级的火。博客日读从 600 左右跳到接近 2,800,其中几乎全部涨幅集中在同一篇文章上。
然后是怀疑。日报说不清这些新读者从哪来;这么大的跳变却找不到任何解释,与其说是胜利,不如说是一个问题。于是有了后面这场横跨 AWS WAF、CloudFront 控制台、以及和 Claude 来回长谈的调查。
这篇文章讲三件事:怎么发现 AI 爬虫在爬你的站;它们为什么既烧你的 CloudFront 配额、又污染你的分析数据;以及怎么用 AWS WAF 反击——从挑战、拦截,到直接向爬虫收费。
那篇吃掉几乎全部注意力的文章,是作者写的 Claude Code 最佳实践,大约 1.4 万次浏览。这份讽刺他自己也承认:机器在我站点上最爱读的,是我教人怎么用机器的指南。
错过一个从未发生过的爆红时刻,只是伤自尊。这波流量本身,同时在三个地方让他付出代价。
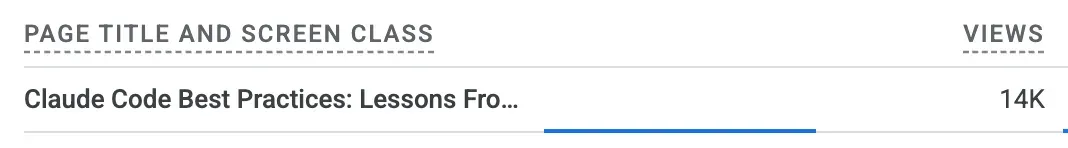
单篇文章扛下了几乎整波涨幅:那篇 Claude Code 最佳实践。来源:Google Analytics 4。
二、三笔账:所谓"免费流量"其实要付钱
第一笔账在账单上。 站点跑在 Amazon CloudFront 的固定费率套餐上,选它就是为了控成本:按量付费时,WAF 规则、日志摄取、CloudFront Functions 各自计费;固定费率套餐把这一切折成一个固定价格,带用量额度,没有超量费用。好处是无论流量尖峰还是攻击,账单都不会给你"惊喜"。代价是:每一个放行进来的 bot 请求,都和真人访问一样消耗额度。爬虫烧掉的,是他为真实读者买的配额。用他的原话说:我在付钱给 Amazon,让它去服务那些爬我的机器。
第二笔账是分析数据被污染。 当成千上万个自动化会话涌进来,没有 referrer、浏览器是不可能的组合,你的流量看起来比实际健康,你最受欢迎的文章其实"受软件欢迎"而不是"受读者欢迎",而所有建立在这份数据上的决策,从一开始就站在假前提上。
第三笔账最让人不舒服。 这些爬虫大多不是来索引文章、把读者送回来的。它们收集内容去训练模型,或者在别人的聊天机器人里回答别人的问题——多年攒下的经验被拿走,没有链接、没有署名、没有一分钱。
公平地说,这不全是"偷"。抓取公开内容本来就是 Web 一直以来的运行方式;经过验证的搜索引擎 bot 仍在给他带访客;很多人也会说,公开的东西就是可以拿的。他真正反对的是眼前这个组合:伪装身份、躲避验证、跑在我付钱的基础设施上,而且我全程没有发言权。
相信是 bot,和证明是 bot,是两件事。所以他去找硬证据。
三、取证:GA4 里到处都是破绽
回到 Google Analytics,故事几乎立刻崩了。
按数字看,他最忠实的读者似乎是一台 2026 年还在运行的 BlackBerry。读者是 bot,而一旦知道该看哪里,迹象到处都是:
- 91% 的会话没有 referrer;
- 流量每天在同一个多小时的窗口里消失,像打卡下班;
- 浏览器分布里塞满 BlackBerry、Nokia Browser、Internet Explorer;
- 参与时间坐实了判断:滚动追踪显示这些文章要 4–10 分钟才读得完,而统计里的平均停留只有十分之一分钟。这不是人的行为,这是定时任务的行为。
我没有爆红。我是被一个不肯自我介绍的什么东西爬了。
为了确认,他用 Claude 去拉 WAF 统计,再和 GA4 开始飙升的具体日期对齐——两边描述的是同一个事件,这才算把证据链闭合。
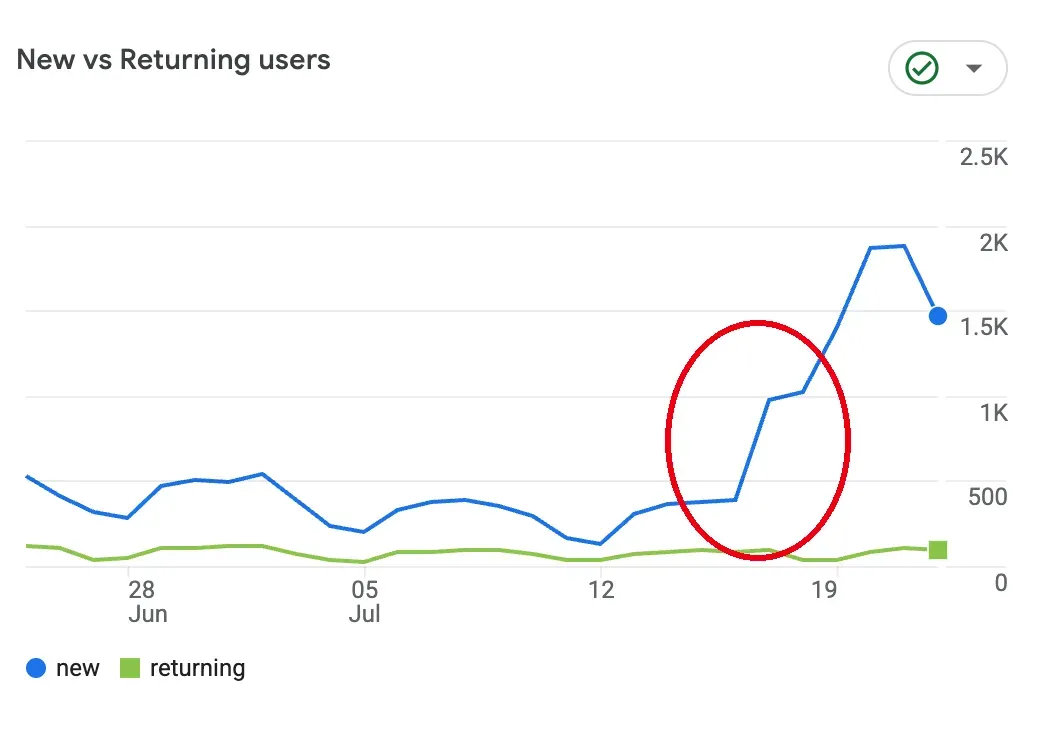
骗过他的那张图。7 月 19 日(圈出)之前,日新用户冲到基线约三倍,而回访读者保持平稳。来源:Google Analytics 4。
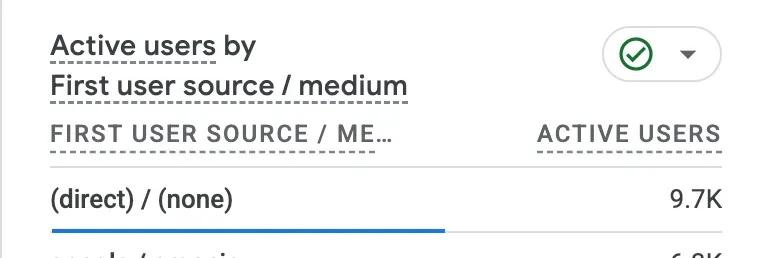
涨幅以 (direct) / (none) 到达:没有搜索、没有来源,只有"手里已经有链接、打开就为抓页面"的客户端。来源:Google Analytics 4。
两张图放在一起只讲一个故事:涨幅只来自新用户——从没见过的新设备和新地址,不是老读者回来看更多;而且以直接流量到达,意味着没人在 Google 搜索后点击,它们本来就有链接,打开只为抓取页面。再把"十分之一分钟"和"涨幅集中在单篇文章"叠上去(同时不少其他文章的阅读量也诡异地变好),红旗已经足够大。
但他仍然说不清这些客户端到底是谁。于是他去源头——AWS 控制台。
四、WAF 的 AI 活动面板:59.65K / 103.47K
AWS WAF 现在自带一个 AI activity dashboard(AI 活动面板),位置在 CloudFront 控制台里、你那个 distribution 的安全区块下,在服务端统计 bot 与 agent 流量。作者没有做任何额外配置,它就在那里——只要已经启用了 WAF,你也能看到。
他查看的那个窗口里:
- 103.47K 次 bot 请求;
- 其中 59.65K 是 AI bot;
- AI 流量里只有 30.9% 能通过验证,剩下 69.1% 匿名。
这个比例改变了他对"站点到底为谁服务"的看法。但不是所有 AI bot 都想要同一样东西。

重新定义"读者"的数字。103.47K 次 bot 请求里 59.65K 是 AI bot,而这部分只有 30.9% 可验证,69.1% 匿名。来源:AWS WAF AI activity dashboard。
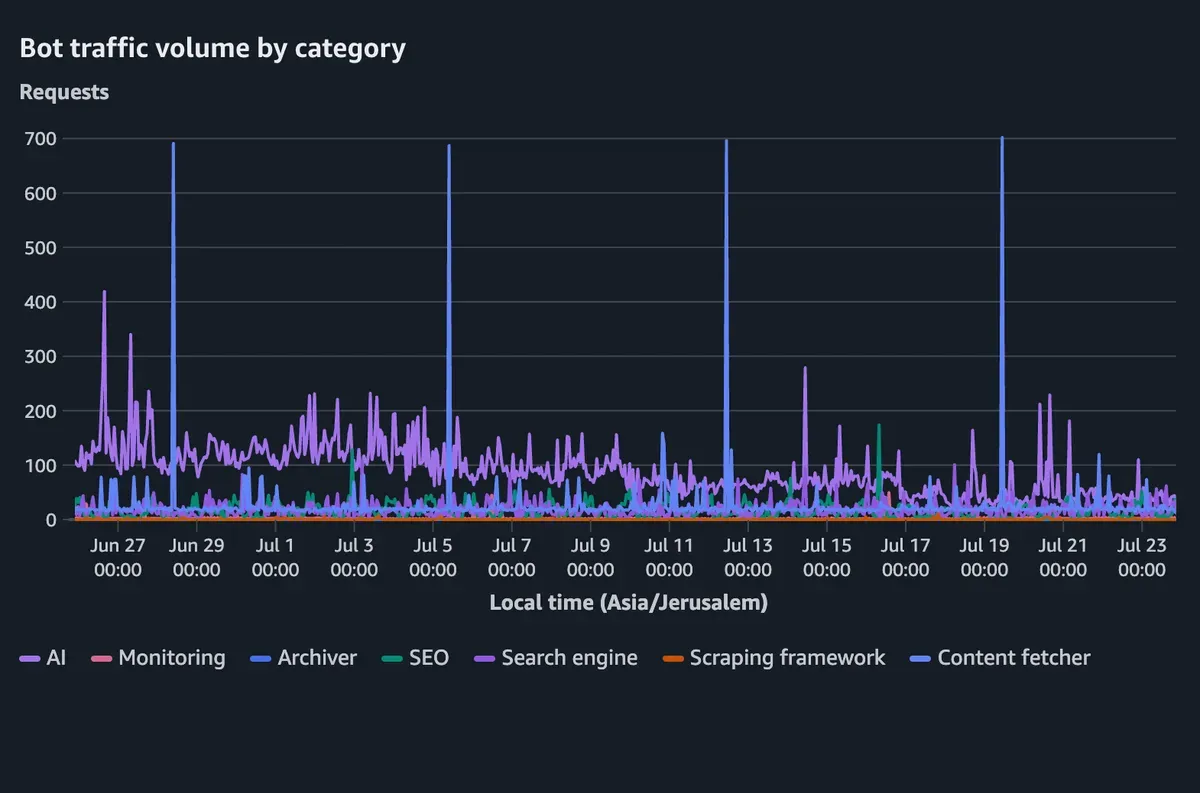
从边缘看:AI bot 流量(紫色)日复一日占据大头;接近 700 次请求的蓝色高峰,是某个归档器每周扫一遍全站。来源:AWS WAF AI activity dashboard。
AWS 把 AI bot 分成三类:
| 类型 | 在做什么 | 对站点意味着什么 |
|---|---|---|
| AI scrapers(抓取器) | 系统性地收集应用数据,用于训练 AI 模型 | 拿走内容,不回链、不带读者 |
| AI tools(工具) | 通过 function calling,把你的数据呈现在 AI 应用里 | 至少可能带来一次曝光或引用 |
| AI agents(代理) | 自主导航、与应用交互,完成复杂任务 | 行为最像人,也最难识别 |
这个区分重要,因为三者的"受欢迎程度"并不相同。一个工具或 agent 为了回答某人的问题来抓页面,至少把你的文字摆到了一个人面前,还可能引用你;一个抓取器把整个存档收走拿去训练模型,什么也不还。
图表还暴露了一个他从未注意到的节奏:那几个高耸的尖峰(有四次达到约 700 次请求)不是随机的好奇心,而是一个归档器按每周计划扫完整站——同样的清扫,每七天一次,安安静静把他写过的所有东西完整复制一份。
已验证与未验证:到底是谁在爬
已验证的 bot 证明了自己的身份:要么是加密的 Web Bot Auth 签名,要么是公开备案的地址段。未验证的 bot 则是 WAF 从行为和指纹判断出"这是自动化",但叫不出名字。
他的站点上,AI 流量只有 30.9% 已验证,69.1% 匿名——正是这个数字,让后面整篇文章变得必要。
换句话说,身份成了一种选择。有的 bot 在 user agent 里自报家门;有的套一个老掉牙的假浏览器字符串(就是那批 BlackBerry);还有的驱动真实浏览器做自动化,彻底藏起来。
愿意自我介绍的不少:OpenAI 的 ChatGPT agent 约 3.53 万次请求排第一,然后是 Meta、Amazon、Google 和 Anthropic 的 Claude,Feedly 这类内容抓取器排在后面。
匿名的大多数才是难题:他怀疑是机器,却无法验证,对它们采取动作就有误伤风险。那部分无名流量最令人不安——不对应任何已知公司或工具,藏在普通人类的 user agent 和普通浏览器后面,触发了行为检测,时间曲线几乎精确贴合他的尖峰,却拒绝说出自己是谁。
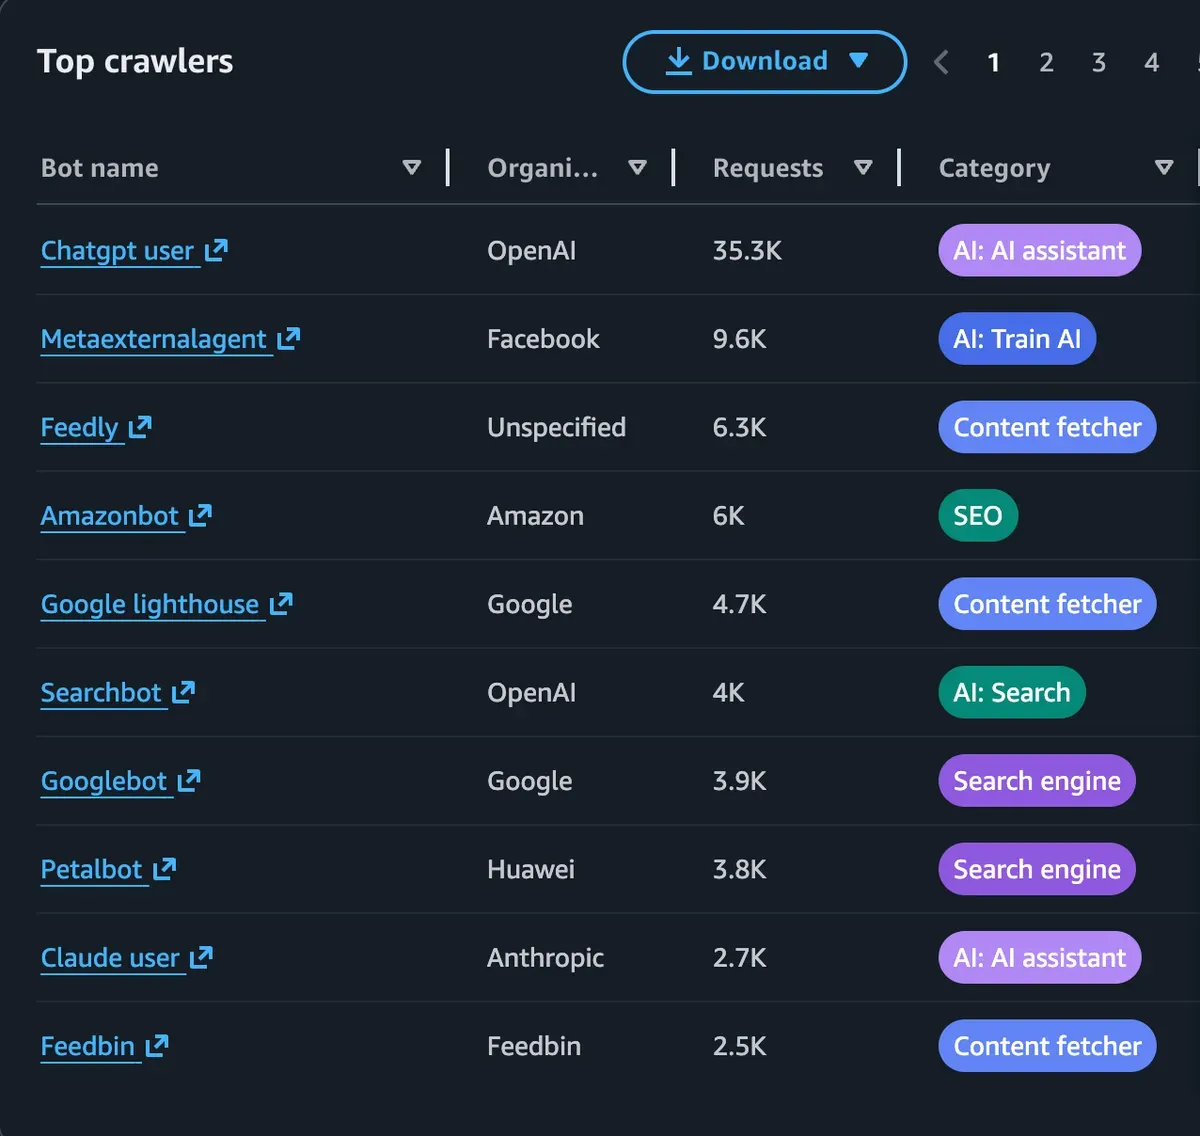
愿意表明身份的 bot:OpenAI 的 ChatGPT agent 领跑,其后是 Meta、Amazon、Google 与 Anthropic 的 Claude。更大的一块未验证流量,永远不会在这里出现名字。来源:AWS WAF AI activity dashboard。
最后一个线索藏在错误指标里:探测不存在的 URL 的请求,把他的 4xx 错误率推到接近 30% 的尖峰,而这一切和自己的代码无关。bot 在猜路径,产生的就是这种噪声。
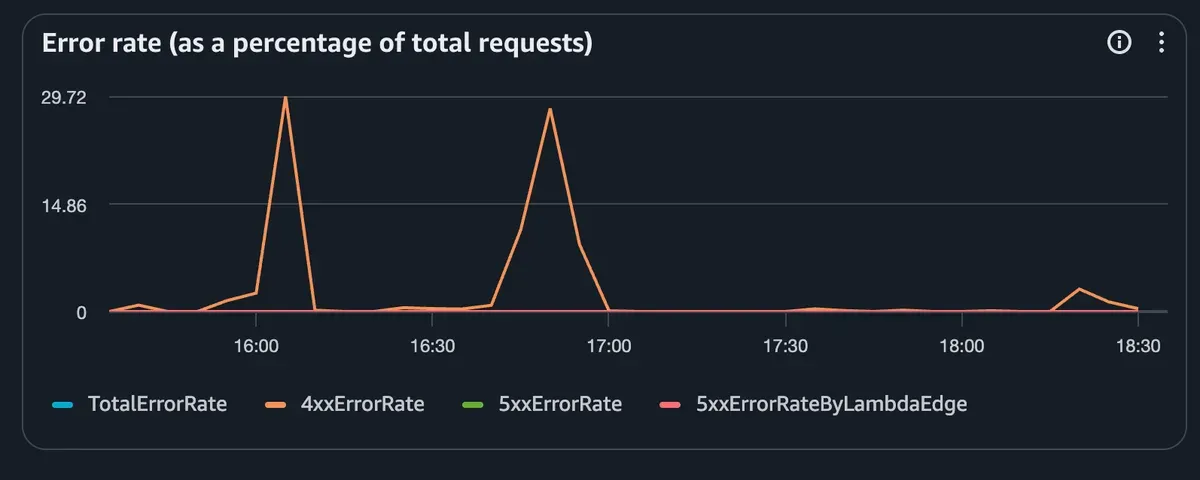
bot 探测不存在的 URL,把 4xx 错误率推成接近 30% 的尖峰——和自己应用无关的噪声。来源:Amazon CloudFront metrics。
面板让一件事变得很清楚:所有那些有名字的爬虫——ChatGPT、Google 等等——在尖峰之前很久就在访问了,速率基本稳定,所以它们一个都解释不了这次跳变。他只是从来没认真看过,只是模糊地假设"bot 会来,这没什么"。真正看到它摊开在眼前,是另一回事。
真正解释尖峰的,是未验证流量:所有可识别的都持平,它却陡峭上升。这些 bot 展示类人的 user agent、驱动真实浏览器——意味着没法可靠追踪,也没法在不误伤真实读者的前提下拦截。
那么,到底能做什么?
五、robots.txt 在 2026 年还剩下什么
他记得最常见的方案之一,是在网站上放一份 robots.txt。但说实话,robots.txt 是礼貌信号,不是防线。
AWS 自己那篇《How to manage AI bots with AWS WAF》推荐的正是这个顺序:先 robots.txt,再 WAF。但那篇文章已经"过期"了:它描述的控制台和今天看到的完全不一样,步骤对不上界面,照着官方路径走的站长最后只能靠猜。
作为执法手段,robots.txt 已经死了。它完全靠自愿。TollBit 2024 年 Q4 的报告发现,OpenAI 的 ChatGPT-User agent 有 42% 的时候无视 robots.txt 的 disallow 规则。2025 年 12 月,联邦法官在 Ziff Davis v. OpenAI 一案中裁定:robots.txt 不构成 DMCA 意义上的有效访问控制机制——它对你的内容的控制力,"不比一块'请勿践踏草坪'的牌子对草坪的控制力更强"。
但真正的问题不只是"agent 可以选择无视"。你写在 robots.txt 里的每一条规则,针对的都是一个 user agent 字符串,这本身就假设了 bot 会如实报上名字;而他最想拦的那批,恰恰不报。所以,他更新了 robots.txt,但知道必须往下挖。
六、HTTP 402 + x402:让 Bot 付费
我觉得最有吸引力的选项,是不打了,让 agent 开始付钱。
AWS WAF 的 AI traffic monetization(AI 流量变现)会用一个 HTTP 402 Payment Required 回应受保护页面的请求,响应里带一个机器可读的价格,以 USDC 计价、走开放的 x402 协议。agent 付钱,WAF 在边缘验证支付,页面在一次往返里返回。
它只对礼貌到愿意自我介绍的 bot 有效,也拦不住任何一次尖峰。但至少,他能从那些守规矩的 bot 身上拿回一点什么,而不是默默补贴它们。
七、JavaScript 挑战为什么不够
下一个选项是 JavaScript 挑战,他一开始就启用了。
它立刻抓到了东西——可惜是他自己抓 sitemap.xml 的自动化,当场罢工。
更有教育意义的是后面:他问 Claude 怎么办,Claude 建议"直接发一个普通 Chrome 的 user agent",挑战瞬间被绕过。
Agent 很聪明,而 JavaScript 挑战很原始。WAF 显然需要比"任何合格脚本都能满足的浏览器检查"更好的启发式。
八、CloudFront Bot Protection:按类别设动作
剩下的选项是 CloudFront 控制台里的 bot protection——本质上是不用自己在规则编辑器里拼装 WAF 规则的友好封装。
他把激进的类别设成 Block,把服务真实读者的类别留在 Monitor,然后等。
生效花了几个小时,之后那些奇怪的请求确实开始消失。
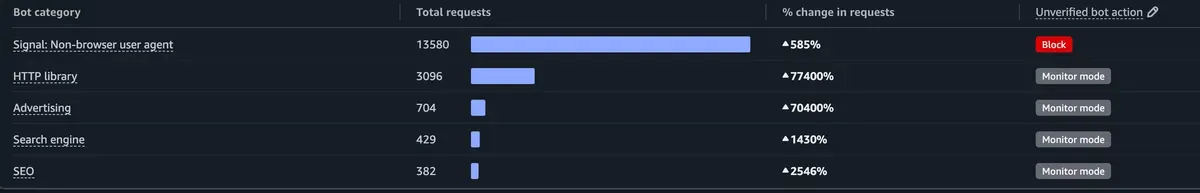
拦截在起作用:未验证的非浏览器 user agent,上升 585% 至 13,580 次请求,现在被拦下;搜索引擎和 SEO 工具保持在监控模式。来源:Amazon CloudFront bot protection。
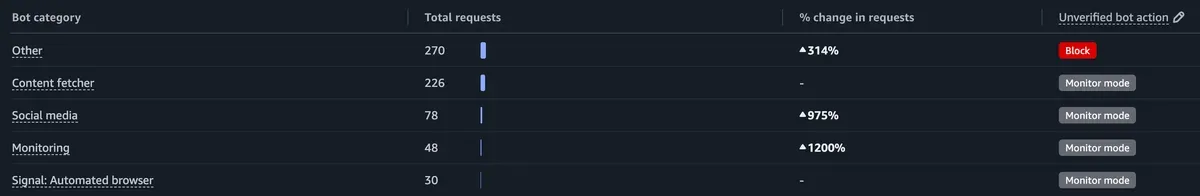
小类别讲的是同一个故事。Other 上升 314%,设为拦截;内容抓取器、社交媒体、监控保持监控模式,因为它们是"好 bot"。来源:Amazon CloudFront bot protection。
到目前为止,流量看起来接近正常了。但他很小心,不愿宣称胜利——这完全可能只是巧合,或者 bot 周末休息。
它显然拦掉了大量流量,但不是全部:他仍然能看到那些没有来源的直接访问成批出现。他也仍然有一大批未验证 bot,而他并不确信要 100% 拦截——这就是为什么好几个类别是故意只统计、不拦截。
九、效果:阅读掉了 29%,停留涨了 70%
最清晰的进展信号不在 WAF,而在他自己的报表里。
他重建了每日分析,让 bot 会话以 bot 会话的身份浮出来,而不是藏在他的流量里。改完后的那一周,报表标出了 2,372 个 bot 会话,比前一周增加 999% 以上。
这几乎都不是"新增的 bot 活动",而是同一批一直在被算作"读者"的爬取,终于被标成了它本来的样子。
把 7 月 19–25 日的暴涨周和之前正常的一周放在一起,形状一眼就能认出来:阅读、用户、会话全部虚高,而平均时长下降 47%,只剩一分多钟——因为制造这波流量的东西,根本不是按人的速度在读。
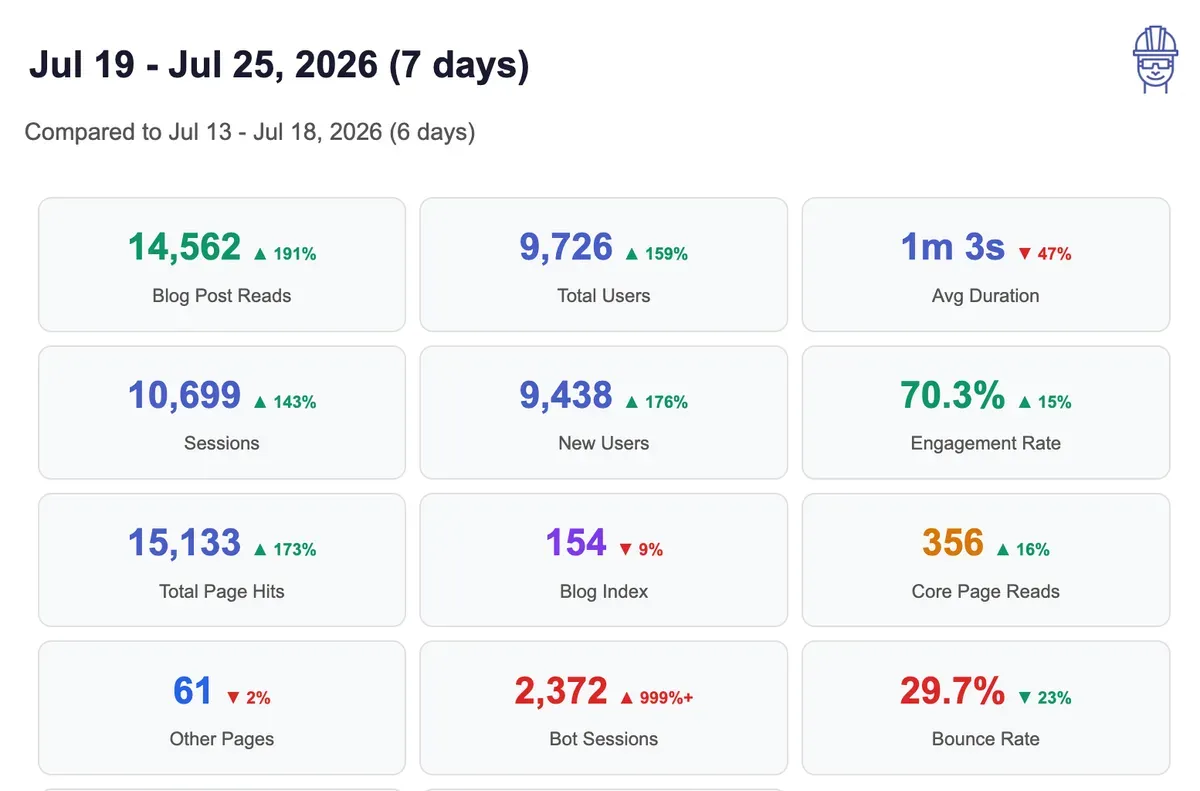
他重建后的日报:暴涨周 vs 前一周。来源:Google Analytics 4。
拦截生效后的第一天,和前一天的对比,数字朝着你希望的方向走:
- 博客阅读 −29%;
- 总用户 −27%;
- 平均会话时长 +70%,到一分半。
前两个听起来像坏消息,直到你看第三个数字:失去三分之一的"受众",而剩下的人读得久得多——这是他能拿到的最清楚证据:被移除的那部分,从来就没在读任何东西。
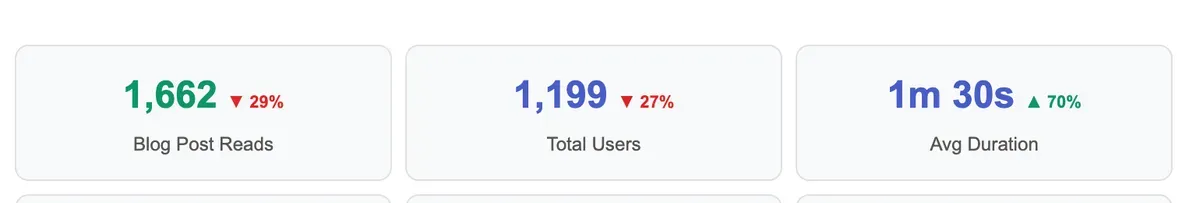
拦截生效后一天 vs 前一天。来源:Google Analytics 4。
还有第二笔回报,永远不会出现在分析面板里:被 WAF 拦下的请求不占用固定费率套餐的用量额度。每一个在边缘被拒的爬虫,都不再花掉他为真实读者买的配额。三笔成本里落在账单上的那一笔,是这次真正修好的。
他也不抱幻想,认为这能抓住一切。大量 bot、大量浏览仍然没有标签地溜过去,像人一样坐在他的数字里——说实话,这没关系。他宁愿要一个知道不完美、也明白为什么不完美的数字,也不要一个因为错误原因而信任的数字。
十、为什么最终要靠行为分析,而不是规则
他的结论是:手里的工具是有上限的。
有些未验证 bot 可以尝试拦截,但要冒误伤真实读者的风险;有些根本拦不了,因为它们带着真实的 user agent 和真实的浏览器来。
要抓住这些,需要真正的行为分析:
- 跨时间的会话模式;
- 把地址和自己的历史比对;
- 地理——他看到过一串来自孟加拉国的 agent,而这个国家从来不访问他的站。
只有这些信号组合起来才暴露模式,而 WAF 今天不做这件事——至少他没找到怎么做。要走到那一步,它需要把分析侧知道的东西,和对站点结构、页面的理解结合起来。
十一、一张表:五种手段,各自拦得住什么
| 手段 | 能挡住什么 | 挡不住什么 |
|---|---|---|
robots.txt |
愿意遵守的爬虫 | 42% 的 ChatGPT-User;伪装 UA;无执法力 |
| HTTP 402 / x402 | 愿意付费、且表明身份的 agent | 匿名爬虫;单次尖峰 |
| JavaScript 挑战 | 最原始的脚本 | 会发普通 Chrome UA 的 agent;自己的自动化 |
| Bot Protection 分类拦截 | 未验证的非浏览器 UA、Other 类 | 真实 UA + 真实浏览器的自动化 |
| 行为分析(待自建) | 会话模式 / 地址历史 / 地理异常 | 需要自己拼,WAF 目前不提供组合判断 |
十二、复刻清单
如果你也在 CloudFront 后面跑站点、想知道自己处在什么位置,作者的起点是这六步:
- 换成 CloudFront 固定费率套餐,并把 WAF 放在站点前面——这样 bot 潮水再大也不会在账单上吓你一跳,你也能在边缘看到流量。
- 打开 AWS WAF 的 AI activity dashboard,看看到底是谁在读你。按作者的说法,Pro 档及以上包含此功能,几分钟就能看完。
- 拿分析数据和现实对账:参与时长 vs 文章实际需要读多久、新用户 vs 回访用户、有多少流量完全无来源。
- 用 Bot Protection 试按类别设动作:拦抓取器,监控服务真实读者的类别;但把它当实验,不是永久城墙。
- 不要指望 JavaScript 挑战救你:坚定的 agent 发一个普通 Chrome UA 就过去了,而且它可能顺手弄坏你自己的自动化。
- 然后拿着自己的数字决定:Business 档的挑战与变现能力,对你是否值得。
编译者再补三条,属于操作层面的提醒,不是原文结论:
- 先量基线再动手。至少留一周的"改前"数据(阅读、用户、会话时长、4xx 比例),否则你无法判断变化是拦截带来的还是周末效应。
- 别用单一信号判人机。UA 可以伪造,IP 会变,停留时间会被前端事件影响;至少要"来源 + 浏览器 + 行为 + 时间分布"四项交叉。
- 留一条回退路径。把 Monitor 模式当成你的安全网:先观察命中,再逐类改 Block,出问题能立刻退回。
十三、边界
- 这是单站点、单时间窗口(2026 年 7 月前后)的观测。59.65K / 30.9% 这类数字不能当行业基准,换个站点可能完全不同。
- 归因不等于因果。拦截后阅读下降、时长上升,作者自己也承认可能是巧合或周末效应;他给出的是一条自洽的证据链,不是受控实验。
- 平台差异。文中所有操作路径都是 CloudFront + AWS WAF 的;其他 CDN / 反代产品的功能名称、计费方式、默认动作都不一样,不要照搬术语。
- 法律结论有边界。Ziff Davis v. OpenAI 的裁定涉及特定法域、特定案由(DMCA 下的访问控制),不等于"
robots.txt在全球范围内没有意义"。 - 一刀切会伤自己。AI bot 里也有搜索、监控、社交预览这类"好 bot",作者的处置方式是分类 + 监控模式,而不是全拦。
Sources
- Ran Isenberg, My Blog's Biggest Fans Are AI Bots. So I Fought Back., 2026-07-29:https://ranthebuilder.cloud/blog/my-blogs-biggest-fans-are-ai-bots-so-i-fought-back/
- AWS, How to manage AI bots with AWS WAF and enhance security:https://aws.amazon.com/blogs/networking-and-content-delivery/how-to-manage-ai-bots-with-aws-waf-and-enhance-security/
- AWS, AWS WAF adds AI traffic monetization capability:https://aws.amazon.com/blogs/aws/aws-waf-adds-ai-traffic-monetization-capability-to-help-content-owners-charge-ai-bots-for-content-access/
- AWS, CloudFront flat rate pricing plans:https://docs.aws.amazon.com/AmazonCloudFront/latest/DeveloperGuide/flat-rate-pricing-plan.html
- AWS, WAF CAPTCHA and challenge actions:https://docs.aws.amazon.com/waf/latest/developerguide/waf-captcha-and-challenge-actions.html
- Digiday, As AI lawsuits mount, publishers still struggle to block the bots(引 TollBit 2024 Q4 报告):https://digiday.com/media/as-ai-lawsuits-mount-publishers-still-struggle-to-block-the-bots/
- Eric Goldman, Are robots.txt Instructions Legally Binding? Ziff Davis v. OpenAI, 2025-12:https://blog.ericgoldman.org/archives/2025/12/are-robots-txt-instructions-legally-binding-ziff-davis-v-openai.htm
相关阅读:AI 基建 / 评测 / 安全完全指南 | Agent 审计日志:为什么"干净的日志"比缺失更危险 | Agent 成本体检:上下文预算与提示缓存 | AI 爬虫流量:11 个问答分清爬取、引荐与转化
本文由汇智网编译整理,转载请注明出处。原文发布于 2026-07-29,控制台界面与产品定价请以你操作时的 AWS 文档为准。
这是「AI 基建 / 评测 / 安全」专题的一部分。完整地图见:AI 基建 / 评测 / 安全完全指南