Fable 5.2 控制机械臂:仿真 64.9%,真机撑不满动作预算
仿真 64.9% vs 真机"撑不满动作预算"。同一件事的两个数字,隔了两周、两种硬件。
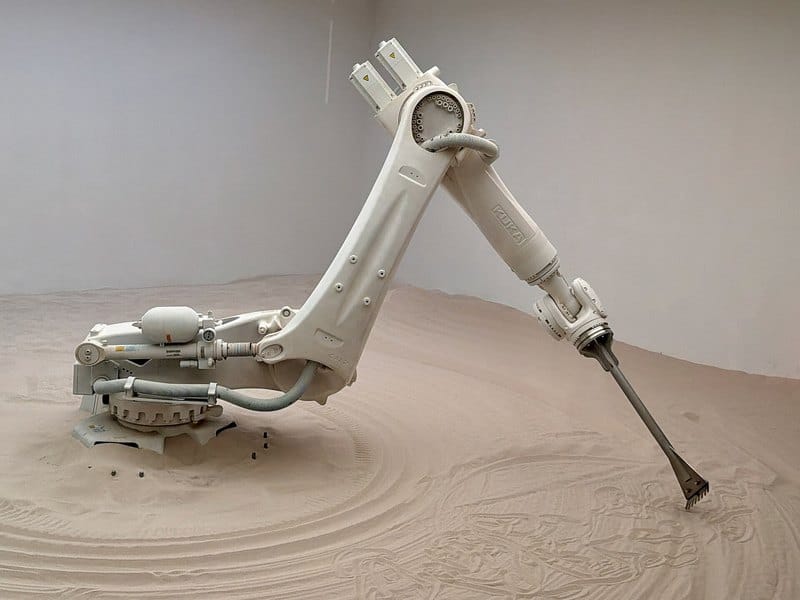
2026 年 11 月 9 日,Anthropic 发布 Fable 5.2。发布表里夹着一行不起眼的数字:RoboDojo Sim 64.9%——那是一个"让模型从相机图像直接驱动双臂机器人"的公开基准。上一代 Fable 5.1 是 27.6%,Anthropic 自己日常推荐的 Opus 5.5 是 39.4%。
一代模型,在专门为机器人造的基准上,跳了 37.3 个百分点。
两周前另有一篇论文在真实机械臂上跑同一套任务,结论是:能控,但精度和效率还撑不满一个实际的动作预算(arXiv 2610.25287,2026-10)。
把这两句话放在一起,才是这次发布的真实含义:通用模型开始吃掉"物理 AI"栈里的一段,但没吃掉可靠性那一段。
一、先看数字,别先看结论
Anthropic 表格里的四个数(同一 harness 跑出来的):
| 模型 | RoboDojo Sim |
|---|---|
| Claude Fable 5.2 | 64.9% |
| Claude Opus 5.5 | 39.4% |
| Claude Fable 5.1 | 27.6% |
| 另一个前沿模型 | 29.8% |
媒体报道的口径再多两个:GPT-6 Astra 29.8%、Gemini 4 Argon 34.2%。也就是说,一个通用模型把一整个"专为机器人造"的梯队甩开了 25 个点以上。
演示视频里有三个动作:两只现成机械臂,通过 Claude Code 驱动,拧开瓶盖、解开魔方、画一张机器人。Anthropic 的说法是"在从未专门训练过的任务上也有显著提升"。
这句话才是最扎人的地方。因为过去三年,做具身智能的默认假设是:机器人控制需要自己一套栈——世界模型、用机器人数据训的视觉-语言-动作策略(VLA)、专门的空间推理、动作 tokenizer、长程规划器。一整个赛道的融资,建在这个假设上。
二、为什么这一跳比看上去更值得认真对待
不是因为分数高,是因为对照条件。
Anthropic 把每个模型都塞进同一个 harness(同一套工具、同一套接口约束、同一套观测格式)再比。这至少排除了"谁的脚手架更顺手"这一层。剩下的差距,才更接近"模型本身会不会控制机械臂"。
更关键的是这条路径的空间:它没有用机器人数据训练。感知、规划、把图像翻译成末端执行器位姿,全在通用能力 + 工程脚手架里完成。如果这条路能延伸到真机,那么 VLA 栈里"感知到动作"这一截,价值会被重新定价。
但也正因为如此,三个扣分项必须同时摆出来。
三、三个扣分项,缺一个都会把结论读歪
| 扣分项 | 具体是什么 | 后果 |
|---|---|---|
| 内部跑分 | 所有数字都是 Anthropic 自己跑的;Claude 与 Astra 用 Max effort,Gemini 4 Argon 用 High | 没有第三方复现,"同 harness"不等于"同预算" |
| 仿真分 | 64.9% 是 RoboDojo Sim;这个基准本身有 42 个仿真任务 + 18 个真机任务 | 真机那 18 个任务,没人给出对应分数 |
| 剪辑视频 | 物理演示是成片,画面标了加速播放、剪掉停顿 | 它证明"能做",不证明"能稳定重复做" |
第二行值得单独说:RoboDojo 不是纯仿真基准。它由港大 MMLab 联合近二十家机构做,42 仿真 + 18 真机,本来就是为"sim-and-real 对照"设计的。发布表里只出现 Sim 这一半,不是造假,但读者很容易把"仿真里的 64.9%"读成"机械臂上的 64.9%"。
这也是为什么两周前那篇论文重要。
四、真机那篇论文:能控,但撑不满预算
arXiv 2610.25287《The Bitter Lesson Comes to Robotics》做的事很朴素:把九个前沿多模态模型放到真实机械臂上,跑 RoboDojo 里的六个操作任务,测量三件事——成功率、执行速率、推理成本。
作者自己的定性是"我们认为是第一次在物理硬件上、用同一套任务对广泛的前沿模型做系统比较"。
结论一句话:当前前沿模型能直接控制真实机械臂完成多种操作任务,但还不够精确、不够高效,无法在实用的动作预算内完成。
但他们同时给了三个更值得记住的趋势数:
- 2026 年 7 月到 10 月,基准上的性能翻倍时间是 53.9 天;
- 最好的执行速率提升了 4.4 倍;
- 最低的执行成本下降了 6.2 倍。
翻译成工程语言:现在不能用,但每 54 天强一倍,而且便宜得比强得更快。 这才是"通用模型要不要接管机器人"这个问题的真实时间轴——不是"能不能",是"哪一年能,以及到时候你的栈还剩下什么"。
五、榜单在涨,但涨幅里有多少是真的
11 月 2 日 OpenRUA 发了一篇很硬的复盘《Behind the RoboDojo Boom》,直接点了三类让具身榜单虚高的漏洞:
| 漏洞 | 机制 | 怎么识别 |
|---|---|---|
| 预算不公 | 不同方法给的动作步数/重试次数不一样,多的自然赢 | 看有没有报"每任务平均动作数" |
| 验证器可读 | 执行过程中把任务进度直接喂给 agent,等于开了透视 | 看 agent 拿到的观测里有没有任务状态 |
| 技能过拟合 | 测试题的解法在评测前就写进 agent 里 | 看有没有"零样本"声明与对应日志 |
这三条不是针对某一家,而是整个 embodied leaderboard 的通病。对读者的实际含义很直接:看到"某模型在机器人基准上超过专用系统",先问三件事——预算统一吗?观测里有没有作弊通道?训练集里有没有这道题?
六、钱这一层,几乎没人写
R&D World 那篇把成本算出来了:token 价格降了 20%,但在满力(Max effort)模式下,每个任务的成本翻了一倍。
同一篇里还有两个对照数字:Anthropic 内部电路板基准 PCB Gym,Fable 5.2 拿 69%、上一代 25%;BenchCAD 2.1(从图纸和渲染图重建 3D 零件/装配/电路板)83.5,Opus 5.5 是 65.3、Fable 5.1 是 44.4。
这三组数字放在一起看,比任何"AGI 要来了/还早"的判断都实在:推理单价在降,但"把一个任务做完"的总成本在涨——因为模型被允许想更久、试更多次。 机器人的动作预算问题,本质是同一个账:每一次重试都要占用真实的时间、真实的工件。
七、我们的整理:对做工业 AI 的人,这意味着什么
上面是别人的数字,下面是我们按工程视角的拆法——哪些能外包给通用模型,哪些不能:
| 环节 | 交给通用模型 | 为什么 |
|---|---|---|
| 看得懂现场(图纸、I/O 表、标签命名、工艺描述) | ✅ 可以 | 这是语言与结构理解,通用模型已经强过大多数专用系统 |
| 写动作序列、排工艺顺序 | ✅ 可以,但要人审 | 演示里的"拧瓶盖、解魔方"就是这类;错在顺序上的代价藏在后面 |
| 抓取点/位姿的最后一厘米 | ❌ 现在不行 | 真机论文说的"不够精确"就卡在这;需要视觉伺服、力控、标定,不是语言能力 |
| 节拍与动作预算 | ❌ 现在不行 | 53.9 天翻一倍是趋势,不是当下的可用性 |
| 安全相关(急停、互锁、F 保护) | ❌ 永远要人 | 工具能保证"发出去了",不能保证"发对了" |
一句话:通用模型吃的是"理解与编排",不是"闭环里的精度"。 谁把这两件事混成一个"AI 接管机器人",谁的方案会在验收那一步崩。
八、下次看到这类发布,用这五条过一遍
- 是不是仿真分? 基准有真机子集就追一句"真机那半多少"。
- 是不是同一预算? 步数、重试、effort 三样里有一项不同,差距就不可比。
- 视频剪没剪? 标了"加速播放/剪掉停顿"的,只能当能力示意。
- 每任务成本涨还是跌? 单价降不等于总价降。
- 它替掉的是哪一层? 理解层、编排层、执行层、安全层——四层里通用模型今天能碰的是前两层。
最后留一个可以复述的判断:这次不是"AI 学会了开机器人",而是"机器人控制栈里最像软件的那一段,被通用模型接管了"。 剩下的那一段,还是机械、标定和节拍。
来源
- Anthropic,《Introducing Claude Fable 5.2 and Claude Mythos 5.2》:https://www.anthropic.com/claude-fable-and-mythos-5-2;方法学见 System Card:https://www.anthropic.com/document/claude-fable-5-2-mythos-5-2-system-card
- RoboDojo 基准(42 仿真 + 18 真机,港大 MMLab 等):https://robodojo-benchmark.com/eval
- 《The Bitter Lesson Comes to Robotics》,arXiv 2610.25287:https://arxiv.org/abs/2610.25287
- OpenRUA,《Behind the RoboDojo Boom: Revisiting Embodied Evaluation of Robot-Use Agents》,2026-11-02:https://openrua.ai/revisiting-rua
- R&D World,《Anthropic's Fable 5.2 nearly doubles hardware-design score》,2026-11-09:https://www.rdworldonline.com/anthropic-says-fable-5-2-nearly-doubles-its-predecessors-hardware-design-score-token-prices-fell-20-but-the-cost-per-task-doubled-at-full-effort/
- RobotsBeat,《Claude Fable 5.2 Beats Astra, Gemini and Opus in Anthropic's Robotics Test》,2026-11-09:https://robotsbeat.com/claude-fable-5-2-robotics-robodojo-astra-gemini-opus/
- Embodied Global,《General Models Are Reshaping Embodied AI, Not Ending It》,2026-11-10:https://embodiedglobal.com/en/article/anthropic-fable-5-2-robodojo-64-9-embodied-ai-competition
说明:文中 Anthropic 表格数字取自官方发布页;GPT-6 Astra / Gemini 4 Argon 的具体分数来自媒体报道,我们未在官方页面逐一核对。RoboDojo 主页为前端渲染,42/18 的任务数与机构来源取自其公开说明与检索摘要。
相关阅读:AI × 工业 / PLC 完全指南 | AI 写 PLC 代码总差一步:一句"有蓝色盘吗"说清了缺的是什么 | AI 原生工业控制:不让 AI 碰实时回路,只让它当"架构师"