AI 写 PLC 代码总差一步:一句"有蓝色盘吗"说清了缺的是什么
光有 I/O 表和标签不够,物理布局和信号语义得单独讲给它听。论文把"AI 碰 PLC"拆成四级台阶:说、写、编、下,每级都要人点头。
先看论文里的一段对话(原文的演示实录,我们译成中文):
工程师:有蓝色盘吗?
AI:没有。厂区上下文里只定义了铬、红、黑三种盘,不存在蓝色盘的料仓、传感器或分选通道。
工程师:生成序列:红 → 红带嵌件 → 铬 → 黑带嵌件 → 铬。
AI:(生成结构化文本,用的是这套设备真实的标签,比如黑盘那条支路用 BLACK_MAG_FUELLSTAND 和 INSERT_MAG_FUELLSTAND 做门控)
工程师:编译。 → 编译通过。
工程师:黑盘也能加嵌件吗?
AI:可以,嵌件工位逻辑在进入黑盘通道前同样适用。 → 编译通过。
工程师:部署到 PLC,清锁存和变量状态,然后启动。 → 设备开始按新序列跑。
这段对话里,最值钱的不是任何一行代码,而是第一句的回答。
一个通用大模型被问"有蓝色盘吗",它会顺着你说"有,我这就写"——然后给你一段编译不过、或者编译过了但根本跑不对的代码。这个 AI 说"没有",因为它手里有一份这家厂的真实清单。
这就是这篇论文的全部重点。
本文完整解读 Joschka Kersting、Gesa Benndorf,2026-10,《From Code Generator to Engineering Companion: A Plant-aware Agent for PLC Programming》(arXiv 2610.28160,IEEE 版权)。它不是讲"用更强的模型写更好的代码",而是讲怎么把"一家具体的厂"喂给模型,以及怎么让它在动手之前必须先停下来问你。
一、先说清楚它解决的痛点
以前的同类系统是这样工作的(论文自己引用的前作 [1],同样是三菱的 GX Works3 环境):
工程师提交一句任务 → 模型生成代码 → 编译服务器校验 → 返回。
这叫流水线。它的三个问题是:
- 它不认识你的厂。 每次都是从零开始,不知道你有哪些标签、哪些模块、现场的盘往哪走。
- 它不能对话。 只回答一次。你没法问"这里为什么用这个互锁",也没法说"把黑盘那条改一下"。
- 它没有从聊天到落地的路径。 生成完就结束了,编译、部署是另一套流程,中间没有任何约束。
论文管这个差距叫交互模型的差距,而不是代码生成的差距。这句定性很重要:它意味着你换一个更强的模型,这条路也不会自动变好。
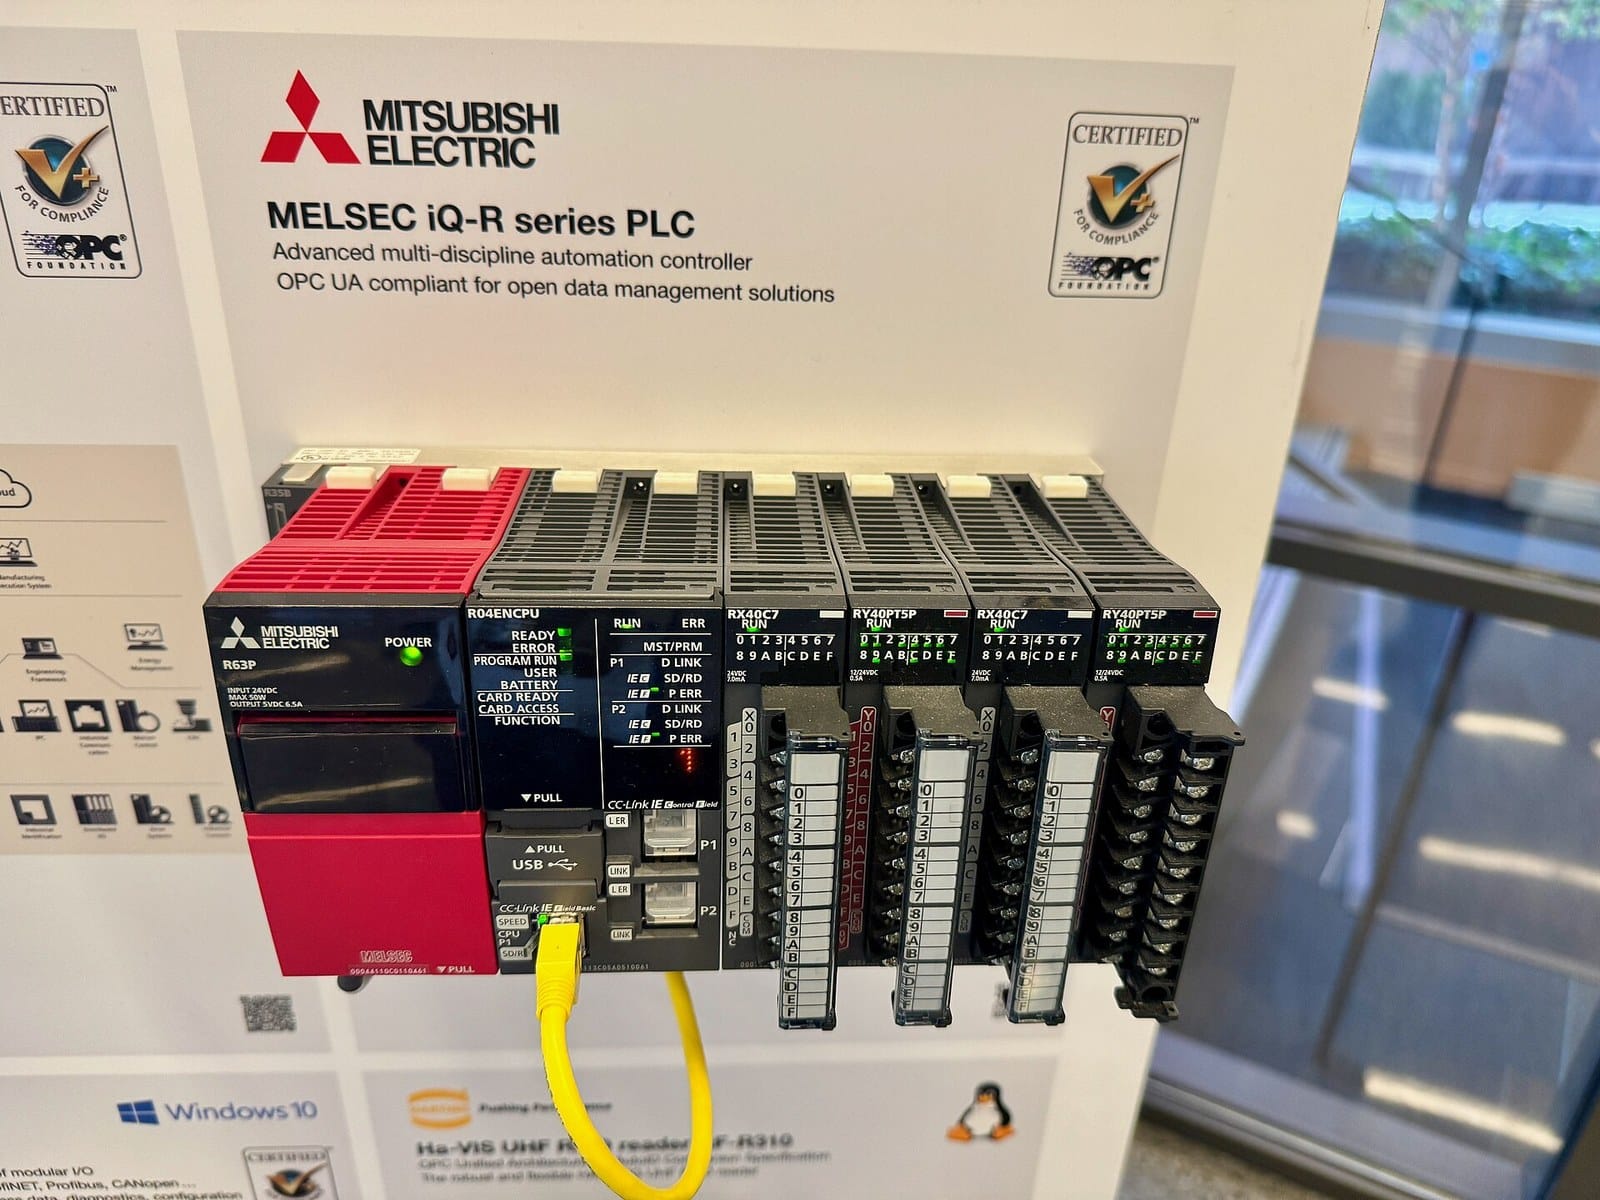
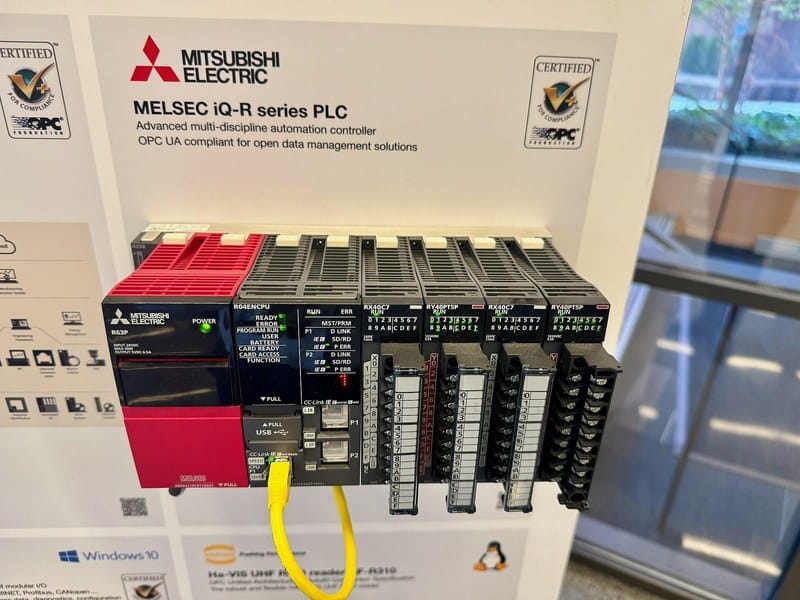
论文的演示台用的是一台三菱电机 iQ-R 系列 CPU(R04),通过 GX Works3 编程。图为同系列机架(R63P 电源 + R04ENCPU)。(图:Oleg Yunakov,CC BY-SA 4.0,Wikimedia Commons)
二、什么叫"知道这个厂"(plant-aware)
论文给的定义很朴素:让生成的代码落在目标厂的 I/O 表、标签命名空间、模块配置和物理信号拓扑上。
翻译成车间语言:别生成"一个叫 SORT_RED 的变量",要生成"你厂里真的存在的那个 BLACK_MAG_FUELLSTAND"。
开工前,工程师要提供四样东西:
| 材料 | 里面装什么 | 没有它会怎样 |
|---|---|---|
| I/O 表 | 所有输入输出的信号名、地址、数据类型、说明 | 生成的代码引用不存在的地址,编译过、跑不对 |
| 标签表 | GX Works3 里完整的标签(含内部变量与程序间信号) | 变量名靠猜,命名风格和你厂对不上,维护时没人认得 |
| 模块配置 | 机架布局、CPU 型号、特殊功能模块的分配 | 用到不存在的模块,或把高速计数当普通输入写 |
| 现有程序片段 | 已部署在设备上的 ST 程序和功能块实例 | 重复造轮子,或和现有逻辑打架 |
这四份材料被切块、向量化,单独建了一个"厂上下文"检索库,和原有的三个库分开。
为什么非要分开建库?
这是全文我最想推荐给同事的一个工程细节。
它的检索是四个库各查各的:库函数定义、规格规则(MEC2023/24)、通用上下文(上传文件与聊天记录)、厂专属上下文。
如果把这些混在一个索引里,你问"黑盘怎么分选",检索可能同时捞回:某本手册里的通用示例、另一家项目的变量名、你厂的真实标签——三份混在一起,模型就挑一个看起来最顺的说。分开建库等于给每类材料一个独立的抽屉,检索时不会串味。
论文的用词是 "avoid cross-source interference"(避免跨源干扰)。这句话在大模型应用里是通用经验:上下文里最危险的不是缺信息,是"错的但看起来对的信息"。
一条被埋在演示里的关键发现
论文在描述演示台时写了这么一句(我们翻译):
实际设备的布局必须额外讲给模型听,因为光有 I/O 表和标签,并不能表达物理布局与信号语义。
具体缺什么?它举了三件:
- 料仓在什么位置;
- 料仓什么时候算"有料"(对应传感器必须为 TRUE);
- 盘是被传送带送到右边,执行机构按什么顺序排布。
这句话对做过现场的人几乎是常识,但它是这套系统能不能用的分水岭:
I/O 表告诉你"有这个信号",物理说明告诉你"这个信号意味着什么"。 前者是数据,后者是知识。
三、四级台阶:为什么它不许 AI 直接碰设备
论文把"AI 能做的事"拆成四级,每一级都要工程师显式触发:
| 级别 | 名字 | AI 能做什么 | 产生什么后果 |
|---|---|---|---|
| L1 | 咨询 | 只回文本,不调任何工具 | 没有物理后果 |
| L2 | 生成代码 | 把 ST 代码显示在对话里 | 只是文本,还没进工程 |
| L3 | 编译 | 调编译服务器,拿回结构化诊断 | 工程里多了一个可编译的块,还没下到设备 |
| L4 | 部署 | 工程师确认后写入 PLC、启动/停止/复位 | 设备真的会动 |
几个值得注意的设计:
- L3 的"结构化诊断"很重要。 不是给一段红字报错,而是能让模型读懂、能自动修的形式;论文写明最多 3 轮修复,超过就停——防止它无限套娃地"改到能编译为止"。
- 每一级的触发权在人手里。 论文的措辞是 "explicit engineer initiation"。AI 不会自己从 L2 跳到 L3,更不会自己跳到 L4。
- L1 不是摆设。 上面那段"有蓝色盘吗"就是 L1——它在你动手之前帮你排除掉一个不存在的需求。这一层不产生任何代码,但它省下的是整轮返工。
这个设计背后的理由论文写得很直白:在工业环境里,一个不受控的"模型到硬件"动作可能砸设备、可能停线。
四、演示台:一个分选机,和它为什么够用
演示设备是一台金属圆盘分选机:
- 盘有三种颜色:铬(最反光)、红、黑;
- 用气压 + 光电传感器识别——三种颜色反射率不同,所以阈值要分开配;
- 还有一个嵌件工位,可以往盘里塞嵌件;
- 传送带把盘往右送,经过所有料仓后分到三个盒子;
- 铬最先走,然后红,最后黑;铬和红由气缸主动推下皮带,黑盘靠重力被动落进盒子。
控制器是三菱电机 iQ-R 系列 R04,通过原型网页界面 + GX Works3 操作;厂上下文按 I/O 表、标签表、现有 ST 片段导入。
这个台子小得有点好笑,但它把问题暴露得很完整:颜色阈值、料仓状态、嵌件时序、主动/被动分选——四件事都要"知道现场"才能写对。论文也说它可作为更复杂产线(比如汽车行业)的示范。
五、这篇论文最该被强调的一句话:还没有量化评测
论文最后一节写得很诚实(我们翻译):
计划中的工作是:在匹配的任务集上,对"厂上下文"与"通用上下文"做结构化的定量对比。
也就是说——截至这篇论文,它还只是一个演示 + 一套设计,没有"用了这套比不用好多少"的数字。
它的局限清单同样坦白:
- 只在一个厂、一个品牌生态(三菱 iQ-R / GX Works3)里演过,跨厂商不在范围内;
- 功能正确性需要硬件在环(HIL)测试或专家评审,编译通过不算数;
- 人机评估只来自单一组织背景。
怎么读这类论文?一句话:它证明的是"这条路能走通",不是"这条路比别的路更好"。 前者已经很有价值(阶梯设计、四库分离、物理知识要单独讲),后者要等它的下一版。
它也给了下一步清单,其中两条特别值得盯:
- 执行反馈:把 PLC 运行时信号接回 AI 的上下文(现在是单向的:AI 写,人跑);
- 多 PLC 编排:一条线上几台控制器时,谁来协调(这正是大批量产线真正难的地方)。
六、把它放回已有研究里,才有参照系
论文自己列了一张对比表,我们补上它们各自报出的数字,你就知道"编译通过率"这行数字有多虚:
| 系统 | 厂上下文 | 代码 | 编译 | 部署 | 会话优先 | 报出的成绩 |
|---|---|---|---|---|---|---|
| LLM4PLC | — | ✓ | ✓ | — | — | 编译+语法+形式验证反馈,把生成成功率从 47% 提到 72%(制造测试台) |
| Agents4PLC | — | ✓ | ✓ | — | — | 23 个任务(16 易 7 中),易 68% / 中 42.3% 可验证率(GPT-4o) |
| AutoPLC | — | ✓ | ✓ | — | — | 面向两个专有平台的厂商感知流水线 |
| Spec2Control | — | ✓ | — | ✓ | — | 65 个用例 / 10 份需求,策略连接 98.6% 正确,工程工作量降 94–96%(ABB) |
| 西门子 Copilot | — | ✓ | ✓ | ✓ | ✓ | 商业产品,无公开评测集 |
| 本文 | ✓ | ✓ | ✓ | ✓ | ✓ | 演示 + 设计,无定量评测 |
读这张表的正确姿势:
- 47% → 72% 说明"让模型看编译错误"这件事本身就值 25 个百分点;
- 98.6% 是"策略连接"的正确率,不是"程序能跑",别混;
- 本文是唯一带"厂上下文"的一列——这是它的位置,也是它的赌注:先解决"对不对得上你的厂",再谈准确率。
七、我们的整理:要落地,这几件事得先想明白
论文没给实施清单,我们按工程顺序补一份(这部分是我们的整理,不是论文内容):
1)先盘家底:五份材料,缺哪份先补哪份
| 材料 | 判据(合格长什么样) | 老厂没有怎么办 |
|---|---|---|
| I/O 表 | 一列信号名、一列地址、一列类型、一列含义,含义要人话 | 从程序里反推,先做"读"的用途(只解释、不生成) |
| 标签表 | 命名有统一后缀/前缀(_MAG_FUELLSTAND 这类就是"料仓液位") |
先定命名规范,再谈 AI |
| 机架/CPU 配置 | CPU 型号、模块槽位、特殊模块型号 | 拍照 + 订货号,至少让模型知道有哪些模块 |
| 现有程序片段 | 最近一年真正在跑的几个块 | 在线上载(没有符号也先拿到 STL),当成"当前事实" |
| 物理布局说明 | 料仓在哪、什么算"上料"、盘往哪走、执行机构顺序 | 请现场的老师傅口述,你录音整理成一页纸 |
最后一行是全文最容易被忽略、最好用的一条:这张"一页纸的现场说明",比再买一套工具更能提升输出质量。
2)四级台阶怎么映射到你现在的流程
| 论文的分级 | 你厂里对应的动作 | 谁签字 |
|---|---|---|
| L1 咨询 | 问"这个需求在现有硬件上成立吗" | 不用签 |
| L2 生成 | 代码贴进评审单,还不进工程 | 写的人 |
| L3 编译 | 进工程、编译、修完再提 | 编译通过 + 评审 |
| L4 部署 | 下载到 CPU、试自动、试 HMI、试安全 | 现场负责人 |
这四级和我们一直说的"预演 → 编译 → 仿真 → 人确认"是同一根轴,只是论文把"咨询"单独拎出来当第 0 级——这一步其实最省钱,因为它能在你打字之前就否掉一个不存在的需求。
3)三个必须先回答的问题
- "厂上下文"谁来维护? 图纸改一次、加一个模块、换一个传感器,语料就过期了。没有版本管理的厂上下文,比没有更危险(它会一本正经地引用旧标签)。
- 跨品牌怎么办? 论文自己说了不在范围内。现实里一条线四种 PLC,别指望一套上下文通吃——先做单台、单品牌,跑通再复制。
- 编译通过算不算过? 不算。论文明确说功能正确性要 HIL 或专家评审。你们内部的验收单上,编译只是第三级。
4)这套思路最值得抄的一句
不是"让 AI 更聪明",而是"让 AI 先知道你厂里的三件事:有什么、在哪、什么时候算有"。
八、和我们的工具怎么接
论文用的是三菱的 GX Works3 + MCP;博途这边的对应路径是 TIA Openness + MCP。要做同样的事——把工程上下文喂进去、让每一步动作都必须由人发起并留下记录——走 TiaLink(博途 MCP 网关)这条路:它的设计前提就是"预演 → 编译 → 仿真 → 人确认",和你在这篇论文里看到的四级台阶是同构的,只是平台从 iQ-R 换成 S7-1200/1500。
要先把"厂上下文"这一层做起来(读工程、导标签、抽块依赖),从 TIA Forge 总入口进。
边界
- 这是一篇演示型论文,不是评测报告:稿中唯一的"结果"是一段交互实录和一台分选试验台,没有任何定量指标(没有编译通过率、没有任务完成率、没有工时对比)。论文自己写明定量评测是"计划中的工作"。
- 版权:论文标注 © 2026 IEEE,允许个人使用;我们未转载论文的图 3/图 1(演示台照片与界面截图),正文配图改用 Wikimedia 的 iQ-R 机架照片(CC BY-SA 4.0,非论文作者提供,仅型号同系列)。
- 我们未复现:没有三菱 iQ-R、没有 GX Works3、没有跑它的原型系统。文中所有系统行为、界面元素、对话实录均译自论文。
- 演示台细节(铬/红/黑盘、气压+光电、嵌件工位、三个盒子、主动/被动分选)来自论文第 IV-A 节;数字(47%/72%、68%/42.3%、98.6%、94–96%)来自论文第 II 节转述的他人工作,我们未核这些原始论文。
- "四条材料清单""四级到流程的映射""三个必须先回答的问题""五份材料判据"是我们补的工程整理,不是论文内容。
- 论文为预印本(arXiv 2610.28160),正式发表版本可能修改。
来源
- 主源文:Joschka Kersting、Gesa Benndorf《From Code Generator to Engineering Companion: A Plant-aware Agent for PLC Programming》,arXiv 2610.28160,2026-10。https://arxiv.org/abs/2610.28160
- 前作(本文基础):Kersting、Rummel、Benndorf《Vendor-aware industrial agents: RAG-enhanced LLMs for secure on-premise PLC code generation》,IEEE ICIT 2026
- 对照工作:LLM4PLC(ICSE-SEIP 2024)、Agents4PLC(arXiv 2410.14209)、AutoPLC(arXiv 2412.02410)、Spec2Control(arXiv 2510.04519)
- 配图:Wikimedia Commons,Oleg Yunakov,CC BY-SA 4.0
同主题阅读
- AI PLC 编程:99% 成功率在这个行业算灾难
- LLM 写 PLC 程序有多靠谱?PLCWorld 闭环基准实测
- 代码锁在二进制里:AI 改 PLC 工程的四个台阶
- 12 个最受欢迎的 PLC AI 工具:能写代码的多,能进工程的少
本文由汇智网编译整理,转载请注明出处。文中的"我们的整理"与"边界"为编译者补充,不是论文内容。
这是「AI × 工业 / PLC」专题的一部分。完整地图见:AI × 工业 / PLC 完全指南