LLM 写 PLC 程序有多靠谱?PLCWorld 闭环基准实测
GPT-5.5 写 PLC:简单任务 82.7%、难任务 25.1%,且完成率高≠安全违规少。"编译通过"和"产线真能跑"之间隔着 Execution Gap。
一句话结论:韩国东国大学与 MOAI technologies 的团队发布了 PLCWorld——一个把 LLM 生成的 PLC 程序放进闭环产线仿真里考试的基准。核心发现有三个:一是模型在难任务上的成功率会从 82.7% 跌到 25.1%;二是完成率高不等于安全违规少,两者必须分开报;三是通过上游检查的程序里,仍有三到四成随后失败或违规——他们把这叫 Execution Gap。
披露:本文编译自 arXiv 论文《PLCWorld: Benchmarking LLM-Generated PLC Programs in Closed-Loop Plant Simulation》(arXiv:2610.02982v1,2026-10-02 提交,cs.AI),作者 Yunji Kim、Yunseok Lee、Hyunwoo Seo、Jaerim Choi、Woojin Lee,来自 Dongguk University 与 MOAI technologies,CC BY 4.0。所有数据来自论文自述,是仿真环境里的评测,不是安全认证,也不是真机实测;文末"译者注"是本站观点。
为什么"编译通过"不够
LLM 生成 PLC 程序的评测,大多数停在静态层面:能不能编译、能不能通过形式化验证、代码质量如何。但 PLC 控制的本质是时序依赖:发出一条命令,不等于对应的动作完成了。一个依赖操作能不能开始,取决于被控设备和工件的实际状态——也就是"产线状态(plant state)"。
论文开篇的例子很简单:一个夹爪要先夹紧工件、再起升。生成的 ST 程序命令夹爪闭合,等一个固定时间,然后命令起升。如果这次抓取花的时间超过了这个固定间隔——哪怕仍在规定工况范围内——起升就会在工件被夹紧之前开始,工件留在台面上。命令的顺序是对的,但程序没有等待"已夹紧"这个前置状态成立。
发对了命令 ≠ 做成了事。检查这类错误,需要观察"程序发出的命令如何改变设备和工件的状态"——这就是闭环评测的出发点。
PLCWorld 是什么
一个公共的闭环执行环境 + 基准:把 ST(Structured Text,IEC 61131-3 的高级文本语言)程序的执行,和模拟产线的响应、传感器反馈耦合起来。
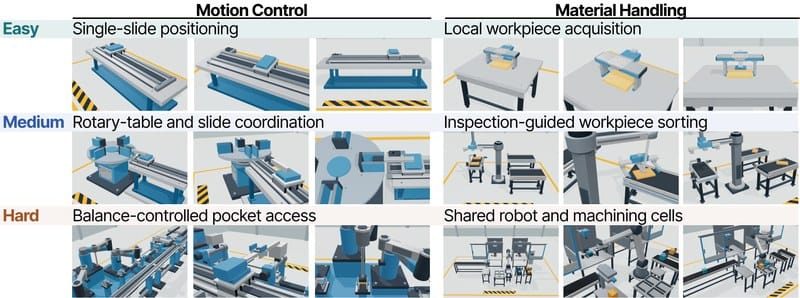
规模与构成:100 个合成任务、473 个注册"任务-条件"对,覆盖运动控制(Motion Control)与物料搬运(Material Handling)两个套件。任务的 I/O 规模随难度急剧上升:
| 套件/难度 | 任务数 | 条件数 | 平均 I/O | I/O 范围 |
|---|---|---|---|---|
| 物料搬运 / Easy | 15 | 46 | 8.0 | 5–12 |
| 物料搬运 / Medium | 20 | 96 | 17.4 | 11–28 |
| 物料搬运 / Hard | 15 | 122 | 57.5 | 37–75 |
| 运动控制 / Easy | 15 | 60 | 8.9 | 7–12 |
| 运动控制 / Medium | 20 | 101 | 20.1 | 12–29 |
| 运动控制 / Hard | 15 | 48 | 128.4 | 64–146 |
| 合计 | 100 | 473 | 37.9 | 5–146 |
难度定义按控制依赖范围分三级:Easy 是单个基本控制功能之内("把滑台移到某位置,确认到位并静止");Medium 是一个 job 内不同功能之间(一个功能的状态条件约束另一个功能的执行,"滑台缩回、转台复位、待静止后接近");Hard 是独立 job 之间——一个 job 的状态约束另一个的推进,典型如两个独立的上下料请求共享摆渡车和转台。
指标协议:Task Success(成功率 SR)与 Safety Violation(安全违规率 SVR)分开报告;另设 Execution Gap——在通过了上游提交检查的程序里,随后出现任务失败或安全违规的比例。
Hard 任务到底难在哪
论文用两个维度解释了“难度上台阶”的含义。一是规模:Hard 运动控制任务平均 128.4 个 I/O 点(64–146),而 Easy 任务平均不到 10 个——这不是“多几个变量”,是上下文管理量级的差别。二是任务族的分布:把 473 对条件按需求族拆开,占比最高的几类是定位与稳定(90)、接近与间隙(60)、抓取与支撑(38)、占用与容量(33)——这几族都是“约束型”需求,同时出现在任务目标和安全约束两侧,这正是 Hard 任务难的来源。
几个注册任务的公开目标(照录):
| 任务 | 套件/难度 | 公开目标 |
|---|---|---|
| MOT-E14 | 运动/Easy | 抑制空吊钩摆动,让小车在当前工作位置静止 |
| MOT-M16 | 运动/Medium | 给刀具循环定位工作台与溜板,全程保持对齐,确认周期完成 |
| MOT-H03 | 运动/Hard | 经提升站、共享摆渡车、移动对接与旋转同步,协调两个独立上料请求 |
| MAT-E06 | 搬运/Easy | 从已对齐料仓推出一个产品并缩回推杆,其余产品保持原位 |
| MAT-M14 | 搬运/Medium | 备好单品、清空供料器,把它按时送入连续移动的接收料仓 |
| MAT-H05 | 搬运/Hard | 在共享转台上协调装配、检测、返工与出料,保持本体-嵌入件配对与检测结果 |
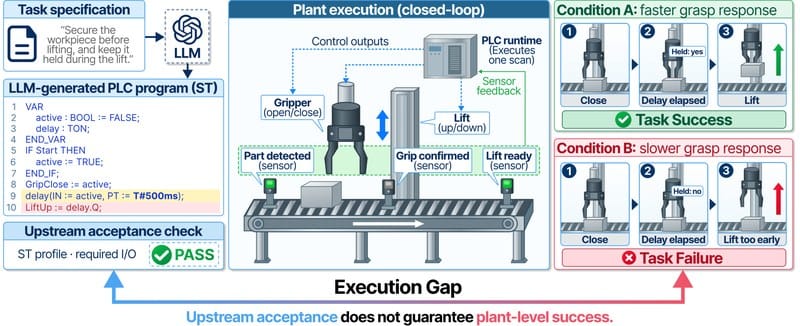
图 1:即使上游检查全部通过,起升仍可能在工件未被夹紧时发生。来源:PLCWorld 论文(原图)。
基准本身怎么验证
评测基准最大的风险是"考题本身有问题"。论文用了四道校验:
- 任务说明:4 名从业者审查公开任务说明的工业合理性、信息充分性、完成与安全的清晰度、难度是否合适;
- 评测器判断:参考程序与替代程序应被接受,542 个定向反例全部能在至少一个注册条件下触发对应的评测器规则;
- 说明-评测器对齐:绑定检查 + 语义检查;
- ST 运行时:重跑 + 跨运行时交叉检查,确认 ST 执行没有跑偏。
实验设计
第一组:直接生成。六个模型——GPT-5.5、GPT-4o、Claude Sonnet 5、Gemini 3.1 Pro、Gemini 3.8 Flash、Qwen3.5-Plus——每个任务做 3 次独立单轮生成:没有工具、没有执行反馈、没有修订、没有择优。
第二组:生成-验证框架。把 LLM4PLC、Agents4PLC、AutoPLC、SemaPLC 四个框架适配到 PLCWorld 上,共享 GPT-5.5 作为底座。
成本在跨"套件×难度"六组均衡的 18 任务共享子集上测(每任务中位数):
| 模型/框架 | 调用次数 | 修订任务数 | Token(k) | 时间(s) |
|---|---|---|---|---|
| GPT-5.5(直接) | 1 | 0/18 | 11.51 | 99.3 |
| GPT-4o(直接) | 1 | 0/18 | 4.45 | 5.9 |
| Claude Sonnet 5(直接) | 1 | 0/18 | 17.00 | 122.3 |
| Gemini 3.1 Pro(直接) | 1 | 0/18 | 19.17 | 118.1 |
| Gemini 3.8 Flash(直接) | 1 | 0/18 | 25.80 | 65.5 |
| Qwen3.5-Plus(直接) | 1 | 0/18 | 19.80 | 250.8 |
| LLM4PLC | 4 | 5/18 | 48.28 | 321.1 |
| Agents4PLC | 5 | 10/18 | 73.11 | 452.6 |
| AutoPLC | 4 | 2/18 | 30.96 | 134.3 |
| SemaPLC | 18 | 10/18 | 523.88 | 230.9 |
主要结果
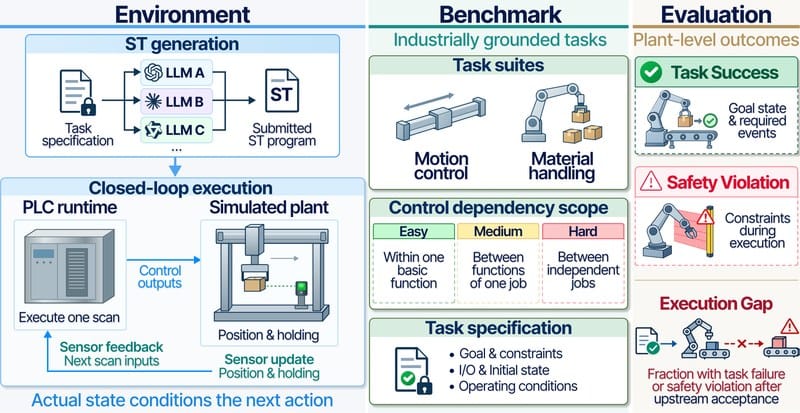
图 2:PLCWorld 框架。来源:论文(原图)。
完整的主结果表(SR=成功率↑,SVR=安全违规率↓,按注册条件数加权;EG=Execution Gap):
| 模型/方法 | MC Easy SR/SVR | MC Med SR/SVR | MC Hard SR/SVR | MH Easy SR/SVR | MH Med SR/SVR | MH Hard SR/SVR | EG↓ |
|---|---|---|---|---|---|---|---|
| GPT-5.5 | 71.1/1.7 | 75.6/7.1 | 18.1/65.2 | 97.8/0.0 | 93.1/1.8 | 27.9/32.2 | 37.88 |
| GPT-4o | 14.4/22.4 | 8.9/42.1 | 0.0/28.6 | 29.0/13.5 | 1.0/21.1 | 0.0/57.7 | 92.75 |
| Claude Sonnet 5 | 75.0/2.3 | 75.9/25.5 | 0.0/73.3 | 88.4/0.7 | 77.4/1.0 | 4.4/51.7 | 50.90 |
| Gemini 3.1 Pro | 78.3/0.0 | 80.9/18.1 | 11.8/65.5 | 94.2/1.5 | 93.4/1.0 | 35.3/52.0 | 36.17 |
| Gemini 3.8 Flash | 95.6/0.0 | 76.9/18.0 | 4.9/72.7 | 98.6/0.0 | 87.5/0.0 | 17.2/32.4 | 32.10 |
| Qwen3.5-Plus | 60.6/6.7 | 55.1/34.9 | 0.0/57.1 | 86.2/2.2 | 46.2/24.1 | 1.6/61.7 | 49.79 |
(MC=运动控制,MH=物料搬运;框架部分另有对照数据,见下文。)
一、难度一上去,成功率崩。按案例数合并两个套件,直接生成的 GPT-5.5 在 Easy 上 SR 82.70%、Medium 84.09%、Hard 上只有 25.10%。其他模型形状类似:Claude Sonnet 5 在运动控制 Hard 上全军覆没(SR 0.00%,SVR 73.33%),GPT-4o 则整体崩塌(物料搬运 Hard 0.00%,EG 92.75%)。
二、完成率高 ≠ 安全违规少。Hard 物料搬运上,Gemini 3.1 Pro 的 SR 比 GPT-5.5 高(35.25% vs 27.87%),但 SVR 也更高(51.95% vs 32.24%)。任务完成度抓不住安全违规,违规率低也不代表完成得好——这就是为什么两个指标必须分开报。
三、生成-验证框架:开销更大,收益不一致。与同底座的 matched direct(GPT-5.5:MC Hard 22.92/70.83)相比,LLM4PLC 和 Agents4PLC 在运动控制 Hard 上 SR 归零(0.00%);AutoPLC 在 Hard 物料搬运上 SR 和 SVR 都改善,但在 Hard 运动控制上两项都变差。四个框架全部比直接生成花更多调用、token 和时间(SemaPLC 中位 18 次调用、523.88k token)。在这组对比里,更高的生成开销没有换来一致的产线级收益。
四、Execution Gap 是实打实的。Gemini 3.8 Flash 的 EG 比 GPT-5.5 低(32.10% vs 37.88%),但它接受的案例更少(1,187 vs 1,399,各占 1,419 个案例),"既成功又无安全违规"的案例也更少(806 vs 869)。Gap 低不等于整体更好,比较必须带上门槛和分母。
失败到底长什么样
论文把进入产线执行后的失败/违规归纳为八种签名(多标签,比例按不利案例池化):
| 组 | 签名 | 表现 |
|---|---|---|
| 完成协议 | 完成时机(最常见) | 到规定期限仍未建立有效完成 |
| 完成协议 | 完成有效性 | 在必要条件满足之前就宣告完成 |
| 完成协议 | 完成保持 | 没能维持要求的完成状态或完成信号 |
| 安全约束 | 执行约束 | 动作与其他命令冲突或违反互锁 |
| 安全约束 | 空间约束 | 违反碰撞、间隙或行程限制 |
| 安全约束 | 资源约束 | 占用、容量、夹持或支撑要求被违反 |
| 要求行为 | 目标达成 | 所需操作或物理目标未达成 |
| 要求行为 | 过程一致性 | 顺序、路径、身份、方向或数量不对 |
一个具体例子:某 GPT-5.5 运动控制程序断言了"完成"输出,但该扫描之后的产线状态不满足完成条件——评测器记"过早完成"。这正是静态检查永远看不到的那类错误。
结论与局限(论文自述)
- PLCWorld 提供的是可复现的闭环评测资源:100 任务、473 对条件、SR 与 SVR 分开判;
- 仿真评测不是安全认证。安全指标只覆盖已评估条件下的指定约束;物理部署需要独立的工程审查与设备特定验证;
- 任务是基于工业控制关系抽象后新造的,不复制任何源程序;保密的工业源程序和工程文档不会公开;
- 作者声明使用了生成式 AI 辅助润色稿件与少量代码修改,作者对最终内容负责。
代码、仿真环境、评测器与基线全部公开:yunji0516.github.io/PLCWorld。
译者注
- 和我们第 43 篇的对应关系。「AI 写 PLC 程序」7 课里把验证分四层:结构校验 → TIA 编译 → 云仿真 → 虚拟 PLC/现场。PLCWorld 做的正是把第三层(仿真)标准化、可复现化:以前各团队自己搭 Factory I/O 场景做闭环验证,现在有了一份公共考卷。它同样只能证明"在已测条件、指定约束下"的行为,向上到现场还有一层。
- 对"AI 写 PLC"类宣传的评测清单。看这类 claims 时,至少问四件事:(1) 报没报 SVR,还是只报成功率;(2) 难任务(跨 job 共享设备)上的数字;(3) 通过上游检查之后的 Execution Gap;(4) 评测条件里有没有注册扫描周期与工况。
- 对工具开发者的启示。四个框架的高开销没有换来一致收益,瓶颈可能不在“多轮修订”本身,而在反馈信号能不能反映产线状态——把执行反馈(而非编译器输出)接进修订循环,是 PLCWorld 给出的方向。
- 边界:合成任务、仿真环境;反例驱动的评测器只覆盖已建模的约束;不要把这里的 82.7%/25.1% 直接当成任何商业工具的真实成功率。
相关阅读:AI × 工业 / PLC 完全指南 | AI 写 PLC 程序,验证才是难点:7 个免费实战课 | 文本生成 SCL:TXT2SCL
Sources
- Yunji Kim, Yunseok Lee, Hyunwoo Seo, Jaerim Choi, Woojin Lee, PLCWorld: Benchmarking LLM-Generated PLC Programs in Closed-Loop Plant Simulation, arXiv:2610.02982v1 [cs.AI], 2026-10-02:https://arxiv.org/abs/2610.02982
- 项目页(代码/环境/评测器):https://yunji0516.github.io/PLCWorld/
- 本站,AI PLC 编程:7 个免费实战课,每课都能验收:https://www.hubwiz.com/blog/ai-plc-programming-7-lessons-verification/
本文由 hubwiz 编译整理,转载请注明出处。
这是「AI × 工业 / PLC」专题的一部分。完整地图见:AI × 工业 / PLC 完全指南