90% 工时没有基准覆盖:Mercor 的 AI 评测地图
29 个基准映射到 18,797 个任务,只覆盖 924 个任务、208 个职业。90% 的美国工时没有基准可测——这张地图也指出了工业控制评测的空白。
一句话结论:我们天天看榜单,却很少问一个更基础的问题--这些基准测的活,是不是真人在干的活。Mercor Research 2026-10-16 发布的《A benchmark map of the US economy》给了个不太好看的答案:把 29 个精选基准映射到美国劳工部 ONET 的 923 个职业、18,797 个任务上:只有 924 个任务(4.9%)被"≥5 条基准提示"覆盖,只有 208 个职业(22.5%)有任务被"≥5 条基准提示"覆盖,22 个职业族里有 6 个完全空白--按工时加权,约 90% 的美国工作时间花在基准几乎没有覆盖的任务上*。
对我们更有用的一点:这张地图同时说明了覆盖偏差的形状——越被 AI 暴露、工资单越大、O*NET 认定越重要的任务,越容易被测到。工业控制这类"AI 暴露度高但工资单小、且有物理世界成分"的活,正好落在空白里。
披露:本文编译自 Mercor Research 的《A Benchmark map of the US economy》与同页 "Methodology" 说明(2026-10-16),并参考其 APEX 基准页面。文中所有覆盖率、分数均为 Mercor 自述口径;本文未独立复算其回归模型,正文两张图表是据其页面公布的数字重绘(原页面图表为交互式,无法直接引用图片),已在图注标明。O*NET 职业/任务分类、LLM 打标与人工校验的细节见原文 Methodology。
一、先看三个数字
| 数字 | 含义 |
|---|---|
| 923 个职业 / 18,797 个任务 | 美国劳工部 O*NET 对美国劳动力的拆分口径(本文的"分母") |
| 29 个基准 / 924 个已覆盖任务 | Mercor 精选的“高质量、经济相关、agentic”基准清单(29 个);其中被 LLM 打标后能对上 ≥5 条提示的 ONET 任务共 924 个(占 18,797 的 4.9%*) |
| 208 / 923 个职业 | 至少有 1 个任务被 ≥5 条基准提示覆盖的职业数;6 / 22 个职业族一个都没有 |
| ≈90% | 按工时加权的结论:美国工作时间中,落在"几乎无基准覆盖"任务上的比例 |
"覆盖"的定义值得单独强调,因为它决定了这张地图偏保守还是偏乐观:一个 O*NET 任务被算作"已覆盖",需要它被映射到至少 5 条基准提示。少于 5 条的,一律不计——因为一两条题目的成绩统计上站不住。
二、覆盖长什么样:先是少数职业族吃饱,再是长尾挨饿
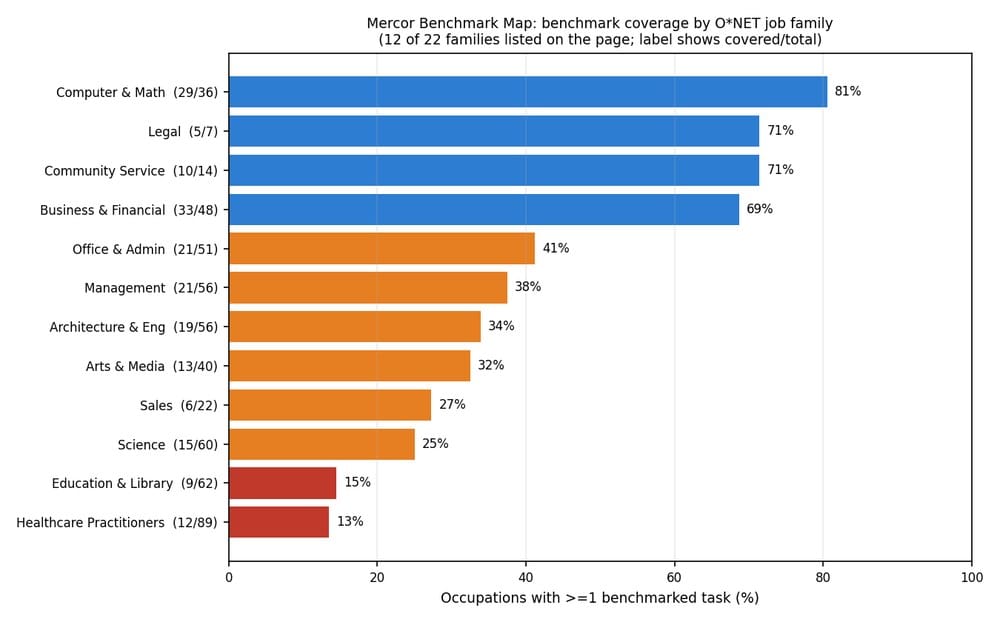
Mercor 在页面上逐族列了 22 个职业族(这里重绘的是页面上半部分列出的 12 个,标签含"覆盖/总数"):
| 职业族 | 覆盖职业数 / 总数 | 覆盖率 |
|---|---|---|
| Computer & Math | 29 / 36 | 81% |
| Legal | 5 / 7 | 71% |
| Community Service | 10 / 14 | 71% |
| Business & Financial | 33 / 48 | 69% |
| Office & Admin | 21 / 51 | 41% |
| Management | 21 / 56 | 38% |
| Architecture & Eng | 19 / 56 | 34% |
| Arts & Media | 13 / 40 | 32% |
| Sales | 6 / 22 | 27% |
| Science | 15 / 60 | 25% |
| Education & Library | 9 / 62 | 15% |
| Healthcare Practitioners | 12 / 89 | 13% |
读法很直接:
- 软件与数学 81%,医疗从业 13%。不是因为医疗不重要,而是因为基准是程序员写的;
- 工程族 34%(建筑与工程 19/56)——这是一个对我们特别重要的一行:工业控制、自动化、制造工程都在这一族里,覆盖率不到平均线;
- 6 个职业族完全空白(原文:只有 6 of 22 job families 没有任何"≥5 条提示覆盖"的职业)。
三、偏差不是随机的:三个可量化的规律
Mercor 用三个 logistic 回归把"为什么是这些任务被测"讲清楚了。三条都值得记住,因为它们能预测下一个基准会测什么:
- AI 暴露度:被 Eloundou et al. (2023) 标记为"AI 暴露"的任务,出现在基准里的概率约是未暴露任务的 6 倍。这合理——基准是为了测 AI 进步,当然先测 AI 最可能干的事。
- 工资单规模:控制 AI 暴露度之后,所在职业的年工资总额越大,任务越可能被覆盖。于是律师的任务被大量覆盖,而同为法律行业、AI 暴露度相近的法务秘书与法庭书记员几乎没人测。
- O*NET 任务重要性(1–5 分):控制职业后,被评为最重要的任务,被覆盖的概率是"最不重要"的 6–10 倍。
三条加起来就是一句工程化的判断:基准资源的分配逻辑与商业逻辑一致——先测"大市场 × 高 AI 暴露 × 高重要性"的交叉区。而这套逻辑的必然结果是:中小工资单的中等收入知识工作、以及带物理世界成分的岗位,长期待在盲区。
四、方法:怎么把"基准"映射到"职业"
如果你要复用这套方法,重点在这五步:
| 步骤 | 做法 | 为什么这样选 |
|---|---|---|
| 1. 分母 | 用 O*NET 的 923 职业 / 18,797 任务 | 唯一覆盖全美的公开职业分类,可对齐 BLS 工资数据 |
| 2. 选基准 | 29 个,见下面五条标准 | 宁可少,也不让"饱和基准"和"答题式基准"混进来 |
| 3. 打标 | 用 LLM judge 给基准里的每条提示标注对应的 O*NET 任务(一条可多标) | 人工标全部提示不现实;但必须校验 |
| 4. 校验 | 在 Mercor 自有 APEX 基准上对照人类专家标注 | 保证 LLM 打标不是"自由发挥" |
| 5. 覆盖率 | 任务被 ≥5 条提示映射才算覆盖;再乘工时占比 | 抗噪:单条题目的分数不可用 |
选基准的五条标准(原文列得很清楚,值得抄进你自己的评测规范):
- 公开可得:至少 25 条公开任务;
- Agentic:要求模型动手做事,而不是回答问题或"指导用户怎么做";
- 经济真实性:任务像企业里真会交给人的活(优先经济价值,而非学术复杂度);
- 经济多样性:每个职业族的基准数量设上限,以抵消"软件工程与研究任务在流行基准里被严重过度代表";
- 难度平衡:排除已被前沿模型打满的饱和基准。
最后一条与第四条其实是一对矛盾:为了多样性要限流,为了不饱和要挑难的。Mercor 自己承认这是权衡——限流会让最热的族(软件工程)的覆盖率被低估,排除饱和基准又可能低估"容易任务"的覆盖。
五、能不能算"这个模型能不能干我这行":一次诚实的失败
这是全文最值得学的部分:Mercor 试了一个很自然的想法——按 O*NET 任务重新加权,让每个任务权重相同(而不是让被多测的任务吃掉全部权重),再看分数变不变。
测试对象是他们的 APEX 基准,四个职业:投资银行、法律、会计、软件工程。
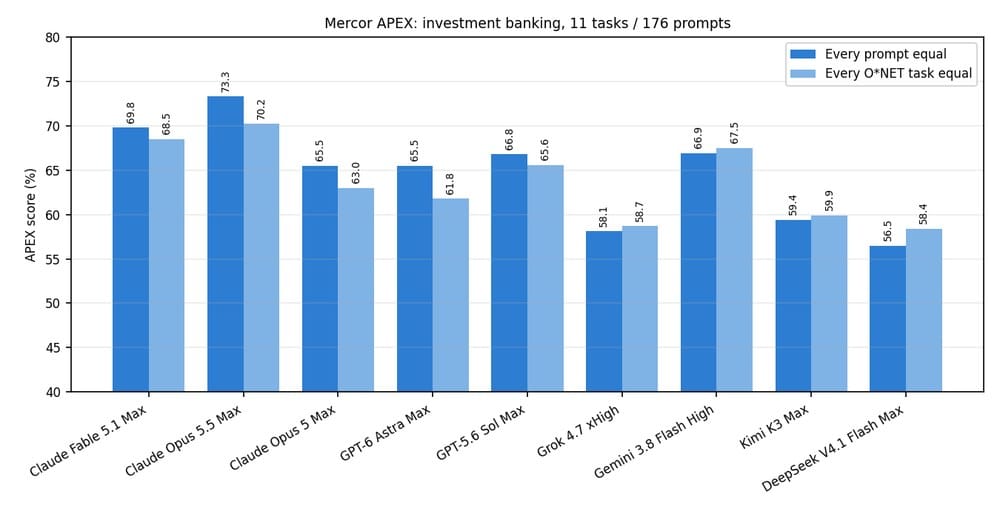
投资银行这一格的数据(11 个任务、176 条提示):
| 模型 | 每条提示等权 | 每个 O*NET 任务等权 |
|---|---|---|
| Claude Opus 5.5 Max | 73.3% | 70.2% |
| Claude Fable 5.1 Max | 69.8% | 68.5% |
| Gemini 3.8 Flash High | 66.9% | 67.5% |
| GPT-5.6 Sol Max | 66.8% | 65.6% |
| Claude Opus 5 Max | 65.5% | 63.0% |
| GPT-6 Astra Max | 65.5% | 61.8% |
| Kimi K3 Max | 59.4% | 59.9% |
| Grok 4.7 xHigh | 58.1% | 58.7% |
| DeepSeek V4.1 Flash Max | 56.5% | 58.4% |
结论是否定式的、但非常有价值:
- 加权几乎不改变分数。排名也基本稳定(最大变动在 GPT-6 Astra:65.5→61.8);
- 原因是:能进入加权平均的任务,表现本来就差不多;
- 更关键的限制:这四个职业里,不到 1/3 的 O*NET 相关任务有足够的 APEX 覆盖,能进入计算;
- 所以"我可以给你一个按职业算的模型分数"这件事,目前还不成立——不是方法错,是数据不够。
这种"把失败的实验也写出来"的做法,比多一个排行榜有用得多:它告诉你当前业界离"按职业评估模型"还有多远。
六、四个还没解的问题(原文自述)
Mercor 明确列了四条,我认为每一条都能直接对应到工程决策:
- 统计功效太低。任何单个 ONET 任务只有很少的题;一两道烂题就能把分数带偏*。→ 别用单一任务分数做采购决策。
- 难度与保真度无法加权。有的基准饱和了(老是过),有的评分粗糙、有错题、可被 reward hack,目前没有"按质量加权"的机制。→ 榜单分数天然混入了基准质量。
- "自动化"评测能不能推广到"增强"。现实里模型主要被人类当助手用,而不是端到端替代岗位,测量"增强"的方法还没规模化。→ 这正是所有"AI 生产力提升 X%"研究的软肋。
- 不是每个职业都能用基准测。Dingel & Neiman 估计只有 37% 的美国工作能完全远程完成,约 63% 的岗位涉及物理世界成分,难以搬进当前基准。→ 工业/制造/现场运维的评测,需要另一套(仿真 + 真机)路线。
第四条对我们这一行尤其重要。工业控制恰恰是"AI 暴露度高 + 工资单小 + 强物理世界"的典型:从这张地图看,它是双重盲区。
七、对我们的三条直接含义
1)"AI 写代码很强"与"AI 能操作产线"是两件不同的事,而且第二件没被好好测过。 软件与数学族覆盖率 81%,建筑与工程族 34%;再叠加"物理世界 63%"这条,结论是:工业 AI 的能力宣称,缺一套公共考卷。这也是我们此前追踪 PLCWorld 那类闭环基准的原因——它在补的正是这一格(仿真产线 + 传感器反馈 + 完成率/安全违规分开报)。
2)看榜单时要问"分母是什么"。 同一个模型,在"软件工程饱和基准"上和在"职业加权、任务随机抽样"的评测上,会得到完全不同的名次。看到"XX 在 12 个基准上领先"时,先问:这 12 个基准覆盖了哪些任务,权重怎么给。
3)给团队建评测集的四条纪律(从这套方法里能直接抄的):
- 先定分母:你的评测要代理哪一类任务?照 O*NET 或你们自己的任务分类写清楚;
- 每条题目标注任务,一个任务至少 5 题,否则别单独报这个任务的分数;
- 限流:别让最容易写的任务(写函数、改 bug)占满整个集合;
- 排除饱和题,并且记录题目的质量(谁写的、怎么判分、有没有已知错题)。
八、边界
- 29 个基准不是全集。作者明说这是"initial list",任何不完整的清单都会低估覆盖率,而且偏差幅度无法界定;结论是"provisional(暂定)"。
- 限流策略会让最热门族(软件工程)的覆盖率被低估,排除饱和基准又可能低估简单任务的覆盖——两个方向的偏置都在。
- LLM 打标靠 APEX 上的人工标注校验,但校验集本身有限;"经济真实性"这类标准难以形式化,选择带主观性。
- "90% 工时"依赖第三方工时估计(Hatgis-Kessell et al. 的 LLM 派生任务工时占比),换一套工时口径,数字会变。
- 本文两张图是据原文数字重绘,不是原文图表;数值以原文交互页面为准。
九、一句话带走
AI 评测的真实问题,不是"分数不够高",而是"考卷没覆盖到大多数人的工作"。 在补齐之前,任何"AI 能替代 X% 岗位"的说法,都应该先回答一句:X 那部分工作,被谁、用什么题、测过几次?
相关阅读:AI 基建 / 评测 / 安全完全指南 | LLM 写 PLC 程序有多靠谱?PLCWorld 闭环基准实测 | Anthropic 就业报告:AI 正在怎样改写招聘与产出 | Muse Spark Open:816B 开源权重,两台 Mac Studio 跑起来
Sources
- Mercor Research, A benchmark map of the US economy, 2026-10-16:https://www.mercor.com/research/labor-index/benchmark-map/
- 方法学与基准清单(同页 Methodology / Benchmark Index 标签):https://www.mercor.com/research/labor-index/benchmark-map/#methodology
- Mercor APEX 基准:https://www.mercor.com/apex
- O*NET 职业数据库(美国劳工部):https://www.onetonline.org/
本文由 hubwiz 编译整理,覆盖率与方法引自 Mercor 原文,两张图为据其数字重绘,转载请注明出处。
这是「AI 基建 / 评测 / 安全」专题的一部分。完整地图见:AI 基建 / 评测 / 安全完全指南