Muse Spark Open:816B 开源权重,两台 Mac Studio 跑起来
816B 总参、42B 激活、1M 上下文,两台 Mac Studio 就能在本机跑。拆参数、基准得分、许可证,也拆它哪里没赢。
一句话结论:2026 年 10 月 15 日,Meta 放出 Muse Spark Open 的权重——816B 总参数、42B 激活、1M token 上下文、原生多模态,官方称其为"迄今最强的美国开放权重模型"。真正值得关注的是后半句:它能在两台 Apple M5 Ultra Mac Studio 上整机跑起来,也就是"1TB 统一内存当一台超算用"。但把基准表摊开看,它在编码类 harness 基准上并没有赢(Terminal-Bench 2.1 输给 Kimi K3 与 GLM 5.3 近 9 分),强项集中在 Agent 与知识推理。想拿它替换云端 API 之前,先把"赢在哪、输在哪、许可允许你做什么"三件事分开看。
披露:本文编译自 Meta AI Research 官方博客《Introducing Muse Spark Open, The Most Capable US Open-Weight Model to Date》(2026-10-15)与其基准记分卡(benchmark-scorecard-dark-v6.png),并参考 Apple ML Research 的 MLX 分布式推理文(2026-10-16)与 Hacker News 当日讨论(919 点)。文中所有性能与参数均为厂商自述,本文未做独立实测;记分卡里的对比模型部分来自各自厂商自报口径,harness 不同(Terminal-Bench 明确注明用 Terminus 2 agent,DeepSWE 标注"best available / self reported"),横比只作量级参考。模型权重与评测报告:见文末来源。
一、规格:一个"能塞进两台桌面机"的 816B
先把账面数字摊平:
| 项目 | 数值 | 意味着什么 |
|---|---|---|
| 总参数 / 激活参数 | 816B / 42B(约 5.1%) | MoE 架构,单 token 只走一小片专家,显存看总量、算力看激活 |
| 上下文 | 1M token | 整仓代码、长任务轨迹、长时间会议记录可以不切块 |
| 模态 | 原生多模态(natively multimodal) | 不是"文本模型外挂视觉编码器",训练期就带图像 |
| 定位 | 编码与 agentic 工作、长程任务、多步推理 | 官方表述:"Built for coding and agentic work" |
| 权重 | Hugging Face / SageMaker / GCP Model Garden / Microsoft Foundry | 官方四处分发,非"仅限研究申请" |
| 许可证 | Muse Model License(有限商业条款) | "many developers 可免费商用"——注意不是 OSI 开源许可证 |
一句提醒:"开放权重"不等于"开源"。权重可下载、可自托管、可微调,但许可证是自定义的商业条款,不是 Apache 2.0。/ 前一个月的 DeepSeek DeepInfer 用 Apache 2.0 放引擎,这一份是权重 + 条款的组合,两者风险面完全不同,落地前请法务过一遍条款正文。
官方为什么强调"桌面"
桌面跑 816B 的算术在这里:Apple M5 Ultra 的统一内存单机最高 512 GB,两台就是 1 TB;M5 Ultra 的内存带宽 1.2 TB/s。粗算一下权重体积:816B 参数按 4 bit 存储约 408 GB,再留出 KV cache 与运行时开销,1 TB 的池子刚好能装下——官方原话是“两台 Mac Studio 表现得像一台拥有 TB 级统一内存的超算”,而带宽决定了每 token 能多快把要用的那一小片读出来。
这也是本篇最容易被误读的地方:它不是"你的笔记本能跑 816B",而是"两台顶配 Mac Studio 能跑"。单机、单卡、消费级显卡都不在官方给出的组合里。
二、基准:Agent 与知识领先,编码没赢
官方记分卡把 11 个基准分四组。下表的对比列是同一张表里的其他模型(Inkling、Nemotron 3 Ultra、Beam、Mistral Large 4、Qwen3.8-2.4T-A95B、GLM 5.3、Kimi K3),"—"表示该模型未报此项。
Agentic
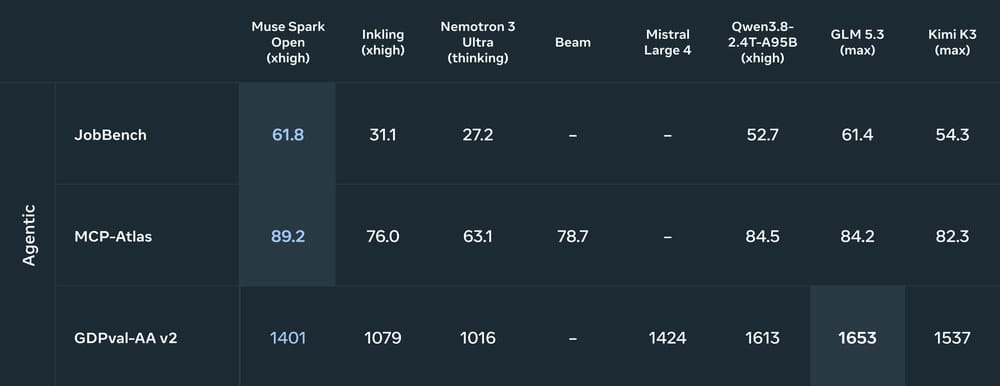
| 基准 | Muse Spark Open | Inkling | Nemotron 3 Ultra | Beam | Mistral Large 4 | Qwen3.8-2.4T-A95B | GLM 5.3 | Kimi K3 |
|---|---|---|---|---|---|---|---|---|
| JobBench | 61.8 | 31.1 | 27.2 | — | — | 52.7 | 61.4 | 54.3 |
| MCP-Atlas | 89.2 | 76.0 | 63.1 | 78.7 | — | 84.5 | 84.2 | 82.3 |
| GDPval-AA v2 | 1401 | 1079 | 1016 | — | 1424 | 1613 | 1653 | 1537 |
三个读法:
- JobBench 是"差距最大"的一项:61.8 vs Inkling 31.1、Nemotron 27.2——接近两倍。但同时 GLM 5.3 是 61.4,只差 0.4 分,说明这不是"独一份的能力",而是"第一梯队里多了一个开放权重选手"。
- MCP-Atlas 89.2 是目前表里最高,比第二名 Qwen 高 4.7 分。MCP 工具调用的准确率是 Agent 落地最硬的一环,这一项领先比 JobBench 更有意义。
- GDPval-AA v2 它排第四:GLM 5.3(1653)> Qwen(1613)> Kimi(1537)> Muse(1401)。GDPval 系列偏"真实职业产出",这一项落后说明它在"交付物像不像专业作品"上还不是最前。
知识 & 推理
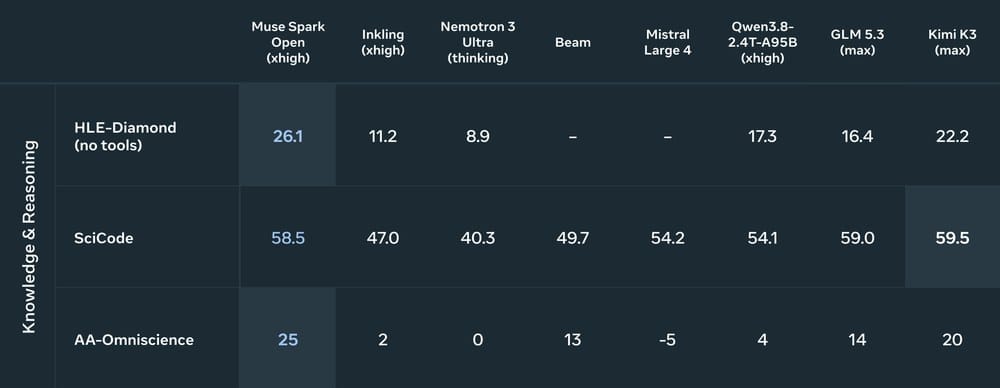
| 基准 | Muse Spark Open | Inkling | Nemotron 3 Ultra | Beam | Mistral Large 4 | Qwen3.8-2.4T-A95B | GLM 5.3 | Kimi K3 |
|---|---|---|---|---|---|---|---|---|
| HLE-Diamond(无工具) | 26.1 | 11.2 | 8.9 | — | — | 17.3 | 16.4 | 22.2 |
| SciCode | 58.5 | 47.0 | 40.3 | 49.7 | 54.2 | 54.1 | 59.0 | 59.5 |
| AA-Omniscience | 25 | 2 | 0 | 13 | -5 | 4 | 14 | 20 |
- HLE-Diamond 26.1 是表里最高,且是"不用工具"的口径。这是它最能站住的一项:难知识题、纯模型能力、不靠检索。
- AA-Omniscience 25 也是最高,而且第二名 Kimi 只有 20、Mistral 甚至是 -5(该基准会惩罚"自信地答错")。负分说明:这类"知道自己不知道"的评测,比常识问答更能区分模型。
- SciCode 它没赢:59.5(Kimi)> 59.0(GLM)> 58.5(Muse)。差距很小,但方向一致——科学计算/数值代码这类,它不是最强的。
编码(harness 基准)
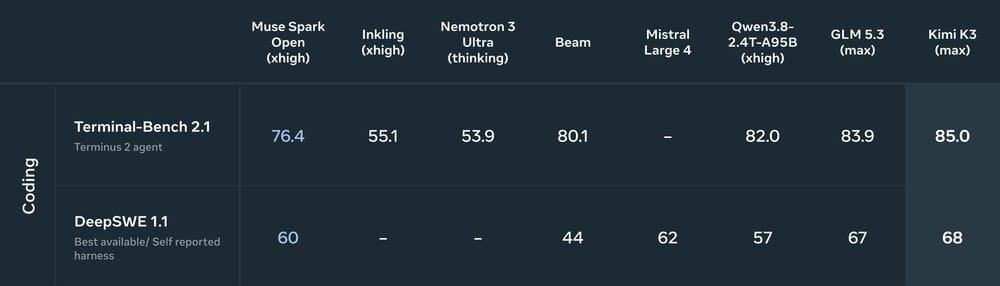
| 基准 | Muse Spark Open | Inkling | Nemotron 3 Ultra | Beam | Mistral Large 4 | Qwen3.8-2.4T-A95B | GLM 5.3 | Kimi K3 |
|---|---|---|---|---|---|---|---|---|
| Terminal-Bench 2.1(Terminus 2 agent) | 76.4 | 55.1 | 53.9 | 80.1 | — | 82.0 | 83.9 | 85.0 |
| DeepSWE 1.1(best available / self reported) | 60 | — | — | 44 | 62 | 57 | 67 | 68 |
这是全表里最该冷静看的一组:
- Terminal-Bench 2.1 上它 76.4,排到第五,落后 Kimi K3 8.6 分、GLM 5.3 7.5 分;
- DeepSWE 1.1 上 60,落后 Kimi 8 分、GLM 7 分;
- 换句话说,"编码与 agentic"是它的定位,但公开的端到端编码 harness 基准目前是竞品领先。定位与榜单不一致时,先信榜单,再看评测口径(后面"边界"一节展开)。
多模态(带工具)
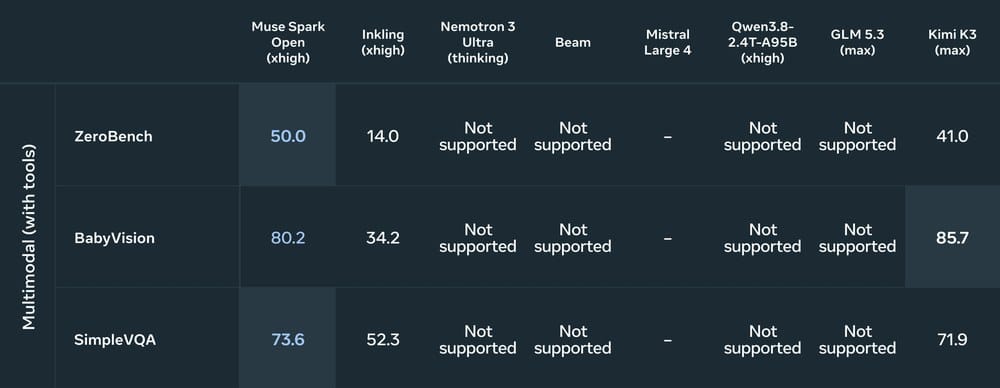
| 基准 | Muse Spark Open | Inkling | Nemotron 3 Ultra | Beam | Mistral Large 4 | Qwen3.8-2.4T-A95B | GLM 5.3 | Kimi K3 |
|---|---|---|---|---|---|---|---|---|
| ZeroBench | 50.0 | 14.0 | 不支持 | 不支持 | — | 不支持 | 不支持 | 41.0 |
| BabyVision | 80.2 | 34.2 | 不支持 | 不支持 | — | 不支持 | 不支持 | 85.7 |
| SimpleVQA | 73.6 | 52.3 | 不支持 | 不支持 | — | 不支持 | 不支持 | 71.9 |
多模态是"原生"最直接的变现:表里能跑 ZeroBench 的模型只有两个(Muse 50.0、Kimi 41.0),BabyVision 上 Kimi 反而更高(85.7 vs 80.2)。这一组的价值不在排名,而在能比较的对手太少——原生多模态 + 开放权重,目前就这几个选手。
三、官方怎么用它做"真活"
官方给了两个"跑在自己机器上"的端到端例子,比基准更有说服力(也都是厂商自述):
- Muse Code + Muse Spark Open 改一个真实 iOS 项目:给开源 Mastodon 客户端 Ice Cubes 提改动——修 bug、加功能、跑完整构建,全程在设备本地。
- 驱动 DaVinci Resolve 剪片:模型逐帧看素材挑出最好的片段,并裁成竖版。这条最能说明"原生多模态 + 长上下文"的组合价值:视频帧是连续图像输入,切点决策需要跨帧记忆。
这两件事的共同点:输入重、上下文长、需要边看边动手。反过来说,如果你的任务是"跑一条命令改一个函数",那 Terminal-Bench 那组的落后更值得在意。
四、工程细节:SGLang 里的 Helion 内核与一条很窄的硬件路线
| 维度 | 官方说法 | 落地含义 |
|---|---|---|
| 推理引擎 | SGLang、vLLM、TensorRT-LLM、HF Transformers、Apple MLX、llama.cpp、Unsloth | 主流栈都能挂,选哪个看你现有部署 |
| 内核优化 | SGLang 内自带可自动调优的 Helion GPU 内核,1.03–3.95× 内核级加速(NVIDIA / AMD),AMD MI350 端到端 +3% | 加速主要发生在 kernel 层,"端到端 3%"是需要被记住的那个数 |
| 硬件 | 优化覆盖 AMD、Apple、Intel、NVIDIA | 比"只吃 CUDA"的开放模型友好 |
| 微调 | PyTorch / TorchTitan | 想 SFT 走官方路径,不用自己拼训练栈 |
| 托管 | Baseten、Fireworks、Groq、Modal、Nebius、OpenRouter、Together | 不想自建就用托管,代价是又回到"API 依赖" |
"内核 1.03–3.95×,端到端 +3%"这组数字值得单独讲。它几乎是所有推理引擎宣传的缩微版:kernel 级加速的跨度可以很漂亮,但经过调度、批处理、显存搬运之后,端到端收益会被摊平。做容量规划时,用端到端数字,不要用 kernel 数字。
五、许可与安全:两句必须看清的话
- 许可:Muse Model License,"limited commercial terms",官方说"许多开发者可以免费商用"。这既不是 Apache 2.0,也不是"研究专用"。要看的是:商用规模门槛、是否要求署名、是否限制再分发/蒸馏、是否允许用于训练其他模型。这些条款直接决定你能不能把它放进产品,比基准分数重要。
- 安全:官方称这是"开放权重的自有考量",因此加了额外的安全后训练,并按 Meta Superintelligence Scaling Framework 评估了最严重风险类别,"达到了发布门槛"。细节在 model card 与即将发布的完整评测报告里。
对自托管用户的实际提醒:开放权重意味着安全策略也在你手上。云端 API 的"护栏"是服务方的责任,落到本地之后,拒答策略、审计、内容过滤、越权工具调用拦截,都得自己配。
六、你该不该动:一张决策表
| 你的情况 | 建议 |
|---|---|
| 有 2× Mac Studio(M5 Ultra,各 512GB)且要数据不出内网 | 值得试:这是目前唯一"官方背书 + 现成 MLX 路径"的 816B 级桌面方案 |
| 只有一台 Mac / 消费级显卡 | 不合适:816B 的权重总量摆在那,量化也塞不进 |
| 主力是端到端编码 agent(长任务、改仓库) | 先别换:Terminal-Bench / DeepSWE 上它不是第一 |
| 主力是 MCP 工具编排、多步 Agent 流程 | 值得试:MCP-Atlas 目前表内第一 |
| 需要长上下文吞整仓/整份文档 + 看图看视频帧 | 值得试:1M 上下文 + 原生多模态,这两个组合目前少见 |
| 需要"能自证不知道"的问答(避免幻觉答错) | 值得试:AA-Omniscience 25 分全场最高,Mistral 甚至是 −5 |
| 要 Apache 2.0 级别的许可自由 | 不合适:先让法务读 Muse Model License |
| 想在生产里省钱 | 算清楚:两台顶配 Mac Studio 的资本开支 vs 你现在的 API 账单,再谈"省" |
七、边界:这四条别忽略
- 全是厂商自述。本文没有复现任何一项基准;同一模型在不同 harness(agent 框架、重试策略、工具集)上分数可以差出十几分。
- 对比对象口径不一。Terminal-Bench 注明 Terminus 2 agent;DeepSWE 标注"best available / self reported"。横比只用于判断量级,不可用于采购决策的最后一票。
- “最美国开放权重”是市场表述。同一张表里的 GLM 5.3、Kimi K3、Qwen3.8-2.4T-A95B 在编码类基准上更强——地缘标签不改变分数;它们的权重是否开放、以何许可开放,请逐个核对(本文不代做结论)。
- 桌面跑 ≠ 生产跑。两台 Mac Studio 的可用性、故障恢复、并发、监控,和机房里的推理集群不是一回事;把桌面方案放进生产,先想清楚"这台机器挂了怎么办"。
相关阅读:本地 & 自托管 LLM 完全指南 | DeepInfer 开源拆解:DeepSeek 生产推理引擎里有什么、缺什么 | Qwen3-8B 微调做提示词难度路由 | 90% 工时没有基准覆盖:Mercor 的 AI 评测地图
Sources
- Meta AI Research, Introducing Muse Spark Open, The Most Capable US Open‑Weight Model to Date, 2026-10-15:https://research.meta.ai/blog/muse-spark-open
- 基准记分卡(原文图片):https://research.meta.ai/articles/muse-spark-open/benchmarks/benchmark-scorecard-dark-v6.png
- 权重集合(Hugging Face):https://huggingface.co/collections/meta-models/muse-spark-open
- Hacker News 讨论(2026-10-15,919 点):https://news.ycombinator.com/item?id=50107379
- Apple ML Research, Muse Spark Open with MLX on Mac Studio(2026-10-16):https://machinelearning.apple.com/research/mlx-distributed-inference
本文由 hubwiz 编译整理,参数与基准均引自官方自述,未做独立实测,转载请注明出处。
这是「本地 & 自托管 LLM」专题的一部分。完整地图见:本地 & 自托管 LLM 完全指南