AI 算力不是堆芯片:Google 的 token 产能每半年翻一倍
10 万张卡跑一个训练,一小时可能挂几次。Google 的答案不是买更多卡:提高 goodput,让每瓦交付更多有用 token。
一个训练任务跑到 10 万个加速器的规模,故障就不再是意外,而是日常——一天几次,甚至一小时几次。每次中断都要检测问题、从检查点恢复、把一部分计算重做一遍。
这就是 Google 的 AI 基建首席技术官 Amin Vahdat 在那期 Training Data 播客里反复强调的那件事:决定 AI 基础设施产出的,不是某颗芯片多快,而是整个系统在故障、恢复、供电之间还能交付多少有用计算。
作者 Guru Chahal 在 2026-10-12 把 7 个要点整理了出来。下面是完整编译。
一、峰值 FLOPS 是最容易报的指标,也是最会骗人的那个
几十年来,数据中心是围绕"容纳不同代的服务器、存储和网络设备"来设计的:一栋楼通常有 25–30 年寿命,所以灵活性很重要。
AI 把这个前提推翻了。
一个常规的存储机架可能消耗 10–40 千瓦。现代 AI 加速机架要几百千瓦,而业界已经在讨论兆瓦级的机架。需求差得这么远,再为"未来所有可能的配置"设计一栋楼,就变得又贵又低效。Google 的做法是让机房的配电、冷却、网络和它将要装进去的硬件一起设计。
同一套逻辑延伸到性能测量上。Amin 认为,峰值 FLOPS 是衡量 AI 基础设施生产率的一个不完整指标。他更愿意用 Google 内部叫 goodput 的口径:扣掉失败、恢复和其他低效之后,系统真正交付的有用计算。
为什么这个差别在大规模下是决定性的?考虑一个跨 10 万个加速器的训练任务。在这个量级上,每天有几处东西坏掉是常态,甚至每小时都有可能。每次中断都有代价:检测、从检查点恢复、重算。
于是结论很硬:一个理论性能更高的系统,交付的有用工作可能少于一个理论性能低但更可靠、恢复更快的系统。
这也把几件"运维的事"重新归类了——调度、可观测性、检查点、故障恢复,都是性能方程的一部分,不是给性能擦屁股的后勤。而优化的单位,正越来越从"单颗加速器"变成"整个 AI 集群"。
二、机架从 40 千瓦到 1 兆瓦:机房得跟着芯片一起改
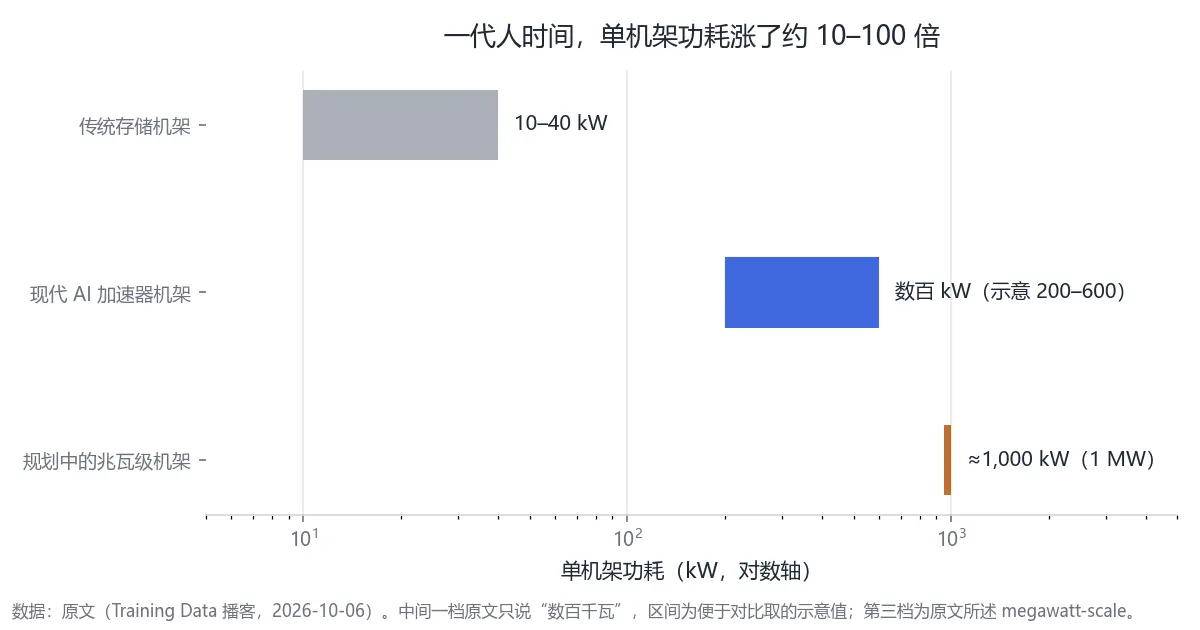
图 1:据原文数字重绘。传统存储机架 10–40 kW,现代 AI 加速机架数百 kW,业界已在讨论兆瓦级机架。
这张图里最容易被忽略的是最后一行。40 千瓦的机架,风冷还撑得住、供电改造还算常规工程;到 1 兆瓦,配电、冷却、承重、消防全都换一套逻辑,而这套逻辑的交付周期是建筑级的,不是机架级的。
所以"芯片越来越快"在工程上会撞到一堵墙:你不能先盖楼再决定楼里装什么。 这也是为什么 Google 要把机房和硬件一起设计——它不是想省钱,而是按老办法盖出来的楼装不进下一代机架。
三、token 产能每半年翻一倍,但不是靠芯片翻倍
Google 内部定了一个相当激进的目标:大约每六个月,把有效的 token 生成能力翻一倍。
注意,这不是"芯片数量翻倍"。
Amin 的解释是,提升的很大一部分来自模型架构、编译器、运行时和服务软件。更好的模型能用同样的计算给出更多智能;更好的基础设施软件能从已有的硬件里榨出更多有用工作。
他甚至认为,在"每瓦智能"这件事上,模型与软件的改进贡献经常超过硬件本身的进步。
这是一个容易被行业注意力盖掉的区分。所有人都在盯着每一代新的 GPU 和 TPU,但软件的改进可以在多代硬件上复利,包括那些已经部署出去的芯片。
一个具体证据:Google 有些 TPU 在部署七八年之后仍然满负荷使用——而硬件通常按大约六年折旧。不是每个负载都需要最新的加速器,老芯片在软件改进延长它们的可用期时,仍然可以是经济上划算的。
由此得到的推论也很反直觉:把存量算力的生产率提上去,可能和新增容量一样重要。
四、专用芯片是在押注未来
作者说他最喜欢的一段,是 Amin 谈"专用化 vs 灵活性"的取舍。
专用硬件能在性能和能效上带来实质提升,但硬件越专用,就越不灵活。难点在于:你被优化的那个负载,在芯片的整个生命周期里还会不会同样重要?
Google 2013 年开始做 TPU,最初瞄准的是推理。此后架构经过多代 AI 负载的演进,包括 transformer 和大规模训练。有意思的是,Amin 说 TPU 底层的计算原语一直相当稳定——即使模型架构在变,AI 计算仍然主要依赖一组共同的线性代数运算。
现在 Google 把专用化又往前推了一步,第八代有两颗芯片:
- TPU 8i,为推理优化。
- TPU 8t,为训练优化。
经济性高度取决于预期的负载构成。如果推理只占未来需求的 2–5%,单独做一套推理架构就不合算;如果占到 30–60%,这笔账就很有说服力。两颗芯片都保留了跑另一类负载的能力,留了一些灵活性。
这对半导体创业公司是一条原则。问题不是"定制硬件能不能加速某个负载",而是"这个负载在几年后——芯片真正部署的时候——是否还足够大、足够持久"。在 AI 里,算法演进的速度远快于芯片开发周期,所以这个预测很难。
五、软硬件协同设计,可能是 Google 最大的优势
Amin 描述 Google 基础设施团队怎么和 DeepMind 合作的那段,信息量最大。
Google 的芯片架构师和 AI 研究者一起做硬件与模型设计。有时候是在临近流片(tape-out)时改芯片,因为某个模型优化如果能得到额外的硬件支持,收益会非常显著;另一些时候反过来,让模型或软件去适配硬件。
这些决定都是取舍:改硬件可能大幅提升性能,但会把流片推迟。团队需要按整个系统来评估收益,而不是按某一层。
Google 能做这种取舍,是因为它控制了栈的绝大部分:模型、编译器、芯片、网络、数据中心。大多数公司只在一两层里干活。
垂直整合的好处,不是"我自己造芯片"这句话,而是优化能在多层之间复利:模型架构的改动可能降低内存需求,编译器的改进可能提高加速器利用率,网络的改进可能减少训练中断。每一个改进都让其他改进更值钱。
当然有代价。通用基础设施提供可移植性、灵活性和更大的软件生态。但当 AI 负载变得更大、更贵时,优化整个系统的经济收益就越来越有分量。
六、网络和可靠性,已经是性能公式的一部分
大的 AI 集群本质上是一台横跨几千到几万个加速器的分布式计算机。连接这些加速器的网络,因此就是计算架构本身。
Amin 讲了 Google 用的光交换(optical circuit switching):通过改变光走的路径,重新配置物理连接。
一个关键用途是故障恢复。当一个机架坏掉,Google 可以用光交换把负载重新接到备用容量上,而不是永久性地削掉集群的一部分算力。这些连接的重新配置可以在毫秒级完成。
在前沿训练的规模上,这个能力会实实在在地提高 goodput。
这也是"只看单芯片性能会漏掉大部分真相"的又一个例子:网络拓扑、带宽、时延、拥塞管理、故障恢复,每一个都在决定一个集群到底交付多少有用计算。
七、Agent 会改变基础设施需求的结构
今天关于 AI 基础设施的讨论,大部分围着 GPU 和 TPU 转。但 Amin 预期 agentic AI 会改变需求的构成。
一次常规推理请求,可能是生成一个回答然后返回给用户。一个长时间运行的 agent 则可能执行上千步:调用工具、跑代码、检索信息、维护状态、和外部系统交互。
这就不只是加速器的事了:
- CPU 变得重要,因为要执行工具、做编排。
- 存储变得重要,因为要维持状态和中间结果。
- 网络变得重要,因为 agent 要跟一堆分布式服务打交道。
换句话说,agent 负载可能把需求推向更完整的数据中心基础设施栈。这件事特别值得注意的地方在于:agent 的基础设施需求和模型训练可能很不一样。 下一波 AI 基础设施投资,可能分散在比"加速器"多得多的品类里。
八、电力是最终的约束
尽管芯片、模型、软件都在飞速创新,Amin 一再回到电力这个根本约束上。
AI 算力可以通过更高效的硬件和软件来增长,但物理上的扩张最终必须有电。而在需要的规模上拿到电,很难。
发电容量、输电设施、变电站、并网,这些动辄要几年。Google 通常更愿意和电力公司合作,而不是自己去运营吉瓦级的发电。
这让"电什么时候能到位"和"基础设施效率"变成了越来越重要的经济考量。它也解释了 Amin 为什么强调 goodput per watt:目标不是最大化理论算力,而是最大化每消耗一瓦所交付的有用工作。
当行业开始讨论兆瓦级机架和越来越大的 AI 集群时,这个指标就变成关键指标。
访谈里还聊到了更投机的可能,比如把数据中心放到轨道上。它们是否经济上可行还不确定,但会被拿出来讨论这件事本身,就反映了这个行业在电力和基础设施上面临的压力有多大。
九、原文的三条结论
作者在结尾给了三个更宏观的观察。
第一,竞争的单位正在从部件转向系统。 一个 AI 集群的经济性取决于模型、软件、芯片、网络、可靠性和电力之间的相互作用。孤立地优化任何一个部件,都越来越不够。
第二,优化可能和扩张同样重要。 行业正在向新算力投入巨额资本,但提升存量基础设施的生产率同样能产生可观的经济价值。那些提高利用率、可靠性和推理效率的软件,值得和下一代硬件拿到同样的注意力。
第三,专用化创造机会,但预测负载的持久性是关键。 定制芯片能带来实实在在的性能和能效收益,难的是找出那些在多年硬件开发与部署周期里仍然足够大、足够稳定的负载。
作者说他最大的收获是:AI 基础设施应该越来越多地按"每美元、每瓦交付多少有用智能"来评价,而不是按加速器数量或峰值 FLOPS。 这是一种更麻烦的测量方式,但它离真正决定哪种架构会赢的经济学近得多。
十、我们的整理:把"买卡的账"换成"交付的账"
这篇文章好用的地方,是它换了一套问法。我们把它压成一张对照表、一个量级示意和三条能抄的做法,最后是边界。
一张对照表:同样的问题,换一种问法
| 你常被问到的指标 | 换个问法 | 差在哪 |
|---|---|---|
| 峰值 FLOPS / 有多少张卡 | goodput:扣掉故障与恢复后还剩多少 | 大规模下故障是常态,差值就在这里流失 |
| 机架多少 kW | 每兆瓦能交付多少 token | 电和并网的周期以年计,不是以季度计 |
| 硬件折旧 6 年 | 实际能满负荷用几年 | 软件改进会延长已部署芯片的经济寿命 |
| 单卡性能提升多少 | 集群级拓扑、拥塞与恢复时间 | 网络是计算架构的一部分 |
| 训练集群规模 | 推理与 agent 负载的占比结构 | 它决定专用芯片这笔账划不划算 |
(上表为我们根据原文整理的对照,非原文图表。)
一个量级示意:同样标称 100% 的集群,能交付多少
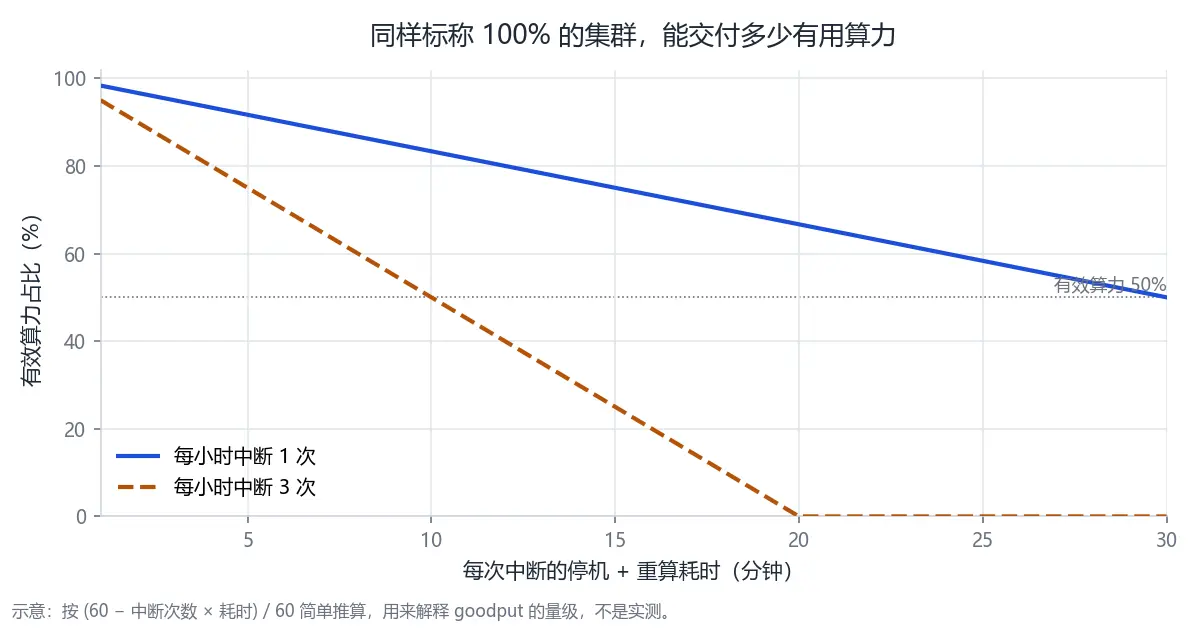
图 2:我们按 (60 − 每小时中断次数 × 每次停机与重算耗时) ÷ 60 做的简单推算,用来解释 goodput 的量级,不是实测数据。
读法很直接:如果每小时中断一次、每次停机加重算 15 分钟,有效算力就掉到 75%;如果每小时中断三次、每次 15 分钟,就只剩 25%。这正是原文那句"理论性能更高的系统交付的可能更少"的算术版本。真实系统里还要叠加检查点写入本身的开销和尾部降速,实际会更差。
三条能直接抄的做法
- 把检查点间隔当成成本参数,而不是习惯。 间隔太稀,每次故障要重算很多;太密,写检查点本身就在吃带宽和存储。有一个经典的最优解形式:最优间隔 ≈ √(2 × 写一次检查点耗时 × 平均无故障时间)。工程上更有用的做法是把它当成一个要定期重算的参数,而不是"当初设的 30 分钟就一直是 30 分钟"。
- 把恢复时间拆成四段分别计时。 检测、隔离、重调度、冷启动——每一段的优化手段完全不同,而"恢复要 20 分钟"这种整体数字会让你不知道先修哪一段。
- 量"每美元每瓦的有用 token",而不是"每卡多少 token"。 这个口径会逼你把利用率、故障率、缓存命中和电价放到同一张账上。
互链:站内几条同一条线
- DeepInfer 开源拆解:DeepSeek 生产推理引擎里有什么、缺什么——推理侧怎么用同一批卡榨出更多吞吐,以及为什么"批不变"这种东西会被写进引擎设计。
- Muse Spark Open:816B 开源权重,两台 Mac Studio 跑起来——把"算力账"算到单机上的极端例子:显存、带宽、量化各扣掉多少。
- AI 编程评测复盘:推理档位开满,36 题 196 个检查点——成本横跨 8.68 倍而分数只差几个百分点,同样的"有效产出"思路在评测上长什么样。
- Grok Bot 用法拆解:一条消息之后,服务端发生了什么——agent 负载的真实形状:队列、持久化工作流、缓存命中率、两级压缩。
边界,别把这篇读成 Google 的通用答案
- 这是 Google 的视角。 自研芯片、自建数据中心、能直接和电力公司谈吉瓦级供电——大多数团队只在这几层里的一层。照抄"垂直整合"没有意义,能抄的是它的口径:按系统交付的有用工作来评估,而不是按单个部件的标称值。
- 租云算力的团队,真正能动的只有四件事:拓扑感知的调度、检查点与恢复策略、可观测性(谁在空等)、推理侧效率(批处理、缓存、量化)。"每瓦 goodput"对这类团队意义有限——电费已经包在你付的单价里了。
- goodput 不回答"值不值"。 它衡量交付效率,不衡量需求。交付出来的有用算力再多,token 卖不出去也还是零。
- 原文性质要说清:这是一篇播客笔记,作者自述"这些是我觉得最值得记下来的点",不是 Google 的官方数据;"每半年翻一倍"是内部目标,2–5% / 30–60% 是假设情景,七八年仍在用的 TPU 是举例。引用时按量级看,别当基准跑分。
- 反过来,这套口径也不是新发明:高吞吐计算领域几十年前就在用"有效算力",只是大模型把这件事的规模推到了必须认真算账的地步。
来源:Guru Chahal,《The Changing Economics of AI Infrastructure》, 2026-10-12。原文链接:https://guruchahal.substack.com/p/the-changing-economics-of-ai-infrastructure。内容整理自 Training Data 播客《Google's AI Infrastructure Chief, Amin Vahdat, on the Physics & Economics of Frontier AI》(2026-10-06)。正文两张图为按原文数字重绘/推算,已在图注标明。
本文由汇智网编译整理,转载请注明出处。
这是「AI 基建 / 评测 / 安全」专题的一部分。完整地图见:AI 基建 / 评测 / 安全完全指南