DeepInfer 开源拆解:DeepSeek 生产推理引擎里有什么、缺什么
DeepSeek 把自家生产推理引擎开源了。vLLM 血统、SM100 + 昇腾 950 双支持、可复现基准——但没有 KV cache 和负载均衡,它是个引擎,不是开箱即用服务器。
一句话结论:2026 年 10 月 20 日,DeepSeek 把支撑自家大规模生产服务的推理引擎 DeepInfer 开源了(Apache 2.0,仓库 deepseek-ai/DeepInfer,发布数日内突破 10,000 星)。它基于 vLLM、深度换核、硬件只挑了两家——NVIDIA SM100 GPU 与华为昇腾 950;README 坦白说明了三件"没开源"的事:KV cache 系统、prefill/decode 分离、跨副本负载均衡。一句话定性:这是一个生产引擎,不是开箱即用的推理服务器。
披露:本文是对官方 README(截至 2026-10-20 版本)、官方 X 公告与社区讨论的拆解整理(英文版首发于我们的 Dev.to),未做独立实测:所有性能相关内容引用官方自述口径,社区热度数字(星标、HN 点数、点赞)为发布当日快照,会随时间漂移。
它是什么:官方那句话里的两个关键词
README 第一段:
"DeepInfer 是支撑 DeepSeek 大规模生产服务的高性能推理框架。本开源版本提供离线推理,以及规模化服务所需的核心特性。"
这句话里有四个词,其中两个最关键:
- "生产"(production):这不是研究补丁堆,而是服务 DeepSeek 自家 API 流量的同一套栈。开源方式是"原样公开",不是"专为外部用户重写"。
- "离线推理"(offline inference):本版本带的是离线(批式)推理。一套完整的在线服务还需要三个 DeepInfer 没有包含的子系统(见下文)。
支持的模型目前只有一个家族:DeepSeek-V4.1-Flash(默认 checkpoint:Hugging Face 上的 deepseek-ai/DeepSeek-V4.1-Flash-1017)。所以它的定位从一开始就很窄:模型-硬件协同优化的生产引擎,不是"万物皆可部署"的通用框架。
盒子里有什么
功能清单与对应开关,全部来自 README:
| 特性 | 启用方式 |
|---|---|
| 优化内核(FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect、自研 TileLang 内核) | 内置 |
| MTP 草稿 token 解码 + 置信度调度验证 | DEEPINFER_ENABLE_MTP_VARLEN=1;草稿长度上限 DEEPINFER_USE_NEXTN_DECODE(默认 5) |
| 并行:注意力 DP / 均衡 CP、MoE EP + EPLB | 内置 |
| 解码器 SWA 有界重放(只重放上下文的有界后缀,减少 prefill 重复计算) | DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact、DEEPINFER_YOCO_PREFILL_KEEP_TOKENS=140 |
| 异步调度(CPU 批次调度与设备执行重叠) | 默认开启 |
| 批不变推理(batch-invariant:不同批次组合下结果一致) | DEEPINFER_BATCH_INVARIANT=1(仅 NVIDIA) |
| 确定性采样(相同输入 token + 相同采样参数 → 相同输出) | DEEPINFER_BATCH_INVARIANT=1 + 固定 seq_seed(仅 NVIDIA) |
| 结构化输出(正则 / JSON Schema / EBNF 文法约束) | SamplingParams(so_args={...}) |
其中两个值得单独说:
- 批不变 + 确定性采样解决的是一整类生产事故。被"同一个提示,换了个批次答案就变了"坑过的人都懂:评测复现、回归测试、灰度对账,全都依赖"同输入同输出"。这个保证通常要靠自研部署才能拿到——本版本里是现成的,但仅限 NVIDIA。
- 置信度调度验证是投机解码(speculative decoding)的调度改良:用置信度估计决定验证预算怎么花。算不上新算法,但这类细节只有真正扛过巨大流量的人才会去打磨。
出身:vLLM 血统 + 罕见的硬件选择站队
README 的致谢部分直接回答了"是不是 vLLM 的 fork"这个问题:
"DeepInfer 最初主要基于 vLLM 构建,并参考了 SGLang 与 TensorRT-LLM。"
所以血缘上是的。DeepSeek 在其上叠加的是自家系列内核(FlashMLA、DeepGEMM、DeepEP 都是 DeepSeek 的开源项目)和围绕自家模型架构设计的调度器。
真正的新闻点在硬件:
- NVIDIA SM100 GPU(CUDA 13)
- 华为昇腾 950 NPU(CANN 9.2)
一个一线开源推理引擎在发布第一天就把昇腾支持摆在 NVIDIA 旁边,这在同类项目里很少见。两边要求都很苛刻:Linux、GCC ≥ 13.0、Python 3.12,外加 CUDA 13 或 CANN 9.2。这不是能跑在消费级显卡上的玩具。
基准:不给"英雄数字",给可复现的 Pareto 曲线
README 没有先甩一个"我们快 X%"的单点数字,而是放了两张 Pareto 图,并给出复现脚本:
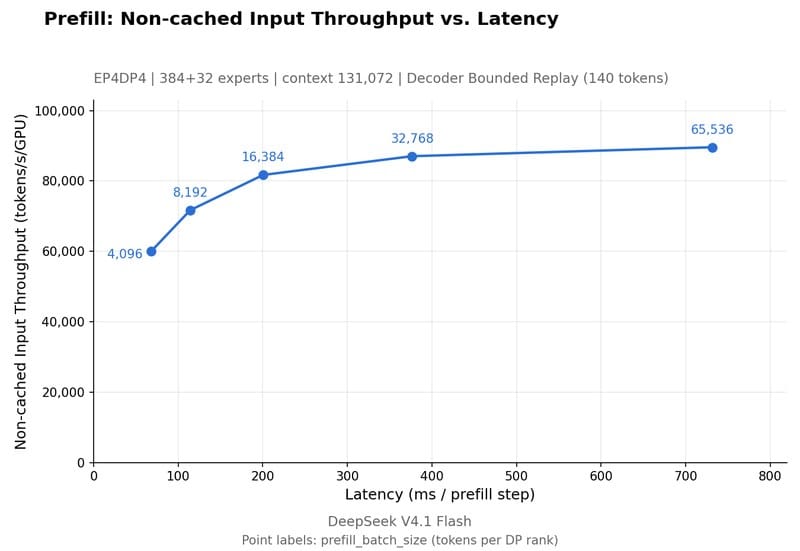
图 1:Prefill——非缓存输入吞吐 vs 延迟,4 张 SM100;原图
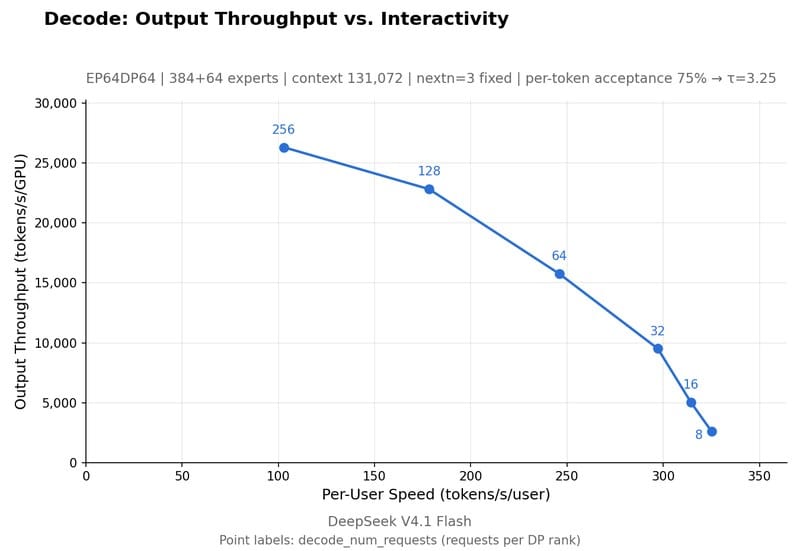
图 2:Decode——输出吞吐 vs 单用户速度,64 张 SM100;原图
测量口径:prefill 用 4 张 SM100,decode 用 64 张,各自处于同一个 scale-up 域内;复现入口是仓库里的 run_sweep.sh。
这个姿势比一张柱状图诚实得多:Pareto 曲线 + 复现脚本是可审计的。至于曲线在你的互联拓扑上能不能成立——sweep 脚本存在的意义,就是承认这件事取决于你的硬件。
刻意不做的三件事
这是大多数报道跳过、但 README 写得最实在的部分。要凑成一个完整的推理服务,还差三个子系统,本版本没有包含:
- KV cache 系统
- VE/prefill/decode 分离(README 注明:大部分所需引擎能力已经实现)
- 数据并行副本间的负载均衡(prefill 与 decode 双侧)
换句话说:这是个引擎,不是开箱即用的服务器。指望明天把它接到 OpenAI 兼容网关后面直接跑生产,那三块得自己补或自己拼。这也是对 DeepSeek 开源哲学的一种公平解读:把最难、最有差异化的核心拿出来,外围基础设施留给生态。
附带一条必须重复的注意事项:批不变与确定性采样仅限 NVIDIA;昇腾支持虽然齐装上岗,但"反向细读 fine print"的重量和任何第一版移植是一样的。
快速上手
从源码构建(先建一个空的 Python 3.12 环境):
# NVIDIA 平台:export DEEPINFER_ACCELERATOR=nvidia
# 昇腾平台把 "nvidia" 换成 "ascend" 即可;务必在运行 DeepInfer 的同一环境里保持导出
export DEEPINFER_ACCELERATOR=nvidia
./build.sh
离线推理(默认 checkpoint 首次运行时自动下载进 HF 缓存;DEEPINFER_HF_MODEL_DIR 指向本地副本可跳过下载):
python examples/offline_inference.py
仓库还带评测基准(eval/README.md),行为层面的核对也在盒子里。
你该不该用:一张决策表
| 你的情况 | DeepInfer 合适吗 |
|---|---|
| 在 SM100 或昇腾 950 上大批量服务 DeepSeek-V4.1-Flash | 合适——这就是它的设计用途 |
| 需要批不变 / 确定性输出(评测、复现、回归测试) | 合适——同类里少见的现成保证,仅 NVIDIA |
| 要一个服务混合模型动物园的通用引擎 | 不合适——vLLM / SGLang 仍是默认答案 |
| 想要开箱即用的在线服务栈 | 暂时不行——KV cache、分离、负载均衡得自备 |
| GPU 早于 SM100,或其他加速器 | 不合适——硬件支持刻意收得很窄 |
诚实的总结:DeepInfer 是为一个模型家族做的生产引擎,开源出来是因为 DeepSeek 相信周围的生态会因此受益。如果你的负载正好走在那条道上,这里的优化深度很难复刻;如果不是,vLLM 和 SGLang 依然是答案——顺带一提,没有它们就没有 DeepInfer。
社区反应
热度是真高:Hacker News 一天内冲过 1,400 点、500+ 评论(讨论帖),r/LocalLLaMA 也有长串跟帖。反复出现的两种立场:一边是对昇腾并列第一梯队的政治性解读,一边是"引擎不是服务器"的落地顾虑;另一边的共识则集中在基准透明度和批不变保证这两件事上。
相关阅读
- AI 基建 / 评测 / 安全完全指南——本站的推理成本、评测与安全专题 Hub
- 本地 & 自托管 LLM 完全指南——不依赖云服务时的另一条路线
- Muse Spark Open:816B 开源权重,两台 Mac Studio 跑起来——同一条路线上的另一份权重
- 90% 工时没有基准覆盖:Mercor 的 AI 评测地图——评测的分母问题
- 本文英文版:DeepInfer: What's Actually Inside DeepSeek's Newly Open-Sourced Inference Engine(Dev.to)
来源
- 官方仓库:github.com/deepseek-ai/DeepInfer(Apache 2.0,README 2026-10-20 版)
- 官方公告:X / @deepseek_ai
- Hacker News 讨论:news.ycombinator.com/item?id=50163277
- 英文报道:The New Stack、The Next Web、Quartz
本文由汇智网整理撰写,基于官方公开资料;技术细节以官方仓库 README 为准,转载请注明出处。
这是「AI 基建 / 评测 / 安全」专题的一部分。完整地图见:AI 基建 / 评测 / 安全完全指南