古代监控视频怎么做:时间戳、REC、机位号全是叠的,模型只管糊
玄武门监控片里最像监控的三样东西——时间戳、REC、机位标签——都不是模型画的。同一条命令我们把清明上河图也变成了一段监控。
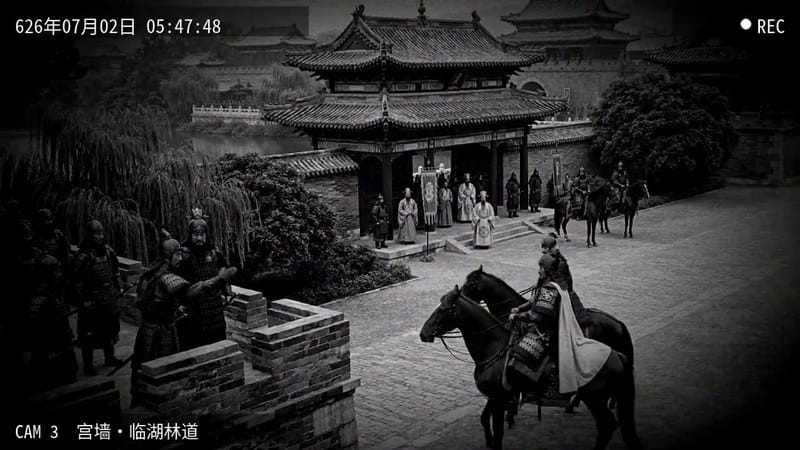
11 月 5 日,一条 2 分钟的黑白片子在 X 上发出来:右上角 ● REC、左上角 626年07月02日 05:47:13、左下角 CAM 1 玄武门·北门外。玄武门之变在五个机位下被拍了下来,原帖配文还补了一句——关键的几段视频神秘消失,有人怀疑是被李世民销毁了。
同一周,同一个格式的片子(荆轲刺秦王、司马光砸缸)出现在 B 站、抖音和微博。
所有人第一反应都是问:用的哪个模型。原帖给了答案,Muse。
但把这条片子拆到帧一级,结论会变:真正让它在"像监控"这件事上成立的,不是模型。 时间戳、REC、机位标签,一个都不是模型生成的。它们是后期一条命令叠上去的。模型只负责一件事——把画面糊到看不清,而这恰好是它最擅长的事。
我做的不多:下载原片、逐帧量参数、把同一套 UI 压回原片上对比,最后用清明上河图复现了一遍。
披露:我们没有 Muse、海螺、Seedance 的账号,视频生成那几步按公开复刻者的说明写;能自己跑的那一步——后期合成——我们跑了,命令在第五节,你可以直接复制。
一、先把这条片子量一遍
这节只做一件事:把"感觉"换成数字。后面每一个参数都从这张表来。
| 项 | 实测 |
|---|---|
| 时长 | 2:00.05 |
| 分辨率 / 帧率 | 1280×720 / 24fps |
| 音轨 | AAC 44.1kHz 立体声,有环境声,不是静音 |
| 时间码 | 05:47:13 → 05:49:09,连续推进 116 秒 |
| 机位 | 5 个(CAM 1–5) |
| UI 位置 | 左上时间戳 / 右上 ● REC / 左下机位号,都带半透明底条 |
时间码推进 116 秒,片长 120 秒,差 3 秒多。这个"差"本身就说明片子是按一条时间轴剪出来的,而不是十几个碎片拼上去再补时间码。监控的可信度,有一半来自时间码的连续性——观众不会去核对秒表,但会本能感觉到"这个时间在走"。
五个机位的标签我逐段抄了下来:
| 机位 | 标签 | 在片里承担什么 |
|---|---|---|
| CAM 1 | 玄武门·北门外 | 队伍入场的总览 |
| CAM 2 | 玄武门·门内甬道 | 贴身冲突 |
| CAM 3 | 宫墙·临湖林道 | 追击、兵力调动 |
| CAM 4 | 太极宫·海池 | 尉迟敬德见李渊 |
| CAM 5 | 太极宫·内庭 | 事后清场 |
这张表不是装饰。玄武门之变那天,建成、元吉死在玄武门内;随后尉迟敬德披甲持矛入海池见李渊。机位正好覆盖"谁在哪被杀、谁去见皇帝"的地理动线,和案件调查里用监控回放重建现场是一个思路。
这也是它比一般 AI 古装片高级的地方:它讲的是空间,不是剧情。观众看到的不是"一场古装打戏",而是"从北门外到海池,这条路上依次发生了什么"。
二、假监控为什么比真 AI 视频更像真的
三个机制在同时起作用,第三个最值钱。
第一,分辨率是滤镜。 20 米外的人脸、手指、兵器,在 720p + 噪点 + 运动模糊下就是一坨。AI 视频最崩的几处——手的关节、脸的对称、人群里多余的腿——全被"画质差"合法遮住了。你让模型做近景,它立刻露馅;你让它拍一片灰蒙蒙的远景,它能骗很久。
第二,镜头语言被压到最简。 固定机位、广角、略俯视、全程不运镜。模型不需要处理它最不擅长的运镜,只需要让一群人慢慢走、旗帜飘、马经过。这是把任务难度从"导演一道戏"降级成"把画面动起来"。
第三,观众对 CCTV 有前理解。 没人会伪造这个。所以画面一旦带上时间戳和机位号,观众先信三分,再去找破绽——而破绽已经被前两条藏好了。微博上已经有人配文转发:"司马光砸缸的监控,这一看就是真的,那个年代还没有 AI。"
把三条合起来看:这个格式火的原因不是模型变强了,是"监控画质"把模型的弱点变成了风格。 同样的模型、同样的提示词,换成 4K、浅景深、运镜花哨,效果会立刻塌。
还有一个容易看漏的细节:原片是 24fps,不是真监控的 12–15fps。它靠噪点和运动模糊去"暗示"低帧率,而不是真的抽帧。因为真抽帧会让动作卡得像掉帧的 PPT,而观众对"监控画质"的记忆其实来自噪点,不来自帧率。这就是通用原则:观众记住的是质感,不是参数。
三、三层拆解:模型只负责中间那层
| 层 | 画面里有什么 | 谁做的 |
|---|---|---|
| 内容 | 城楼、甲士、马、人群、尘土 | 视频模型(原帖用 Muse) |
| 质感 | 黑白、噪点、低对比、暗部糊、轻微顿挫 | 一半模型、一半后期 |
| UI | 时间戳、● REC、CAM 标签 |
100% 后期 |
判据有三条,任意一条都足以定案。
字形:片中"玄武门·门内甬道"这几个字,每一帧都完美,笔画没有一处粘连、没有一处错字。视频模型渲染中文小字必崩——会重复、会腐蚀、偏旁会自己长出来。能稳定写出这行字的,只有字体文件。
位置:UI 坐标逐帧不动,连底条宽度都不变。模型生成的"文字"会随画面轻微呼吸、抖动、明暗变化。
可叠:把同一套 UI 按同样位置压回原片,两层能严丝合缝对上。这说明它是烧进像素的固定图层,不是浮层,也不是模型画的。
顺带解释了另一个细节:为什么这条片子的中文这么整齐。因为那根本不是模型写的字。
这条经验可以推广:片名、字幕、监控 OSD、手机界面,都不该交给视频模型。模型的文本渲染到现在仍然是抽奖,而字体文件是确定的。
四、复刻:先写机位表,最后才碰模型
这一节的顺序和多数教程是反的。多数教程从提示词开始,我建议从机位表开始——这条片子的信息量在"哪几个机位",不在提示词上。 提示词决定好不好看,机位表决定像不像监控。
第 1 步:写机位表。 3 到 6 个机位,每个只承担一个动作,名字用"地点 · 具体位置"的格式(玄武门·门内甬道比场景2强一百倍)。机位名本身就是叙事:观众读标签的时候,已经知道自己在哪。
第 2 步:一张参考图锁场景。 同一座城楼要在三个机位里出现,靠提示词是锁不住的。必须用同一张参考图喂给每一个镜头(图生视频)。公开复刻"司马光砸缸"的那位创作者也是这条路子:先做人物和庭院的参考图,再分段生成。
第 3 步:分段,一段 5–8 秒,一段一个动作。 那位创作者把砸缸拆成了"落水 → 想办法 → 砸缸 → 救人"四段,在 ComfyUI 里按段跑。玄武门这条 2 分钟,按 6–8 秒一段算,是 15 段上下——这是个工作量问题,不是技术问题。
下面这张表是我照着原片节奏排的骨架:机位标签和画面里的动作取自原片,时间码按 8 秒一格示意,不是原作者的脚本,但足够你照着排:
| # | 时间码 | 机位 | 画面里发生什么 | 提示词要点 |
|---|---|---|---|---|
| 1 | 05:47:13 | CAM 1 北门外 | 城门洞开,守军列队 | 远景人群,不给近景 |
| 2 | 05:47:29 | CAM 2 门内甬道 | 一队甲士穿门跑过 | 只留"跑",不加拔刀 |
| 3 | 05:47:45 | CAM 1 北门外 | 骑手勒马停住 | 马与旗,无面部 |
| 4 | 05:48:01 | CAM 3 宫墙·临湖林道 | 队伍沿墙行进 | 尘土、柳枝摆动 |
| 5 | 05:48:17 | CAM 2 门内甬道 | 两名甲士扭打倒地 | 动作单一,机位再远一点 |
| 6 | 05:48:41 | CAM 4 太极宫·海池 | 甲士逼近湖边亭子 | 固定机位,水面反光 |
| 7 | 05:48:57 | CAM 5 太极宫·内庭 | 殿前跪伏、清场 | 人群跪姿,动作放慢 |
| 8 | 05:49:09 | CAM 1 北门外 | 空镜,只剩旗帜 | 结尾留空 |
排表时有个规律:动作越激烈,机位越远。 近景拍打架,模型的手会立刻崩;远景拍同一场架,你只会看到"一群人缠在一起",而这正是监控拍到的样子。
第 4 步:压 UI。 下一节。
第 5 步:声音。 见第五节末尾。
首帧提示词(图片模型):
黑白监控摄像头画面,固定机位,广角,略俯视,唐代城门内侧庭院:
石砖地、城楼、柳树、持戟卫兵列队。低对比、明显噪点、轻微运动模糊、
高光过曝、暗部糊成一片,720p 监控画质。人群在 20 米外,看不清面部。
无文字、无字幕、无水印。
视频提示词(图生视频):
固定机位监控视角,镜头完全静止(locked-off surveillance camera, no pan,
no zoom, no dolly)。披甲士兵从城门两侧涌入,旗帜与长戟摆动,尘土扬起,
后方人群缓慢移动。监控自动曝光轻微闪烁,12fps 顿挫感,持续噪点与压缩块,
远景人物面部模糊。保持现有构图与机位,不出现现代物体。
负面词:运镜、变焦、浅景深、电影感、清晰人脸、慢动作、字幕、现代建筑。
中英各写一遍是有原因的:中文提示词在部分模型上理解偏弱,英文更稳;但"甲士、戟、甬道"这类词翻成英文容易失真。所以先用中文生成首帧图(国内图像模型对中式场景更好),再拿这张图去跑图生视频——图已经把手、脸、服饰定死了,视频那段提示词只需要管运动。
五、后期那一步:一条命令
这一段是全文唯一由我们自己跑出成片效果的部分。结论:不需要 PR、不需要 AE,一条 ffmpeg 命令就能把任何画面变成监控。
下面这张图是同一个画面的前后对比。上:清明上河图的城门段(公有领域)。下:同一条命令处理之后。
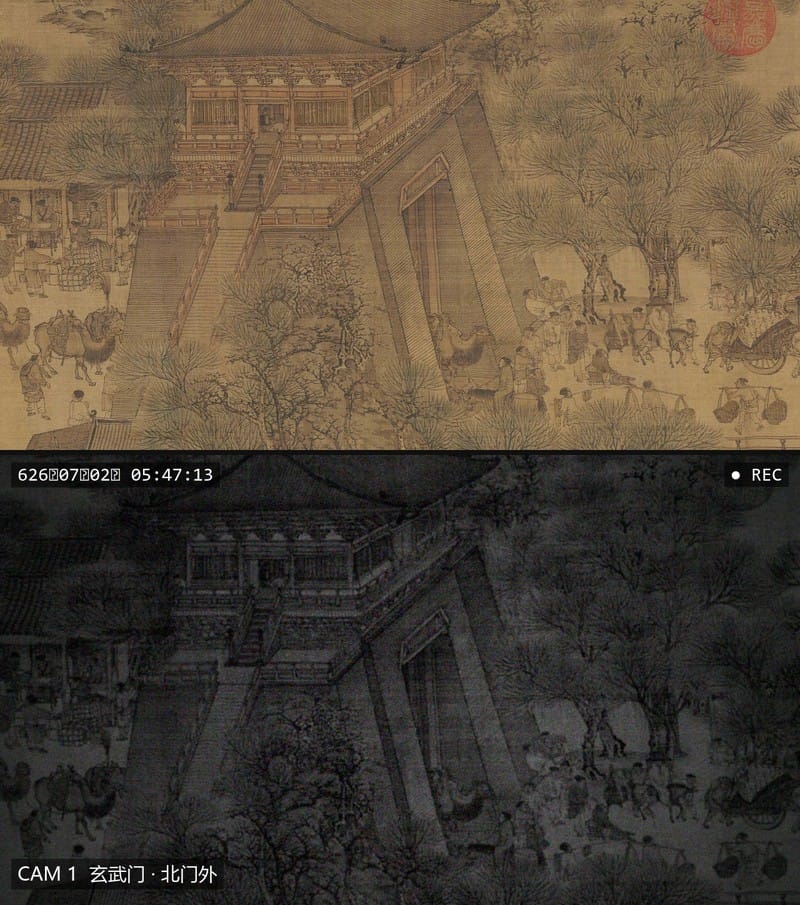
上:原画。下:压暗、去色、加噪、降到低分辨率再拉回、叠 UI 之后。
命令(Windows 11、ffmpeg 9.0.2 上跑通,输入换成你的视频即可):
ffmpeg -y -i in.mp4 -vf "\
scale=640:360:flags=bilinear,scale=1280:720:flags=bicubic,\
format=gray,eq=contrast=1.3:brightness=-0.22,noise=alls=26:allf=t,gblur=sigma=0.6,\
vignette=PI/5,\
drawtext=fontfile='C\:/Windows/Fonts/consola.ttf':text='626年07月02日 05\:47\:13':fontcolor=white:fontsize=30:x=28:y=22:box=1:boxcolor=black@0.55:boxborderw=10,\
drawtext=fontfile='C\:/Windows/Fonts/consola.ttf':text='● REC':fontcolor=white:fontsize=30:x=w-tw-28:y=22:box=1:boxcolor=black@0.55:boxborderw=10,\
drawtext=fontfile='C\:/Windows/Fonts/msyh.ttc':text='CAM 1  玄武门 · 北门外':fontcolor=white:fontsize=30:x=28:y=h-64:box=1:boxcolor=black@0.5:boxborderw=10" \
-c:v libx264 -crf 23 -pix_fmt yuv420p out.mp4
五处参数决定"像不像",按重要性排:
scale=640:360再放大回 1280 —— 先降到低分辨率再拉回来,这一来一回把细节吃掉。比单纯加噪点更像老摄像机:噪点是叠上去的,模糊是"没有"的。eq=contrast=1.3:brightness=-0.22—— 监控夜视是"暗部死黑、高光也糊",不是干净的黑白。只去色不压暗,出来的是黑白电影,不是监控。noise=alls=26:allf=t—— 其中的t让噪点逐帧变化。静态噪点一眼假,因为真实传感器的噪点永远在动。box=1:boxcolor=black@0.55—— 底条。没有底条,白字压到亮部就直接消失;真实 OSD 都有这一层。- 字号 30,画布 720p —— 大约占画面高度的 1/24。真监控的字就这么小。字一大,立刻从"监控"变成"电影字幕"。
时间码要跟着走,把 text 里的时间换成 %{eif\:t\:d}(按秒递增),或者直接用 drawtext 自带的 timecode= 选项。多机位拼接时,每段的起始时间码要接着上一段——这条片子 116 秒走完 116 秒,中间没有跳,这就是可信度。
让几段"文件损坏"
原帖那句"关键的几段视频神秘消失",做起来是四行命令:
ffmpeg -f lavfi -i "color=c=black:s=1280x720:d=4:r=24" -vf "\
noise=alls=40:allf=t,format=gray,\
drawtext=fontfile='C\:/Windows/Fonts/consola.ttf':text='SIGNAL LOST':fontcolor=0xCCCCCC:fontsize=44:x=(w-tw)/2:y=(h-th)/2,\
drawtext=fontfile='C\:/Windows/Fonts/consola.ttf':text='626年07月02日 05\:48\:37':fontcolor=white:fontsize=30:x=28:y=22:box=1:boxcolor=black@0.55:boxborderw=10" \
-c:v libx264 -crf 23 -pix_fmt yuv420p lost.mp4
四秒黑屏 + 逐帧噪点 + 一行 SIGNAL LOST,接在上一段后面,再把下一段的时间码往前跳 7 分钟。观众看到的是"录像缺了一段",实际是你少生成了两段。这一条我们也跑了:
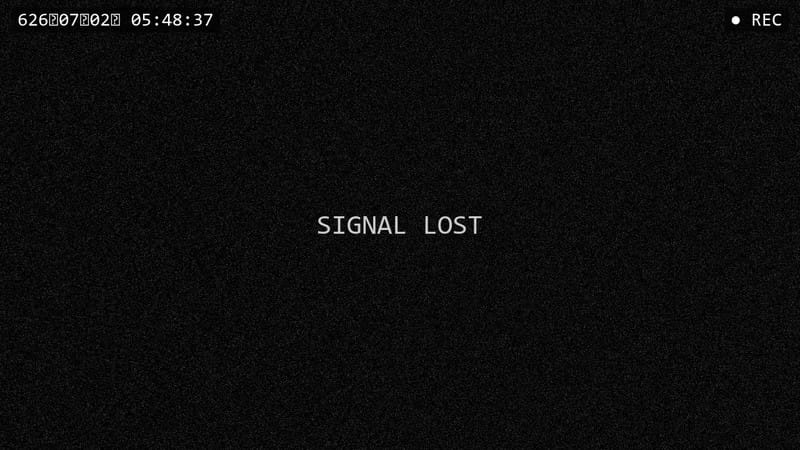
黑屏 + 噪点 + 时间码。注意丢失帧上的时间码没有跳——跳档要放在它后面那一段的开头。
声音:三轨叠。现场层(脚步、甲片、马蹄、远处人声)、设备层(底噪,-30dB 左右的白噪,加偶尔一声"咔")、叙事层(可留白)。监控画面里的沉默是最假的——真实监控永远有电流声。
六、工具怎么选
| 档 | 做法 | 适合 |
|---|---|---|
| 最可控 | 参考图 + 图生视频(海螺 / MiniMax H3、Seedance、可灵),平台或 ComfyUI 编排 | 要多机位、要一致 |
| 最省事 | Lovart 这类 agent:一段话出首帧,一段话出视频 | 一条就走、不挑细节 |
| 原帖同款 | Muse(Meta 2026 年 9 月上线,个人 Agent,带视频生成,需海外区账号) | 已经在用的人 |
三档的差别不在画质,在你能不能指定机位。监控风格对机位极度敏感:同一个场景,机位高 1 米、广角再多 5 度,"监控感"就没了。所以真要做系列,选第一档——它允许你把"固定机位"写进参数,而不是写进祈祷。
七、七个坑
- 一段里塞两个动作必崩。 走 + 拔刀 + 转身,只能留一个。剩下的用下一段接。
- 换机位建筑会变。 同一张参考图喂到底;变了就宁可重跑,别想着后期救。
- 中文提示词别指望。 首帧用中文图模型,视频段用英文。
- 别给近景人脸。 监控片里没有近景——这不是限制,是掩护。
- 时间码要和片长对得上。 差 3 秒没人看得出来,差 30 秒满屏穿帮。
- 年号日期会被考据。 626 年 7 月 2 日是对的(武德九年六月初四),写错就被人抓住,评论区第一条就是纠错。
- 别让"像真的"变成"被当成真的"。 标 AI 生成,别去水印。这条在微博上已经有人当真了。
出片前过五个检查
每段素材放进时间轴之前,按顺序看五处。这五处也是观众会下意识看的地方:
- 时间码:起止时间接得上吗?差 1–2 秒没事,差半分钟就穿帮。
- 机位一致性:同一座城楼在三个机位里,屋脊的方向对吗?
- 手:有没有近景?有就换远景,不要修。
- 旗与戟:长条物在移动中最容易变形,逐段看画面靠边的旗。
- 人群:有没有多出来的腿、突然消失的人。远景看不清细节,但"消失"看得清。
前两条是硬伤,后三条是概率。硬伤必须重跑,概率可以靠剪辑盖。
八、这类片子能干什么,边界在哪
它适合三种内容:历史科普(把"某年某月某日发生了什么"变成"从哪几个门进、谁先动手")、案件式叙事(任何有时序 + 有空间的事件都能用机位重建)、需要"档案感"的广告与预告片(比搭实景便宜一个量级)。
边界也有三条,都是硬的:
不要拍真人,不要拍在世的公众人物。 假监控 + 真人 = 造谣,不是创作。
不要做成能被当证据转发的形态。 带台标、带真实门牌号、去掉 AI 标识,就越线了。平台对"伪造监控"的审核和真监控一样敏感。
这个格式靠新鲜感续命。 观众第一次被骗会转发,第三次就只剩"又是这个"。要续命,方向是往考据走——更准的服饰、更对的动线、更细的时间码——而不是往"更真"走。比"更真",模型永远输给真实素材。
九、我们的整理
三条判据,跟视频模型没关系,跟信息设计有关系。
先删,再加。 把模型不擅长的东西从画面里删掉(细节、运镜、文字),再用后期补上"证据感"(时间码、机位号、噪点)。这条对任何"伪造某种介质"的玩法都成立:伪胶片、伪行车记录仪、伪直播截图,都是同一个公式。
一个格式的可信度,来自它自带的限制。 监控可信,是因为它画质差、机位固定、时间连续——不是因为它漂亮。找限制,比找模型有用。
后期那层才是护城河。 提示词人人能调,UI 那层的位置、字号、底条透明度、时间码节奏,是一帧一帧调出来的。原片里 ● REC 和左下角 CAM 标签的底条宽度几乎一样,这种一致性,模型永远给不了。
来源:
- 原帖:@PixelAigc,2026-11-05,2:00,明示由 Muse 生成
- 复刻说明:@AXIS95277 长文(一段话出首帧、一段话出视频,Lovart);@0xmomonifty(RunningHub + MiniMax H3,时间码用 VCR OSD Mono 字体后期压)
- 传播讨论:B 站
BV1Je4P6SEo9、BV1UZ4i6WEy9;抖音"当年司马光砸缸监控疑似泄露" - 产品信息:Meta Muse 官方公告(2026-09)
- 封面与本文引用的原片画面:@PixelAigc 原帖(2026-11-05),仅用于评述该片,版权归原作者
- 对比图:清明上河图(公有领域)+ 本文命令合成
相关阅读:多模态生成完全指南;AI 视频生成教程:让 coding agent 写代码出片
本文由 汇智网 · Software 2.0 整理,转载请注明出处。
这是「多模态生成」专题的一部分。完整地图见:多模态生成完全指南