不训练,平替 Jev:EmbeddingGemma 2 改造复现
174MB 的模型在 CPU 上就能给出带概率的选择。能替的是"哪个最像",替不了"算一步"——这是复现之后最清楚的一条线。
作者的示例我复现到了小数点后四位:问"今晚吃什么",四个选项的分布是 Order takeout 0.447 / Pasta bake 0.277 / Fried rice 0.199 / Big salad 0.077;问"我还有多少精力",档位概率是 0.584 / 0.1451 / 0.0146 / 0.2382 / 0.0181,期望分 1.961。
同一份代码,另一句话就崩了:"发票 400 欧,客户只付了 150 欧"——问"是否已付清",它答 true,置信度 0.98。
两个数字放在一起,就是这套方案的边界:它能判"哪个最像",不能判"算一步"。这篇文章把配方、复现数字、以及它在哪儿必错,一次说清。
一、决策和生成是两件事
2026 年 9 月 15 日,TypeSafe 上线了一个叫 Jev 的模型。它不写作文,只回答类型化的问题:
{ "state": "客户被重复扣款,今天要求退款。",
  "questions": {
    "route":    { "type": "choice", "instructions": "这张工单归哪个队列?",
                  "criteria": { "billing": "付款、退款、发票", "technical": "产品报错、使用问题" } },
    "escalate": { "type": "noul",  "instructions": "现在需要人工介入吗?" },
    "urgency":  { "type": "score", "instructions": "对客户而言有多紧急?",
                  "criteria": ["routine", "soon", "urgent", "critical"] } } }
四种题型:noul 给一个 P(yes),choice 给选中项和全量概率,score 给有序档位和期望分,box 给图像里的归一化框。一个请求最多 8 个问题、每题指令 1,800 字符、选项 2–20 个、档位 2–10 级,按输入 token 计费,输出不计费。
关键差别在输出形态。聊天模型返回一段文本,你要再写解析、再处理它偶发的不合规;Jev 返回的是 {choice, probabilities, confidence},代码可以直接 branch。这也是"零解码"的价值:没有自回归,就没有 token 生成延迟,也没有格式漂移。
这不是孤立的产品。同期 OpenAI 出了 Decisions API(beta,predicate / choice / score),Jared Palmer 出了 Kev——0.8B 到 27B、Qwen 底座、Apache 2.0、说同一套 Jev API,可以自托管也可以微调。三个东西指向同一个判断:"从文本里取出结构化判断"正在从 prompt 技巧变成一类独立的模型接口。
那么问题来了:一个只会输出向量的 embedding 模型,凭什么挤进来?
二、Jevfree:把决策压成四次点积
让这件事出圈的是一条 Hacker News 评论:"这东西用来做 Jev 式的任务也很妙,文本和图像都行。" 顺着链接是 Google 的 MediaPipe Decision Maker 文档。独立开发者 Joachim Leonfellner 照文档写了个周末项目 Jevfree:吃 Jev 格式的 {state, questions},在浏览器里给出概率,没有服务器、没有 API key、没有 token 账单。
原理就一句:embedding 模型把状态和每个候选答案各映射成一个向量,谁离得近谁赢。"我只有 20 分钟、有剩饭和鸡蛋、我很累"在向量空间里就是比"焗意面"更靠近"剩饭炒蛋"。
但只做"最近邻"是不够的。真正让结果可用的是下面五步。
① 选项侧也要带问题指令。 选项文本拼成 task: classification | query: {问题} — {标签}: {描述}。只嵌 "Fried rice: ..." 会让所有选项都靠近"食物"这个共同主题,指令是让判断对齐到具体问题。
② 选项向量一次算好并缓存(prewarm)。 选项与请求无关,请求里只需要嵌状态本身。省掉这步,每个请求要嵌十几个文本段,延迟直接翻倍——作者给的响应里 option_tokens 是 272,state_tokens 只有 38,比例就是这里来的。
③ 组内去均值再归一化。 这一步是灵魂,MediaPipe 管它叫 normalizePrior:
// 每个问题自己的选项取平均,减掉,再重新归一化
const mean = vs.reduce((a, v) => a.map((x, i) => x + v[i] / vs.length), vs[0].map(() => 0));
const whitened = vs.map(v => normalize(v.map((x, i) => x - mean[i])));
四个晚餐选项都跟"吃"有关,这部分共性会让它们对状态看起来一样近。减去均值,剩下的才是差异。
④ 点积除以温度,走 softmax。 单位向量点积落在 [-1, 1],不除温度 softmax 会非常平;作者用 T = 0.05,相当于把分数放大 20 倍。
⑤ 概率回归成三种题型。 boolean 就是"条件 / 条件的否定"二选一,概率过阈值即 yes;score 是在档位上的加权期望——1.961 比"选了第 1 档"信息量大得多;confidence 是 top2 间隔与归一化熵的混合。
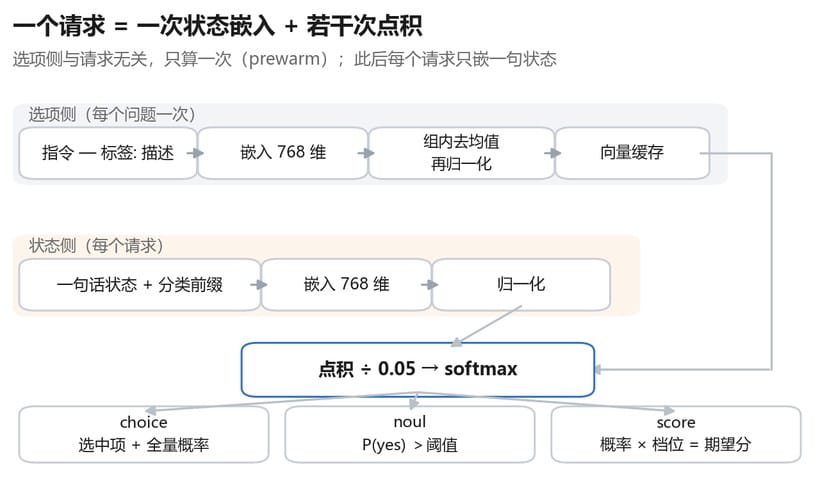
五步流水线。选项侧与请求无关,预嵌一次、去均值、进缓存;状态侧每个请求只嵌一句。两条线在打分处汇合,除以温度走 softmax,再翻译成 choice / noul / score 三种输出。
浏览器里跑的部分:transformers.js 加载 ONNX 权重,模型跑在 web worker 里,有 WebGPU 用 WebGPU、没有就退 WASM。默认 fp16(首屏约 1.5 GB,含视觉与音频编码器),GPU 不支持半精度时换 q4。音频在主线程解码成 16 kHz 单声道、最多 90 秒;视频按 1 fps 抽最多 16 帧——这两条限制不是随手写的,是为了压在 WebGPU 后端的 token 上限之内。
作者自己给这套东西的评价很克制:"它只是比较意义,不推理",概率更接近"感觉"而不是可以依赖的答案。
下面四节是我们的复现与整理,不是原文内容。
三、为什么是这四个数
把配方抄下来容易,理解每一步在改什么才不会抄错。四个数值得单独看一眼。
点积就是余弦。 模型输出先做了 L2 归一化,所以点积等于余弦相似度,落在 [-1, 1]。开箱时四个晚餐选项对同一句话的余弦通常在 0.6 上下,挤在一起——这就是"看起来一样近"的来源。
去均值等于换坐标系。 减去组内均值,把"这一组共有的方向"从每个向量里扣掉,剩下的向量在原点附近散开。原来的 0.6 / 0.61 / 0.62 变成 -0.3 / 0.02 / 0.28,乘以 20 之后(除以 0.05),差距就从"看不出来"变成"一眼分得开"。这一步不改变排序逻辑,改变的是分数的可分辨性。
T = 0.05 是把分数拉到 softmax 的工作区间。 余弦差 0.1 在 T=1 时只产生约 1.1 倍的概率比,在 T=0.05 时是 e²≈7.4 倍。温度越低越"敢下结论",越低也越容易在噪声上过拟合——所以它必须是可调的,不能焊死。
confidence 是另一条曲线。 作者取 top2 间隔和归一化熵各一半。晚餐那个例子 confidence 是 0.1398——四个选项概率接近,判它"没把握"是对的;否定那个例子是 0.994——两个选项一边倒。这两个数说明 confidence 读得出来"分布有多平",但它不等于正确率:第五节里那个 0.91 的错答案,就是最好的反例。
四、复现:从 174MB 到小数点后四位
环境与配置:
| 项 | 值 |
|---|---|
| 模型 | onnx-community/embeddinggemma-2-ONNX,q4(文本主干 174 MB) |
| 运行时 | Node 24 + transformers.js 4.3.2,CPU(无 WebGPU) |
| 输入 | 作者博文里的"今晚吃什么",加我自己写的一组工单用例 |
| 复现脚本 | 五步配方 60 行,whiten / softmax / confidence 与原文一致 |
结果对齐得比预期好——不只是"排序一致",是数值一致:
| 问题 | 作者博文 | 本次复现 |
|---|---|---|
| 晚餐 choice | 0.447 / 0.277 / 0.199 / 0.077,confidence 0.1398 | 同 |
| 精力 score | 期望 1.961,逐档 0.584 / 0.1451 / 0.0146 / 0.2382 / 0.0181 | 同 |
| 工单路由 | — | billing 0.959、technical 0.027、sales 0.014(conf 0.876) |
| 需要人工吗 | — | true 0.838 |
| 紧急度 | — | critical 0.576,期望 2.29 |
延迟(同一台桌面 CPU,q4,3 个问题 11 个选项):首个请求 1.34 s(含预热),之后 1.03 s、0.72 s、0.42 s。作者在浏览器 WebGPU + fp16 下更快,但没有给数字,这里只能给 CPU 侧的参考值。
一点必要的说明:q4 与 fp16 在这个尺度上差异小到看不见(我用的 q4,复现出的是作者 fp16 的数字)。这不是"小模型也够用"的证据,只说明分类这种任务对量化不敏感。
如果想自己走一遍,顺序是这样的:
- 装运行时,拉起模型(一句
AutoModel.from_pretrained,ONNX 版会自动挑 q4); - 把问题写成
{state, questions},选项写成"标签 + 什么情况下选它"; - 按
指令 — 标签: 描述拼选项文本,加task: classification | query:前缀; - 批量嵌入选项,缓存,再嵌状态;
- 每个问题单独去均值、归一化、点积除以温度、softmax;
- 打印三项:选中项、全量概率、confidence——先看 confidence,再看选中项。
第 6 步是很多人会漏的。只打印选中项,你会得到一堆"看起来都对"的结果,直到某天批量跑了 500 条才发现错的那批置信度也不低。
五、关掉 whitening,置信度从 0.88 掉到 0.22
配方里最容易被当成"优化项"跳过的是第三步。我把 whiten 换成恒等函数,其他一律不动,同一批输入重跑:
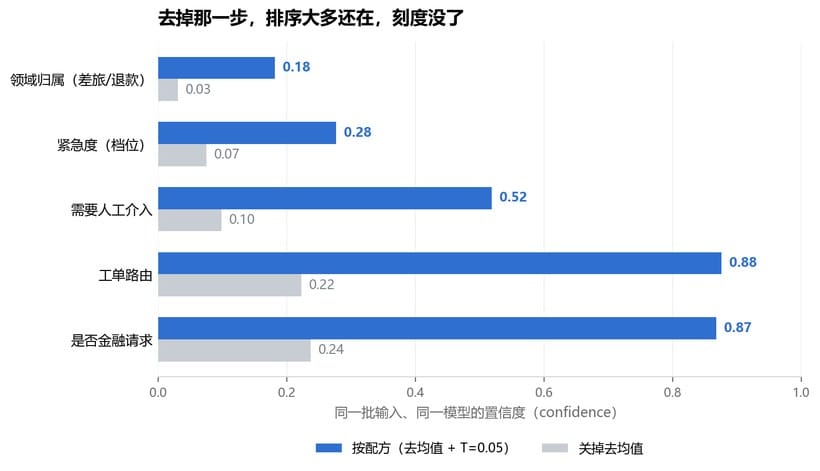
蓝色是按配方,灰色是关掉去均值。变的不是答得对不对,是"有多大把握"——路由从 0.88 掉到 0.22,金融请求从 0.87 掉到 0.24。领域归属那一条两边都低,说明它本来就分不清差旅和退款。
| 问题 | 正常 | 关掉 whitening |
|---|---|---|
| 工单路由 | billing 0.959,conf 0.876 | billing 0.571,conf 0.223 |
| 需要人工吗 | true 0.838 | true 0.588(conf 0.099) |
| 紧急度 | 期望 2.29 | 期望 1.801 |
| 是否金融请求 | true 0.969,conf 0.868 | true 0.686,conf 0.237 |
| 领域(差旅/退款) | billing 0.551 / travel 0.368 | billing 0.404 / travel 0.364,conf 0.031 |
排序大多还在,但概率塌了:原本 0.96 的把握变成 0.57,原本 0.87 的置信度变成 0.22。对"选一个标签"这种用途,排序够用;对"按阈值分流、按置信度升级"这种用途,塌掉的概率等于把整个兜底机制废掉。
这就是为什么它不该被当成可选优化:你要的不是最近的选项,而是"最近多少"这个刻度。 而刻度的分辨率,是这一步给的。
六、它必错的地方
复现完,最有价值的部分是找它崩在哪里。三个例子,都是同一套代码、同一个模型:
① 数字不推理,而且错得很自信。
状态:发票 400 欧,客户只付了 150 欧。问题:是否已付清? 答案:true,0.9797,confidence 0.908。
它显然是按"paid / invoice / amount"这些词的共现去判"像不像已付清",而不是做减法。危险的正是那个 0.91——如果按置信度分流,这一条会直接走"自动执行"。
② 语义相邻就分不开。 "取消明天的航班并退款":判"是否金融请求"没问题(0.969),但问"这属于差旅、退款还是技术支持",得到 billing 0.551 / travel 0.368 / technical 0.081,confidence 0.18。它是在两个都对的答案之间掷硬币,而不是答错。
③ 否定反而能对——前提是你把话说全。 "包裹没有任何可见损坏"问"是否损坏",得到 0.0008(conf 0.994)。不是因为模型懂否定,而是因为选项文本写的是"没有可见损坏"这条正向描述。同一句里如果只写 false: "包装没有损坏" 这种依赖反推的说法,结果就会飘。
三件事合成一条判据:embedding 模型判的是"像不像",不是"对不对"。 凡是答案能从措辞的表面共现里读出来,它就很好用;凡是需要跨一步算术、跨一层否定、或者在两个近义类别之间做取舍,它都不该单独上场。
顺带一个推论:标注数据的价值在这里会被放大。你不需要标 10 万条来训模型,只需要标 200 条来发现"哪类问题它总是错、错的时候置信度是多少"。第①条那种用例,只要在验证集里出现两次,你就会给它单开一条规则。
十分钟体检:你的任务适不适合交给它
不用先搭服务,三个探针就够判断:
- 近义探针:把正确选项和一个近义改写同时放进选项("退款" vs "返还货款"),跑一遍。两者打平且 confidence 掉到 0.2 附近,说明它在你的场景里只能排到"二选一",需要交叉编码器兜底。
- 改数探针:把状态里的关键数字换掉(400 改成 40、150 改成 400),看答案变不变。不变的那类问题,它根本没读数字,别再要求它做算术。
- 删描述探针:把 boolean 的
false描述删掉,只留自动生成的否定句,看概率怎么飘。飘得厉害,说明你的结果是在吃措辞细节,换一批同义表达就会崩。
三个探针都不通过,说明这类问题需要的不是"更像的选项",而是"会算的模型"——直接换下面的 B 或 C 路线,别在这条路上加提示词。
七、四种做法怎么选
同样一个"这张工单归哪个队列",今天至少有四种实现。它们的差别不在"准不准"这一个维度上:
| 做法 | 单次延迟 | 成本 | 离线 | 弱点 |
|---|---|---|---|---|
| 托管决策 API(Jev / OpenAI Decisions) | 厂商称 70–500 ms | 按 token 计费 | 否 | 数据出网,受配额制约 |
| Embedding 双塔(本文复现) | 单机 0.3–1.3 s,预热后更低 | 一次性下载 174 MB | 是 | 只判相似度,不推理 |
| 交叉编码器(Laya、GLiNER2.5-Decide) | 高一个量级 | 模型更大 | 是 | 选项多时线性变慢 |
| 生成式(Gemma 4 E2B / E4B) | 秒级(要解码) | 最大 | 可以 | 要约束格式,可能跑偏 |
这张表解释了一件常被忽略的事:MediaPipe Decision Maker 并不绑定 embedding 后端——双塔、交叉编码器、生成式 Gemma 4 都能挂,同一份 schema 只换模型。之所以这么设计,正是因为上面这几档的质量差距是真实存在的。
选择逻辑因此很简单:先问"错了的代价有多大"。错了只是多一次转人工,embedding 够了;错了要赔钱,就上交叉编码器;错了要上法庭,就上生成式加人工复核。
八、三条落地路线
A. 直接用官方 SDK(最省事)
MediaPipe Decision Maker 就是这套东西的官方实现,Web / Android / iOS / Python 四端一致,prewarm()、evaluateBatch()、normalizePrior 都是内建参数:
const decision = await FilesetResolver.forDecisionTasks(
  'https://cdn.jsdelivr.net/npm/@mediapipe/tasks-decision@latest/wasm');
const maker = await DecisionMaker.createFromOptions(decision,
  { baseOptions: { modelAssetPath: MODEL_URL, delegate: 'GPU' }, maxNumTokens: 512 });

const q = { criteria: { billing: '退款、发票、订阅扣费', technical: '崩溃、登录失败、功能异常' },
            normalizePrior: true };
maker.prewarm?.(q);
const r = await maker.evaluateChoice('登录后应用立刻崩溃。', q);
它还内建了 Jev JSON 与 OpenAI json_schema 的解析,能直接吃上面那种请求体。图像作为选项也走同一条路:EmbeddingGemma 2 的视觉编码器和文本在同一个空间,图片可以直接当 criteria 的一项。
B. 自己写(要可控)
配方就是前面五步,一百多行,任何能跑 ONNX 或 sentence-transformers 的地方都能实现。需要自己写的理由只有三个:自定义题型、服务端批量、选项里混图片或音频(ONNX 版里视觉编码器 q4 是 109 MB,音频 189 MB,只在用到时才加载)。
C. 换更强的决策模型
有标注数据就微调(Kev 是现成的自托管起点);要顶配就走 Jev / OpenAI Decisions API。embedding 那一套最适合当第一道粗筛。
我的建议是三道门:
| 置信度 | 动作 |
|---|---|
| ≥ 0.6 | 直接执行(记日志) |
| 0.3 – 0.6 | 交交叉编码器或小模型复核 |
| < 0.3 | 转人工 / 追问 |
这三档不是拍出来的。0.6 以上在复现里基本是"分布一边倒"的样本,0.3 以下基本是"两个近义选项打平"——也就是第二节那个 0.18。阈值应该由你的错单成本决定,而不是由这篇文章决定。
九、上生产要补的四件事
① 温度和阈值不能抄。 0.05 和 0.5 是作者示例里好用的值,不是你的分布。收 200–500 条标好的 (状态, 正确选项),网格搜温度,按 NLL 或 ECE 选;boolean 的阈值同理,默认 0.5 会让"宁可漏不可错"和"宁可错不可漏"两种业务共用一条线。
② 选项措辞就是提示词工程。 每条选项写"什么情况下该选它",而不是一个名词;boolean 一定要显式写 false 的描述(第六节第三个例子就是靠这个把 0.0008 拿到的)。选项数量压在 3–8 个,越多越平。
③ 缓存与预热。 选项向量按 (模型, 选项文本) 缓存,服务启动时预热。这是把 1 秒压到 100 毫秒级的关键,也是它比"每次调 API"更适合高频小判断的地方。
④ 维度是旋钮。 768 维可以截到 512 / 256 / 128(Matryoshka),截到 256 基本不掉点、内存降三倍;768 只在选项特别多时才有必要。
十、边界
这次复现只做了文本:图片、音频、视频三路都通(模型是多模态的,同一空间),我们没测。跑的是 CPU + q4,WebGPU 上的真实延迟没测。温度、阈值都没有校准,上面所有数字都是单机、单模型、示例级的结果,不该当成"这个模型的能力上限"。
还有一件必须说清的事:作者写这个项目的初衷是玩,他自己的定性是 "not a drop-in replacement"。我们复现的结论也一样——它能替掉的是"哪个最像"这一层判断,替不掉"算一步"。
真正值得带走的不是 174MB 这个数字,而是那个顺序:先把问题写成选项,再让向量去排序,最后用置信度决定要不要人来。 前两步今天就能离线跑,第三步才是产品。
来源
- Joachim Leonfellner,Jevfree - repurposing EmbeddingGemma 2 for Jev-like decisions(2026-10-08):https://johnnys.news/2026/10/Jevfree-repurposing-an-embedding-model-for-decisions/
- Jevfree 源码:https://github.com/nor0x/Jevfree,线上 demo:https://nor0x.github.io/Jevfree/
- Google AI Edge,Decision Maker(Web / Python / Android / iOS):https://developers.google.com/edge/mediapipe/solutions/decision/decision_maker/web_js
- Google,Bring multimodal semantic search to the edge with EmbeddingGemma 2(2026-10-06):https://developers.googleblog.com/en/google-ai-edge-with-embeddinggemma-2/
- Jev API 文档:https://jevmodel.org/docs/
- 模型:
google/embeddinggemma-2、onnx-community/embeddinggemma-2-ONNX
本文由汇智网编译整理,转载请注明出处。
这是「本地 & 自托管 LLM」专题的一部分。完整地图见:本地 & 自托管 LLM 完全指南