Fable 5.2 画一张画 48 万笔,一像素都没用图像模型
画里没有一像素来自图像模型。模型写了个笔刷引擎:参考图只取色,笔触沿轮廓走,48 万笔分五遍落下。我们照做了一遍,6.5 万笔、误差 3.1%。
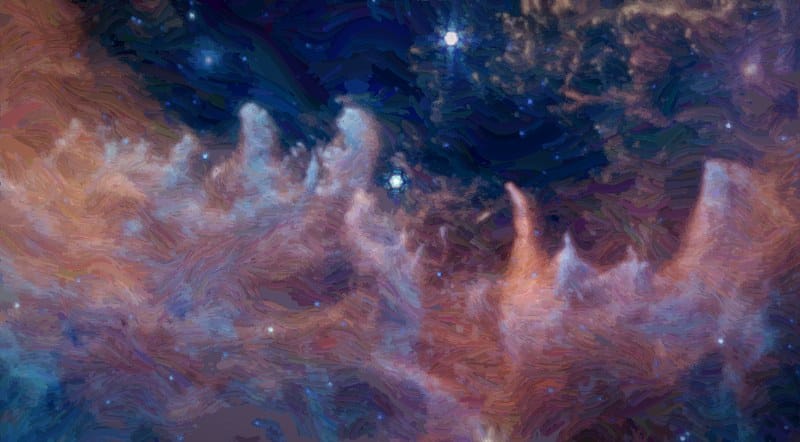
11 月 9 日 Fable 5.2 发布,两天后最出圈的产物不是 benchmark 分数,是两张画。
@vctbtc 在 11 月 11 日凌晨发了一条 19 秒视频:空白画布上笔触一层层压上去,最后停在一幅古典油画。他的注释是"还原度几乎是 100%",紧跟两个对比数字——按计算量,扩散模型是这种代码绘图的一万到十万倍;按能耗,是 10 到 100 倍。前一天,@wquguru 发了另一张:500 多行 Python、8584 笔,画的是有花、柿子、金属壶的静物。
两张画都不经过图像模型,也没有滤镜。它们是一个程序画出来的:模型写的不是像素,是画笔。
一、它到底做了四个什么动作
先看 @vctbtc 那条的正文。作者把代码整理成四步,函数名是模型自己起的——setup() / buildFlow() / planPasses() / dab(),这段比视频的信息量大得多:
- 参考图放在一张隐藏画布上。 不显示,只用来取色,程序读出每个像素的颜色。
- 算每个位置的笔触方向。 先转明暗,再算"明暗变化最剧烈的方向,也就是轮廓线的走向";没有明显轮廓的平坦区域,方向由平滑的随机噪声决定。
- 分五遍上色,从粗到细。 26、13、6 像素宽的大笔各铺一遍整张画,3 和 1.5 像素的小笔只画有细节的地方:轮廓明显处,以及脸、手、龙头这几个重点区域。总共约 48 万笔。
- 单笔怎么画。 落笔点取一个颜色、加一点随机偏差;顺着方向走四小段,形成一条略弯的线;走到颜色差别大的地方提前收笔;大笔触两侧各加一条很淡的亮线和暗线,模拟笔刷毛痕和颜料厚度。
收尾另有一步:给剑加一层发光,四角压暗,叠一层画布纹理;之后每帧在剑身生成几个小光点,向上飘动并淡出——火焰的闪动。
这里有个地方要单独指出来:第 2 步那句"明暗变化最剧烈的方向,也就是轮廓线的走向",两句话差了 90 度。明暗变化最剧烈的方向是横跨轮廓的,笔触要走的是垂直于它的方向,也就是轮廓的切线。代码里必须取后者;取前者,笔触就会横穿轮廓,羽毛和衣褶立刻糊成一团。作者大概是照搬了模型的解释,没有对着代码核。
这套四步也不是它发明的。1998 年 SIGGRAPH 上,Aaron Hertzmann 的《Painterly Rendering with Curved Brush Strokes of Multiple Sizes》给的就是这个:多尺度分遍、沿轮廓方向生成曲线笔触、按参考图与画布的差异决定下一笔落在哪。
Fable 5.2 没有抄这篇论文——函数名、参数、收笔条件都是它自己的。它是在没人告诉它这篇论文存在的前提下,把一套 28 年前的计算机图形学方法重新实现了一遍。
顺带解释一个看起来无关的细节:为什么这两条一个用 p5.js、一个用 Python,同一个模型在其他 demo 里又跑去调 Blender 的 API。因为载体换的是"谁来画线",不是"怎么落笔"。p5.js 在这类程序里贡献的只有 createCanvas、line 和 draw 循环,三十行;换成原生 canvas 做同一件事,每画一笔的代码量翻四倍,而且默认笔头是方的——方头笔触一眼就像马克笔,油画感当场消失。模型选 p5.js,是因为"创意编程"这类语料里它就是出现频率最高的体裁。
二、我们照它说的写了一版
只看解释判断不出难度,所以我们照那四步写了一个 Python 版本,参考图换成一张公有领域的韦布望远镜图像,从空画布开始跑。
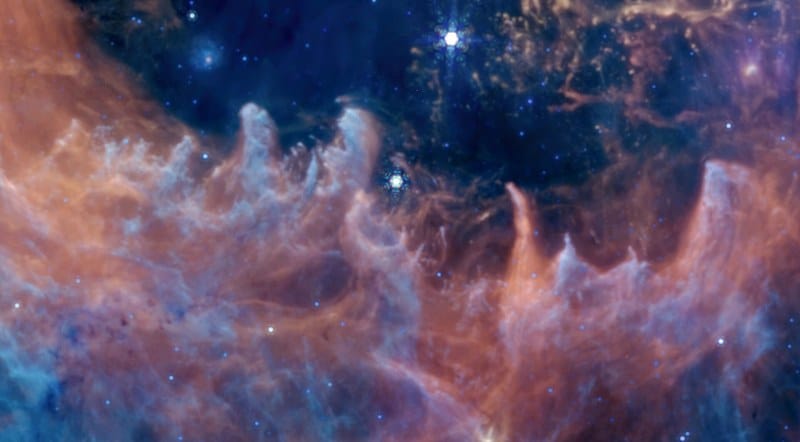
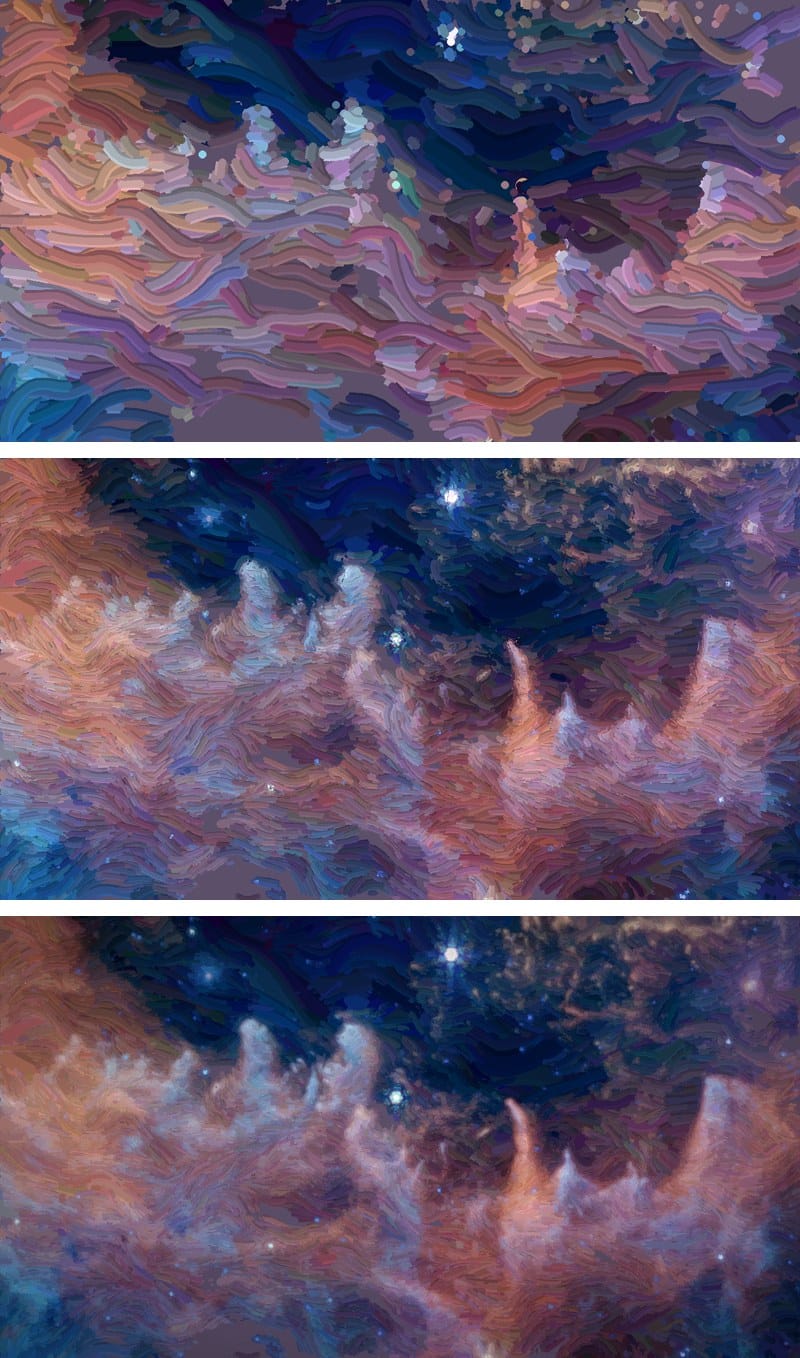
六遍跑完的结果:
| 遍 | 笔宽(px) | 笔数 | 累计 | 与参考图平均误差(/255) |
|---|---|---|---|---|
| 1 | 30 | 480 | 480 | 20.8 |
| 2 | 15 | 1,244 | 1,724 | 17.6 |
| 3 | 7.5 | 6,117 | 7,841 | 13.8 |
| 4 | 3.5 | 4,523 | 12,364 | 12.0 |
| 5 | 1.8 | 23,974 | 36,338 | 9.6 |
| 6 | 1.0 | 29,233 | 65,571 | 8.0 |
65,571 笔、283,036 段落笔、单线程 Python、机器上没开 GPU,两次运行分别 14 秒和 44 秒(同一份脚本,机器负载不同)。与参考图的平均绝对误差 3.1%,PSNR 27.3 dB。收尾的暗角会把误差抬到 12.9——那是刻意的,人眼觉得压暗之后更像照片。
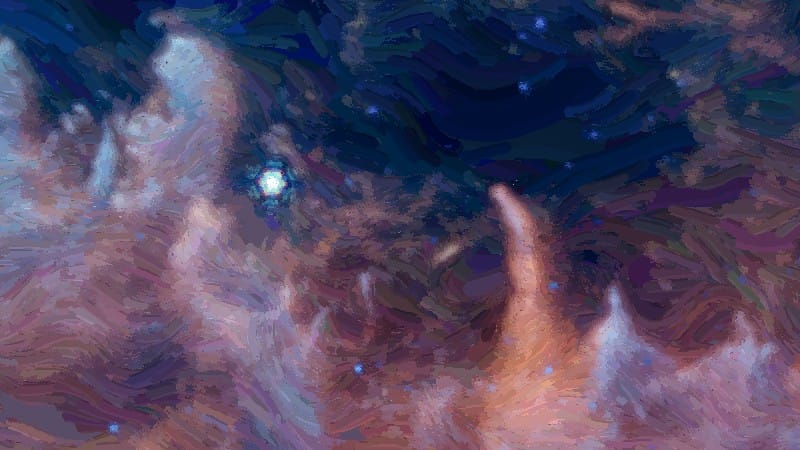
每一遍开始前都会重算一次"画布与参考图的差",只往差异大的地方落笔——这是 1998 年那篇论文的核心做法,也是 48 万笔里废笔不多的原因。不加这层判断、均匀铺满,多出来的笔会全部落在已经画好的地方:同样一笔预算,画出的细节少一半。
复现里有三件事推文没写、但必须自己撞出来:
- 方向的取法。 第一版把"明暗变化最剧烈"当真,直接用梯度方向,瓶口和花瓣全部糊成一片。换成结构张量的切线方向才对。
- 平坦区域的方向。 云和背景没有轮廓,如果沿用局部梯度,笔触会在原地打转,画出来像漩涡。要叠一层低频噪声,两套方向按边缘强度加权混合。
- 颜色扰动的量级。 粗笔给 ±9 的随机色偏是"手抖",细笔给同样的幅度就是"撒彩纸屑"。扰动必须随笔宽缩放,否则最后两遍会把画面打成噪点。
第一条不是审美问题,是几何问题。照抄推文那句话的人,一定会卡在这里。
和推文那版比,我们这份有两处不一样,写出来方便对照:笔宽按画布宽度等比缩放(同一个 26 像素,画在 2228 宽的画布上和 800 宽的画布上完全是两种东西);分成六遍而不是五遍,因为 26 到 1.5 之间差一个数量级,中间少一层,第 4 遍的笔会落在还看得见台阶的色块上。另有一个取舍:细笔落哪里,推文用的是手标的区域(脸、手、龙头),我们用的是边缘强度——手标更准,但换一张图就得重新标一遍。复现脚本约 130 行,依赖只有 numpy、PIL 和 scipy。
三、笔数不是难度指标
三个数字摆在一起容易被误读:8584、48 万、70 万。@jkeatn 画那张"尽可能与照片无法区分"的图用了约 70 万笔,@wquguru 的静物只用了 8584 笔,差 80 倍。
笔数反映的是每笔有多长,不是模型有多强。我们这一版平均每笔只有 4.3 段、12 像素——收笔的色差阈值设得紧,笔刚走几步就碰到颜色变化停下来。所以成品更像点彩,而不是扫笔。8584 笔那张正相反,每一笔都拉得很长,一笔能扫过半个花瓶。
同一块画面,8000 次长笔和 48 万次短笔可以盖出差不多的覆盖率,质感完全不同:长笔是梵高,短笔是修拉。判断一个 demo 有多难,看的是笔触秩序,不是笔数。
这两种质感之间只隔两个旋钮:每笔最多走几段,以及色差超过多少就收笔。把段数上限从十来段提到几十段、收笔阈值放宽一倍,点彩立刻变成扫笔,代价是轮廓附近开始糊。稳妥的调法是先只动段数上限、把阈值留死,看成品能不能接受;一上手就两个一起动,出了问题分不清是谁的错。
四、"计算量只有万分之一"这笔账
这句话最容易被当成结论转发,所以值得把算式摊开。
- 我们这边:65,571 笔 × 平均 4.3 段 ≈ 28 万次线段光栅化,纯 CPU,全程没有一次前向推理。
- 扩散模型那边:一张 1024 级别的图,二三十步去噪、每步一次全图前向,量级在 10¹⁴–10¹⁵ 浮点运算。
差 10⁴–10⁵,方向和量级都对得上。
能耗那句要看条件。我们单线程跑 43.5 秒(慢的那次),按整机 65 W 粗算约 2.8 千焦;一次 GPU 出图按 400 W 跑 5 秒约 2 千焦——同一个量级。也就是说,渲染器写得像这版 Python 这么慢,能耗一点都不省。 宣传里的 10 到 100 倍能成立,前提是引擎跑在浏览器里、一两秒画完,而推文那版正是 p5.js 写的。
两笔账合起来,真正省下来的不是电力,是参考图已经存在这件事:颜色和构图不用猜。
五、"品味"就是那些没人要求它定的常数
把上面两张表拆开看,真正撑起"像一幅画"的,是模型自己试出来的一串数字。
| 参数 | 它给的值 | 换掉会怎样 |
|---|---|---|
| 笔宽阶梯 | 26 / 13 / 6 / 3 / 1.5 | 阶梯拉不开就是滤镜;阶梯太密,笔数爆炸而画面没变化 |
| 细笔的门槛 | 轮廓明显处 + 脸/手/剑几个重点区 | 全图均匀铺细笔 = 一层噪点 |
| 收笔条件 | 色差超过阈值就停 | 不设它,大笔把花瓶边缘的颜色拖到桌布上 |
| 单笔形状 | 走 4 小段、略弯 | 直线画出来是矢量插画,不是油画 |
| 大笔的边缘 | 两侧淡亮线 + 淡暗线 | 没有它,笔触是色块拼贴,不是颜料堆叠 |
| 平坦区方向 | 低频噪声 | 沿用梯度,画面出现漩涡与条纹 |
| 收尾 | 辉光、暗角、纸纹、粒子 | 不压暗就是平光贴图;不加粒子,视频停在最后一帧很干 |
这七行没有一行会出现在常见的 prompt 写法里。它们是从"画得像"这个目标反推出来的常数——也就是成品和"滤镜"之间那条线。
六、同一只手还画了别的
@wquguru 那条的重点其实不只是画。他在同一条推里报了另一件事:作曲,同样用 Python 生成,编制是马林巴、钢琴、钟琴和一条铺底长音,并且直接拿来对比 Opus 5.5——"单调到刺耳"。
同一批 demo 里还有更远的:@Tech Friend AJ 让模型写了 4800 行 Python 调 Blender 的 API,全程不碰图形界面,把 3D 场景的建模、动画、渲染一次做完;@camperaigg 用 2000 行 Three.js 跑了 83 分钟做出一段动画,人物的动作表演被评价为"审美强得离谱"(这两个数字来自知乎作者数字生命卡兹克的整理,本刊未逐条复核)。
这些产物的共同点是:它们都不是"生成内容",而是"写一个生产内容的程序"。 画画那几条中间站着一个笔刷引擎,3D 那几条中间站着一个建模脚本,音乐那条中间站着一套合成器与配器表。
判断一个 demo 属于哪一类,看它有没有这层带名字的中间层。调 API 出的图,中间层是别人的模型;这篇文章里的两张画,中间层是它自己写的 buildFlow 和 dab。前者靠算力,后者靠把模糊目标翻译成参数——这也是为什么同一只手,能在两天里既画油画又写 3D 渲染。
音乐那条比画更说明问题:它在描述里报的是编制(马林巴、钢琴、钟琴、铺底长音),不是"好听的旋律"。这说明程序里至少有乐器分层、包络和混响这几层结构,而不是把一串音符直接播出来而已。模型在那里做的也不是"作曲",是写一台合成器加一张配器表。
七、想让模型一次给对,prompt 要写什么
两条推都没有贴原始提示词(我把全文抓下来核过,正文只有结果和这段解释)。但可以根据它给出的四步反推出该写什么。硬约束只有三条,其余全部留给模型:
[附一张图] 用 p5.js 写一个单文件 sketch.js,把这张图画成一幅油画,一笔一笔画出来。

约束:
- 不许调用任何图像模型、不许用滤镜或色彩量化、不许把原图贴到画布上、
  不许用 SVG 自动描摹。
- 原图只能放在离屏 canvas 上用来取色;观众看到的每一笔都得是程序画的。
- 单文件,双击 index.html 就能跑,无外部依赖。
- 加载后自动作画,逐帧累积,能看到笔触一层层叠上去;画完停在成品。

验收:放大到 100% 能看清笔触走向;花瓶、手指这类边缘不许被笔触糊掉;
总笔数打在控制台,不少于 20 万;成品构图和原图一致。
三条反捷径约束是这段 prompt 的全部价值。不写它们,模型会给你 drawImage 加一个滤镜,或者把原图 base64 塞进 canvas——那也是"一次生成就能跑"的程序,但什么也没证明。
反过来,把 26 / 13 / 6 / 3 / 1.5 写进 prompt 就等于替它想完了,出来的东西会像上一个时代的模板。该写死的是约束和验收,不该写死的是参数。
推文里那段四步解释,是追问出来的:写完程序之后再问一句"讲讲你的实现",它会用自己起的函数名把设计复述一遍。想让别人看懂你的 demo,这一轮的产出比程序本身更适合发出来。
三种最常见的失败长这样:第一遍就把轮廓糊了,是方向场取错,回去改几何、别调笔宽;每一遍都在原地打转,是平坦区缺低频噪声;成品像撒了一层彩纸,是细笔的色扰没随笔宽缩放。
八、边界
它不会凭空画。 @vctbtc 和 @wquguru 两条都用参考图,本质是"照描"——颜色和构图都来自输入。@jkeatn 9 月那条明确写了另一条更难的路:不用任何参考图,只凭模型对每位画家的了解生成程序,7500 行代码模拟不同笔刷。两条路的难度不在一个量级,混着说会高估这项能力。
版权是双份的。 参考图的版权归参考图;生成物的版权还没有定论。我们这篇用的参考图是 NASA / ESA / CSA / STScI 的公有领域图像,这是最省事的选法。
视频不是加速播放。 它是逐帧画出来的:每帧落几千笔,所以你能看见"画"的过程。想发视频,别渲染成一张图再慢慢揭开——那等于放弃了这条路最值钱的部分。
最该记住的一句:这不是"AI 会画画",是"AI 会写画笔"。 它证明的是模型能把一个模糊的感官目标("像油画")翻译成可执行、可调参、可复现的程序,而不是它有了审美。
想自己试,三步
- 找一张 800–1600 像素宽的图,最好是公有领域或自己的照片,先别用人像——手指和发丝是最难的两处。
- 用上面那段 prompt 让模型出单文件版,跑起来先看第一遍:如果粗笔就把轮廓糊了,先改方向场,别急着调笔宽。
- 把每一步的笔数和误差打进日志。差别就在这两个数字里:笔数上不去,画面永远像滤镜;误差下不来,说明收笔阈值和细笔的门没配对。
做完之后你会发现,48 万笔这个数字没那么神秘——它只是"五遍阶梯 + 收色差就停笔"这两个决定的算术结果。
来源
- @vctbtc(赛博永生 vct),X,2026-11-11:https://x.com/vctbtc/status/2120344162730123733(48 万笔、五遍 26/13/6/3/1.5、四步说明均为原文)
- @wquguru,X,2026-11-10:https://x.com/wquguru/status/2120177800288378938(500+ 行 Python、8584 笔、配器)
- Jake Eaton(@jkeatn),X,2026-11-09:https://x.com/jkeatn/status/2119874018706874601("as indistinguishable as possible from a photograph",约 70 万笔);2026-09-22:https://x.com/jkeatn/status/2102441348075057539(7,500 行、不用参考图)
- Anthropic,《Introducing Claude Fable 5.2 and Claude Mythos 5.2》,2026-11-09:https://www.anthropic.com/claude-fable-and-mythos-5-2
- 数字生命卡兹克,《Claude Fable 5.2 证明了,AI 可以靠代码吞噬一切。》,知乎,2026-11-10:https://zhuanlan.zhihu.com/p/2103833893174523205(第六节 4800 行 Blender、2000 行 Three.js 两个数字转引自该文)
- Aaron Hertzmann,《Painterly Rendering with Curved Brush Strokes of Multiple Sizes》,SIGGRAPH 1998:https://doi.org/10.1145/280814.280951
- 参考图:NASA / ESA / CSA / STScI,《The Sickle: Pillars of Creation in the Galactic Center》,公有领域:https://commons.wikimedia.org/wiki/File:The_Sickle-_Pillars_of_Creation_in_the_Galactic_Center_-_NASA-ESA_JWST_Space_Telescope_(54475890271).jpg
关于本文的数据
第二至五节的笔数、耗时、误差为本文自建脚本实测(六遍、1600×884、单线程 Python、两次运行 14 秒与 44 秒);功耗与扩散模型算力为数量级估算,非实测。两条推文的画作均为作者各自生成,本文未复现其具体参数。
相关阅读:AI 视频生成教程:让 coding agent 写代码出片,实测 162 秒拿到第一条 MP4——同一条路子的视频版:不调用视频模型,让 agent 写代码逐帧出片。|Fable 5.2 控制机械臂:仿真 64.9%,真机撑不满动作预算——同一个模型,另一条线的实测。|多模态生成完全指南——图像、视频、语音与设计的工作流地图。
这是「多模态生成」专题的一部分。完整地图见:多模态生成完全指南