Falcon-ASR 发布:1.6B 阿拉伯语语音识别模型,六项基准平均 WER 20.92%
阿拉伯语方言数据稀缺、口音差异大,长期是 ASR 的"硬骨头"。阿布扎比 TII 发布 Falcon-ASR:1.6B 参数,五种语言共用一套权重且无需语言标志,六项阿拉伯语基准平均 WER 20.92%,阿联酋方言 22.73%,英语 5.74%,还支持词级时间戳。本文完整编译官方数据与训练细节。
一句话结论:阿拉伯语语音识别多了一个新选项。阿布扎比技术创新研究院(TII)发布 Falcon-ASR:1.6B 参数,以阿联酋方言为重心,在 6 个阿拉伯语测试集上平均 WER 20.92%——比它引用的榜单快照最佳结果(23.17%)低 2.25 个百分点;英语平均 WER 5.74%;同一套权重支持 5 种语言,且不需要语言标志位,并支持词级时间戳。
本文完整编译自 TII 在 Hugging Face 发布的《Introducing Falcon ASR》(2026-10-07),并做中文整理。
图 1:Falcon-ASR 同时面向阿拉伯语与英语,官方 Demo 支持最长 60 秒音频转写(来源:TII / Hugging Face)。
一、阿拉伯语 ASR 为什么难
语音识别的通用难题是口音与场景,阿拉伯语把这两点都拉满了:
- 地区差异大。阿拉伯语口语随地区、说话人、场景变化明显。一个能处理正式新闻播报的模型,未必搞得定阿联酋方言的日常对话,也未必适应电话线路里的音质损失;
- 方言转写资源少。方言阿拉伯语的转写语料比现代标准阿拉伯语(MSA)少得多,训练和评测都更难;
- 语码转换频繁。真实对话里经常混用方言、MSA 与英语,模型要能跟着说话人切换。
TII 的做法是把训练数据铺开:阿联酋方言、MSA、其他海湾与阿拉伯方言,以及英语都进训练集。目标很明确——转写人们在日常对话里实际使用的词,包括方言形式和语言之间的切换。
二、Falcon-ASR 是什么
| 项目 | 说明 |
|---|---|
| 参数规模 | 1.6B |
| 语言 | 阿拉伯语(重点:阿联酋方言)、英语、法语、西班牙语、葡萄牙语 |
| 权重 | 五种语言共用一套,无需语言标志(language flag) |
| 输出 | 转写结果使用所讲语言,不做强制翻译 |
| 附加能力 | 词级时间戳:每个转写词对应到音频中的位置 |
"不需要语言标志"这一点值得单独说明:很多多语言 ASR 需要你提前告诉模型"这段音频是什么语言",Falcon-ASR 省掉了这一步——同一套权重直接处理五种语言,输出就是说话人实际使用的语言。词级时间戳则让转写结果可以直接用于字幕对齐、音频检索、会议纪要定位等下游场景。
三、阿拉伯语基准:平均 WER 20.92%
评测协议来自 Open Universal Arabic ASR Leaderboard(由 ELM Research Center 维护):按六个测试集的等权平均 WER 排名,同时报告字符错误率(CER),两个指标都是越低越好。TII 使用该榜单固定的 manifest 在同样六个基准上评测;竞品数字取自该榜单在 2026 年 9 月 30 日核对过的已发布平均值。
两个指标先解释清楚:
- WER(Word Error Rate,词错误率):识别错误(替换、删除、插入)的词数占参考词数的比例;
- CER(Character Error Rate,字符错误率):在字符粒度上统计同样的错误,对黏着语和形态复杂的语言更有参考价值。
结果:Falcon-ASR 平均 WER 20.92%,比该快照中最好的已发布结果 23.17% 低 2.25 个百分点。
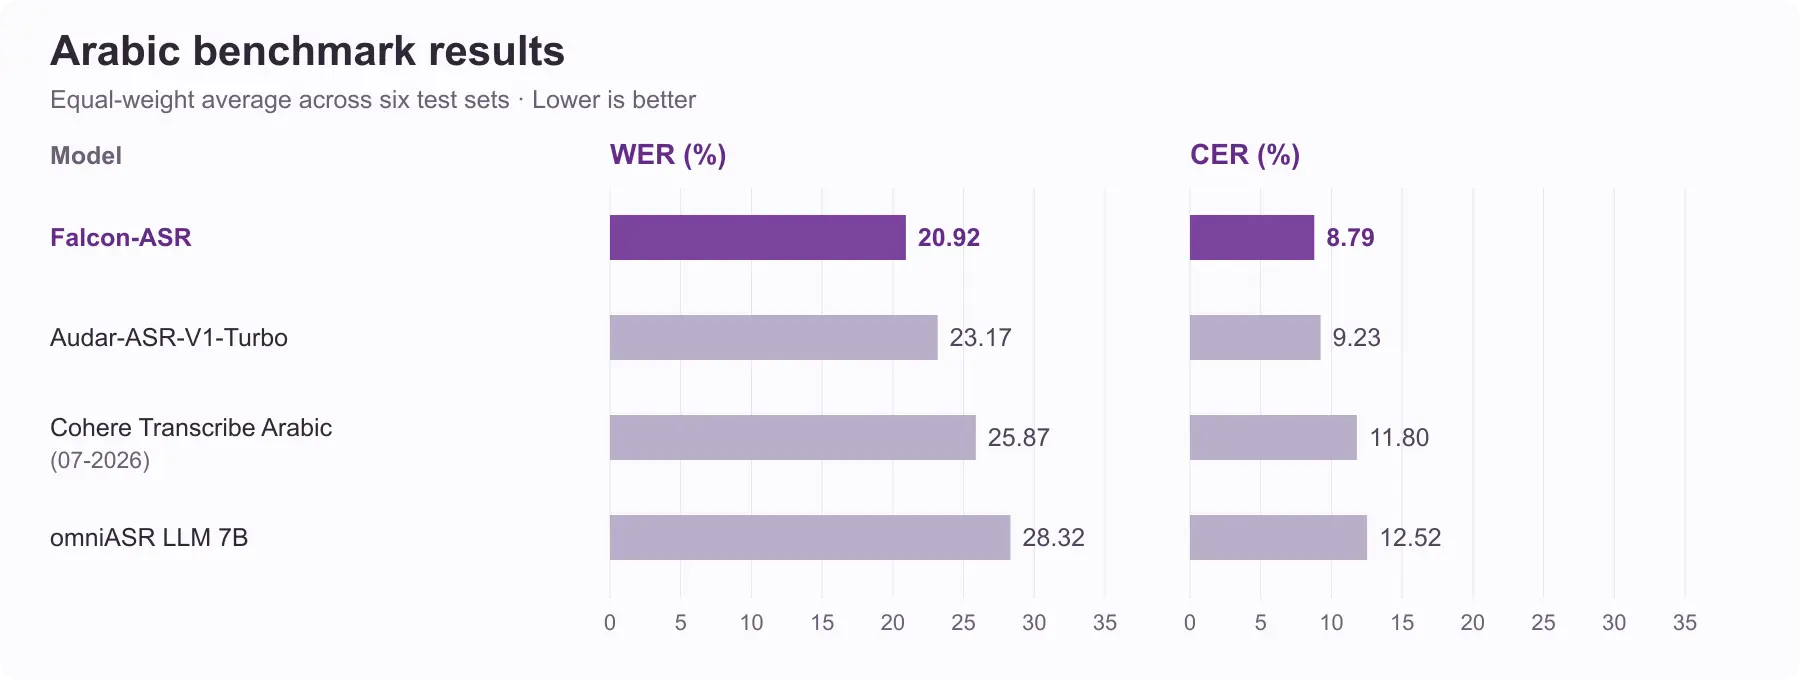
图 2:在开放式通用阿拉伯语 ASR 榜单的六个测试集上,Falcon-ASR 与已发布系统的 WER / CER 对比(来源:TII / Hugging Face)。
四、阿联酋方言:内部评测 WER 22.73%
公开评测数据里其实已经包含阿联酋语料——Casablanca 数据集带一个 UAE 子集。TII 在此基础上补充了一个内部评测:额外的阿联酋语与海湾语录音,使用留出录音和人工校验的转写,评估公开子集之外的转写准确率。
结果是:
| 指标 | Falcon-ASR |
|---|---|
| WER | 22.73% |
| CER | 10.19% |
Falcon-ASR 在这组对比中拿到最低的 WER 与 CER:WER 比排名第二的 Qwen3-Omni 低 4.07 个百分点。官方表示,这组数字说明模型在该评测上词级与字符级的转写准确率都有改善。
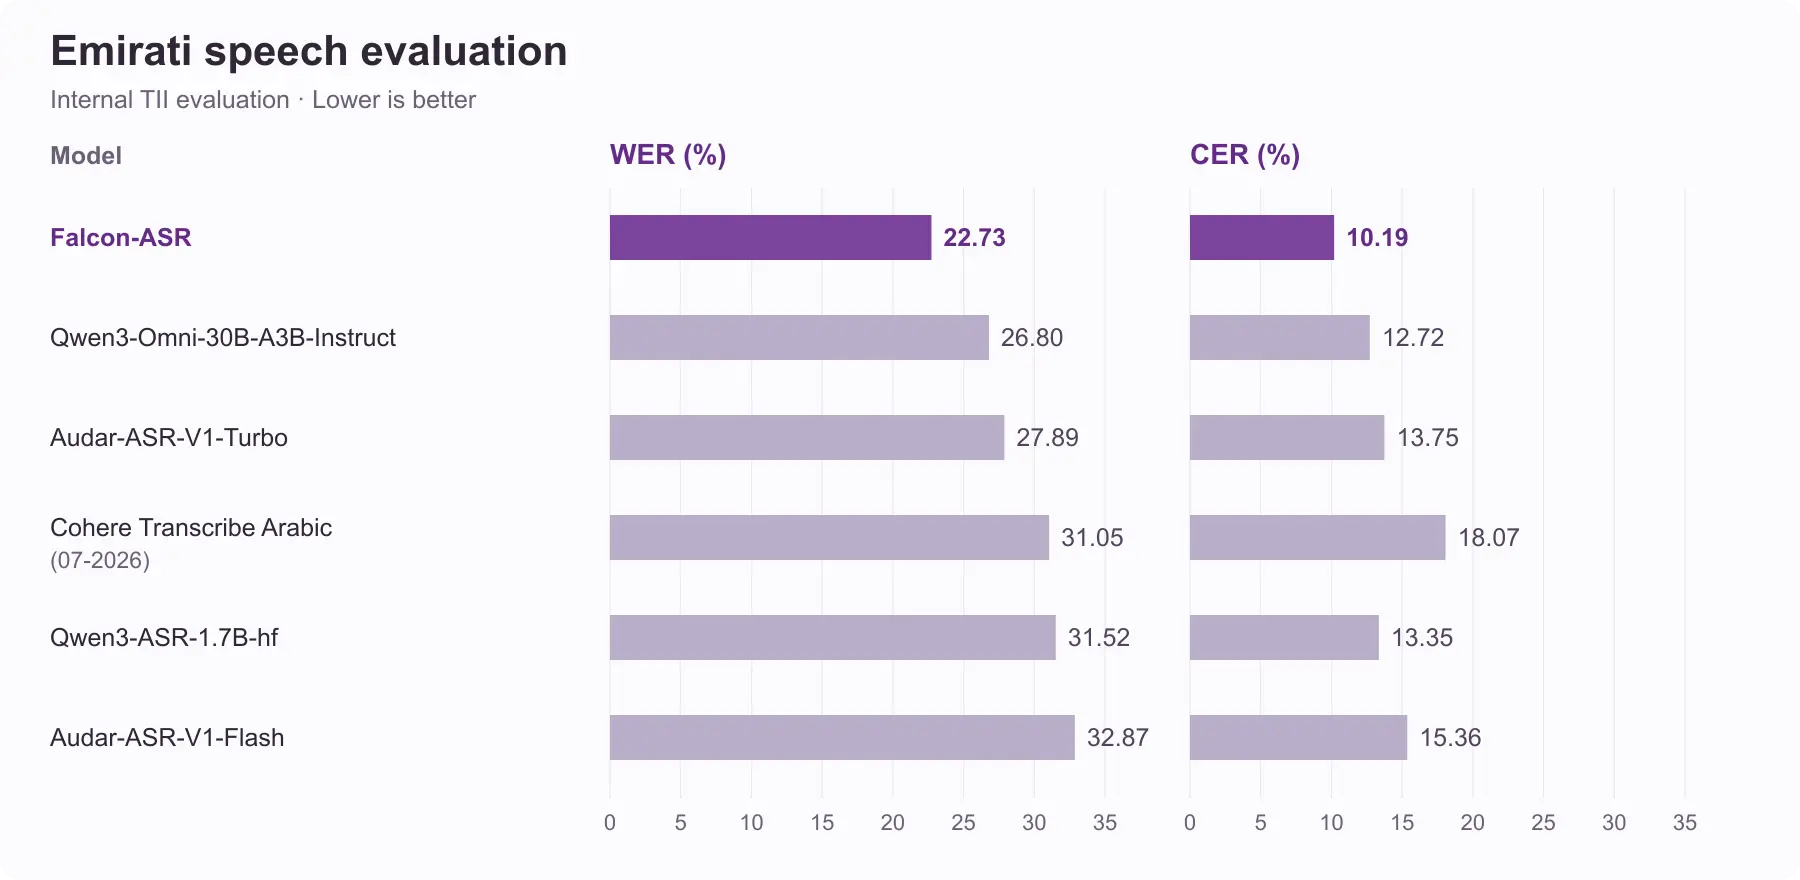
图 3:阿联酋方言内部评测中,Falcon-ASR 与对比系统的 WER / CER(来源:TII / Hugging Face)。
五、英语与另外三种语言:平均 WER 5.74%
Falcon-ASR 用同一套权重转写英语。在 Hugging Face Open ASR Leaderboard 使用的 7 个公开英语测试集上,平均 WER 为 5.74%。
此外,模型还支持法语、西班牙语、葡萄牙语。五种语言共用同一套权重,不需要传语言标志,输出是所讲语言的转写。对一个 1.6B 的多语言模型来说,这种"免语言标注"的接口设计,意味着部署侧不用为每种语言维护语言识别前置模块或分别部署权重。
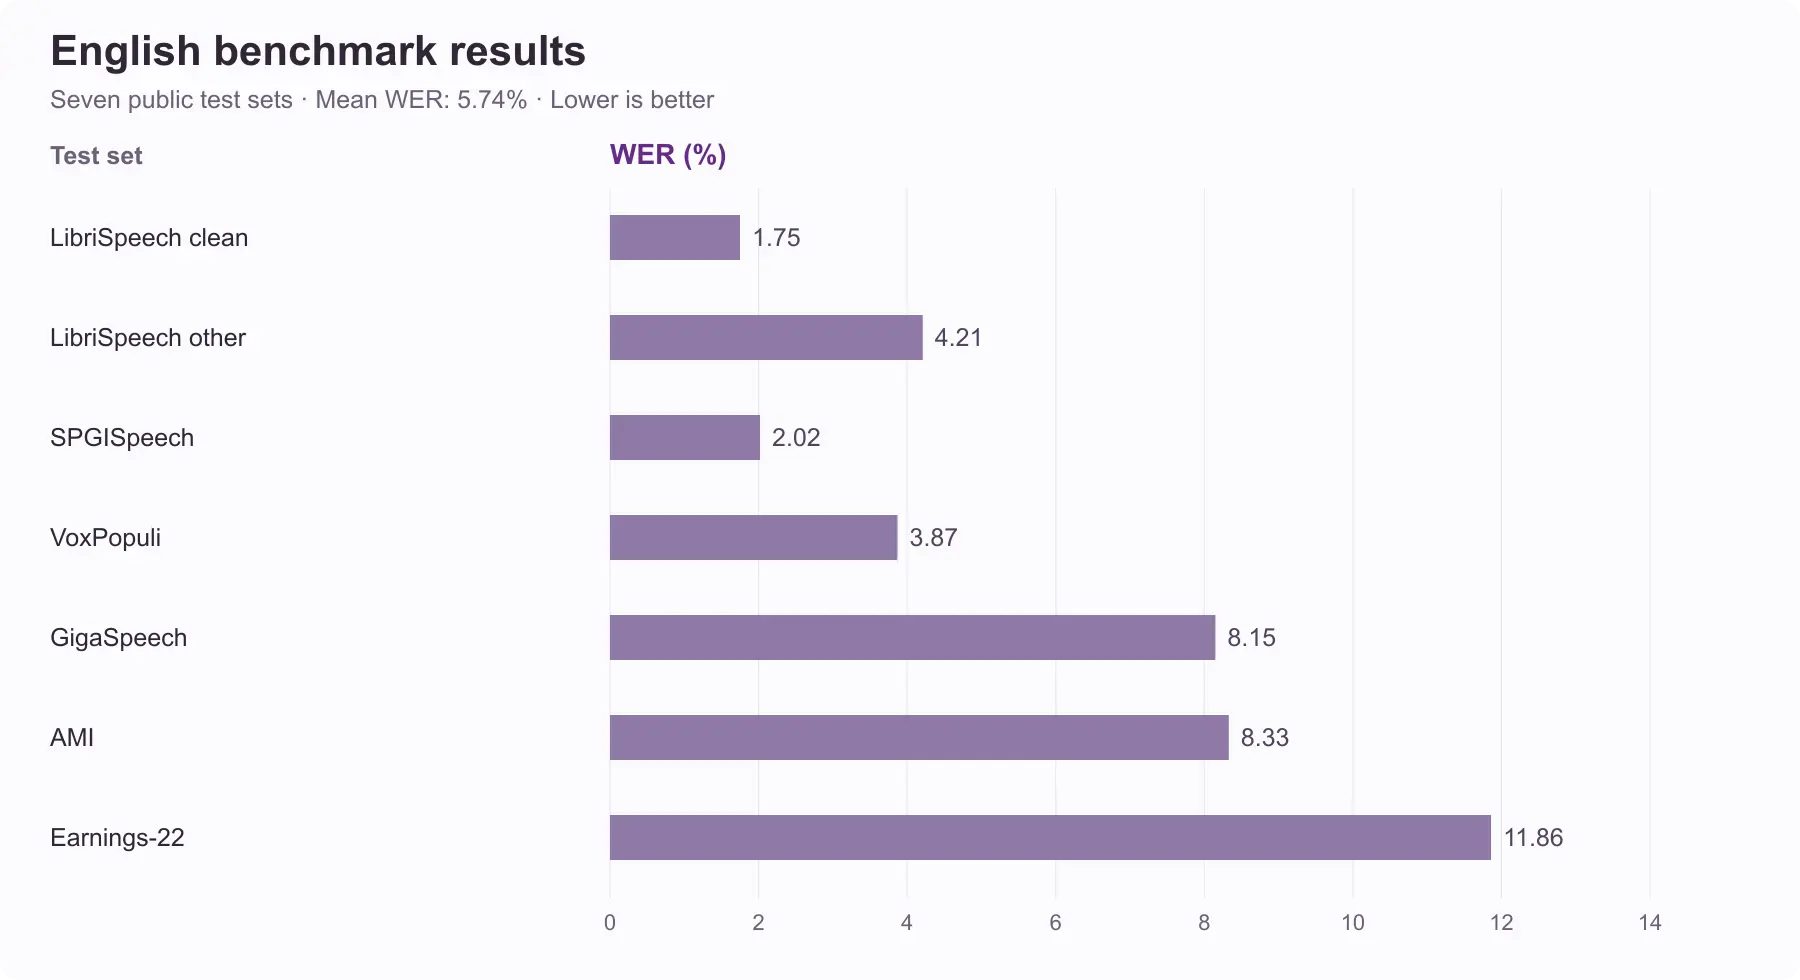
图 4:英语公开测试集上的词错误率(来源:TII / Hugging Face)。
六、录音条件:刻意"加噪"训练
模型要落地,就得面对真实录音的乱七八糟。TII 在训练数据里主动注入了这些条件:
- 背景噪声;
- 重叠语音(多人同时说话);
- 音乐;
- 房间混响;
- 电话链路效应(带宽受限、压缩失真);
- 语速与音高变化。
同样的处理也应用到了阿联酋语录音上——让模型提前见过会议、通话与其他日常录音中可能遇到的各种条件。这属于 ASR 领域的常规"数据增强"思路,但把方言录音也纳入同样的增强管线,对低资源方言场景更关键。
七、技术底座:Falcon3-Audio
Falcon-ASR 基于 TII 此前的 Falcon3-Audio 工作,其架构与训练方法记录在论文《Competitive Audio-Language Models with Data-Efficient Single-Stage Training on Public Data》中——关键词是数据高效的单阶段训练,即用相对精简的训练流程在公开数据上达到有竞争力的音频语言模型效果。TII 同时致谢 Falcon-Emirati 团队在阿拉伯语基础模型上的支持。
八、怎么动手试
- 在线 Demo:Hugging Face Space「Falcon ASR Demo」支持上传最长 60 秒的音频直接体验转写;
- API 与原生应用:官方表示在计划中;
- 评测复现入口:Open Universal Arabic ASR Leaderboard(榜单与 manifest 公开)。
对做多语言客服、会议转写、语音字幕、方言语音数据标注的团队来说,Falcon-ASR 提供了一个新的轻量级选项——官方 Demo 现已可试,API 与原生应用在计划中;对中文社区而言,它"方言 + 多语言 + 免语言标志"的建模思路,也值得在汉语方言或跨境业务场景里借鉴。
参考来源
- TII / Hugging Face:《Introducing Falcon ASR》(2026-10-07)https://huggingface.co/blog/tiiuae/falcon-asr
- Falcon-ASR 在线 Demo:https://huggingface.co/spaces/tiiuae/falcon-asr-demo
- Open Universal Arabic ASR Leaderboard:https://huggingface.co/spaces/elmresearchcenter/open_universal_arabic_asr_leaderboard
- Casablanca 数据集(含 UAE 子集):https://huggingface.co/datasets/UBC-NLP/Casablanca
- Falcon3-Audio 相关论文:https://arxiv.org/abs/2509.07526
延伸阅读(本站)
本文由 汇智网 · Software 2.0 编译整理,转载请注明出处。