敏感单据不上传:本地 3B 模型转写 + 代码校验
敏感票据交给云端?三份本地实测给出另一条路:3B/7B 模型只负责"抄",Python 负责校验与计算——95% 字段正确,错误全部进人工队列。
一句话结论:把敏感单据交给云,最贵的一步不是 API 账单,而是"客户的财务记录离开了这台机器"这件事本身。2026 年 10 月出现了三份值得一起读的本地实测:巴西会计的票据阅读器、日本合格发票的 QLoRA 抽取器、阿尔伯塔电费单的比价工具。它们用的模型都不大(3B 到 8B),字段级正确率 95%~97%,但真正决定能不能用的是另一件事——错误有没有被"抓住":巴西那份的 3 处错误全部来自一张故意模糊的收据,全部进了人工复核队列;日本那份在 600 张合成发票上自动通过 86.8%,已通过样本中被校验覆盖的字段 0 错;电费单那份靠 20 条确定性检查,把一次会把"省 $117.70"算成"亏 $117.70"的误读拦在了报价页之前。共同配方只有一句:模型只负责"抄",代码负责"算",人负责"签"——再加上一台自己的机器。
披露:三份单据项目均来自 dev.to(2026-10-15 / 10-16),其中巴西票据与电费单是 Hacktoberfest 2026 的参赛作品,代码 MIT 开源;日本发票项目的数据集与适配器公开在 Hugging Face,全部为合成发票,作者明确"不构成对真实发票的任何声明",且基座模型为 Qwen 研究许可(非商用)。硬件两篇中,@theclairvoyantbeing 为通用 PyTorch 工程技巧(无产品推广);@thomaspoli 的预算指南文内链有第三方教程(推广性质),显存数字可按公开模型卡核对。所有数字按"方法与口径"引用,未做独立复测。
一、三份"本地读单据"的实测
1. 巴西会计的 100 份发票:95% 字段正确,错误全部进了复核队列
一位自雇会计,每周从小微客户那里收到约 100 份文件:NF-e 发票(PDF)、手机拍的 NFC-e 小票、Pix 转账截图,偶尔还有手写的 recibo。过去她把这些逐条敲进表格。leitor de notas 把这件事变成:拖入文件 → 选会计月(competência)→ 本地 Ollama 模型读 → Python 校验并标出必须人工看的行 → 她在可编辑表格里改 → 导出 Excel(一张分录表 + 一张分类汇总)。
为什么必须是本机?因为这些是客户的财务记录,受巴西《通用数据保护法》(LGPD)约束——"把你客户的银行收据上传到我们的云"对她的客户是硬推销。项目作者把账算得很明白:隐私就是产品。全流程唯一的网络调用是本机的 localhost:11434(Ollama);连 Streamlit 默认开启的使用统计都关掉了(gatherUsageStats = false),服务只绑定 localhost。成本账同样清楚:每周 100 份文件,按页计费的 API 会直接吃掉会计的利润,而一块显卡是一次性支出;模型名写在一个常量里,出现更好的小模型时改一行、重跑评测即可,不需要新合同、新定价。
流水线做了一件关键的事:用"最便宜但够用"的模型分层。
可提取文本的 PDF(> 50 字符)──► pdfplumber ──► qwen2.5:3b
扫描 PDF ──► 渲染成图片 ─────────┐
JPG / PNG ──────────────────────┴──► qwen2.5vl:7b
                      │
                      ▼
  JSON Schema 约束输出 ─► Python 逐字段校验 ─► needs_review = True/False
大多数 NF-e 是带文本层的真 PDF,根本用不到视觉模型;输出用 Ollama 的 format 参数直接接 pydantic 模型的 JSON Schema,保证永远能解析。评测集是 10 份虚构文档:文本 PDF、Pix 收据、倾斜的手机照片、手写收据,外加一张故意模糊到读不出来的。结果:95% 的字段正确,3 处错误全部来自那张模糊件——模型在那儿幻觉出一个日期和一个 CNPJ,两处都被校验抓住,文档进了复核队列,这正是应该发生的事。在 AMD RX 9060 XT(Ollama,Vulkan)上,每张文本 PDF 2.2 秒、每张图片 4.0 秒,一周的文档约 5 分钟跑完。
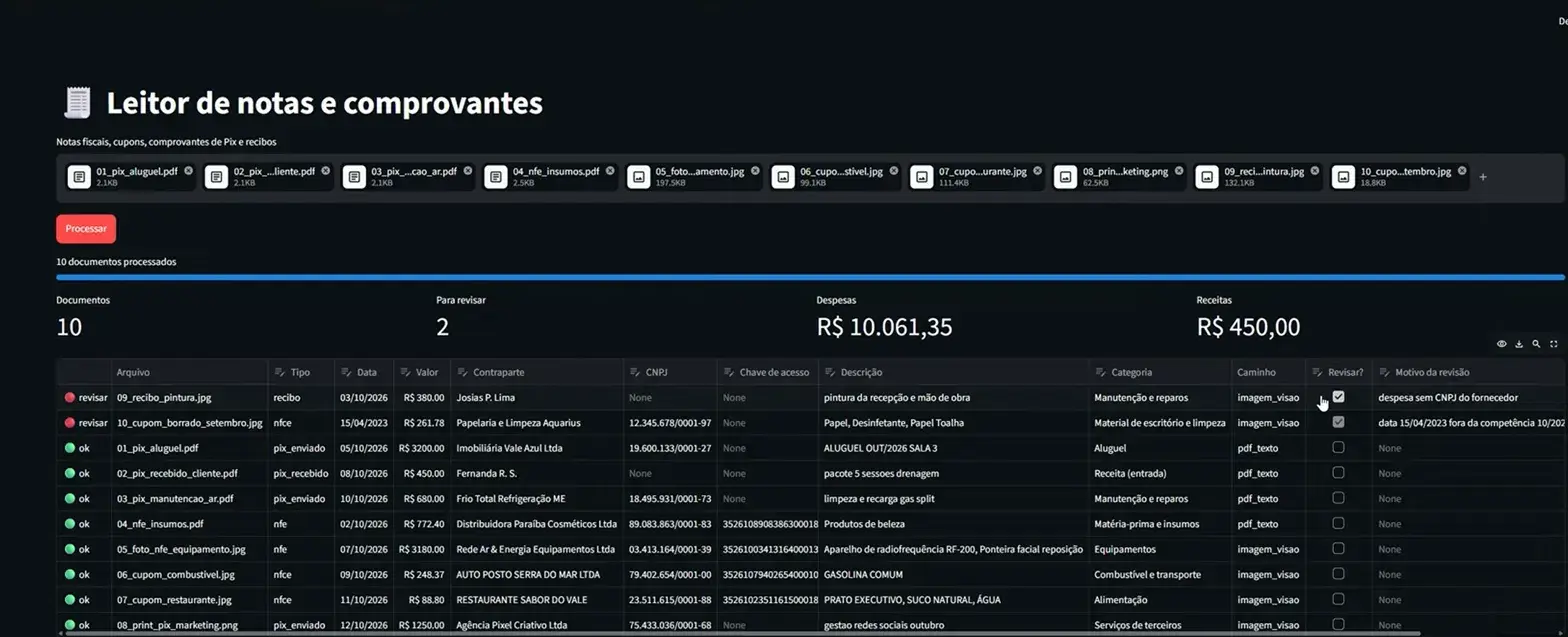
leitor de notas 的复核界面:10 份文档、2 份标红待审(revisar),每行有模型值、来源路径(pdf_text / imagem_visao)与人工修改入口。图源:@mathfe(dev.to)。
三条经验,比数字更值得抄:
- 不要让小模型做推理和角色判断。最初的提示词要模型判断"对手方:采购时是开票方,收款时是付款方",3B 模型总是返回发票的收件人——也就是会计自己。修法是只问"纸面上写着谁收了钱、谁付了钱",对手方由 Python 决定。更漂亮的是:巴西发票的 44 位访问键里嵌着开票方的 CNPJ(第 7–20 位),Python 可以据此确定性地纠正模型交换的买卖双方;访问键本身还有 mod-11 校验位,一段正则找到、算一下校验位就能确认——"3B 模型抄 44 位数字一定会掉一位"这件事,也就有了兜底。
- 一个提示只回答一个决策。抽取提示同时选分类时,分类准确率只有 70%:"Limpeza e recarga gás split"(空调清洗)被归到清洁用品,一笔收到的 Pix 被归成餐饮。两处修改把它推到 100%:收支方向由规则判断(单据类型 + 客户自己的 CNPJ 是否是收款方),支出分类再发一次只带供应商名、单据类型和一句描述的小请求(约 0.3 秒),用带单行提示的枚举做选择题。"小模型答一个窄问题,远好于一次答五个。"
- 校验就是产品本身。每条记录在被人信任之前都要过 Python:CNPJ 校验位(包括 2026 年 7 月起强制的新版字母数字 CNPJ)、NF-e 访问键的 44 位 + mod-11(且键里的 CNPJ 必须与开票方一致)、金额 > 0、日期落在所选会计月内、没有供应商 CNPJ 的支出(比如个人开的 recibo)被标记出来以便核对代扣税。任何一项失败就置
revisar = True并附一句人话原因,例如"日期 29/09/2026 在会计月 10/2026 之外";把流水线弄崩的文档会变成一条带标记的行,而不是杀掉整批。作者的原话值得记住:"她不需要 AI 完美,她需要知道 10 份里该看哪 2 份。"
至于"让模型重试一次"?作者明确拒绝:一次重试只会产生另一种幻觉,所以校验失败一律转人工。
2. 日本合格发票:86.8% 自动通过,检查之外仍有 4.6% 看不见
第二份实验换了一个更聪明的起点:日本 2023 年 10 月起要求合格发票(適格請求書)印上注册号(T + 13 位)、按税率(10% 标准、8% 优惠)分别列示金额与税额。这给了抽取器一份符号化的真值:注册号登记库是公开的、法人编号有校验位、税额是算术——于是问题不再是"模型准确率多高",而是"检查能抓住多少错误,又会漏掉多少"。
作者用同一份 JSON 格式做了三个抽取器:PaddleOCR 文本框上的手写规则、Qwen2.5-VL-3B 零样本、以及在 3,000 张合成发票上做 QLoRA 微调的同一个模型(1 个 epoch,RTX 3060 上 4 小时 57 分)。然后叠五个累积检查:schema、校验位、登记库(在册、且在发票日期有效)、开票方名称与登记库一致、三种舍入约定(切り捨て / 四捨五入 / 切り上げ)下的税额算术。全过就自动通过,否则带失败原因转人工。600 张测试集上的结果:
| 抽取方式 | 整张完全正确 | 自动通过 | 已通过中"可覆盖字段"错误 |
|---|---|---|---|
| OCR + 规则 | 37.8% [33.8, 41.7] | 55.0% | 0 / 292(95% 上界 1.3%) |
| Qwen2.5-VL-3B 零样本 | 5.3% [3.7, 7.2] | 8.1% | 3 / 43(7.0%) |
| QLoRA 微调 | 83.0% [80.0, 85.8] | 86.8% [83.6, 89.6] | 0 / 461(上界 0.8%) |
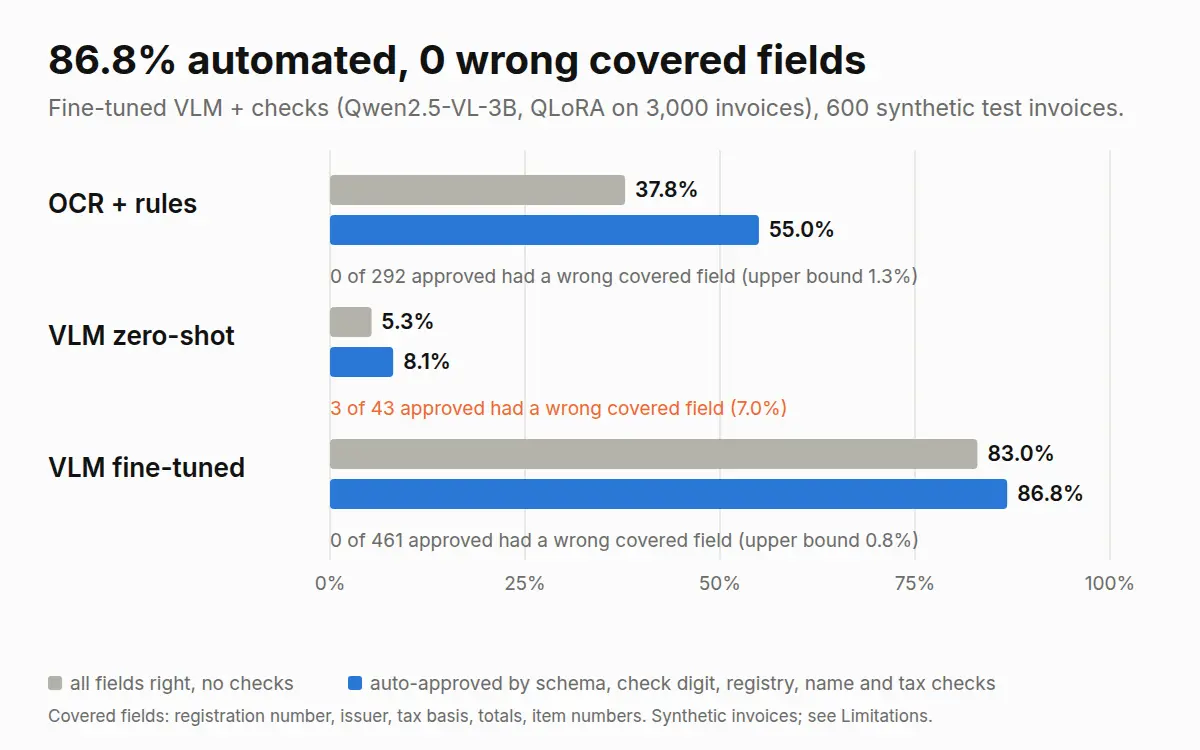
原文配图:600 张合成测试发票上“不加检查的整张正确率”与“加检查后的自动通过率”。图源:@raihan-js(dev.to)。
"可覆盖"指检查能作用于该字段(注册号、开票方名称、税基、合计、条目金额),这个定义在给模型打分之前就固定了。不跑检查的话,微调模型有 12.8% 的输出含可覆盖字段错误——检查把它压到 0。注入的文档问题(坏校验位、未注册号码、已注销发行人、别家公司的号码、错的税额)69 次全部被送进复核,其中 95.7% 被"本该抓住它的那项检查"抓住。
但检查也有明确看不见的地方:微调模型已通过的发票里仍有 4.6% 带错,全部落在没有任何东西验证的字段——10 个错的发票号、10 个错的日期、1 个错的条目;登记库知道开票方是谁,不知道客户是谁,而一个落在有效窗口内的错日期查不出来。OCR 基线的这个问题更严重:32% 的已通过发票,条目描述里有算术抓不到的错字("費" 读成 "费")。检查让"被覆盖字段"可以自动化,剩下的必须另设控制。
失败边界也写得很诚实:横版版式测试集 97.3% 整张正确,没见过的横版 99.0%;竖版只有 40.0%——问题出在侧排的拉丁文字(注册号 62.7%、日期 82.7%),表格反而没事;完全竖版、没见过的版式掉到 4%。学习曲线说明"加更多同类数据"救不了竖版:0 张训练样本时 8.7%,800 张 84.7%,2,400 张和 3,000 张都是 89.3%。还有一个反直觉的数字:在真实登记库(258 万家法人,且全部能通过校验位)里把 30 万个号码各改一位——校验位抓住 95.6%,查库再抓 4.1%,0.29% 会命中另一家真实公司(号码是成簇的);合成登记库没有这种聚集,所以名称匹配才是那张安全网。
3. 阿尔伯塔电费单:20 条检查拦住"亏 $117.70"的误读
第三份是零售场景:把电费单照片变成一张客户能看懂的省钱对比页,外加一行可直接录入的表单数据。作者先找到了让问题可解的那个洞察——账单上只有两行属于零售商:能源费(energy charge)和管理费(admin fee);配送、附加费和本地接入费由监管与市政设定,换哪家都一样。所以"比较"就是两行加差额的 GST,算术很简单,难的是读对。
规则被写在规格书第一行,并贯穿实现:模型只转写纸面上的内容,绝不计算、换算或自行纠正;可疑数字只标记、交给人工,永不静默修复。每张单一请求、附上全部页面、JSON Schema、temperature 0、thinking 关闭;每个字段"必需但可空",于是输出要么完整、要么被拒绝,"我读不出来"是模型可以给出的答案。然后跑 20 条确定性检查,每条返回一个带严重性的标记,例如:
- C01:能源费 = 用量 × 费率?小差额是警告(阶梯电价可以解释),超过 3 倍直接阻断;
- C04:抄表读数是否对得上用量;
- C06:费率与单位是否匹配(这条专抓 ¢ 与 $ 互换,直接阻断);
- C07 / C17:站点 ID 是否是 13 位、以 00 开头(电,绝不能是 000)或 000 开头(气),且不能是账号——有些账号同样是 13 位,模型很容易放错框;
- C12:报价关键字段是否缺失;
- C20:各行相加是否等于打印的小计(从错误行读来的值立刻露馅);
- C19:比较本身是否合理(两侧相差超过 3 倍,说明有数字读错了)。
阻断标记停止报价;警告必须在复核屏上打勾确认;复核者每一次修改都记录模型值、新值和时间。
在 8 张合成账单(3 种版式)+ 1 张 Pillow 生成的"手机照片"上:Gemma 4 e4b 有 5/8 张报价关键字段全对、8/8 输出有效、约 9 秒一张;Qwen3-VL 8b 是 7/8、7/8、约 73 秒一张。字段级 95% / 97% 听起来很好,却恰好是最不该看的数字——关键字段错一位,就是一张错的报价。 真实手机照(Pixel 7 拍摄 7 张)上,Gemma 3/7、Qwen 5/7。
失败案例讲得很直白:一版合成燃气单上,Gemma 把用量 37.49 GJ 填进了能源费栏。正确能源费是 $183.33;用这个值做的报价会告诉客户"换到我们这儿要亏 $117.70",而实际上客户是省钱的——而且它乍看完全正常。抓住它的是 C01:37.49 ≠ 37.49 × 4.89 = 183.33。另外两张:把抄表读数 30,937 读成 30.937 kWh(逗号当了小数点,C04 抓住);把 12.05 ¢/kWh 标成美元(C06 阻断);还有一张,两个站点 ID 都少读一位(0010099000016 → 001009900016),C07 阻断——只检查"字段非空"的工具会安静地接受它。
录制演示时还出过一次真正的翻车:复核屏上改了检查标出的字段、勾了警告确认,页面开心地宣布"你现在贵 $4,072.21,一年 $47,947"。因为那时 C01 还只是警告——一条被人工确认过的警告,等于没拦。于是两处修改:C01 的 3 倍差额改为阻断,并新增 C19 拒绝两侧相差 3 倍以上的比较。新阻断可以覆盖,但必须写下书面理由、随账单保存,而且数字或报价一变、覆盖立即失效。
最后的选型 trade-off 也很诚实:Qwen 在两个集合上都领先,但它总是思考(think: false 无效)、大约慢 8 倍,8 张里还有 1 张 JSON 被 8,192 token 上限裁断;Gemma 快、能"在厨房餐桌上用",而且它出错时检查每次都能抓住。作者保留了 Gemma 作为默认,同时把模型做成一个配置值——eval --model X 就能在同一批账单上给任何 Ollama 视觉模型打分。
二、为什么"模型转写、代码计算"能到 95%
把三份实现叠在一起,配方其实只有四步:
- 模型只做字面抄写。不让它算、不让它转换单位、不让它猜业务角色(对手方、收支方向、税)。小模型答一个窄问题远好于一次答五个——那个 70%→100% 的分类实验就是证据。
- 用符号化的真值做校验。校验位、访问键、公开登记库、算术恒等式,都是"独立于模型"的事实来源;拿它们当第二份证据,而不是再叫一个模型来点评。日本那份更进一步:先固定"哪些字段可被检查"的定义,再给模型打分,避免事后挑口径。
- 约束输出格式,把"看不清"设成合法答案。JSON Schema 保证输出能解析;"必需但可空"让"读不出来"被显式表达,而不是幻觉成一个看似合理的值。
- 失败进人工队列,而不是重试。模糊照片上重试只会换一种幻觉;把失败变成一条带原因的行,才是"让 100 份里该看的 2 份浮出来"。
这套分层的价值不在"本地模型更强"——它明明更弱——而在于每一条产出的可复核性。云端大模型也许能一次读得更准,但你没有把它接进"校验位 + 登记库 + 算术"的机会,也很难把它换成一个能自己保管数据的版本。
三、20 条检查长什么样:五个类别
把三份项目的检查合并去重,大致是五类。写自己的管道时,可以直接当起点:
① 标识类:格式(13 位 / 44 位 / T+13)、校验位(CNPJ、法人编号、mod-11)、嵌入关系(访问键里的 CNPJ 必须与开票方一致)、唯一性(站点 ID 不是账号)。
② 算术类:用量 × 费率 = 费用;各行合计 = 小计;税额在三种舍入约定下都过关;差额能闭合到最小货币单位。
③ 一致性类:日期落在会计期间 / 有效窗口内;名称与登记库匹配(这条能抓住"号码改一位后撞上另一家真公司"的那 0.29%);单位与量级吻合(¢ vs $、kWh vs GJ)。
④ 完备类:报价 / 付款关键字段缺失即阻断;没有供应商的支出标记待核(税代扣)。
⑤ 合理性类:比较两侧相差 3 倍以上、量级明显异常、费率与单位不匹配——这类通常既要报警还要阻断。
配合两条流程规则:严重性分级(阻断报价 vs 警告需勾选确认)、覆盖要留痕(书面理由、随记录保存、输入变化即失效)。日本那份用 69/69 的注入测试证明了检查本身也要被测试;电费单那份则用一次真实的 $4,072.21 翻车证明了"人工确认过的警告等于没拦"。
四、4–8GB 显卡的省显存四招与本地模型内存表
三份管道主要是推理(Ollama),一台带中端显卡的机器就够;但如果你想在本地做微调(日本那份的 QLoRA 在 RTX 3060 上跑了约 5 小时),或者只是想在自己的机器上跑 PyTorch,另一份材料给了四个立刻能用的技巧:
- 梯度累积模拟大 batch:把 batch 64 拆成 4 × 16,逐微批累积梯度、每 4 步才更新一次优化器;显存里只放 16 的激活,但优化器轨迹等价于 64。
- 混合精度(
torch.amp的 autocast + GradScaler):激活显存下降约 40%~50%,常能把本地微批翻倍;GradScaler 防止 FP16 下小梯度下溢成 0。 - 堵住 autograd 泄漏:
total_loss += loss会把整张反向图钉在显存里,改成loss.item();评估时永远model.eval()+torch.no_grad()。 - 照顾主机侧与散热:输入把 float64/int64 降到 float32/int32;
pin_memory=True;num_workers取 2–4;笔记本垫高一寸就能明显缓解 CPU/GPU 共享散热管带来的降频。
至于"多大模型能跑",一份 2026 年的实用口径是:量化后的 7–8B 约需 5–6 GB 空闲内存,13B 约 8–9 GB,32B 约 20 GB;16 GB 统一内存的笔记本可以舒服地跑 7–8B(Llama 3.2 8B、Mistral 7B、Qwen 2.5 7B 这一类),而编码等专门任务上,小的专用模型经常打赢更大的通用模型。别忘了那条最容易被忘掉的提醒:本地模型同样会幻觉——把它当起草助手,不是神谕,事实性内容一律核验。
五、本地优先的真实代价
三份材料都没有把"本地方案"说成免费或全胜,值得照实转述:
- 读得差的地方就是差。电费单作者的原话:前沿托管模型读模糊手机照"大概率更好",而这是"留在本地的真实代价";日本那份的竖版版式只有 40% 整张正确,且更多同类数据也救不了。
- 速度可能慢一个量级。Qwen3-VL 比 Gemma 慢约 8 倍,还有 JSON 被 token 上限裁断的风险。
- 幻觉不会因为本地而消失。它只是"没有离开这台机器"——5.3% 的零样本整张正确率就是提醒。
- 一次买断 vs 每页账单:会计那种每周 100 份、持续多年的量,硬件是一次性的;但低频、超高难度的场景,云反而更划算。这不是价值观问题,是算术问题。
- 可替换性要设计进去:模型名放进配置、评测脚本对同一批样本跑分,才能在新模型出现时"改一行、重跑评测"。
六、清单:准备在本地读单据时
- [ ] 先画数据流:文件从哪来、在哪解码、网络调用白名单(例如只允许
localhost:11434);关掉框架的遥测(StreamlitgatherUsageStats = false),把服务只绑 localhost; - [ ] 把"模型只转写、代码负责算"写成规格的第一条;
- [ ] 每个字段配独立校验,失败时给人话理由;把流水线崩溃的文档变成带标记的行;
- [ ] 关键动作(报价 / 付款 / 入账)之前设人工复核门,复核屏是产品,不是补丁;
- [ ] 建评测集与指标:字段级、整张级、以及"关键字段错但被通过"——前两个会骗你,第三个才是钱;
- [ ] "看不清"写成合法输出;不要让模型替你补值;
- [ ] 阻断可覆盖,但必须书面理由 + 留痕 + 输入变化即失效;
- [ ] 用注入问题测试你的检查(坏校验位、别家号码、错税额……);
- [ ] 把模型做成一行配置,用同一评测脚本做升级决策;
- [ ] 承认本地读得差的版式(模糊照片、竖排文字),给它们一条明确的人工分支。
一眼结论:这三份实测给出的不是"小模型打败了大模型"的故事,而是"会拒绝、可校验、能留痕的管道"打败了"看起来更聪明的单次回答"。如果你的单据里有客户的税号、地址、账户余额,先把机器留在自己这边,再让模型抄字——最后让代码把每一行都问一遍。
相关阅读
- 本地跑小模型:LFM2.5 与 24B MoE 的设备端思路
- GGUF 与量化:llama.cpp 怎么把大模型塞进消费级显卡
- Agent 成本体检:92,413 token 的启动账与上下文预算
- 专题:本地 & 自托管 LLM 完全指南
- 专题:RAG / 数据 / 文档智能完全指南
本系列另两篇(三站相关系列 · 本地优先)
- 图纸不上传:DWG 版本自查与照片元数据清理(同一件事落到 CAD:在浏览器里读 DWG 文件头确定版本、本地审阅流程、以及共享工地照片前把 GPS/EXIF 无损清掉)
- 不看仪表盘:自己从 RPC 和 MCP 读链上数据(落到链上:用 curl 读策略快照、用普通 JSON-RPC 把一笔回购逐 wei 重算、以及为什么你自己的数据库只是缓存)
来源
- @mathfe, A local AI that types up a Brazilian accountant's receipts (and knows when it's wrong)(dev.to,2026-10-16;Hacktoberfest 参赛作品,代码 MIT 开源,样本为 10 份虚构文档;场景、95% 字段正确率、2.2s/4.0s 数字与三条经验均出自原文):https://dev.to/mathfe/a-local-ai-that-types-up-a-brazilian-accountants-receipts-and-knows-when-its-wrong-5gbi
- @raihan-js, Invoice-Check JP: A 3B Model Reads the Invoice, Checks Decide Whether to Trust It(dev.to,2026-10-15;全部为合成发票,单模型、单次训练、单一种子,基座为 Qwen 研究许可(非商用);数据集 / 适配器在 Hugging Face,registry 数据加工自日本国税厅公开站点):https://dev.to/raihan-js/invoice-check-jp-a-3b-model-reads-the-invoice-checks-decide-whether-to-trust-it-39mf
- @minchinweb, Only two lines on an Alberta power bill matter. A local model finds them.(dev.to,2026-10-15;Hacktoberfest 参赛作品;所有账单为合成,7 张照片样本量小,作者明确承认前沿托管模型在模糊照片上大概率更好):https://dev.to/minchinweb/only-two-lines-on-an-alberta-power-bill-matter-a-local-model-finds-them-47ap
- @theclairvoyantbeing, Making PyTorch & Local ML Work on Modest Hardware: Lessons from a 4GB/8GB Laptop GPU(dev.to,2026-10-15;通用 PyTorch 工程技巧,无产品推广):https://dev.to/theclairvoyantbeing/making-pytorch-local-ml-work-on-modest-hardware-lessons-from-a-4gb8gb-laptop-gpu-5hn6
- @thomaspoli, Running LLMs Locally on a Budget: A Practical 2026 Guide(dev.to,2026-10-15;指南文,文内链有第三方教程,显存口径可按公开模型卡核对):https://dev.to/thomaspoli/running-llms-locally-on-a-budget-a-practical-2026-guide-4h2i
本文由 汇智网 · Software 2.0 编译整理,转载请注明出处。
这是「本地 & 自托管 LLM」专题的一部分。完整地图见:本地 & 自托管 LLM 完全指南