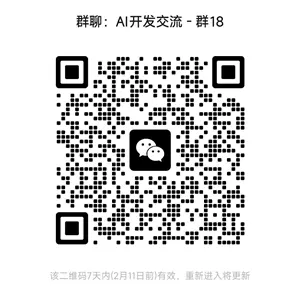
Google AX:Agent 控制面
大多数基础设施团队已经知道如何运行服务和批处理作业。自主 agent 则不同。
博途PLC工程智能体 | AI智能体博途网关 | 梯形图转SCL | 自然语言生成梯形图 | 自然语言生成SCL | 逆向生成程序块文档 | 梯形图在线查看 | 博途编程文档MCP | AI模型价格对比 | AI工具导航 | ONNX模型库 | Vibe Coding教程 | PLC在线仿真器 | Tripo 3D | Meshy AI
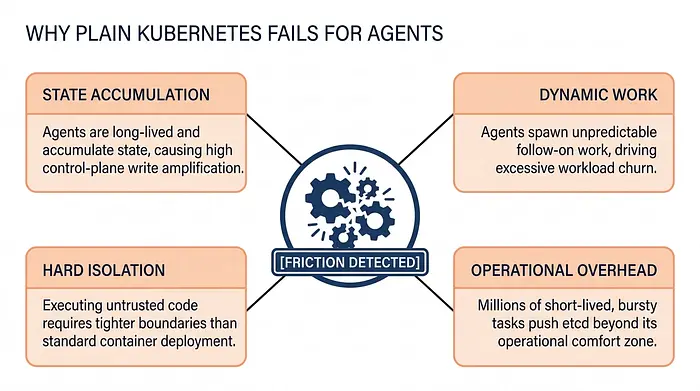
大多数基础设施团队已经知道如何运行服务和批处理作业。自主 agent 则不同。它们的生命周期足够长,能够积累状态;足够动态,能够派生后续工作;足够危险,需要硬隔离;足够昂贵,以至于你希望对网络、模型和运行时行为进行严格控制。如果你试图把它们直接塞进普通的 Kubernetes 原语中,很快就会遇到摩擦:容器里塞了太多的引导逻辑,太多策略被临时编码,一旦工作负载数量增长,运维开销就变得过大。
Google 的 ax 就是为了解决这一差距。
AX 是一个用于大规模 agent 工作负载的声明式编排器。对于任何使用过 Kubernetes 的人来说,它看起来是刻意熟悉的,但它替换了一些底层假设,以更好地匹配 agent 系统:以任务为中心的沙箱、可复用的工作区、显式的出口控制、挂起/恢复语义,以及一个为超高任务吞吐量设计的控制平面。
本文是面向软件开发者和 DevOps 工程师的实用导览。
1、AX 是什么
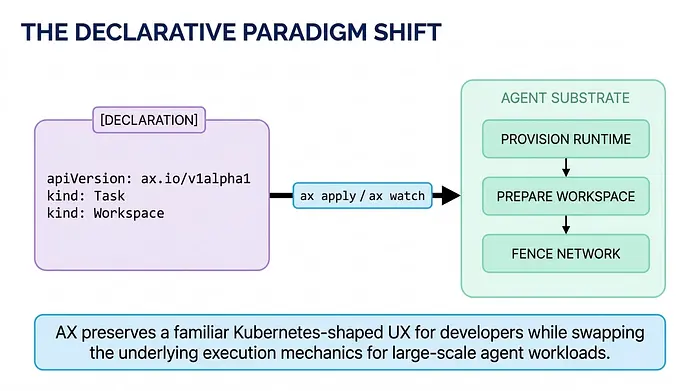
从高层来看,AX 是一个控制平面,用于在 Agent Substrate 之上,在隔离的沙箱中运行 agent 任务。
来自项目 README:
- 你用 YAML 清单描述工作负载。
- 你用一个类似
kubectl的 CLI 来应用它们。 - 平台配置运行时、准备工作区、围栏网络,并驱动任务达到其期望状态。
一个最小示例如下:
apiVersion: ax.io/v1alpha1
kind: Workspace
metadata:
  name: golang
spec:
  git:
    - repo: https://github.com/golang/go.git
      branch: "my-fix"
---
apiVersion: ax.io/v1alpha1
kind: Task
metadata:
  name: test
spec:
  workspaces:
    - name: golang
      goal: "Ensure that Go tool chain is available and is built from source"
  debug: true
然后你这样与它交互:
ax apply -f task.yaml
ax watch task test
ax ssh test -- ls -al /workspace
这已经说明了很多设计意图:
- 部署单元不是"一个服务",而是一个
Task。 - 运行时环境被单独声明为
Workspace。 - 检查和实时调试是一等能力。
- 系统期望 agent 环境需要准备,而不仅仅是启动一个容器。
2、AX 解决的核心问题
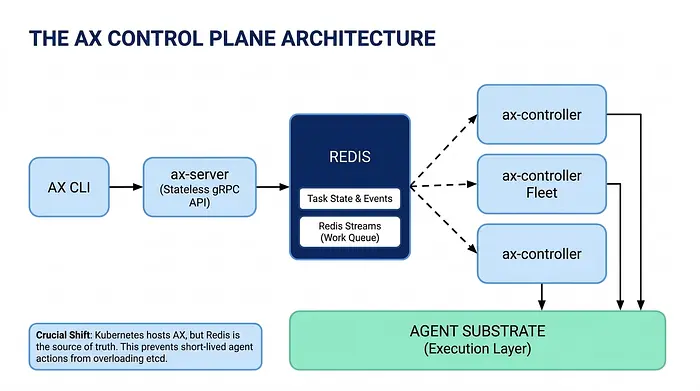
AX 明确避免在大规模场景下将任务状态存储为 Kubernetes CRD。原因是运维层面:数百万个短生命周期的任务会把 etcd 和 Kubernetes 控制平面推到舒适区之外。相反,AX 将状态保存在 Redis 中,并使用 Redis Streams 作为 API 层与横向扩展的控制器集群之间的工作队列。
AX 不只是"一些 CRD 和一个控制器"。它是一个 Kubernetes 相邻的控制平面,借用了声明式的用户体验,但为了吞吐量和任务周转率而改变了内部实现。
设计文档中的架构是:
axCLIax-server作为无状态 gRPC API- Redis 用于任务状态、事件和流
ax-controllerworker 从 Redis Streams 消费- Agent Substrate 作为执行层
换句话说:
- Kubernetes 是 AX 自身的托管环境。
- Redis 是 AX 资源状态的真相来源。
- Agent Substrate 是隔离任务沙箱的运行时基底。
对于平台工程师来说,这可能是系统最有趣的部分。AX 保留了 Kubernetes 控制平面的人体工学,但它并不强制 Kubernetes 本身成为每个短生命周期 agent 操作的持久化和调度模型。
3、四大主要原语
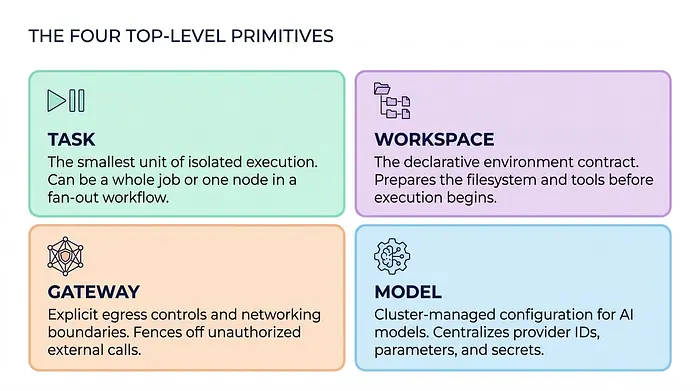
AX 围绕四种顶级资源类型构建:
TaskWorkspaceGatewayModel
这些是需要理解的主要概念。
3.1 Task:隔离执行的单元
Task 是 AX 中最小的执行单元。
它声明的内容包括:
- 容器镜像
- 命令
- 环境变量
- 计算请求和限制
- 工作区绑定
- 网关引用
- 调试能力
从概念上讲,当你想在具有明确定义的生命周期和资源边界的沙箱中运行不受信任或半受信任的 agent 代码时,Task 就是你使用的原语。
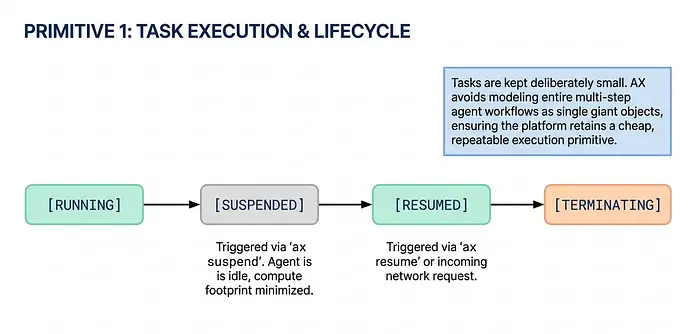
仓库中的概念文档提出了一个重要观点:AX 刻意保持这个单元很小。它不会试图将整个多步 agent 工作流建模为一个巨大的对象。相反,一个任务可以是:
- 整个工作
- 更大任务树的根节点
- 扇出/扇入工作流中的一个节点
这在运维上是合理的。它为平台提供了一个廉价、可重复的执行原语,可以一致地创建、挂起、恢复和销毁。
一个代表性的清单:
apiVersion: ax.io/v1alpha1
kind: Task
metadata:
  name: task123
spec:
  image: "ghcr.io/my-org/my-agent-image"
  command: ["python", "agent.py"]
  env:
    - name: ENVIRONMENT
      value: "production"
  resources:
    requests:
      cpu: "500m"
      memory: "1Gi"
    limits:
      cpu: "2"
      memory: "4Gi"
  workspaces:
    - name: default-workspace
      path: "/workspace"
      goal: "Install dependencies and run the test suite"
  gateway:
    name: default-gateway
  debug: true
任务生命周期
AX 为每个任务提供阶段(phase)和条件(conditions)。
高级别的 status.phase 是一个紧凑的摘要,例如:
RunningSuspendedFailedTerminating
条件携带更细致的细节。文档中强调的重要条件包括:
WorkspaceReadyGatewayReadyReady
对于运维人员来说,这是一个好的模式。它既提供了粗粒度的仪表盘视图,也提供了更细致的就绪/调试界面。
两个生命周期操作很突出:
ax suspendax resume
这在主流应用平台中不常见,但与 agent 高度相关。一个空闲或等待中的 agent 可以被暂停、检查点保存,之后再恢复,而无需将整个工作负载视为一次性的临时计算。
3.2 Workspace:声明式环境准备
如果 Task 是执行单元,Workspace 就是环境契约。
这是 AX 更有用的想法之一。
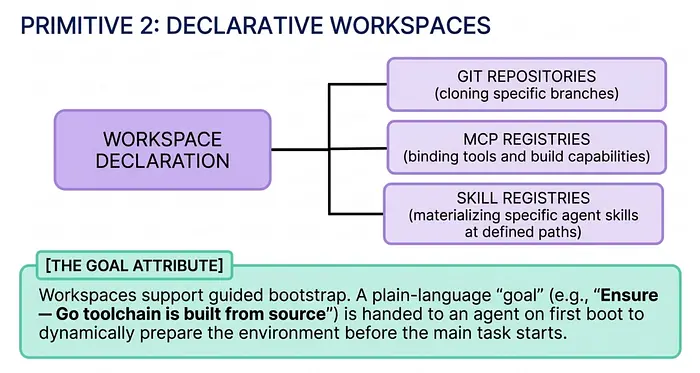
Workspace 声明任务启动时应具备的文件系统和工具上下文。根据文档,它可以包括:
- Git 仓库
- MCP 服务器和注册表
- 技能注册表和技能物化路径
一个任务可以绑定一个或多个工作区,每个工作区在各自的路径上物化。第一个工作区成为任务命令的工作目录。
示例:
apiVersion: ax.io/v1alpha1
kind: Workspace
metadata:
  name: default-workspace
spec:
  git:
    - name: origin
      repo: "https://github.com/chalk/chalk.git"
      branch: "main"
  mcp:
    registries:
      - provider: google
        query: "mcp.tags:build"
    servers:
      - name: git-tools
        endpoint: "http://git-mcp.default.svc.cluster.local:8080"
  skills:
    registries:
      - provider: google
        query: "skills.tags:nodejs"
    path: "/.agents/skills"
为什么这很重要:
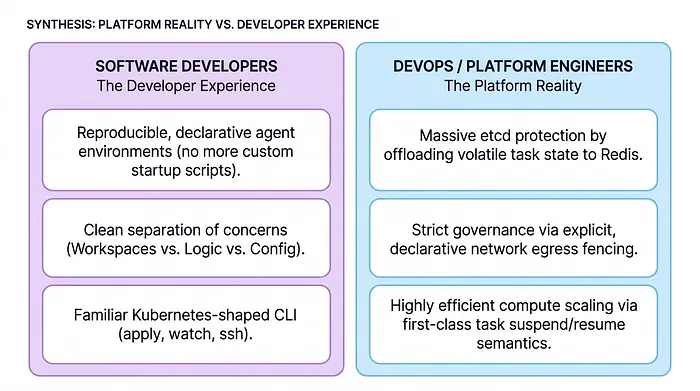
- 开发者不再需要将每个设置步骤都塞进自定义启动脚本。
- 平台团队可以标准化工具访问和仓库水合。
- 可复用的环境定义可以在许多任务之间共享。
AX 还支持工作区绑定上的 goal。这一点特别有趣。goal 是对任务所需环境的自然语言描述,在首次启动时,运行器可以将该 goal 交给一个 agent 来完成环境设置。
例如:
- 安装工具链
- 获取依赖
- 让仓库可构建
- 准备测试基础设施
这意味着 AX 不限于静态环境描述。它支持 agent 就绪工作区的引导式引导。
这是一个强大的模式,但也是平台团队会希望为可复现性和安全性仔细治理的功能。
3.3 Gateway:显式的网络边界
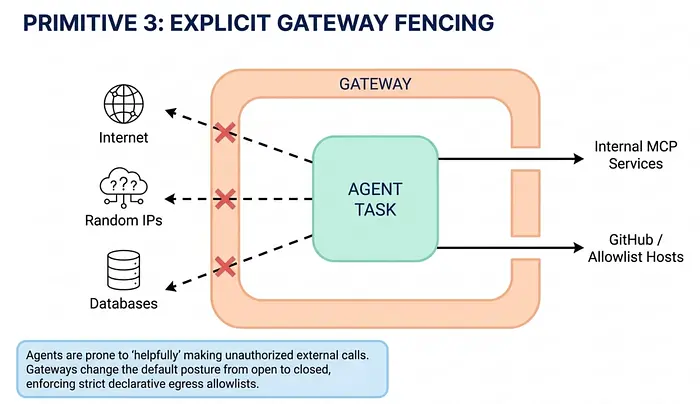
Gateway 是 AX 的网络和出口控制原语。
你不是让每个任务自由地与网络通信,而是声明:
- 任务暴露的监听器
- 沙箱可以到达的主机和端口的出口允许列表
示例:
apiVersion: ax.io/v1alpha1
kind: Gateway
metadata:
  name: default-gateway
spec:
  listeners:
    - name: grpc
      port: 8494
      protocol: gRPC
    - name: http
      port: 8080
      protocol: HTTP
  egress:
    allowlist:
      hosts:
        - host: "*"
          port: 443
文档明确指出,443 端口上的 * 对于入门很方便,但预期的生产姿态要严格得多。
对于 DevOps 和安全团队来说,这是 AX 价值主张的核心部分。Agent 尤其容易"好心地"发起外部调用。一等的出口允许列表让你能够以声明式方式约束这种行为。
在实践中,你可以说:
- 这个任务可以与模型提供者通信
- 这个任务可以与 GitHub 通信
- 这个任务可以与内部 MCP 服务通信
- 这个任务不能与其他任何东西通信
对于自主执行代码的工作负载来说,这是正确的默认值。
3.4 Model:集群管理的模型配置
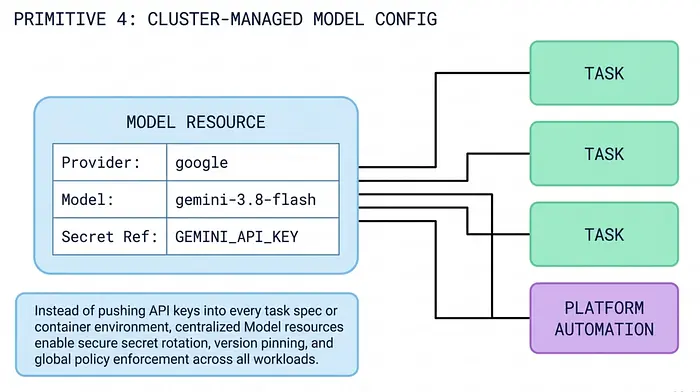
Model 这个名字在最好的意义上稍微有点名不副实。它不是一个模型工件;它是一个命名的模型配置资源。
它定义:
- 提供者
- 模型标识符
- 提供者特定的参数
- 凭据的密钥引用
示例:
apiVersion: ax.io/v1alpha1
kind: Model
metadata:
  name: default-model
spec:
  provider: google
  model: gemini-3.8-flash
  secretKey:
    name: gemini-api-secret
    key: GEMINI_API_KEY
  parameters:
    temperature: 0.9
这对运维来说是一个聪明的抽象。
你不需要将 API 密钥和模型名称推送到每个任务清单或容器环境中,AX 让你可以集中管理它们。这改进了:
- 密钥轮换
- 版本固定
- 策略执行
- 跨工作负载的一致性
文档还指出,AX 本身可以读取这些模型资源,例如在根据目标规划工作区时。因此模型配置不仅适用于你的 agent 代码;它也是平台自身自动化界面的一部分。
4、AX 的运行时模型:任务内部实际发生了什么
仓库中更具体的部分之一是运行器契约。
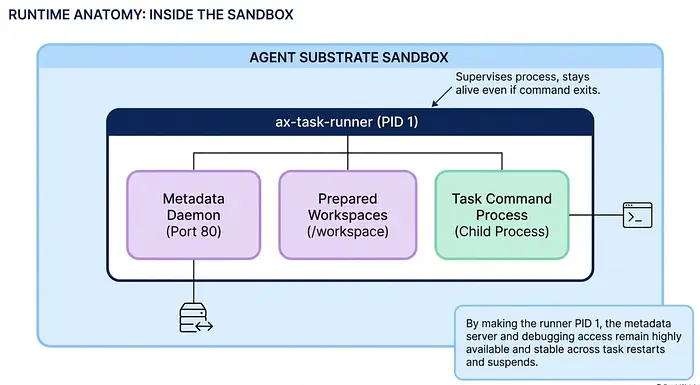
每个任务容器都以 ax-task-runner 作为 PID 1 启动。该运行器负责将声明式规范转化为一个活跃的环境。
启动时它会:
- 加载
Task和绑定的Workspace规范 - 在端口 80 上启动一个元数据和客户机管理守护进程
- 准备每个工作区
- 将任务命令作为子进程启动
- 监督该进程,即使命令退出后也保持存活
这是一个微妙但重要的设计选择。
在许多容器平台中,你的应用进程就是 PID 1,容器生命周期直接映射到进程生命周期。AX 解耦了这些关注点:
- 运行器保持为控制面
- 元数据服务器保持可用
- 调试访问可以保持可用
- 工作区生命周期在任务命令重启和挂起期间保持稳定
对于开发者来说,这提供了一个更可内省的环境。对于运维人员来说,它为平台提供了一个稳定的管理端点。
4.1 元数据与内省
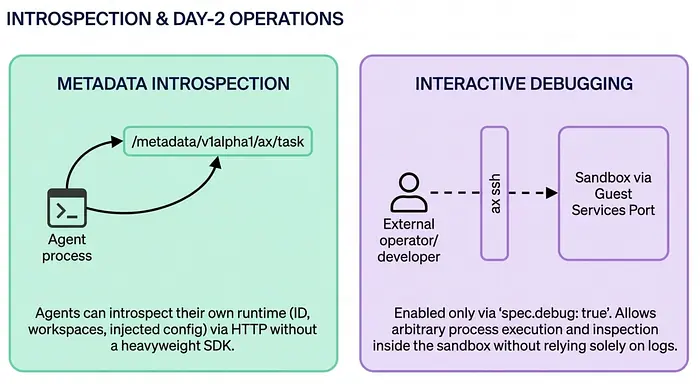
在沙箱内部,运行器暴露 HTTP 端点,例如:
/healthz/readyz/metadata/v1alpha1/ax/task/metadata/v1alpha1/ax/workspaces
任务命令在其环境中获得 AX_METADATA_URL。
这是一个干净的模式。这意味着 agent 代码可以在不需要重量级 SDK 的情况下内省自己的运行时。一个进程可以询问:
- 我是什么任务?
- 我有哪些工作区?
- 我完全就绪了吗?
- 注入了什么配置?
这对自定义 agent 和通用工具都有用。
4.2 调试与客户机服务
如果启用了 spec.debug: true,运行器还会暴露驱动 ax ssh 的客户机服务。
这对第二日运维很重要。当你只有日志时,agent 很难调试。AX 将交互式检查声明为一种声明式能力,而不是事后添加的功能。
调试模式是可选加入的,这也是正确的默认值,因为客户机服务允许在沙箱内执行任意进程和文件访问。
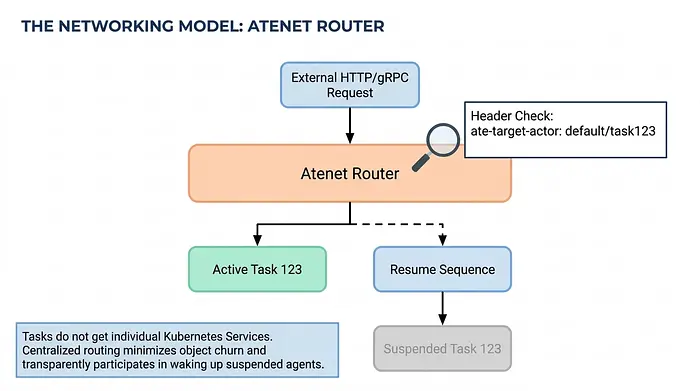
4.3 网络模型:没有每个任务的 Kubernetes Service
AX 的网络模型也值得一提。
任务不会各自获得自己的 Kubernetes Service 或 Ingress。相反,请求通过 Agent Substrate 的 atenet router 路由,使用 ate-target-actor 头来标识目标任务。
例如:
curl -H "ate-target-actor: default/task123" \
  http://atenet-router.ate-system.svc.cluster.local/metadata/v1alpha1/ax/task
对于运维人员来说,这有几个好处:
- 每个任务的 Kubernetes 对象更少
- 运行中或挂起的任务具有一致的访问路径
- 路由可以在代理流量之前恢复任务
最后一点特别有趣。AX 围绕这样的理念构建:一个任务可以被挂起,之后被透明地恢复,以至于路由基础设施也参与唤醒它。
5、为什么这个架构很重要
AX 最独特的部分不是 YAML。很多平台都有 YAML。
有趣的是其背后的架构:
- 无状态 API 服务器
- Redis 支撑的状态
- Redis Streams 作为调和队列
- 横向扩展的控制器
- Agent Substrate 作为执行后端
这告诉我们,AX 为规模和周转率而优化,而不仅仅是在小集群规模下保证正确性。
从平台角度来看,AX 似乎围绕以下几个假设设计:
- agent 任务可能数量众多
- 许多将是短生命周期或突发性的
- 控制平面的写入放大会产生影响
- 运行时隔离是不可协商的
- 工作区引导是一等生命周期阶段
- 挂起/恢复在运维上有价值
这与典型 Web 服务编排的假设集不同。
6、开发者体验
对于开发者来说,AX 刻意让人感到熟悉。
CLI 支持这样的动词:
applygetdescribewatchdelete
然后添加了 agent 特有的操作:
sshsuspendresume
这种"Kubernetes 形状的用户体验"是一个好的决策。它降低了学习曲线,同时在工作负载模型真正不同的地方引入了新的原语。
多文档清单工作流也很务实。你可以在一个文件中定义 Task、Workspace、Gateway 和 Model,然后一起应用它们。
7、软件开发者应该关心什么
如果你构建 agent 驱动的系统,AX 为你提供了几个有意义的关注点分离:
Task用于执行Workspace用于准备好的上下文Gateway用于网络策略Model用于模型配置
这减少了直接嵌入到应用代码和容器镜像中的环境逻辑量。
对开发者来说最大的收获可能是 agent 环境的可复现性。AX 不是让每个团队发明自己的启动 shell 脚本,而是给你一个声明式、可复用的设置层。
DevOps 和平台工程师应该关心什么
如果你运行共享基础设施,AX 之所以有趣,原因不同:
- 它避免了大量 CRD 对 etcd 的压力
- 它将任务状态集中在 Redis 中
- 它暴露了显式的出口控制
- 它支持挂起/恢复
- 它将调试视为一种受治理的能力
- 它将平台管理的模型凭据与应用代码清晰地分离
简而言之,AX 看起来不像是"AI 的 Kubernetes"营销,而更像是一个真正的 agent 工作负载控制平面设计。
8、AX 在哪些地方有主见
从仓库来看,AX 在几个特定方面有主见:
- 它假设 Agent Substrate 是沙箱后端。
- 它假设运行器契约是执行模型的核心。
- 它将工作区视为可复用的设置原语,而不仅仅是卷。
- 它强烈倾向于声明式配置,而不是临时的容器启动逻辑。
- 它将网络出口视为需要显式围栏的东西。
对于企业级 agent 基础设施来说,这些是合理的观点。
9、结束语
AX 最好被理解为 agent 执行的控制平面,而不仅仅是一个任务运行器。
其核心洞察是,agent 需要的不仅仅是"一个带有提示词的容器"。它们需要:
- 隔离
- 温热的、声明式的工作区
- 受控的网络访问
- 集中的模型配置
- 可观测性和交互式调试
- 挂起和恢复等生命周期操作
- 能够承受超高任务数量的架构
对于软件开发者来说,AX 提供了一种更干净的方式来打包和运行 agent 工作负载。
对于 DevOps 和平台团队来说,它提供了一个比试图将数十亿 agent 任务强行塞进原生 Kubernetes API 更现实的运维模型。
如果 Kubernetes 教会了行业为服务声明期望状态,那么 AX 正在探索自主 agent 的期望状态应该是什么样子。
原文链接: Google’s AX: A Kubernetes-Shaped Control Plane for Agent Workloads
汇智网翻译整理,转载请标明出处