Cloudflare 如何构建软件工厂?
过去几个月,我们在 Astro 仓库上运行了一条自动化分诊流水线。它读取收到的 bug 报告,在沙箱中复现,诊断根因,并为报告者发布预览版本供其验证。
博途PLC工程智能体 | AI智能体博途网关 | 博途PLC程序知识图谱 | 梯形图转SCL | 自然语言生成梯形图 | 自然语言生成SCL | 逆向生成程序块文档 | 梯形图在线查看 | 博途编程文档MCP | AI模型价格对比 | AI工具导航 | ONNX模型库 | Vibe Coding教程 | PLC在线仿真器 | Tripo 3D | Meshy AI
每个人都在谈论软件工厂:把 AI 智能体组装成一条流水线,让它自主产出可运行的软件——就像工厂把原材料变成成品。关于这是否真的可行、自动化的边界到底在哪、以及人们演示的那些"循环"是否有意义,争论无穷无尽。有些人已经断言这是一场失败。
与此同时,还有另一场更安静、更令人忧虑的对话:开源维护者正在 burnout。AI 浪潮让生成 issue、PR 和安全报告的成本几乎为零,但维护者逐条阅读的成本却高得惊人。过去维持项目健康运转的老办法,正在数量面前崩塌。
两个话题人人都有高见。我们认为自己能拿出更稀缺的东西:真实结果。过去几个月,我们在 Astro 仓库上运行了一条自动化分诊流水线。它读取收到的 bug 报告,在沙箱中复现,诊断根因,并为报告者发布预览版本供其验证。底下的引擎已经发展为 Flue——一个构建此类智能体自动化的开放框架,也正是你可以用来构建自己那套的工具。
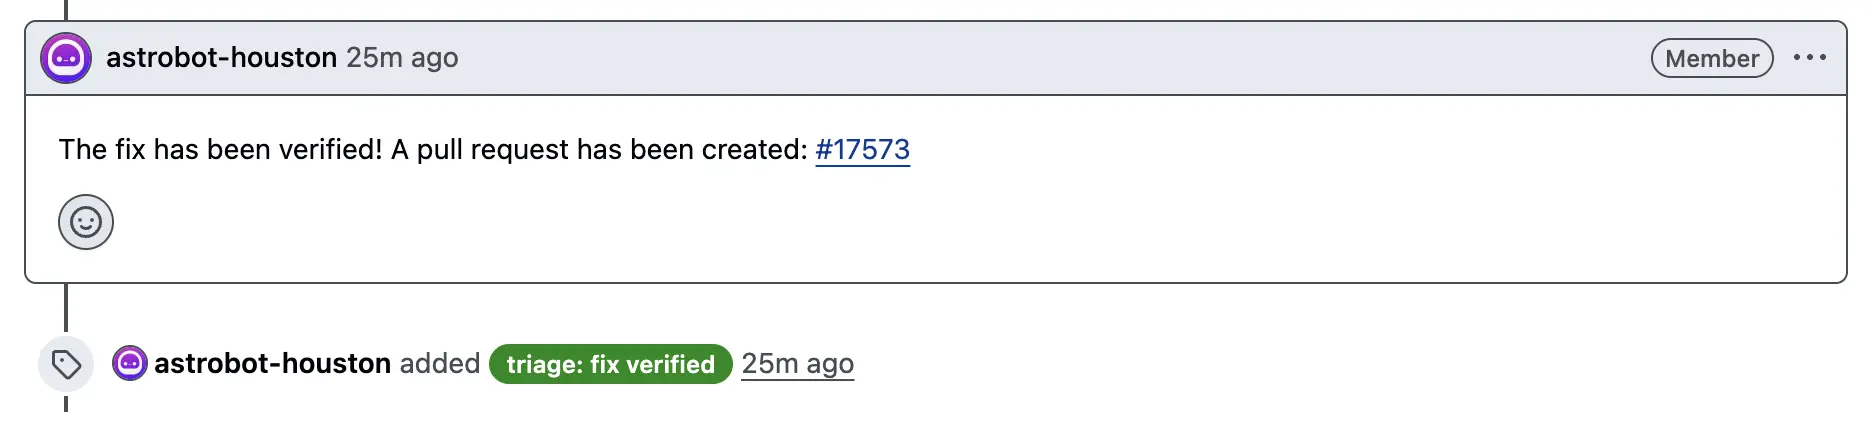
这不是一蹴而就的。但经过大量迭代,我们把开放 issue 从 200 多个降到了 30 个左右,预计下个月就能清零。这将是这个仓库 5 年多历史中第一次实现零开放 issue。
我们不是靠宣布"issue 破产"、自动关闭冷工单或无视报告做到的。我们靠的是用一支在 GitHub Actions 里运行的隔离 AI 子智能体团队,把 issue 分诊流程自动化。以下是我们的故事,以及你可以带回自己项目的经验。
1、从一个智能体技能开始
年初,我们聚焦于自动化开发中一个具体环节:issue 分诊。作为一个开源项目,手动分诊可能是工作中最耗时、回报最低的部分之一。单个 issue 有时光复现就要花几个小时,更别提修复了。这是我们开启自动化之旅一个自然(却常被忽视)的起点。
我们从开发一个智能体技能开始。这让我们作为维护者可以在本地开发和测试自动化——在自己的机器上运行编码 Harness。然后我们可以在仓库的 GitHub Action 里运行同一个 Harness,完整复用同一套分诊工作流技能。
分诊技能精确镜像了我们手动解决 issue 时的步骤:
- 复现(Reproduce):克隆提供的复现仓库,验证所报告的问题。
- 诊断(Diagnose):对代码库插桩并加入日志,定位 bug 根因。
- 验证(Verify):审查相关测试套件、代码注释和文档,判断这个行为究竟是 bug 还是预期功能。
- 修复(Fix):把复现转化为失败的单元测试,通过架构指南确定合适的解决方案,然后部署修复。
为了防止 LLM 常见的倾向——在 bug 可能并不存在时强行给出解决方案——每个阶段都由一个隔离的子智能体执行。这些子智能体将它们的发现汇编进一个 report.md 文件,顺序传递信息。
2、把技能变成自动化
在内部初步测试分诊技能之后,我们的重心转向构建一条全自动化流水线。我们特别希望把这个逻辑直接集成进 GitHub 工作流,确保完全透明,让任何人都能轻松审计智能体的顺序推理和操作步骤。
在接线的过程中,我们意识到整条流水线其实只是一个由 issue 标签驱动的状态机。每个新提交以 triage needed 标签开始,一旦用户确认修复就移至 fix verified。除了这些标签转换,流水线不持有任何自身状态;它只是回读 issue 已有的评论,弄清楚某个 issue 处于什么位置、下一步应该发生什么。
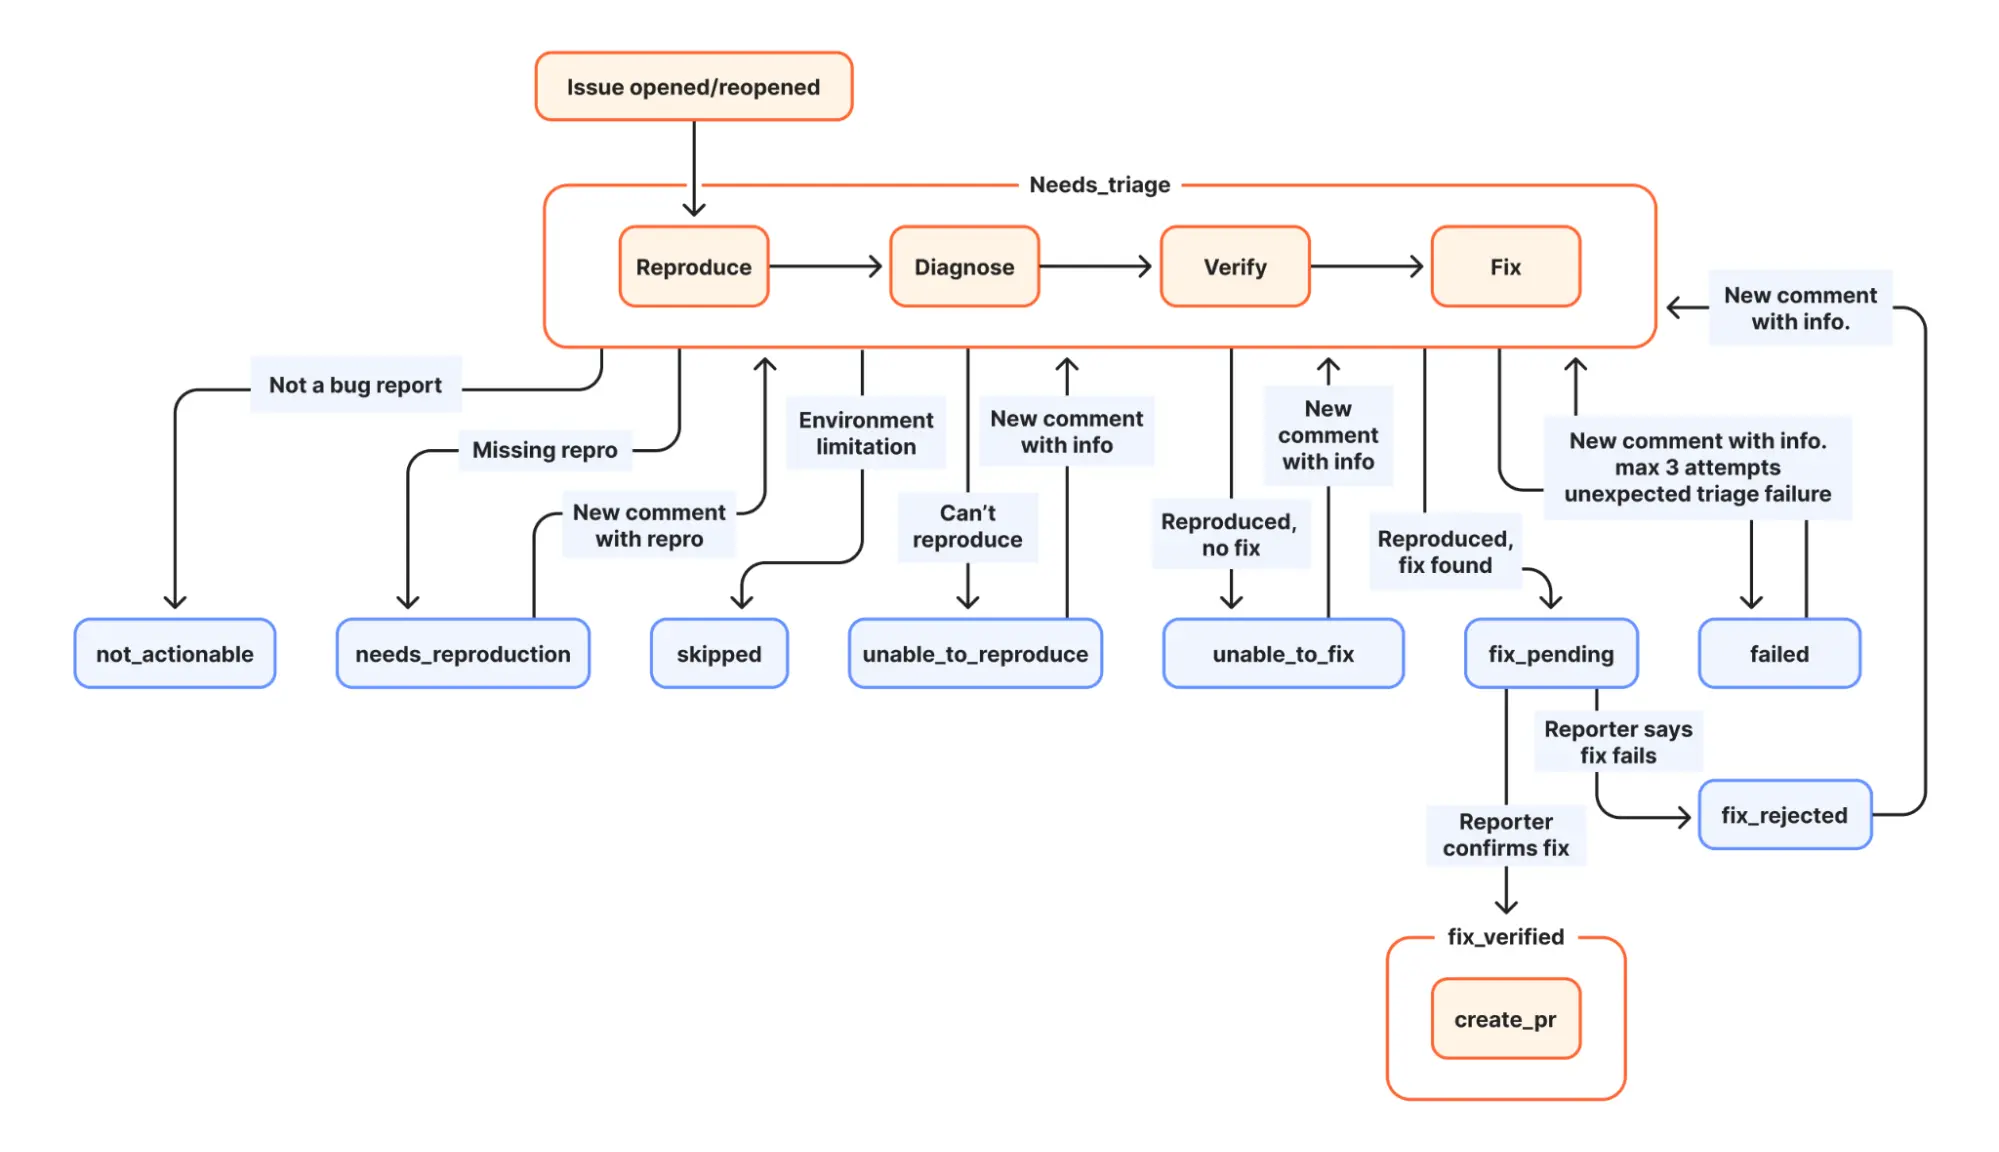
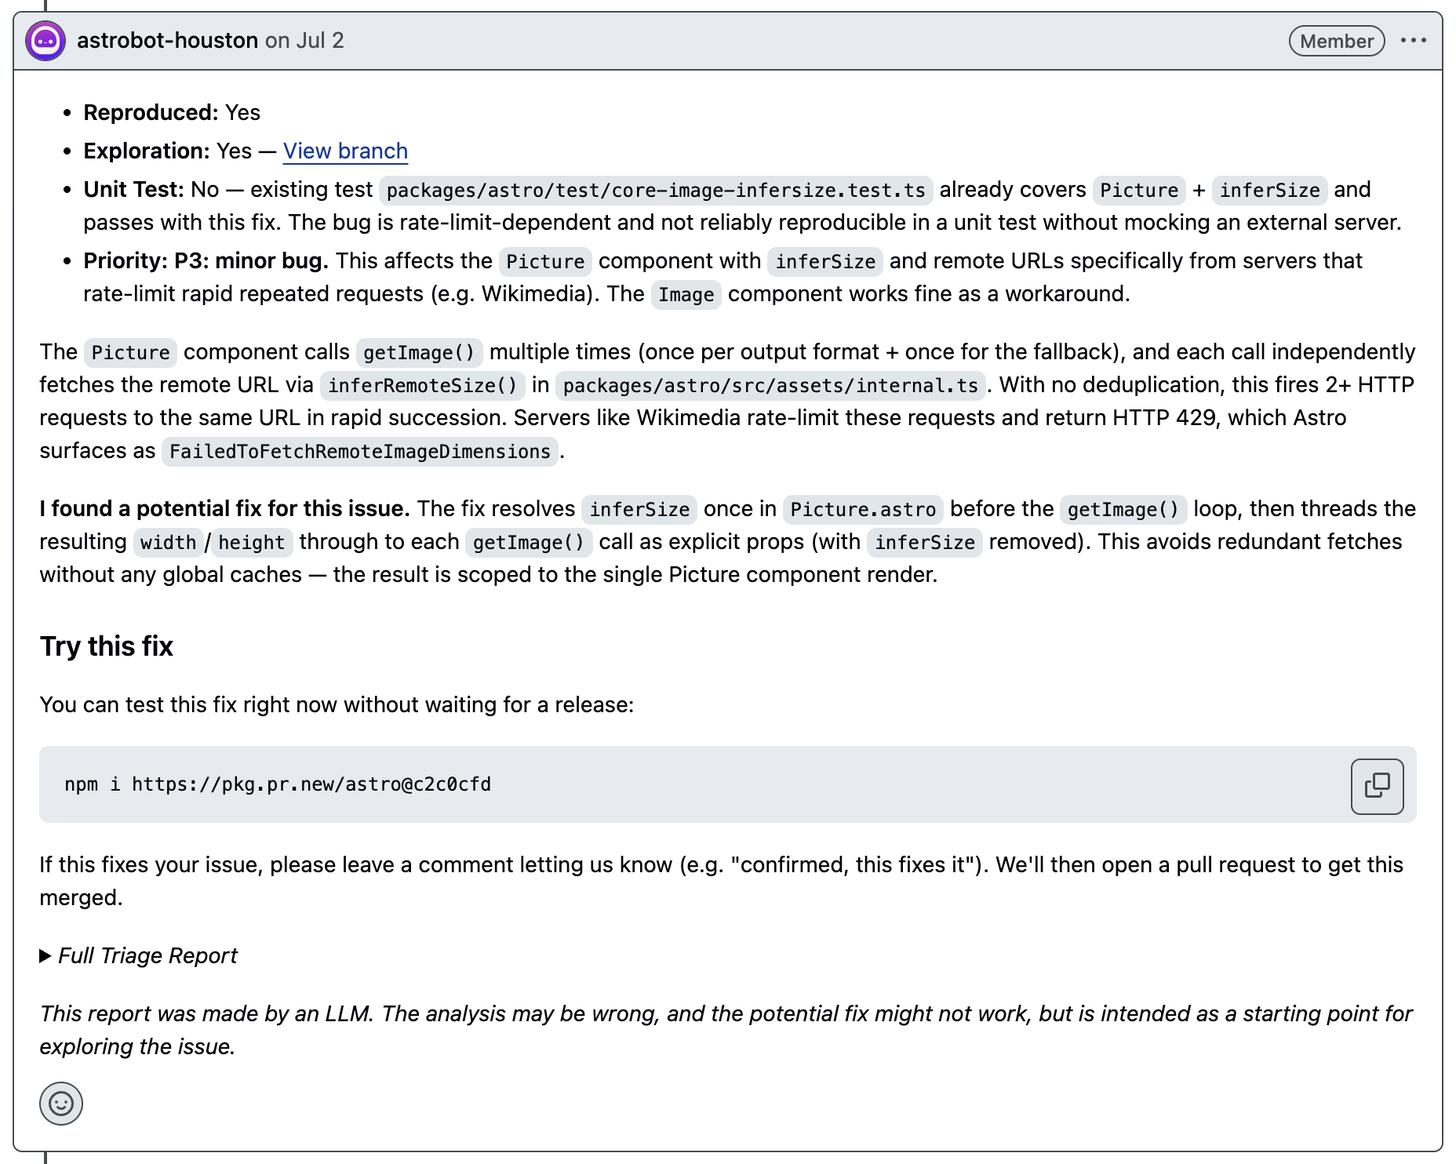
从那里,流程自行运转。当智能体找到修复方案时,流水线用 pkg.pr.new 启动一个预览发布,并把所有东西发回 issue:发现的摘要、完整日志以及安装预览的说明。原始报告者可以在自己的项目上试用这个补丁,如果确认有效,自动化就打开一个关联到该 issue 的 PR。
3、从分诊到框架
随着构建推进,我们不断注意到:其中没有任何东西真正绑定 GitHub。响应事件、运行一连串隔离的子智能体、把它们的推理与它们被允许执行的动作分开——这一切只是一个工作流。它从 Slack 消息、定时任务或 webhook 启动,与从 GitHub issue 启动一样顺畅。把这个认识泛化为一个无论部署在哪里、驱动哪个模型都以同样方式工作的运行时,就是 Flue:一个开放的、平台无关的构建持久智能体和工作流的框架。
4、智能体自动化的好处
当我们首次推出这套自动化系统时,大家对它的效果以及可能给开发者社区带来的负面影响都有顾虑。有一个合理的担忧:依赖自动化的机器人回复可能显得冷漠,在我们维护者和用户之间再制造一层隔阂。
并没有发生。如果有什么变化的话,我们现在和用户交流得更多了,只是在更有用的地方:
- 在 Discord 里直接与社区成员互动。
- 积极参与 RFC 讨论并回应新功能请求。
- 与贡献者密切合作,帮助把他们的想法整合进框架。
关于自动化补丁的质量,我们的核心理念是:AI 智能体应该成功解决绝大多数收到的 issue。当智能体没能找到正确方案时,我们把这次失败解读为代码库中潜在架构或文档问题的信号,指向以下三个方向之一:
- 不透明的抽象:如果智能体无法解读组件之间的边界,人类开发者多半也会在同样的代码结构上挣扎。
- 缺失的文档:关键代码段缺乏解释其实现逻辑的明确注释。
- 不足的测试:仓库缺乏全面的测试覆盖,尤其是单元测试。
一个清晰的例子出现在一系列相关的热模块替换(HMR)bug 上。分诊机器人反复尝试修改一个特定的 if 条件来解决问题。虽然这个改动修复了目标 bug,但由于该条件缺乏测试覆盖,它在其他地方引入了回归。一旦我们加上了一条解释该语句确切逻辑的说明性注释,机器人就适应了,不再在那个区域尝试错误的修改。
每当我们追查出这类失败并补上缺失的注释、测试或更清晰的边界时,机器人在这部分代码库上就明显变好了,下一个接手的人类也一样。
5、把工作流变成 GitHub Action
起初,我们的分诊逻辑直接住在 Astro monorepo 里。这种耦合让迭代变得困难;升级 Flue 或修改工作流,感觉像是在没有安全网的情况下对在线基础设施做手术。为了解决这个问题,我们把逻辑解耦成一个独立的、可测试的仓库:triagebot-action。这种隔离让我们得以引入自动化测试,在碰主代码库之前先确保稳定性。
今天,这个 Action 驱动着 Astro 的 issue 管理,并从那里传播开来。好几个其他团队已经捡起了它——有的直接使用,有的 fork 它来构建贴合自己项目的自动化"工厂"。第二种路径才是真正的要点:triagebot-action 还年轻且仍在积极演进,所以我们分享它与其说是作为成品,不如说是作为一个你可以阅读、学习并改造的工作参考。
Action 本身的接线长这样:
      - uses: withastro/triagebot-action@v1
        with:
          read-token: ${{ secrets.GITHUB_TOKEN }}
          write-token: ${{ secrets.BOT_GITHUB_TOKEN }}
          cloudflare-api-key: ${{ secrets.CLOUDFLARE_API_KEY }}
          cloudflare-account-id: ${{ secrets.CLOUDFLARE_ACCOUNT_ID }}
          triage-model: cloudflare-workers-ai/@cf/moonshotai/kimi-k2.7-code
          verification-model: cloudflare-workers-ai/@cf/moonshotai/kimi-k2.6
          triage-skill: .agents/skills/triage
或者把你自己的智能体指向这个仓库,让它通读配置流程,包括添加状态机依赖的标签。
无论你走哪条路,底层理念都比我们具体的实现更重要:一个可持续的反馈循环,把维护者从管理积压中解放出来,让他们专注于框架本身。代码是开放的。Fork 它、精简它,或者只是借用适合你项目的部分。
原文链接: How we built a software factory to drive Astro's GitHub issue count to zero
汇智网翻译整理,转载请标明出处