AI视频生成为何变得如此强大
在这篇文章中,我想与你分享使视觉质量和时间一致性实现如此惊人进步的主要技术进展。
梯形图转SCL | 需求文本转SCL | 梯形图在线查看 | 博途编程文档MCP | AI模型价格对比 | AI工具导航 | ONNX模型库 | Vibe Coding教程 | PLC在线仿真器 | Tripo 3D | Meshy AI | ElevenLabs | KlingAI | ArtSpace
我记得几年前第一次尝试Deforum的时候。
当时,Deforum是创建AI动画的首选开源工具。它依赖Stable Diffusion模型逐帧生成AI视频。
当时的想法是使用Deforum配合Stable Diffusion 1.5、Anime LoRA和ControlNet来改变输入视频的风格,从电影奇幻风格转换为动漫风格,同时保持帧间一致性。结果可以说是相当令人失望。
除了生成的帧存在很多问题(例如奇怪的微细节、融化的背景细节、对提示词理解不佳、畸形细节等)之外,那个AI视频时代的主要挑战是时间不一致性。例如,你可能见过那段时期超级火爆的跳舞希腊雕像视频。
尽管这在当时被认为是使用可用AI工具取得的惊人成果,但闪烁是一个明显可见的问题。视频闪烁基本上发生在生成模型逐帧重新决定细节、纹理或光照时,破坏了时间一致性。
快进三年,我们现在有了MiniMax H3、Kling 3.0、Sora 2、Wan 2.2等模型。这些模型不仅能够生成清晰美观的帧,还能保持高度的时间一致性。
在这篇文章中,我想与你分享使视觉质量和时间一致性实现如此惊人进步的主要技术进展。
1、当每一帧都是单独任务时
视频生成的故事并非始于Deforum或Stable Diffusion模型,引言中提到的大多数挑战从一开始就存在。自生成AI早期以来就有很多尝试,例如VGAN使用GAN内的3D卷积生成视频,MoCoGAN尝试明确分离"内容"和"运动",以便独立控制两者。 当"注意力"机制出现时,我们看到了VideoGPT将视频视为离散token序列供Transformer预测,借鉴了文本处理中已经成功的机制。
这些早期尝试都没有成为主流,因为取得的结果最多只能说是"有前途"。
然而,在2022年成为主流的是Stable Diffusion,随后不久是Deforum,它提出了一种将图像模型改造为视频生成的方法。
2、Deforum(配合ControlNet)是如何工作的?
首先,我们获取原始源帧,从中提取结构图(通常是深度图或边缘图,输入ControlNet使输出大致保持原始构图)。然后我们使用前一帧的输出作为SD 1.5 img2img处理的起点。输出结果成为下一帧的"前一帧输出",循环重复。
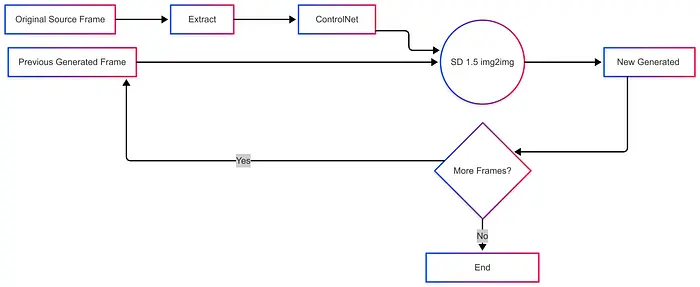
正如我之前提到的,我的配置是:SD1.5、动漫LoRA用于风格、ControlNet深度图用于结构。这在理论上看起来很合理,但实践中并没有达到预期。主要原因是循环中的每一步都是在独立推理步骤之间传递图像数据,而不是模型内部的持久连接。SD 1.5根本不知道前一帧的存在,甚至不知道它正在处理视频帧。它只是接收一个初始图像并像任何其他img2img任务一样去噪。它对自己一帧之前生成的内容没有任何记忆。我们唯一的时间连续性来自于将前一帧的生成结果反馈作为下一帧的初始图像,而不是来自模型本身。
此外,ControlNet映射是为每一帧独立重新提取的,这可能导致帧与帧之间出现轻微的不连贯。如果我们增加前一帧的影响以保持一致性,就有可能削弱风格化效果。但如果我们减少这种影响以让动漫风格显现出来,就有可能让细节和纹理在每一帧都重新生成。
一致性是我在用像素做交易,每一次都是弱交易。
3、教会图像模型关于运动的知识
下一代尝试在不抛弃扩散模型的情况下解决这些问题。相反,它在扩散模型基础上进行了扩展。例如,AnimateDiff和Video LDM方法保持了一个冻结的预训练2D图像UNet,并在其现有空间层之间插入了一个新的时间注意力层。
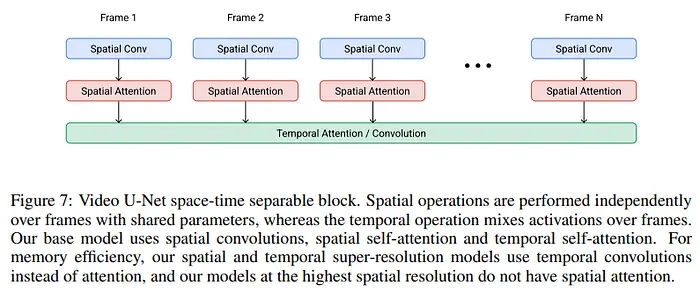
空间层仍然独立处理每一帧(时间轴只是被折叠到批次中),但新模块跨越帧轴进行观察,由于它在大量视频集合上训练,它学习了真实的运动模式,而不是依赖像素混合技巧。
这带来了真正的改进。训练模型学习帧之间的相关性。
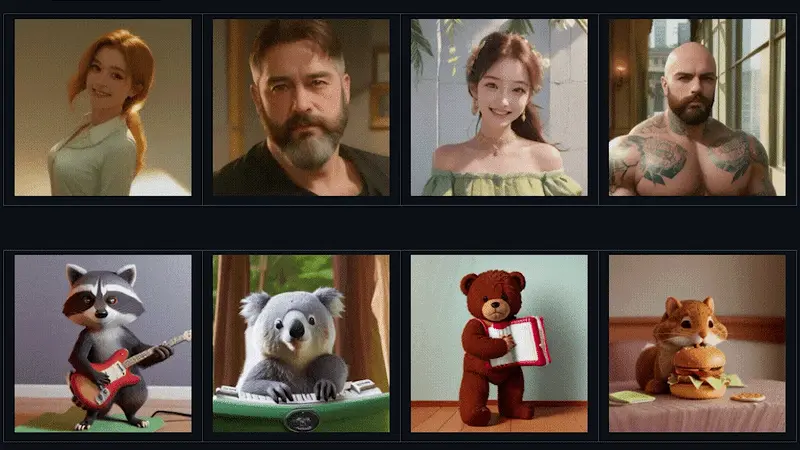
现在模型已经学会了时间一致性,但时间推理仍然是基于图像模型的附加功能,这为其性能创造了上限。
为了更好地理解这一点,想象模型生成一个人在走路。
空间UNet非常擅长回答:
这个单独的帧应该是什么样子?
时间模块帮助回答:
这个帧应该如何与相邻帧关联?
但底层的图像生成模型仍然从根本上优化于生成合理的图像。时间模块必须在其基础上强加连贯的运动。这在很多情况下可以很好地工作,但当我们需要以下内容时,任务变得更加困难:
- 复杂的长期运动
- 物体被遮挡后重新出现
- 持续多秒的运动
另一条研究路线试图在不训练专用视频模型的情况下解决视频重样式问题。Rerender-A-Video使用光流和跨帧约束在帧之间传播信息,而TokenFlow采用了不同的方法,根据帧之间的对应关系传播扩散特征。两者都利用源视频的信息来防止每一帧被孤立地生成,而不需要额外的训练或微调。
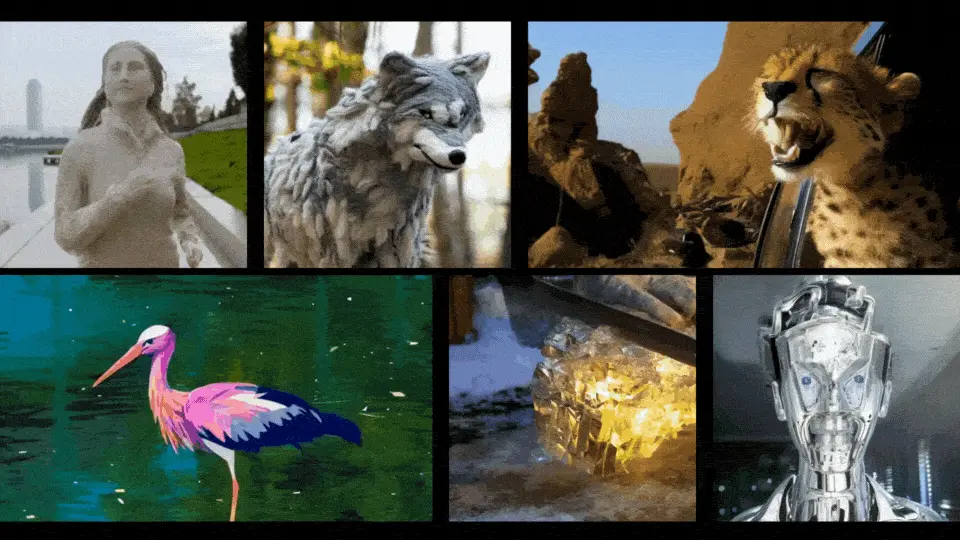
这使得视频重样式比简单地在每一帧上独立运行图像扩散模型具有更好的时间一致性。但这些方法仍然依赖于建立帧之间的可靠对应关系。遮挡、快速运动、新显露区域或模糊匹配仍然可能破坏这些对应关系并引入伪影。
4、一致视频生成的现代方式
主要转折点是从将视频视为图像序列转变为将其建模为时空对象。这种转变随着Sora的发布在质量上产生了重大飞跃,Sora将视频表示为统一的时空潜在表示,并整体去噪,而不是独立生成每一帧。
这一新类别的模型遵循类似的流程。
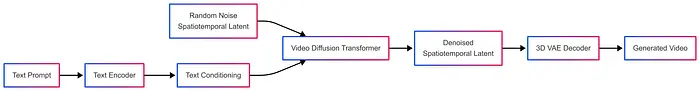

在这些较新的架构中,因果3D VAE跨空间和时间压缩和解压缩视频,产生时空潜在表示。这使得时间信息可以直接保存在潜在表示中,而不是仅在像素级别处理。
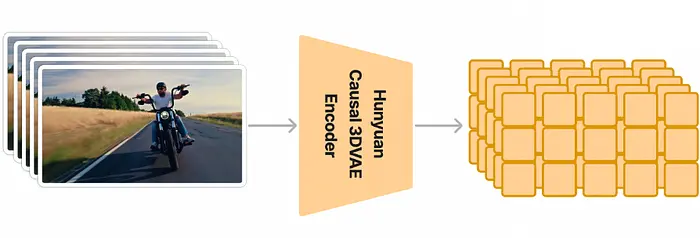
该潜在表示被切分成"时空块",每个块跨越一小块空间和时间,相当于视觉Transformer将图像切分成块的视频版本。
这些token输入扩散Transformer(DiT),在整个序列上运行完整的自注意力,这意味着每个token可以关注剪辑中任何位置的任何其他token,而不仅仅是几帧之外的相同空间位置。
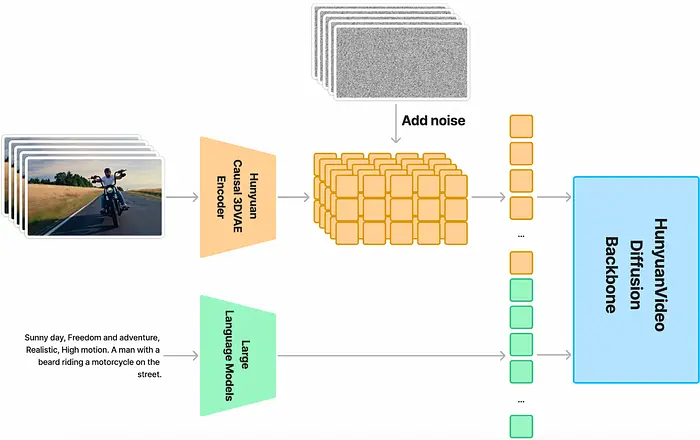
使用扩散骨干网络的真正影响是允许模型在第40帧对角色的手进行去噪,同时在同一注意力操作中直接关注第5帧和第90帧中的对应手部。
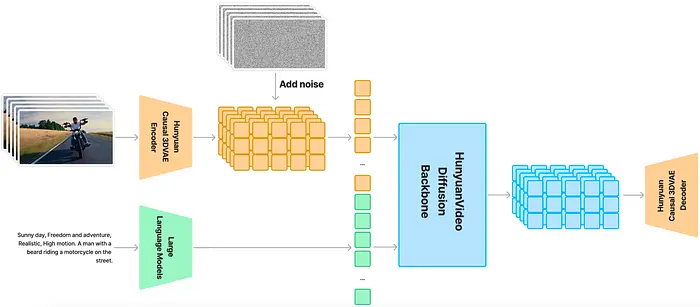
最后,我们解码扩散骨干网络的输出,得到一个时间一致性不是事后约束的视频。
为了更深入地理解这种AI视频生成的新范式,让我们看看阿里巴巴云的流行模型系列Wan-Video。
5、案例研究:Wan 2.1和2.2
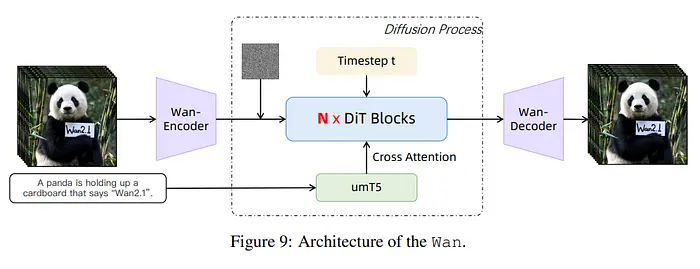
如果你想了解这些新一代模型的工作原理,Wan模型系列是最好的选择。阿里巴巴发布了完整权重和技术报告。
Wan 2.1的架构如下所示。
5.1 VAE
这个架构中第一个有趣的组件是Wan编码器/解码器,它是一个时空变分自编码器。
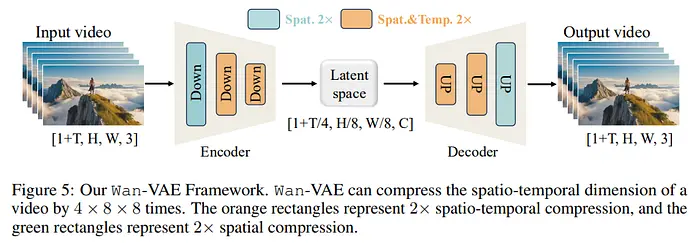
Wan-VAE是一个相对较小的因果3D VAE,拥有约1.27亿参数。像任何VAE一样,它的任务是将输入压缩到低维潜在表示中。它通过沿时间维度压缩视频4倍、空间压缩64倍(高度和宽度各减少8倍)来实现这一点。
Wan-VAE被描述为因果性的,这意味着时空表示中的每个潜在切片仅依赖于当前帧和之前的帧,永远不依赖于未来的帧。这使得模型可以缓存最近的特征,并流式编码/解码任意长的视频,而无需从头重新处理所有内容。为了确保这一点,他们在VAE内部将GroupNorm替换为RMSNorm,因为GroupNorm的跨批次统计会破坏因果属性。
5.2 Transformer
在Wan-VAE编码步骤之后,我们进入扩散Transformer组件。它主要由三个部分组成:
- 一个分块模块。
- Transformer块。
- 一个反分块模块。
首先,潜在表示使用(1,2,2)维度的核进行分块,形成token序列。这些token通过Transformer块,执行时空自注意力以及与文本嵌入的交叉注意力。
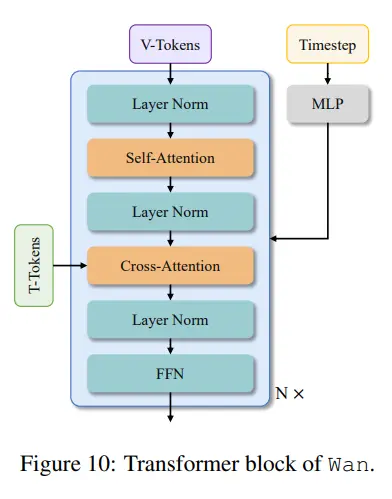
关于文本编码的一个值得一提的细节是文本嵌入模型的选择。Wan使用umT5进行文本编码,它是一个T5模型,这意味着它是双向的,不同于现在每个人都默认使用的因果解码器仅LLM。这个区别在这里很重要,因为文本编码器不是在生成文本。它的任务是理解整个提示词并产生丰富的表示,供扩散模型用于条件化。
然后模型通过流匹配进行训练。它不是像经典扩散模型那样学习预测和去除添加到视频中的噪声,而是学习如何通过预测每一步移动的方向和速度,将噪声表示移向原始视频。
5.3 Wan 2.2中的MoE
Wan 2.2将去噪轨迹本身分割到两个专家之间,而不是按内容路由:
- 高噪声专家处理早期步骤,模型决定整体布局和粗略运动。
- 低噪声专家接管后期步骤,细化纹理和细节。
信噪比阈值决定何时交接。每个专家约140亿参数,总计约270亿,但每一步只有一个处于活动状态,因此推理成本接近密集的140亿模型,而总容量大致翻倍。
6、使用VACE正确重样式视频
现在现代视频生成模型如Wan,主要用于文本到视频或图像到视频任务。但由于我最初的兴趣是视频重样式,所以介绍当前如何实现这一点是合适的。尽管方法可能因模型而异,但总体概念保持不变。
继续以Wan模型系列为例。阿里巴巴团队在2025年推出了VACE,代表Video tasks within an All-in-one framework for Creation and Editing(用于创作和编辑的一体化框架中的视频任务)。它建立在Wan之上,是一个支持视频重样式、修复、姿势或深度引导编辑以及基于参考的风格迁移等任务的框架。
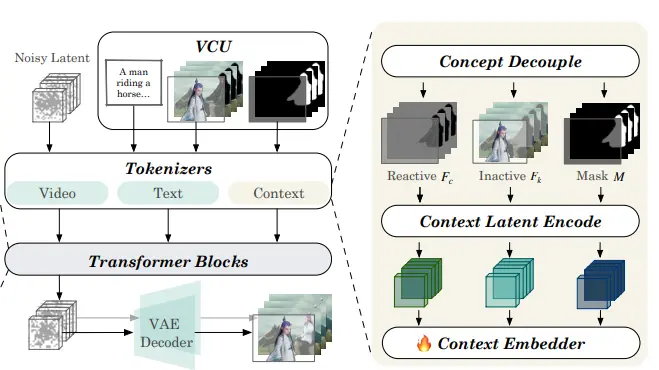
VACE将输入文本、源视频和掩码捆绑到视频条件单元中。
在到达VAE之前,在分词过程中,"概念解耦"步骤使用掩码将源视频分割成两个独立的序列:
- 响应帧:包含应该重新生成的区域。
- 非响应帧:包含应该保留的区域。
两者都由Wan-VAE编码到与噪声生成token相同的潜在空间中。
换句话说,模型根据掩码知道哪些区域应该重新生成,哪些应该保留,而不是依赖去噪强度滑块并希望达到正确的平衡。如果你还记得的话,这是Deforum面临的最大挑战之一。
从那里,VACE支持两种训练方式:
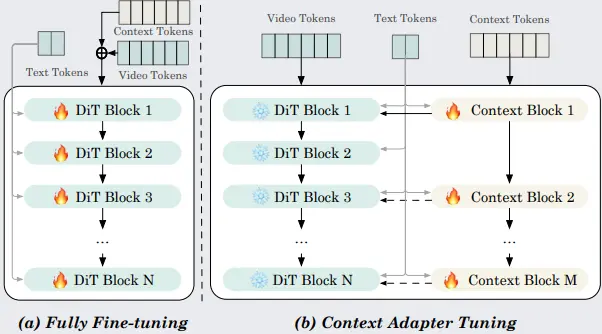
- 全量微调:上下文token直接与噪声token连接,整个模型重新训练。
- 上下文适配器调优:一个更轻量的选项,其中并行的上下文块堆栈处理条件,并将其输出重新集成到原本冻结的基础DiT中。
上下文适配器调优遵循类似于图像ControlNet的模式,但将其适配到视频原生Transformer。
7、结束语
在短短3年内,这一领域取得了巨大进展。尽管本文只介绍了一种架构,但还有许多其他架构已经取得了类似甚至更好的结果。如今,Seedance 2.0、MiniMax H3和Luma's Ray3.2等模型正在展示令人印象深刻的SOTA结果,它们解决的远不止时间一致性。它们可以:
- 跨镜头保持角色身份,
- 遵循复杂指令,
- 保留参考图像和视频的结构,
- 处理多个主体和交互
- 在更长的序列中产生越来越连贯的运动。
从让连续帧看起来不像是独立生成的问题,已经演变为教会模型理解和控制整个视觉场景随时间展开的过程。
原文链接:How Did AI Became So Good At Video Generation
汇智网翻译整理,转载请标明出处