如何选择 Git Diff 算法?
git 2.28.0 总共支持 4 种 diff 算法,即 myers、minimal、patience 和 histogram。在以下各节中,我将分享我对何时应使用每种算法的看法。
博途PLC工程智能体 | AI智能体博途网关 | 博途PLC程序知识图谱 | 梯形图转SCL | 自然语言生成梯形图 | 自然语言生成SCL | 逆向生成程序块文档 | 梯形图在线查看 | 博途编程文档MCP | AI模型价格对比 | AI工具导航 | ONNX模型库 | Vibe Coding教程 | PLC在线仿真器 | Tripo 3D | Meshy AI
git diff 是一个 Git 命令,用于显示工作树和索引或树之间的更改、索引和树之间的更改、两个树之间的更改、合并产生的更改、两个 blob 对象之间的更改,或磁盘上两个文件之间的更改。
截至撰写本文时,git 的最新版本是 2.28.0,它总共支持 4 种 diff 算法,即 myers、minimal、patience 和 histogram。在以下各节中,我将分享我对何时应使用每种算法的看法。本文不涵盖算法工作原理和/或其复杂性的详细分解——您可以通过快速搜索找到这些内容。
在深入细节之前,需要注意的是,效果可能因 1) 比较的文件类型、2) 文件内的更改,以及可能 3) 您使用的 git 包/版本而异。大量更改中的一种可能会影响 diff 算法的有效性。我建议将本文作为入门指南,以确定哪种算法最适合您的需求。
1、‐‐diff-algorithm={myers|default}
默认的贪心算法最初由 Eugene W. Myers 于 1986 年开发,当指定 myers、default 或未指定显式算法时使用。它在大多数情况下运行良好,提供可读性好的 diff,具有合理的大小和运行时间。
何时使用 myers:
- 适用于大多数文件类型和更改
- 如果您不确定使用哪种 diff 算法
2、‐‐diff-algorithm=minimal
myers 算法使用启发式方法来确保执行时间和输入大小之间的合理权衡。但是,在某些情况下,人们可能更倾向于拥有最小的 diff 大小而不是执行时间。在 Linux diff 工具中,可以传递一个标志来禁用启发式方法并运行完整的算法迭代集。以下关于 Linux diff 命令的段落很好地总结了这一点:
基本算法在以下文献中描述:"An O(ND) Difference Algorithm and its Variations",Eugene Myers,Algorithmica Vol. 1 No. 2,1986,pp. 251-266;...除非指定了 --minimal 选项,否则此代码使用 Paul Eggert 的 TOO_EXPENSIVE 启发式方法,将成本限制为 O(N**1.5 log N),但代价是为具有许多差异的大输入产生次优输出。 https://wiki.c2.com/?DiffAlgorithm
minimal diff 算法是 Git 环境中的等效算法。
我们可以通过使用足够大的输入大小来比较 myers 与 minimal 之间的 diff 更改。在下面的示例中,我比较了使用每种算法时两组维基百科文章之间的更改数量:
# 准备用于 diff 的数据
$ curl {article-A,article-B,article-C,article-D} > wikipediaSet1
$ curl {article-E,article-F,article-G,article-H} > wikipediaSet2

# 使用 myers 算法进行 diff
$ git diff --diff-algorithm=myers --shortstat wikipediaSet1 wikipediaSet2
 1 file changed, 7990 insertions(+), 4463 deletions(-)

# 使用 minimal 算法进行 diff
$ git diff --diff-algorithm=minimal --shortstat wikipediaSet1 wikipediaSet2
 1 file changed, 7712 insertions(+), 4185 deletions(-)
请注意,可以在小输入大小上使用 minimal diff 算法,尽管输出可能与 myers 相同,因为要迭代的问题空间在启发式范围内。
何时使用 minimal:
- 比较大文件之间的许多更改
- 不介意花费更多时间来生成更小的 diff/更改集
3、‐‐diff-algorithm=patience
patience 算法由 Bram Cohen(BitTorrent 的创建者)发明,关键区别在于它以不同的方式匹配两个文件之间的相似行。James Coglan 文章中的这段话很好地总结了它:
首先要注意的是,patience diff 本身并不是一种 diff 算法。它真正的作用是一种将文档两个版本中的行进行匹配的方法,以便在使用实际的 diff 算法(如 Myers)处理这些片段之前,将它们分解成更小的片段。https://blog.jcoglan.com/2017/09/19/the-patience-diff-algorithm/
为了演示 patience 如何能比 myers 产生更好的 diff,让我们首先看看基于两个伪代码 Java 文件(原始文件请参阅本文附录)由 myers 生成的 diff:
$ git diff --diff-algorithm=myers File1 File2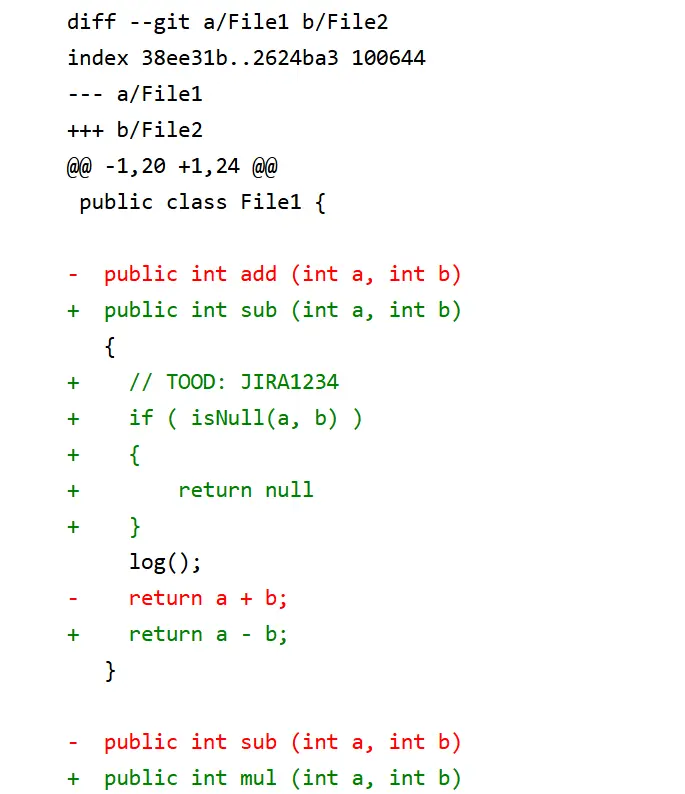
我们可以观察到 myers diff:
- 匹配了两个文件中只有花括号的行(对理解更改没有用)
- 在同一文件中添加和删除了 sub() 方法(实际上只是重新排序了)
这样的 diff 不容易理解,因为几乎每一行都是更改。审查者很容易错过逻辑中的边缘情况和/或错误。
现在让我们看看 patience 生成的 diff:
$ git diff --diff-algorithm=patience File1 File2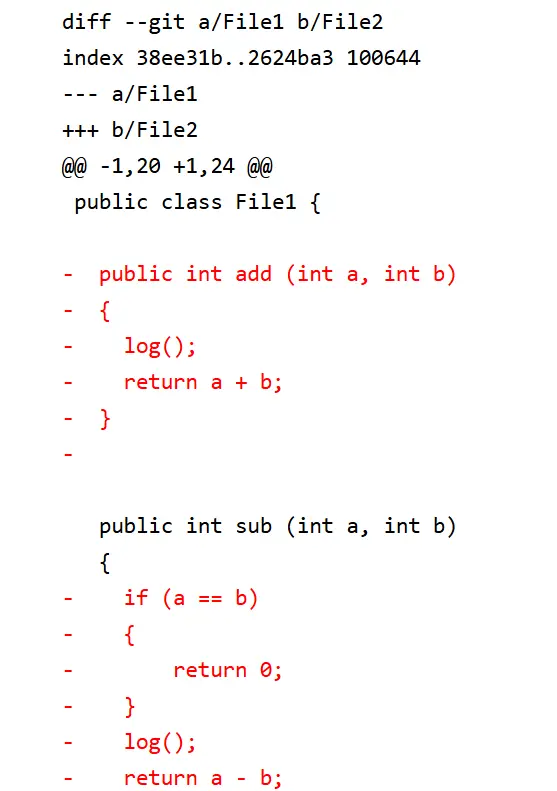
使用 patience 生成的这个 diff,更容易观察到更改:
- add() 方法被删除了
- mul() 方法被添加了
- sub() 方法有一些逻辑更改
何时使用 patience:
- 重新排序代码/内容,且 myers diff 匹配了无关紧要的行
- 相同的行在同一文件中被添加和删除
4、‐‐diff-algorithm=histogram
histogram diff 算法是对 patience 的改进,源自 jgit。这个 stackoverflow 问题很好地解释了它,并链接到 jgit HistogramDiff 类,其中包含详细说明:
通过始终选择出现次数最低的 LCS 位置,只要两个序列之间存在唯一的公共元素,此算法的行为就与 Bram Cohen 的 patience diff 完全相同。当不存在唯一元素时, instead 选择出现次数最低的元素。这比简单地回退到标准 Myers O(ND) 算法产生更可读的 diff。https://github.com/eclipse/jgit/blob/ebfd62433a58d23af221adfdffed56d9274f4268/org.eclipse.jgit/src/org/eclipse/jgit/diff/HistogramDiff.java#L65-L70
为了更好地理解为什么这种方法更好,让我们看看使用 patience diff 算法时的早期更改之一:
$ git diff --diff-algorithm=patience File1 File2 [...]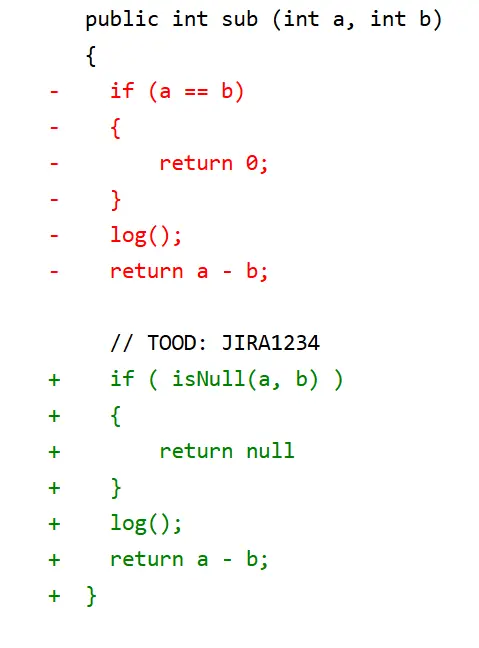
作为 sub() 方法内逻辑更改的一部分,我将 TODO 注释从最后一行移到了第一行。不幸的是,patience 似乎认为注释在两个文件之间保持不变,而原始行被删除了。
然而,这种表示本身并没有错,但它确实表明所有原始逻辑都被丢弃了(包括 log() 和 return 语句),并插入了一组新的内容。
我们可以用 histogram 更好地显示更改:
$ git diff --diff-algorithm=histogram File1 File2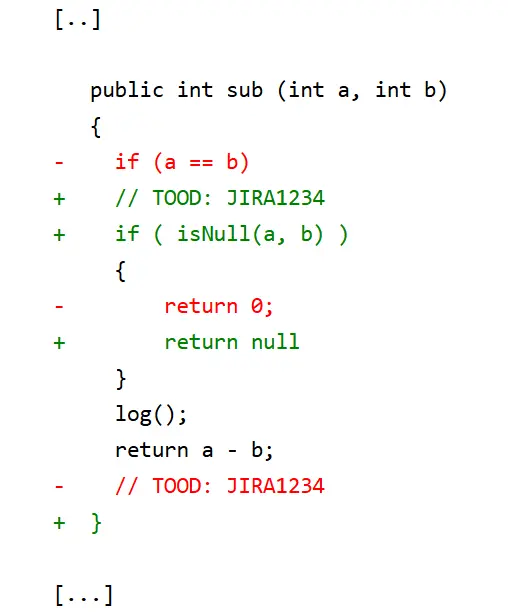
现在我们可以清楚地看到两个更改:1) 注释的重新排序,以及 2) 新的输入清理检查。
何时使用 histogram:
- 比较代码更改,根据 Nugroho 等人(2019 年)进行的相当近期的研究
- 当 patience 似乎难以表示某些更改时
5、结束语
鉴于各种类型文件(例如源代码、YAML、文档)中所有可能更改的集合,git diff 工具的每种 diff 算法都更适合特定的子集。虽然默认的 myers 算法在大多数情况下运行良好,但有时使用另一种方法可以更好地表示某些更改。
我相信会存在一组更改/文件,其中没有提供的 diff 算法能完美运行。在这种情况下,要么接受次优的 diff 输出,要么寻找 git diff 工具之外的解决方案。
原文链接: When to Use Each of the Git Diff Algorithms
汇智网翻译整理,转载请标明出处