Fable 5.2 离 AGI 只差一步:能建 204 个世界,却看不出自己做得不够好
一次提示做出电影、建 204 个世界、写出 182 页论文,还会自己长出 8.7 万词规则手册。差的那一步:它看不出自己做得不够好。
如果 AGI 的定义是「在多数能靠电脑完成的知识性任务上,达到大多数人类专家的水平」,那么 Anthropic 这次的新模型已经站到门口了——但它还差最后一步,而差的那一步不是推理能力。
我在公开发布前用 Claude Fable 5.2 用了一段时间(它接在已经相当出色的 Opus 5.5 之后),印象非常深。AI 已经好到值得问一个问题:Anthropic 的新模型,以及 OpenAI 和 Google 必然很快推出的竞品,是否已经越过 AGI 的边界?
AGI 是个争论很多、定义很多的词。本文采用的定义是:「一个在多数你能用电脑完成的知识性任务上、和大多数人类专家一样好的 AI。」这个定义明确排除了大量人类工作——与物理世界打交道、与他人打交道,以及大多数真实岗位(在那些岗位上,「用电脑」只是众多任务之一)。但即便有这些限定,构建一种有限形式的 AGI 一直是 AI 开发者的目标。
为了不吊你胃口:我的答案是「几乎」是 AGI,或者说我称之为锯齿状 AGI(Jagged AGI)。即便在我这个有限定义里,仍有许多任务的重要环节上,AI 的锯齿足以让它远落后于人类能力。但这种锯齿不再表现为简单的错误或幻觉,所以它更难描述。本文想做的就是把这件事说清楚:展示 Fable 能做什么,以及缺口在哪里。
我先给新模型下了这么一条指令:
我在写 OneUsefulThing 等等。我需要你在发布时做出我能拿去给人看的最惊艳的东西。它要能嵌在一篇文章里,前言随你怎么写。它要给人带来生理层面的冲击,展示你能做什么、能力跨度有多大。它要能迅速抓住人。在这件事上要极其聪明。
Fable 让我先看完它的视频,再开口说话。
这是一次成型,除了那条提示我没有给任何反馈。里面有创意(包括反转结尾)、有判断力、有玩心、也有聪明。我认为这是一个人类专家只靠代码做电影所能达到的水平——那种表现,我以前会归给 AGI。
AGI 里的那个 G
代码和视频生成一直是 AI 发展的重点领域,所以真正的问题是:Fable 5.2 是不是通用智能?为了测这个,我在不同领域给了它一系列高难挑战。
只用一条提示去黑一台硬件。 我桌上有个 Codex Micro——一个带几个发光按键的小 USB 键盘,讽刺的是它为 ChatGPT 而造。我让 Fable 把它变成一台游戏机。据我所知这件事没有任何公开说明,于是它去读控制这个键盘的两个 app 的代码,搞清了怎么设置每个键的颜色、怎么读旋钮和摇杆,然后写了六个游戏,包括 Simon 和一个用旋钮玩的破保险箱游戏。Fable 立刻理解了我想要什么,设计了有趣、可玩、又贴合键盘极有限能力的游戏,并且在完全没有人帮忙的情况下,第一次就把它拼出来了。
创办一家企业。 现在我们从编程这类领域走进更混乱的商业世界。我告诉 Fable:「创办一家企业帮我赚钱,我要一年至少 2 万美元。它每月占用我的时间不超过 20 分钟,其余你全做。」它的回应是筛了 22 个想法,最后提出 Prebid Brief——一项告诉设备销售代表哪些公园和水务项目正在获批资金或正在设计、甚至在进入招标之前就知道的服务。它读了 201 个市和县政府的公开议程,做出了头几期。它还建立了档案:哪些城市已经拥有什么设备、有多旧、当初花了多少钱。你可以看它做出来的东西,包括营销计划和定价建议。Fable 已经开始设定定时任务来推进这门生意,并问能不能开始向地方政府发公开记录请求。到这一步,我让它只做一个 demo,不要真的启动这个想法。
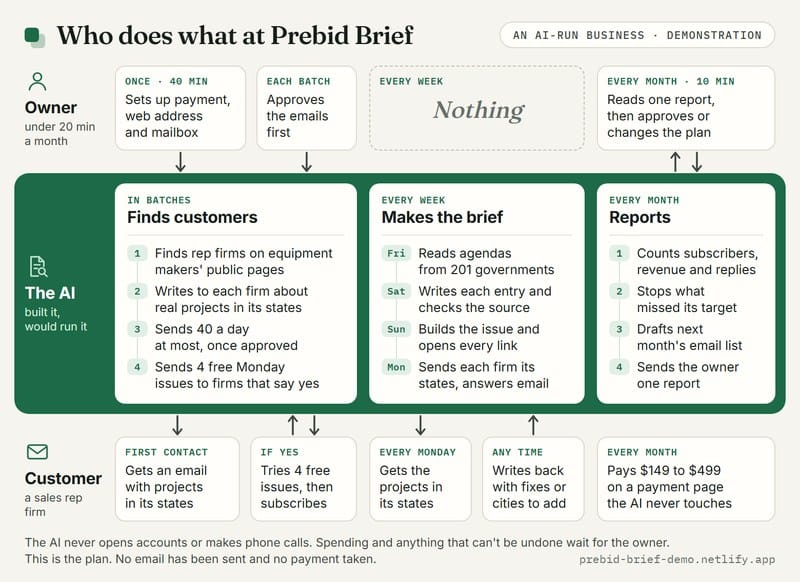
我是创业学教授,所以常年评估商业计划。如果这份东西是我的 MBA 学生期末交上来的,我会印象深刻。它可行、想得清楚、有可能成立,但绝不是稳赚(AI 自己估计成功率 20%–40%)。我在弄清它能不能真的运营这家公司之前就叫停了实验,因为我担心它会收钱却拿不出有质量的东西。它似乎认为很容易搭起来的持续基础设施其实还不存在,而销售与营销所需的众多环节我也不确定它能不能处理好。不过我猜,每周补几个小时人工去填这些洞,我真能认真试着做这门生意。所以,如果 AGI 意味着 AI 能独立持续经营一家企业,我们大概还没到那一步。话又说回来,要是有个人向我承诺「每月只占你 20 分钟,我帮你把生意做起来赚钱」,我在信他之前也会先问几个问题。
重建史上最难的人文课。 1941 年,诗人 W. H. Auden 在密歇根大学开了一门课,其教学大纲后来被互联网称为史上最难之一。他宣布期末考试时,一个学生委员会称它「不可能且不人道」。「欧洲文学中的命运与个体」要求 6,000 页阅读、苛刻的作业,还要背诵长诗和翻译其他诗作。我们对这门课的了解,大多散落在幸存的学生笔记和 Auden 的书信里。我让 Claude 用有趣、有参与感的方式重建它——教你诗,而不是惩罚你。它做出了 Fate and the Individual。站点为 Auden 书目上的 35 部主要作品各做了一页,还包括他写在黑板上的内容、他放的唱片、他布置的作业。它还通读了 Auden 已出版的全部研究,并用他在其他来源里写过的内容为诗作加了注。Claude 完成了研究、设计、写作和代码,让批评 agent 逐字审阅、让事实核查 agent 把论断与来源对照,把开源代码放上 Github(还做了预告片)。
如果你爱文学,这些结果非常有意思;考虑到它把学术、网页设计和文学分析混在一起,我认为这需要几个月的人力才能做出来。我自己做了交叉核对,也用其他先进 AI 检查过,没有发现重大错误。但在品味和判断上仍有锯齿。Fable 的第一版准确却毫无乐趣:一个十五周课程的网站,配上测验。我告诉它做出来的是「一场穿过最无聊网页的残酷苦旅」,让它做得美一些。它第一次尝试做出了一个要按铃的儿童游戏,我不得不再给反馈。当我让它解释一首诗的节奏或用词为什么重要时,它写出了自信的解读,却没有考虑 Auden 自己说过什么。每一次修复只花几分钟,但它一次都没自己发现这些问题。那么,这是品味上的差异,还是我没把要求说清楚,还是 AI 的弱点?有时很难分辨。
做原创学术研究。 我让 Fable 在创业研究里找一个尚未解决的实证问题,找到数据,预注册假设与方法,写出论文,再让其他 agent 去批评它。很快我拿到了《The One-Dollar Company》,你可以在这里读。分析估计:科罗拉多州把 LLC 注册费从 50 美元降到 1 美元时,新公司注册量上升了约 17%;英国把费用从 12 英镑提高到 50 英镑时,注册量下降了约 17%。注册量的这些变化,并没有在后续几份商业活动记录里得到相应变化,说明新增的企业质量不高。结果很漂亮,而 Fable 自己选了问题、找到公开数据和自然实验、写出了分析计划和代码。但它并没有真的预注册:计划都留在项目内部,有些还是在早期结果出来之后才写的。
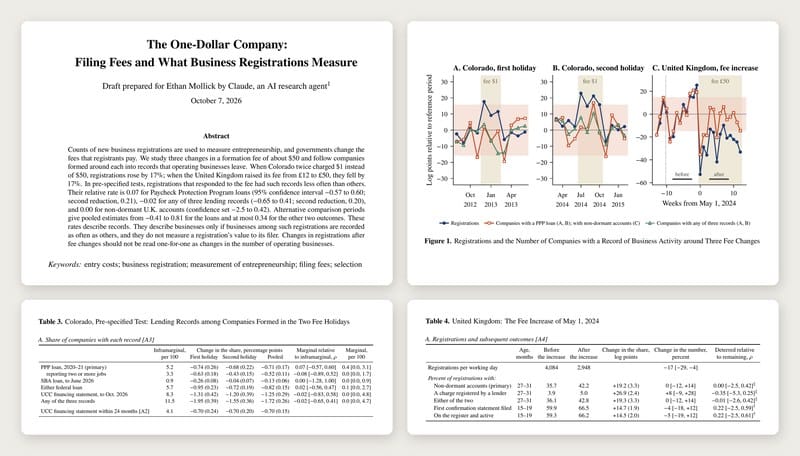
与我试过的许多 AI 论文不同,这一篇用巧妙的研究设计处理了一个重要主题。初读之下,它的水平超出我对二年级博士生的预期。但它按现状也发表不了。它有 182 页,因为每一条批评都换来一次新的分析,而什么都没有删(这个主题我们后面还会回到)。我还让 GPT-6 Pro(复杂学术工作一次性评审里最好的模型)充当同行评审,它两次发现了需要解决的问题。那些修订让文字更绕,还把「Claudespeak」塞进正文,于是又需要更多轮修改。就目前来看,我猜这篇论文已经接近对文献的真实贡献。这本来要几个月人力,而我投入不到一小时就到了这一步。然而这漏掉了研究工作的很大一部分:没有任何人完整核过结果,包括我。AI 现在产出研究的速度已经超过任何人阅读的速度,这在学术界制造了一场危机。
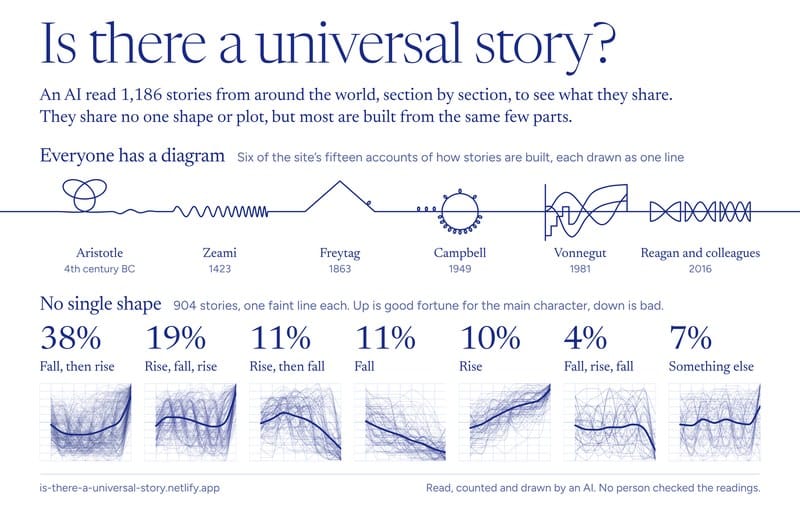
第二个项目顺利得多。我让 Fable 复现「故事遵循少数几种基本情绪弧线」的研究,然后去问:情节里有没有什么东西是普适的。它读了世界各地 1,186 个故事,做了一个关于故事本质的漂亮网站,结论是这些故事「不共享任何一种形状或情节,但大多数由同样的少数部件搭成;最典型的故事是一个关于巫师和魔法香蕉的夏威夷民间故事」。我遇到的主要问题还是 Claudespeak,提醒几次就修好了。
穿过传送门
在我最喜欢的实验里,我给 Claude 一段话,描述一段无尽、无需操作的旅程:穿越由传送门相连的一个个 3D 世界,然后告诉它「做出来,并让它令人敬畏」。二十小时后,一个上线的网站上有了 204 个世界。现在超过 450 个,包括百万面镜之厅、卡尔维诺《看不见的城市》系列、古代七大奇迹,以及杀死恐龙的那颗小行星撞上地球前 40 秒的场景。还有以 M.C. 埃舍尔、洞穴壁画、北斋《巨浪》、贝叶挂毯、一本立体书和一张儿童蜡笔画为原型的世界。每一个都由代码实时绘制,背后没有预制 3D 模型,也没有图片文件。我的提示要求有艺术家 agent、编码 agent 和评估者组成的团队。到第十天,已经有了一个主 AI agent 和 28 个其他 agent 团队并行建设。Claude 估计整个项目涉及 25,000 次 agent 运行,不过绝大多数只做单个任务,比如评判一张图(我至今庆幸早期试用时 token 用量不计费)。
我出了一串地点清单(荒野与海洋、城市与室内、书、画家、AI 内部笑话)和一些功能要求(给晕动症患者的减弱动效模式、可选画廊)。但其余都是 Claude 的,包括每个世界的创意工作。而且确实非常有创造力。在 The Valley Unzips 里,山丘是用牛仔布缝成的,一条一英里长的拉链正在解开。Bouncy Castle Town 由一堆尼龙房子组成,只有风扇一直转着它们才立得住;Keep Refrigerated 则是从一只果蝇的视角,看冰箱门被打开时的内部。我个人最喜欢 The Drawer Cliffs:你沿一条河峡谷向上飞,两侧峡谷壁是三百米高的抽屉柜。我确实要求它加入 AI 测试的内部笑话(比如骑自行车的鹈鹕),它想出来的是一队骑自行车的鹈鹕,还内置了一个关于 AI 进步的笑话:你先超越来自过去的车群(那里自行车画得全错),再到前方现在这只画得正确的鹈鹕。当我把这类作品给在电子游戏行业干了一辈子的朋友看时,他们对结果非常震惊。这又一次感觉像 AGI。但这里也藏着锯齿。
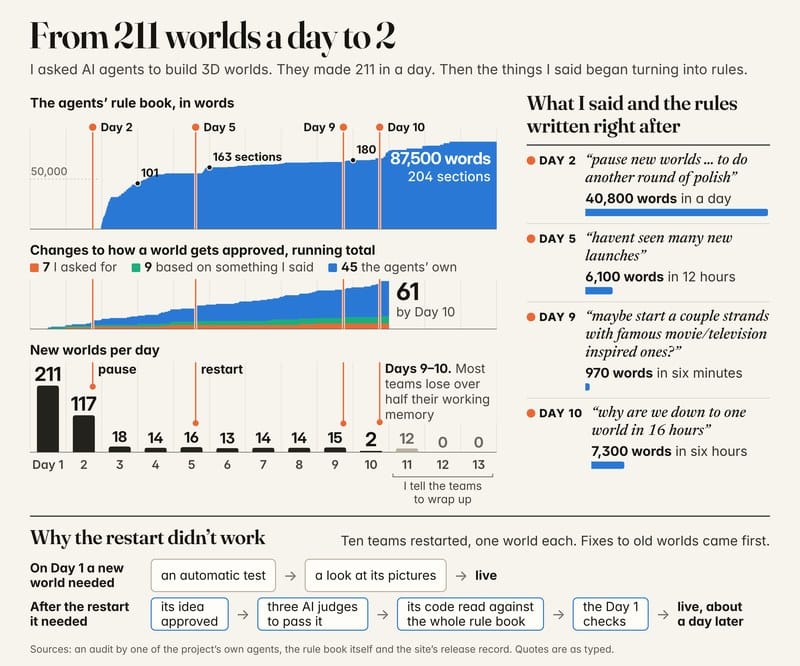
头两天,agent 建了 328 个独特世界。以我人类的眼光看,有些质量参差不齐,agent 之间缺乏协调还造成了重复。举例来说,三个互不相干的 agent 团队各自做了一个旋转动物的旋风(驯鹿、蝠鲼、鹳)——这暴露了 AI 的另一个弱点:它们会一遍遍回到相似的主题。我告诉 AI 停止新建、去打磨已有世界。几天后我注意到,它不再是每天几百个新世界,而是一天十几个。我让几个 agent 去查发生了什么,它们发现了意外的东西。
AI 建起了一套官僚体系。
agent 们认定,我要求「打磨」意味着每个新版本都必须在 12 张测试截图上、由一组评审 agent 盲投胜过旧版。于是做新版本的团队开始针对那几张特定截图优化世界。主 agent 发现后禁止了这个做法,并为评估新版本制定了更严格的规则。第二天早上出现了一本 84 节的规则手册(我从没要求过)。规则随着 AI 遇到问题而增加,而且没有任何文字被删掉。十二天后,它变成 204 节、87,500 词。很快,上线一个新世界需要:想法获批、三名 AI 评审,以及对照整本规则手册的完整代码审查。全部加起来大约要一天。光是读规则手册,就占掉 agent 工作上下文的一大部分。
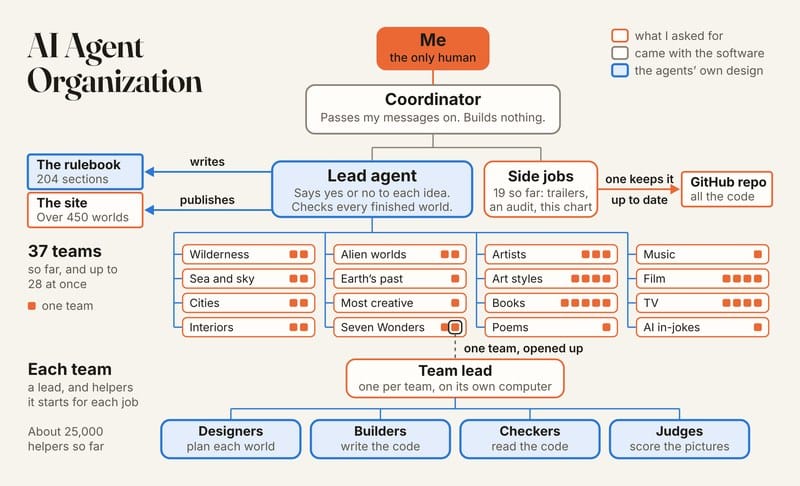
于是我做了你会对任何把自己缠成一团的组织做的事:请顾问。我让 Fable 另建一个 agent 团队,从外部审视整个流程。他们的结论太长太密,我懒得读,但似乎确实有效——流程加速回到每天 30 个以上世界,同时保留了大部分质量控制。
几乎是 AGI
那么,按我那个有限定义,这是 AGI 吗?它当然是人造的,也是智能的。它还出人意料地通用。仅在这篇文章里,一个模型就当过电影制作人、硬件黑客、创业者、文学学者、社会科学家和 3D 世界建造者,而且在每一个角色上都做得令人印象深刻。在很多单项任务上,我认为它达到了我一开始设的门槛:和大多数人类专家一样好。
当然,我挑的是非常数字化的任务——AI 可以自己行动,不太需要与其他人交互。当我感到不放心、不让 Fable 去接触真实客户时,你就开始看到这种局限了。而且确实存在失败。几年前,「锯齿边界」意味着失败是明显编造的事实或者算不出基本算术。Fable 的失败不一样:它做了一门准确但毫无乐趣的课,写了 182 页的论文,反复回到自己偏爱的想法,把一个创意项目埋进规则和审批之下。我在商学院教书,这些事我在有才华的人身上、在优秀的组织里都见过。如果「建官僚体系」就取消通用智能的资格,我们很多人都要倒霉。
但缺口仍然存在,这也是我说「几乎」AGI 的原因。最关键的一点是:AI 自己没发现这些问题。它没看出那门课是一场苦旅,也没看出自己被自己的规则手册缠住了。这并不是因为缺检查。Fable 几乎给每个项目都配了批评者、事实核查者或评审,但这些检查找的是错误、加的是修补。没有一个问过:这作品是不是太长、太重复、或不好玩。这些全都落在我身上;如果我没盯着并采取行动,结果往往会没那么令人印象深刻(虽然也不算彻底失败)。知道自己的作品还不够好,是成为专家的一大部分,而这恰恰是 Fable 最不可靠的部分。我仍然不放心让它独自经营一家企业,尽管它的商业计划如果出自我的 MBA 学生团队,我会印象深刻。
然而,有些问题其实起于我(规则手册源于我那个含糊的「打磨」要求),有些可能只是品味差异。我们让学生思考:一个问题来自团队,还是来自管理方式?很多时候我也分辨不出来。这不是我以前对软件需要问的问题。
不过,每一个项目之所以发生,都是因为我给了 AI 一个想法。有时这就够了,但对更长的项目来说,我一路上的反馈显然很重要。因为我启动并驾驭了每个 AI 项目,Fable 让我感到被赋能——能够命令做出我以前根本不会考虑去做的东西。所以我认为这个「锯齿状 AGI」阶段令人兴奋,尽管我有点焦虑地想知道它还能持续多久。
我们的整理:这篇能当什么用
Mollick 这套实验的价值不在于「模型很强」这个结论,而在于它给出了四个可复用的探针,任何人都能照着做:
- 跨域单次提示:不给例子、不给反馈,让它做一件你没做过的东西(视频、硬件改造、课程)。看它理解意图的速度,而不是看完成度。
- 带外部约束的任务:预注册、公开记录请求、真实客户联系——这些约束会让模型的「越界冲动」暴露出来(它想去给政府发公开记录请求)。
- 多智能体长跑:一旦给 agent 团队加「打磨」这类模糊要求,观察它是否自己发明度量、进而优化那个度量(12 张截图盲投就是典型的指标被游戏化)。
- 自评能力:问它「这作品哪里不够好」,看它能不能说出你已经在担心的问题。这一项,本文给的是否定答案。
边界也要写清楚:作者拿的是早期访问且期间 token 不计费,所有 demo 都由同一位作者在单次会话序列里完成,没有第三方复现;Anthropic 未预览本文;「20%–40% 成功率」「17% 涨跌」都是模型自报或模型自己跑出的数字,未经独立核验。本文的判断只能读成「一位长期观察者的定性结论」,不能读成基准测试。
来源:Fable 5.2 and Jagged AGI(Ethan Mollick,One Useful Thing,2026-11-09)。
原文注释:考虑到 Anthropic 的 IPO 很可能即将进行,有必要重申:作者不收任何 AI 实验室的钱,也不会从 IPO 中获得财务收益;Anthropic、OpenAI、Google 从未被事先询问他会写什么,Anthropic 也没有看过本文。作者有时会获得模型的早期访问(包括 Fable 5.2),在访问期间 token 用量不计费,除此之外他自付账号费用。
本文由汇智网 · Software 2.0 编译整理,转载请注明出处。
这是「AI 基建 / 评测 / 安全」专题的一部分。完整地图见:AI 基建 / 评测 / 安全完全指南