多 Agent 写代码:代码是最简单的部分,协议才是系统
两个 agent 各写一个 Java 类,测试全绿、评审无阻塞。作者却说还不敢信:代码对不对只是结果的一小部分,真正的工作量在它周围那套协议。
一句话结论:多个 coding agent 一起干活,难的从来不是"它会不会写代码",而是围绕代码运转的那套控制平面——谁在跑、跑在什么状态上、用了哪个模型、改动被谁看过、什么算"完成"、以及谁有权把它合进去。代码是最容易的那部分,协议才是系统。
披露:本文编译自 Sumant Thakur《I Ran Multiple Coding Agents. The Code Was the Easy Part.》(2026-09-30,Substack),完整编译其全部要点与六条操作契约。原文的实践基于 Kiro Crew(编排层)+ Codex / OpenCode(执行层)+ Antigravity(只读评审)。文中细节与引语均来自原文,我们未独立复现;标"编者补充"的部分不是原文内容。
一、实验本身:两个再普通不过的 Java 类
作者用 Kiro Crew 协调了一次小型多 agent 实验:
- Codex 和 OpenCode 各自拿到一个独立的 Java 任务,跑在互相隔离的 git worktree 里;
- Antigravity 从一条独立的、只读的车道上评审产出的改动;
- 两个任务分别是
EmailNormalizer和WordCounter。
结果:
- 两个改动都通过了各自的测试;
- 评审没有发现阻塞性问题。
看起来一切都对了。但作者说:我还不能把这个流程叫作"可信"。
正确的代码只是结果的一部分。系统还必须能说清:哪个 agent 动了手、它用了哪个模型、它拿到的仓库状态是什么、它被允许改什么、以及在人类批准之前存在哪些证据。
Java 方法很简单。周围那套协议不简单。
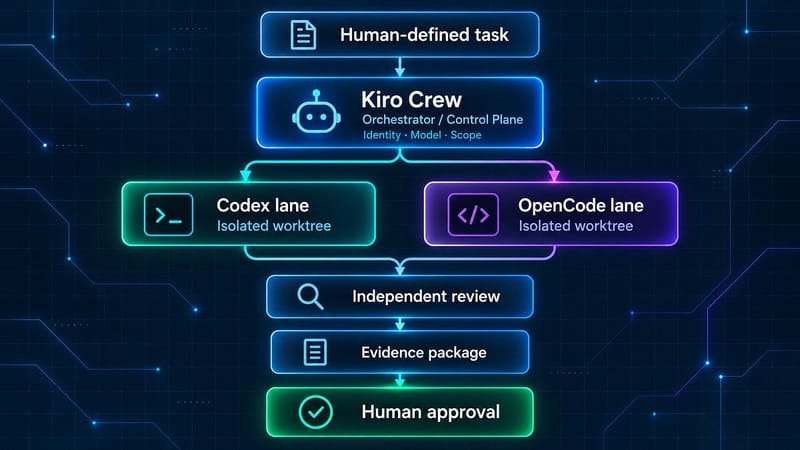
图:原文作者绘制的控制平面流程——任务从人类出发,经编排层(身份 / 模型 / 范围)分到两条隔离 worktree 车道,再合并为独立评审、证据包与人工批准。(图源:Sumant Thakur,2026-09-30)
二、多 agent 编程是一个分布式系统问题
一旦多个 coding agent 并发工作,你手里就不再是"几个更聪明的聊天窗口",而是会失败、会重试、会卡住、会读到陈旧状态、会互相干扰的 worker:
- 一个任务完成了,另一个还卡着;
- 任务没变,模型变了;
- 仓库往前走了,agent 还在对着旧提交推理;
- 两个 agent 各自产出了合法改动,合起来却不兼容。
这些都是分布式系统里熟悉的问题:agent 是 worker,编排层是控制平面。
在这个实验里,Kiro Crew 扮演控制平面:协调各条车道以及车道之间的交接;Codex 和 OpenCode 是干活的 worker。git worktree 提供隔离状态,锁与归属规则限制并发访问,测试与评审产出证据,人工批准定义重大状态转换之前的边界。
用这个视角看,你会停止只问"它能不能写代码",转而设计:它在哪工作、能碰什么、它的动作怎么被记录、以及它必须在什么时候停下来。
模型当然还重要,但决定"它的工作能不能被信任"的,是模型周围的那套架构。这不是 OpenCode 特有的问题——worker 换成 Claude Code、Codex、Cursor 或别的,控制平面的要求一模一样。
三、把编程任务做得刻意无聊
这不是一次模型基准测试。作者故意不选复杂算法、不熟悉的框架或含糊的需求——实现任务越窄,工作流的毛病就越藏不住。
这一点确实有用:代码简单的时候,一个坏掉的工作流没法拿"模型不擅长这道题"当借口。
实验真正要问的是:几个 agent 能不能表现得像一个工程团队,而不是一堆互不相干的会话。那就不能只给每个 agent 一个 prompt,而是要给每个 agent:明确的职责、隔离的工作区、已知的运行时、验证路径,以及权力的明确边界。
代码本身是最快的部分。把边界立起来花了大部分功夫。
四、第一个真正的失败,出在"身份"上
运行中,Kiro Crew 开始拒绝执行 worker 操作,报了一个 identity_unattested(身份未被证明)条件。
重启编排器解决了眼下的问题。但这次故障暴露了一个关键区别:
一个 agent 可以可用,却没有被信任;它可以完成对模型供应商的认证,却没有控制平面愿意接受的身份;它可以访问工具,却不具备在当前工作流里使用它们的权限。
可用(available)、已认证(authenticated)、已证明(attested)是三种不同状态。
一旦 agent 能改文件、跑命令、操作外部系统,这个区别就变得关键。在单 agent 的聊天里,你说"agent 改了代码"似乎已经足够具体;但在多 agent 系统里,"agent"已经不再是一个有用的身份标识。
执行记录应该把一次改动连到具体的 agent 实例、模型配置、工具集、起始状态、以及权限范围上。缺了这些信息,你可能有能跑的代码,但没有可靠的溯源。
这在本地实验里显得小题大做,可一旦进入团队或生产环境,它就是基本的运维卫生:
你不会接受一次由未知服务账号发起的部署。Agentic 开发不该因为"它的操作者用自然语言说话"就享受更低的标准。
五、模型选择是运行时的一部分
他们还必须确认 Codex 和 OpenCode 用的确实是打算用的那个模型。
这在"一个助手、一个界面"时很容易被忽略——模型像是工具的内部细节。但当一个工作流支持多个供应商、自动路由、回退、或者给不同角色配不同模型时,这个假设就崩了:
仓库可以没变,prompt 可以没变,编排代码可以没变,换一个模型仍然可以产出实质不同的结果。
所以模型选择属于执行记录。探索性工作让工具自动选没问题;可重复的工程工作应该钉住模型,至少也要记录下来——记供应商、模型、相关配置,以及有没有发生回退。
你不会在不知道编译器版本和依赖集的情况下试图复现一次构建。模型正在变成开发生态里的又一个运行时组件。 不记它,你能复现 prompt,但复现不了那次执行。
六、并行 agent 需要隔离状态
每条实现车道都跑在一个独立的 git worktree 里。这个选择的重量超过任何巧妙的 prompt 措辞。
没有隔离工作区,两个 agent 可能编辑同一批文件、把对方的改动 reset 掉、在混合状态上跑测试、或者在一个还没被评审的改动之上继续构建。结果仓库可能照样能编译,但那不意味着你能解释它是怎么走到这个状态的。
worktree 给每条车道:一个明确的起始提交、自己的文件系统、独立的分支、一个有边界的 diff。EmailNormalizer 属于一条车道,WordCounter 属于另一条,两边都能推进,而不悄悄改掉对方看到的状态。
这是把普通的并发控制应用到 AI worker 上。自然语言界面并不会让竞态条件消失;某种意义上,非确定性的 worker 让隔离更重要——人类开发者会注意到"别人也在改这块"并停下来协调,而自主 agent 可能把新出现的文件当成合法上下文继续干下去。等测试失败时,两次改动之间原本的边界可能已经找不回来了。
如果你想让 coding agent 并行工作,就给它们并行的工作区。共享仓库不该等于共享可变状态。
七、仓库里的规则,应该活得比 prompt 长
一个常驻的 agent 团队,不该依赖人类在每次 prompt 里重新陈述工程流程。
一段详细的 prompt 能指导一次执行,但它是存放永久策略的糟糕位置。构建命令、目录归属、测试预期、架构约束、审批边界,都应该靠近代码,让每个 agent 无论换哪个模型、哪个工具,都以一致的形式遇到这些规则。
否则每次会话都从"重建策略"开始:人记得一些、漏掉一些,措辞在变,上下文被压缩,不同 agent 对同一条规则的理解也不同。
那不是治理,那是重复劳动。
在作者更完整的设置里,仓库内建的控件包括:明确的车道职责、验证命令、归属规则、就绪检查,以及"什么算完成"的清晰预期。具体机制可以不同——agent 指令文件、CODEOWNERS、贡献指南、策略定义、或机器可读的任务契约——但原则是一样的:
仓库不只承载软件,还要承载"改动这份软件的规则"。
这些规则比 prompt、比一次会话、比某个模型供应商活得更久。它们也让 agent 更容易被替换:当操作契约住在仓库里,从一个 coding agent 换到另一个,不需要凭记忆重建整个流程。
八、验证是证据,不是授权
两个 Java 实现都通过了测试。这确立的东西有用但很窄:代码满足了我们写下的行为检查。
它没有确立整个执行过程可信:
- 一个绿的测试不能确认是打算用的那个模型执行了任务;
- 不能证明 agent 是从被批准的提交开始的;
- 不能显示在验证期间没有别的 worker 动过这个工作区;
- 也不能确认 agent 待在它被分配的范围内。
一个通过的测试是证据,不是许可。
当 agent 能做的不只是"提出一个补丁"时,这个区别就重要了:合并分支、部署应用、改基础设施,和编辑一个本地文件的后果完全不是一个量级。
所以一条 agent 车道的有用产出不只是代码,而是一个证据包。对一个编码任务,它可能包含:
- 起始提交与结果提交;
- 改动的文件与最终 diff;
- 执行过的测试与验证命令;
- 模型与 agent 身份;
- 相关的工具活动;
- 独立评审的发现;
- 工作区最终状态符合预期的确认。
人类不需要手工复现每一个动作,但应该拿到足够证据,用判断力而不是信任来完成批准。
这正是 human-in-the-loop 设计常被误解的地方:目标不是把一个人塞进 agent 的每一个动作里(那会以牺牲自动化的大部分价值为代价换取控制感),而是把人的权威放在有后果的边界上。agent 可以计划、实现、测试、准备证据;系统在"改动变得难以回退"之前停下来。
九、评审者需要和实现者不同的权限
Antigravity 从一条独立的、只读的车道评审产出。这个分离很重要。
评审者应该检查实现、对照任务、识别风险、产出发现,不该悄悄变成另一个实现者——除非这个转换是显式的。
当同一个 agent 既写、又改、又验证、又批准一次改动时,工作流可能仍然产出好代码,但作者身份与评审已经坍缩成了一次执行。
这让结果更难审计。独立的评审者带来更干净的一次交接:coding agent 产出改动与支撑证据,评审者评估两者,人类收到的是"实现"和"批评"两份分开的输入。
人类工程团队早就懂这个分离:作者可以自己测代码,但独立评审者带来的是不同的责任与视角。agent 团队需要同一种区分,只不过要靠权限与工作流边界来强制,而不是靠职位头衔。
十、一套"coding 班组"的最小操作契约
这次实验给作者留下六条要求:
| # | 要求 | 一句话 |
|---|---|---|
| 1 | 可证明的身份(attestable identity) | 每个实质动作都要连到已知的 agent 实例与执行上下文。有了多个 worker 之后,"coding agent 干的"不再是合格的审计记录 |
| 2 | 隔离的状态 | 并行 agent 不该悄悄共享可变工作区;每条车道要有明确的起点、有边界的范围、可检查的产出 |
| 3 | 记录模型选择 | 模型是运行时的一部分:要可复现就钉住它,即使允许自动路由也要记下来 |
| 4 | 仓库内的规则 | 工程策略要活得比 prompt 长;仓库必须说明人和 agent 各自被允许怎么改它 |
| 5 | 独立验证 | 测试、静态检查、评审要产出可以和 agent 自己的"完成"消息分开检查的证据;自信的总结不能替代可复现的结果 |
| 6 | 明确的审批边界 | agent 要知道"自主准备"到哪里结束、"负有责任的权威"从哪里开始;系统必须在有后果或难以回退的转换前停下 |
这六条没有一条能让模型更会写 Java。它们让整个开发系统更容易安全地运行——那才是更重要的问题。
十一、更多 agent 不会自动变成团队
实验是成功的:Kiro Crew 协调了工作流,Codex 完成一个实现任务,OpenCode 完成另一个,Antigravity 评审结果,测试通过,独立评审没发现阻塞问题。
但这个结果不是"把几个能干的 agent 放在同一个仓库里"换来的,而是"在它们之间立起边界"换来的:
每个 agent 有明确的职责;每条实现车道有隔离状态;选定的模型被验证过;仓库承载了操作指令;评审者有独立角色;工作流在看到人工权威该出场的地方停下。
这就是"几个工具"开始变成"一个班组"的地方。
随着你把更多 coding agent 加进开发流程,最有价值的改进可能不是再找一个更强的专家模型,而是围绕你已经在用的那些模型的协议。
在加下一个 worker 之前,先确保系统能重建每一次改动背后的:行动者、起始状态、模型、权限、证据。 这些细节仍然可见时,agent 会更容易被信任、调试和替换;它们一直是隐含的时,每多一个 agent,产出和不确定性会一起增加。
代码是最简单的部分。协议才是真正的系统。
十二、一个读者补充:worktree 是生产边界,不是验证边界
在原文评论区,Gustavo Bataller 补了一条很关键的边界(编者引述,非原文):
即使身份、溯源、权限、本地验证都成立,这些保证也不会自动告诉你"两个各自可接受的改动合成一个系统之后会发生什么"。
worktree 是一条生产边界,不一定是验证边界。 值得问的问题是:两个改动交互之后可能冒出什么行为,是任何一方单独验证时都没覆盖的?如果现有证据仍然覆盖这个"合成后的主张",就复用;不覆盖,就该在这里扩大验证面。
这条补充和第八节是同一件事的两面:测试证明"改动自己没问题",不证明"改动合起来没问题"。
十三、编者补充:从这篇文章能抄什么
原文的六条契约可以直接映射成三样东西(编者补充):
- 身份 → 每个 agent 独立的 Git 署名 + 平台账号(怎么在 GitHub / 私有 Forgejo 上做,见 多 Agent 同机:Git 作者、凭据与提交归属怎么分);
- 隔离 + 规则 →
git worktree+ 仓库内的AGENTS.md/CODEOWNERS/ 任务契约(AGENTS.md怎么写才不是摆设,见 1,866 个项目的 Agent 说明书实测); - 证据包 + 审批边界 → 分支保护(要求评审、要求签名、要求状态检查)+ 一个"证据清单"式的 PR 模板(评审怎么做成七层防线,见 Claude Code 团队怎么做代码评审)。
十四、边界
- 本文为编译整理,未独立复现实验;
EmailNormalizer/WordCounter、identity_unattested条件、两任务均通过测试与评审无阻塞,均来自原文。 - 原文是一次小规模实验(两个任务、三个 agent),作者自己也只说"开始像可信",没有做量化基准;不要把它当性能或成功率证据。
- 文中对 Kiro Crew / Codex / OpenCode / Antigravity 的描述是作者在其设置下的用法,不代表这些工具在所有配置下的行为。
- 第十二节的观点来自评论区读者,单独标注,不代表原作者立场。
- 术语上,本文统一把 lane 译为"车道"、worktree 保留原名、control plane 译为"控制平面"。
相关阅读:AI 编程 / Vibe Coding 完全指南 | Agent / MCP / 自动化完全指南 | 多 Agent 同机:Git 作者、凭据与提交归属怎么分 | 多机并行 coding agent 实战栈 | Triglav:多 Agent 编排的 10 天复盘 | Agent 交付验收:声明与 diff 对账 | AI 辅助提交怎么标:Assisted-by、Co-authored-by 与签名别混
Sources
- Sumant Thakur, I Ran Multiple Coding Agents. The Code Was the Easy Part., 2026-09-30:https://sumantthakur.substack.com/p/multi-agent-coding-workflow
- 原文配图(Kiro Crew 控制平面流程示意):https://substackcdn.com/image/fetch/$s_!Jubq!,w_1200,h_675,c_fill,f_jpg,q_auto:good,fl_progressive:steep,g_auto/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F08454891-8fed-48ed-9aec-f6d0a0bcadc4_1672x941.png
- 评论区补充观点:Gustavo Bataller 在原文评论区的留言(2026-10-06)
本文由 hubwiz 编译整理,转载请注明出处。
这是「AI 编程 / Vibe Coding」专题的一部分。完整地图见:AI 编程 / Vibe Coding 完全指南