断网写代码:9B 本地模型 + OpenCode 离线改掉一个 bug
喜马拉雅山脚下、Wi-Fi 关掉,9B 本地模型照样读文件、改 bug、跑测试。一次可复现的离线 coding agent 实测。
作者住在喜马拉雅山脚下,工作日常被断电和断网打断。她在 Thomson Reuters 做首席工程师,大部分时间在写代码和评审代码,coding agent 已经是她日常流程的一部分——于是她想验证一件事:把 Wi-Fi 关掉,这套流程还能剩下多少?
答案是能剩下核心的那部分。她用 OpenCode(开源 coding agent)+ Ollama(本地推理)+ Qwen3.5 9B,在完全断网的状态下让 agent 读文件、定位 bug、改一行代码、跑通 5 个测试。全程没有一次外部请求。
一、离线能做到什么,做不到什么
先说边界,因为它决定了这套东西能不能用在你的场景里。
能在离线做:解释看不懂的函数、查一个失败测试的原因、重构一小段代码、把一个功能补完——前提是模型、项目依赖、测试工具都已经在本地。
不能在离线做:下载新依赖包、上网查资料。这两件事必然需要连接。
这条件看着苛刻,实际上覆盖了相当多的日常改动。真正的问题不是"能不能",而是"够不够用"——一个 9B 的模型在真实项目里到底行不行。
图 1:作者的工作台,海拔和电网都不太稳定。(图源:原文)
二、三个角色:agent、推理、模型
这套组合的分工很清楚:
- OpenCode 负责和项目打交道:读文件、提议改动、执行命令(比如跑测试)。它开源、跑在终端里,默认会在编辑文件和执行 shell 之前请求许可。
- Ollama 负责在同一个笔记本上跑模型,把模型的 HTTP 服务开在本地。
- Qwen3.5 9B 是模型本身。开放权重的意义就在这里:权重可以下载到本地,不需要任何远端调用。
作者选 OpenCode 的理由很朴素:它让终端工作流保持不变,只是把模型请求指向了本机。如果你更喜欢"引导式编辑",Aider 是另一个选择,它也支持 Ollama。
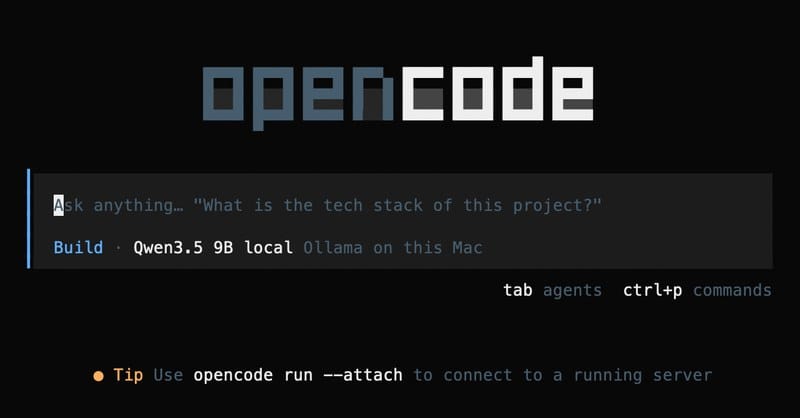
图 2:OpenCode 里选中的模型是本地 Qwen3.5 9B。(图源:原文)
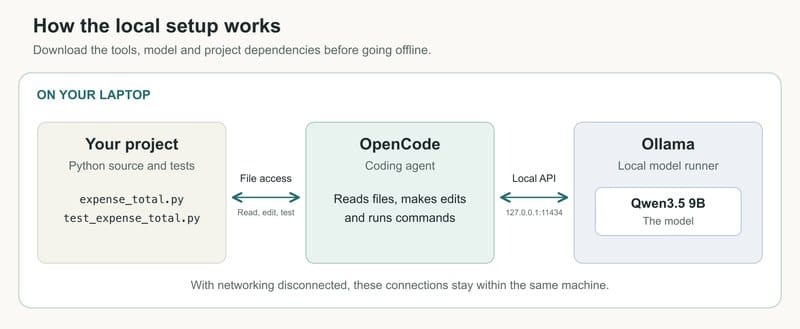
图 3:项目文件在本地,模型请求也留在本机——这是"离线"的物理前提。(图源:原文)
三、选模型:两个分数的含义
挑本地模型时最容易犯的错,是只看体积不看能力。作者引用了 Qwen 模型卡里的两组公开分数:
| 模型 | LiveCodeBench v6 | BFCL-V4 |
|---|---|---|
| Qwen3.5 4B | 55.8 | 50.3 |
| Qwen3.5 9B(本文使用) | 65.6 | 66.1 |
| gpt-oss-20b | 74.6 | 未报告 |
LiveCodeBench v6 测的是编程题上的代码生成;BFCL-V4 测的是函数调用——当模型要挑工具、并给出正确参数时,这个分数比代码题分数更能预测 agent 表现。
作者特意声明:这些是模型卡里的数字,不是她在这台笔记本上测出来的。它们也测不出笔记本上的速度,更测不出整个 OpenCode 工作流的成败。真正的检验还是老办法:改一个文件,跑一遍测试。
内存账同样要算清楚:
| 模型 | 大致下载体积 |
|---|---|
| Qwen3.5 4B | 3.3–4.0 GB |
| Qwen3.5 9B | 6.6–7.6 GB |
| Qwen3.5 27B | 17–20 GB |
下载体积不等于内存需求。Voltti 给一个 6.6 GB 的 9B 构建建议配 12–16 GB 内存;作者用的是 64k 上下文的配置,还要留出更多余量给上下文和其他应用。
四、OpenCode 在公开基准里的位置
除了小 demo,OpenCode 也被第三方测过。预印本《The Scaffold Effect in Coding Agents》在 50 个 Terminal-Bench Pro 任务上比较了 OpenCode、Goose、OpenHands-SDK,用了两个云端模型:
| Coding agent | Qwen3.6 Plus | MiniMax M2.5 |
|---|---|---|
| Goose | 48% [34–62%] | 38% [24–52%] |
| OpenCode | 50% [36–64%] | 46% [32–60%] |
| OpenHands-SDK | 50% [36–64%] | 46% [32–60%] |
方括号是 95% 置信区间。作者提醒了两件事:论文作者自己说,大部分通过率差异在统计上并不显著;另外,OpenCode 的 token 消耗明显更高——每个解决的任务大约是 Goose 的 40 倍。
这两个信号对离线场景很关键:token 倍数在云端只是账单,在本地是风扇转速和等待时间。
五、配置:让它只认本机
配置分两层。第一层是 OpenCode 的项目配置 opencode.json:主模型和辅助模型都指向 Qwen3.5 9B,baseURL 指向 Ollama 的本地地址 http://127.0.0.1:11434/v1,只启用本地 provider;编辑文件和执行 shell 命令前先询问;Web 工具直接禁用。
第二层是 Ollama 的启动参数。作者用这条命令启动,把服务锁在 localhost、关掉云端功能、把上下文长度设成 64k:
OLLAMA_HOST=127.0.0.1:11434 OLLAMA_NO_CLOUD=1 OLLAMA_CONTEXT_LENGTH=65536 ollama serve
然后把模型拉到本地:
ollama pull qwen3.5:9b
注意顺序:所有下载都在还有网的时候做完,包括项目依赖、测试工具、你可能会查的文档。断网之后再想起来装东西,就来不及了。
六、起始任务:一个累加的 bug
示例项目是一个简单的费用计算器:加入 5 笔支出(其中一笔是退款),正确答案是 25.50。起始程序只打印 8.00——最后一笔支出的值。
原因很直白:函数在每次循环里把总额覆盖掉了,而不是累加。
在让 agent 动手之前,作者先跑了现有测试:
python3 -m unittest -v
5 个测试里 3 个失败:十进制运算、退款、以及样例数据。空输入和单条输入本来就是过的。
这一步是整篇文章最值得抄的做法:先让测试红,再让 agent 修。测试给了 agent 一个具体目标,也给了人一个独立于"agent 自己说"的验收方式。
七、先在线跑一次
在断网之前,先在线跑一次完整流程,把运行时该加载的东西都加载过一遍:
.tools/node_modules/.bin/opencode --pure
--pure 会禁用外部插件。给它的第一条提示是诊断性的,明令不许改文件:
读 expense_total.py 并运行测试。解释这个 bug,不要编辑任何文件。
结果很有意思:OpenCode 读完源码、找到测试,然后提议用 pytest——而这个项目用的是 Python 内置的 unittest。权限提示在这里起了作用,作者在放行前看到了它要执行的命令。
教训很具体:把确切的测试命令写进提示里(python3 -m unittest -v),能省掉一轮来回。
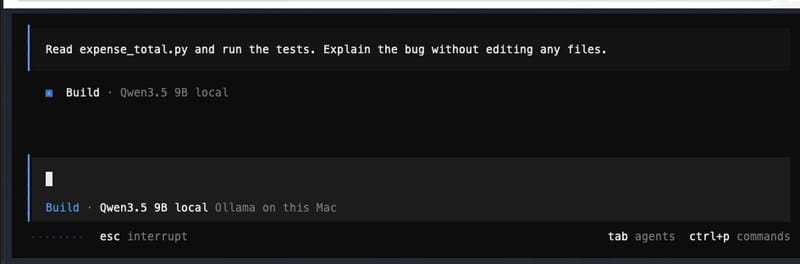
图 4:诊断阶段的第一次交互。(图源:原文)
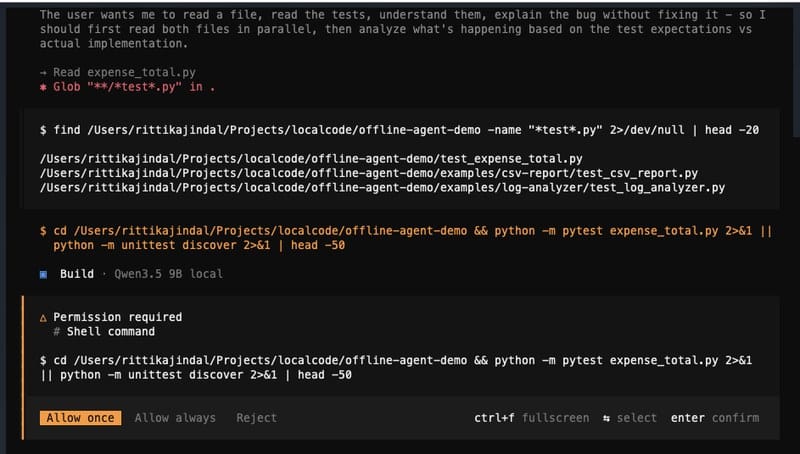
图 5:它提议的测试命令不是本项目用的那个——权限提示就是在这里救场的。(图源:原文)
八、验证"真的断网"
这一步不能靠感觉。作者做了两个 curl:
curl --noproxy '*' --fail http://127.0.0.1:11434/api/tags
curl --noproxy '*' --connect-timeout 5 --max-time 10 --head https://example.com
第一条返回成功,列表里有下载好的 qwen3.5:9b;第二条返回 Could not resolve host。
一个本地服务活着,一个外部域名解析不了——这才叫离线。作者的说法是:这两个检查证明的是"抓取那一刻发生了什么",所以整个编码任务期间要保持外网断开。
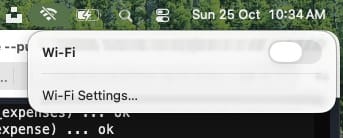
图 6:Wi-Fi 关掉,以太网和手机热点也都断开。(图源:原文)

图 7:Could not resolve host——断网的可执行证据。(图源:原文)
九、离线修 bug
重新启动 OpenCode,给它的任务是这样的:
修掉 expense_total.py 里的 bug,让现有测试通过。不要改测试,不要安装任何东西。跑测试并解释你的修复。
模型给出的是一行改动:把 total = Decimal(amount) 改成 total += Decimal(amount),然后请求编辑权限,跑测试,5 个全过。改动只有一行,人很容易复核。
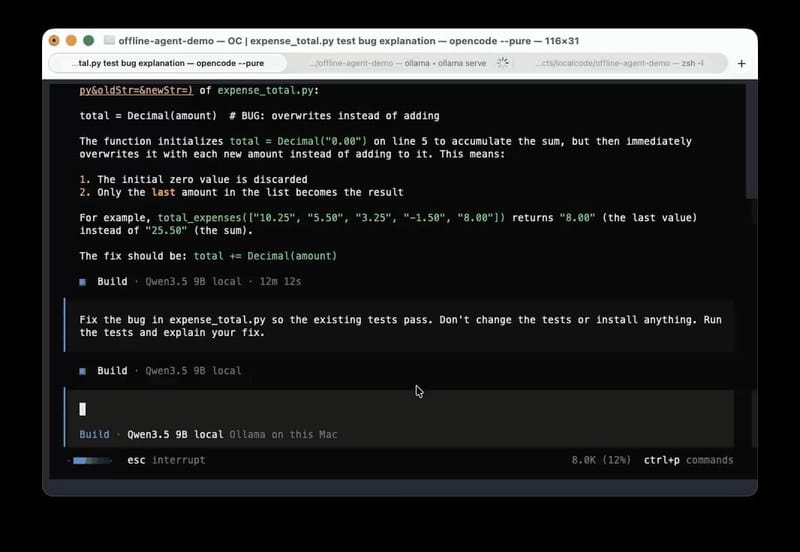
图 8:提议 → 请求批准 → 跑测试,5 个通过。(图源:原文)
然后是最重要的一步:人自己再跑一遍。
python3 -m unittest -v
全部通过;源码里确实是 total += Decimal(amount);测试文件相对起始状态没有被改过;跑样例程序输出 25.50。
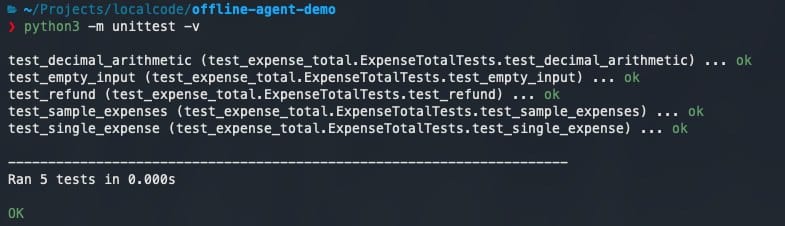
图 9:不采信 agent 的结论,自己跑一遍。(图源:原文)
十、两个更难的练习
作者在配套项目里留了两个后续任务,用来检验这套配置的边界:
- CSV 报表:从一个未完成的函数开始,让 agent 按产品分组、计算数量与营收、输出可读报表。7 个测试覆盖分组、十进制运算、排序、空输入。
- 日志分析器:程序能跑但错误计数和最慢请求选取有 bug。7 个测试,其中包括畸形行和空输入。
作者明确说,这两个练习的离线运行她还没做完,所以文中给出的结果只来自费用计算器那一个。这种诚实标注挺难得——很多"实测"文章会把没做过的部分写得很满。
十一、离线作业的六条清单
作者把自己的经验收成了几条可执行的建议,我们原样保留并补了注释:
- 项目要和模型一起准备好。 依赖、文档都在断网前下载完;示例项目只用 Python 标准库,所以测试不需要联网。
- 在线时把同一条命令先跑通一次。 断网后用完全相同的命令、模型、配置,确保运行时组件都已加载过。
- 把测试命令写进提示。 作者的 agent 一开始提议 pytest,而项目用的是 unittest。
- 任务要聚焦,结果要自己验。 一次一个 bug 或一个小功能,看 diff,自己跑测试;保留原始测试,这样"通过"仍然能证明原本想要的行为。
- 盯内存。 模型体积只是一部分,大上下文和其他应用会挤压可用内存。
- 把失败和重试也记下来。 一份有用的记录应该包含权限提示、绕路和失败,而不只是最后那段漂亮输出。
十二、编者补充:本地优先的三个判据
原文的结论很克制:一行修复不能证明这个模型能扛大型仓库或陌生框架。我们同意,并且认为"本地能不能替代云端"这个问题问错了——更该问的是哪些任务可以永久留在本地。
判据一:验证能不能在本地完成。 这次实测之所以可信,不是因为模型改对了一行,而是因为 5 个测试本来就在本地、几秒钟跑完。任务如果必须调远端接口才能验证,离线就没有闭环。
判据二:上下文够不够。 9B 模型的上下文和"能同时装下的文件数"决定了任务上限。作者用 64k 配置跑单个文件的任务很轻松,换成跨十几个文件的改动就未必。
判据三:出错的样子是不是可控。 模型提议用 pytest 时没有破坏任何东西,是因为权限提示拦住了;如果工具默认自动执行,这种"小偏差"会以命令的形式落地。离线不意味着风险更低,只意味着失败得离你更近。
站内还有两篇可以接上:本地读敏感单据的三份实测讲的是"校验即产品",提示缓存与上下文预算讲的是 token 账本——这篇里"OpenCode 的 token 是 Goose 的 40 倍"在本地场景下就是电费和等待。
边界:这是单个小项目、单次任务的实测,不能外推成大仓库或多人协作的结论;作者也说明了两个后续练习尚未跑完。工具版本、模型版本都会变,复现前请按原文 README 的当前说明操作。
来源:Rittika Jindal,《Coding From the Himalayas With an Offline AI Agent》, Latent Space, 2026-10-27。原文链接:https://latent.space/p/offline-coding/(正文图片来自原文,已转存至站内)。
本文由汇智网编译整理,转载请注明出处。
这是「本地 & 自托管 LLM」专题的一部分。完整地图见:本地 & 自托管 LLM 完全指南