MODEL-ZOO
推理模型的训练:从原理到实践
我们采用了一个微小的 0.5B 参数模型,在我们的家庭实验室中向它投入了一些 GRPO,并设法教会它一些相当不错的推理技能。
MODEL-ZOO
我们采用了一个微小的 0.5B 参数模型,在我们的家庭实验室中向它投入了一些 GRPO,并设法教会它一些相当不错的推理技能。

APPLICATION
在本文中,我们将了解使用 DeepSeek 对新闻文章进行推理的方式。一切都使用 Ollama 在本地设置。

LIBRARY
由于访问官方服务时可能遇到的不稳定性问题,许多用户需要依赖第三方服务商来接入DeepSeek-R1。

MODEL-ZOO
人工智能在逻辑推理、问题解决和可解释性方面正在迅速发展。虽然 DeepSeek 的 R1 引起了关注,但它并不是唯一在推理任务中表现出色的免费 AI 模型。
RL
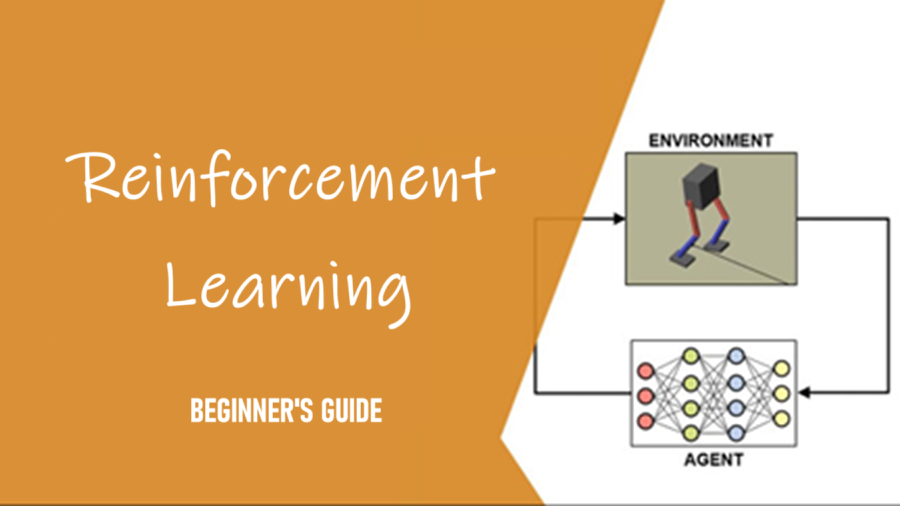
如果你曾经对机器如何学习玩视频游戏、驾驶自动驾驶汽车或优化商业策略感到着迷,那强化学习就是解锁这些可能性的关键。

APPLICATION
本文将引导你了解如何在 GitHub Models 上将 Microsoft.Extensions.AI (MEAI) 库与 DeepSeek R1 结合使用,以便你今天就可以开始尝试使用 R1 模型。
TOOL
DeepSeek 的 R1 研究揭示了一个“顿悟时刻”,其中 R1-Zero 通过使用群组相对策略优化 (GRPO) 自主学习分配更多思考时间而无需人工反馈。你就可以使用 Unsloth和Qwen2.5 (1.5B) 在仅 7GB 的 VRAM 上重现 R1-Zero 的“顿悟时刻”。

MODEL-ZOO
在 MMLU 等任务上,使用 VPTQ 的 2 位量化几乎实现了与原始 16 位模型相当的性能。此外,它能够在单个 GPU 上运行 Llama 3.1 405B,同时使用的内存比 70B 模型少!

MODEL-ZOO
我向这3个模型提供了一系列相同的提示,以测试它们从高级推理和编码能力到解决问题能力等各个方面。

APPLICATOIN
本指南将向你展示如何在本地安装和运行 DeepSeek、使用 CodeGPT 对其进行配置以及开始利用 AI 来增强你的软件开发工作流程,所有这些都无需依赖基于云的服务。

MODEL-ZOO
为了让一切变得简单,我们将使用手绘流程图和简单的计算来帮助从头开始澄清DeeoSeek-R1的核心概念。

MODEL-ZOO
在手机或桌面上使用 DeepSeek 应用程序时,我们可能会不确定何时选择 R1(也称为 DeepThink),而不是日常任务的默认 V3 模型。