lint 不够用:AI 代码 61% 功能正确,只有 10.5% 安全
语法全对、类型齐全、f-string 写得很漂亮,SQL 注入就在里面。lint 停在哪,后面三层谁来接。
语法全对、类型齐全、f-string 写得很漂亮,SQL 注入就在里面。lint 停在哪,后面三层谁来接。
CLAUDE.md 写三遍不如一条能退出码 1 的规则:把团队规范编码成自定义 linter,让 agent 自己跑、自己修。
AI 只靠 lint、依赖规则和变异测试的反馈写代码,能写出可维护的代码库吗?一份逐项实测,附她自己踩的坑。
六码农六文案加两个协调者,总产出 182;更强的 AI 打不过这支队伍。差距在一个数:协作。
验证循环决定你敢同时开几个 Claude:三种测试怎么选、39 项清单按 diff 触发、检查不能被被检查的改动修改、漏掉的 bug 怎么变成规则。
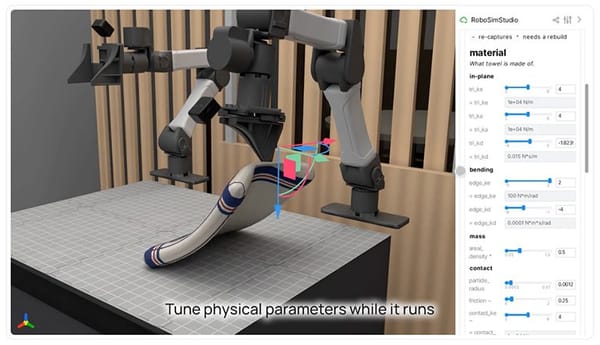
仿真里擦拭面积从 0% 刷到 100%,真机第一次就把支架推走了——因为仿真中它是钉死的。这条失败反过来改对了世界模型。
同一个"AI 副业月入 X",付款数据给 2.2 万美元,363 条自述的中位只有 1.27 万,而 87% 的说法根本查不到证据。三张图把口径摊开。
五步里信号越来越稀:一个 token 一个值 → 一个答案一个分 → 一整段 rollout 一个结果。稀到什么程度该上环境,这份课程给了判据。
RL 把 agent 推过了基座的 Pass@K 边界,但同一状态下的单步决策只有一半更好。真正被强化的是"出错之后"——代价是它需要更多轮次才兑现。
账很难看:验证吞掉 75%–94% 的预算,六成花在后来没用上的技能与记忆上。而只改一段笔记的笨办法,赢了三个会搜索候选的方案。
AI 已经写掉九成代码,却没人把选题交给它。这份综述把"RSI 还有多远"拆成三个必须依次成立的步骤和 18 个可下注的问题。
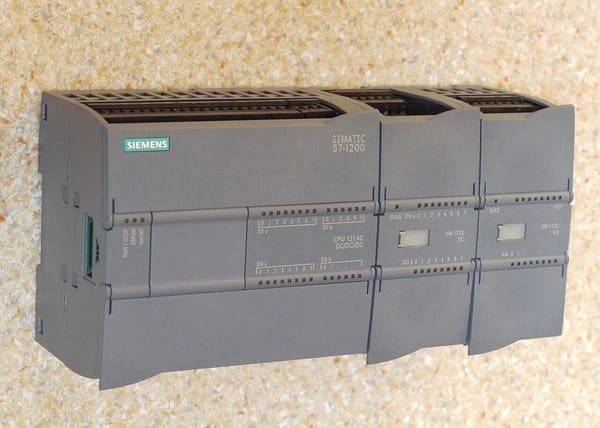
豆包会写 SCL 代码,但它写不进博途项目,也没法验证写得对不对。补中间那一层,再装一个插件包,三步就通。
在线 PLC 仿真
能测"你写得对不对"的不多,能测"它会不会自己重新启动"的更少。这也是我们把自己那个工具放进表里、并且把四条"做不到"写清的原因。
西门子
第一次开博途,多数人卡在同一个地方:不是逻辑写错,是下载按钮灰色——因为没人告诉你 PG/PC 接口要选对。卡住的每一步都能问:把 AI 接到博途上,它读得到你的工程。
PLC 编程软件
正确答案几乎永远不是"最好的那个",而是"你这台控制器支持的那个"。选完还要问一句:装完之后这段学习曲线,谁陪你走过去。
本地测试
42,857 个测试过 24,243 个——听起来不及格,但它给了 agent 最缺的东西:一个会按 AWS 的方式报错、而且免费随便重置的回路。
AI 成本
一个任务 6,150 个输入 token 对 1,000 个,3 轮对 1 轮——多出来的每一轮都要把变长的历史重发一次。价目表上永远看不到这四个成本。
AI Agent
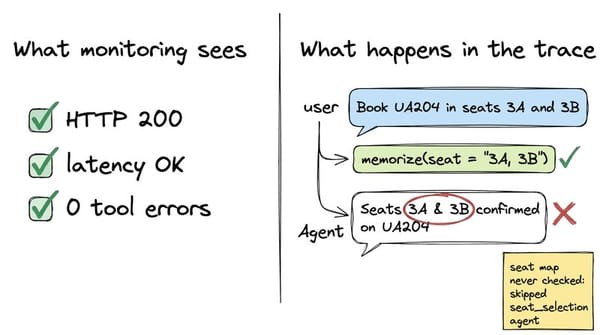
从外面看,这四类失败几乎一样。要分清,只能把失败轨迹和产生它的那份代码修订放在一起读——所以 AQuA 的 schema 里干脆没有「置信度」这个字段。
运动控制
目标给成绝对坐标还是相对距离?这个选择决定了停机、打滑、断电重启之后机器怎么动。含三段 SCL 示例与四个实操要点。
梯形图
同一个启停自保持回路写四遍:LAD 梯级、布尔表达式、IF/ELSIF、SCL。看每种写法丢掉了什么,比看功能对比表有用。
PLC
最可靠的自动化项目不是从功能清单开始,而是从失败清单开始:「这条线必须坏的话,它会怎么坏?」十种坏法、三道余量、一次真事复盘。
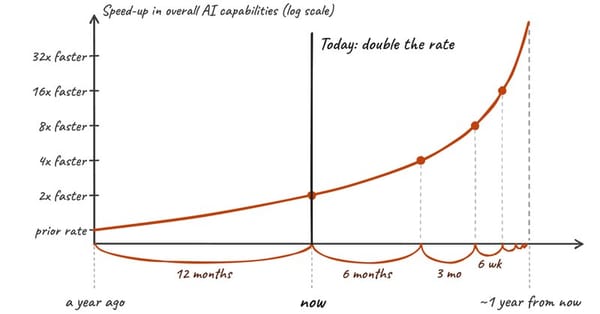
AI 研究加速
能力进步 1.9 倍、约八成归因于 AI 自己。把复合加速的算术摊开,时间线是一年——而这个行业连「防国家级窃取权重」的门槛都没到。
AI 泡沫
5 万亿美元账单、Anthropic 每 1 美元算力换 2.08 美元收入、20 多倍市盈率。把账摊开算,「明年就破」这个共识站不住。
AGI
一次提示做出电影、建 204 个世界、写出 182 页论文,还会自己长出 8.7 万词规则手册。差的那一步:它看不出自己做得不够好。