AI 写机器人程序:仿真刷到 100%,真机被一个支架拆穿
仿真里擦拭面积从 0% 刷到 100%,真机第一次就把支架推走了——因为仿真中它是钉死的。这条失败反过来改对了世界模型。
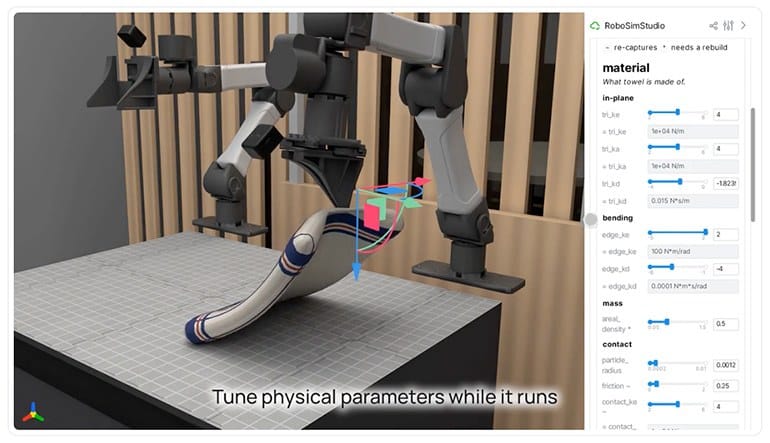
一块海绵擦掉金属杆上的一道墨线,机器人练了一小时,仿真里的擦拭面积从 0% 涨到 100%,然后上了真机——第一次就失败:海绵把一个支架推走了。
仿真里那个支架是固定在环境上的。真机上不是。这条差异没人写进参数里,所以模型在一小时里学到的最优动作,恰好是那个只有"支架不会动"的世界里才成立的动作。
这是 UC 伯克利 AUTOLab(Ken Goldberg 实验室)与英伟达合作的 agentic robotics 项目里最值得看的一段。它比"智能体写代码"这个说法有意思得多:一次真机失败,被当成世界模型的错误证据,然后反过来把约束改对了。
一、先看这次失败,它比成功率数字更重要
流程是这样的:研究人员给智能体一段手机拍的视频——机械臂拿泡沫海绵擦金属杆——没有任何 CAD 模型,也没有标定过的相机。论文给出的数字是,一个智能体用 56 分钟建好并通过了仿真验证。
仿真建好之后,研究者把海绵的刚度做成可变参数,生成 30 种杆与海绵的布置,一个叫 Graph-as-Policy 的框架拿这些仿真的反馈去改擦拭程序。经过 14 次迭代,仿真里的擦拭面积从 0% 涨到 100%。
然后真机跑了一次,支架被推走,海绵失去接触。
接下来的处理是这个案例真正的价值:把失败视频和"哪里不对"的描述交给智能体,它认出原始仿真把支架的支撑固定(fixed constraint)在了环境上,于是把它改成可自由运动的刚体。改完的仿真复现了真实情况——海绵压得够重或者偏离杆中心擦的时候,杆和支架会移动、会倾倒。
一条现场失败,变成了对虚拟世界的一次修正。这条路径是闭环的:真机失败 → 改仿真里的物理假设 → 重新自学习 → 再导出程序。
二、它想绕开的,是那个"没有数据就没有机器人"的死结
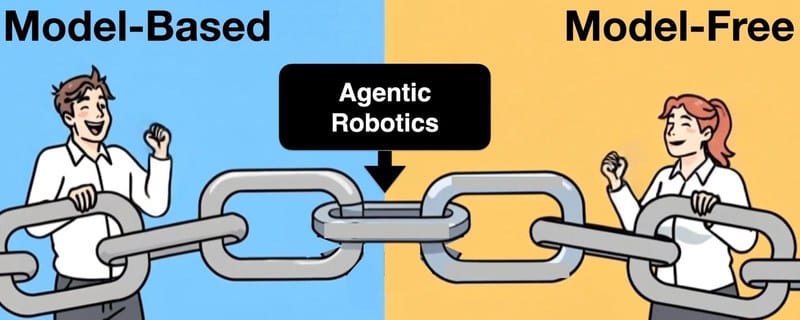
过去控制机器人只有两条路,Goldberg 把它们画成两种文化:
| 路线 | 怎么做 | 代价 |
|---|---|---|
| model-based | 工程师手工建模、编程、调参每个应用 | 每个新任务都要大量工程 |
| model-free | 用 VLA / ACT 这类大模型,从大量人类遥操作演示里学 | 需要巨量真机数据,采不到就没有 |
| agentic robotics | 多智能体 LLM 系统写、测、诊断并迭代改进结构化机器人程序,基本在离线仿真里完成 | 仿真建得对不对,直接决定学到什么 |
Goldberg 的原话是,他被"要采集的数据量"打击过;而 agentic robotics 提供了一条"不需要额外数据"的路。英伟达机器人工程总监 Spencer Huang 的说法更工程化:把智能体 AI、仿真、面向工业任务的开放基准组合起来,让开发者在部署前快速测和改进行为。
这两句话合起来是一个立场:数据不够时,把"试错"从物理世界搬到物理引擎里。 而搬进去的东西准不准,就是整个方法的天花板。
三、三段管线:一段视频进,ROS2 代码出
项目页把流程写得很干净,一共五个部件:一个真人演示做输入、三段工作、ROS2 代码做输出。
- Real2Sim:把视频、任务摘要、目标机器人与其传感器规格、已知环境几何一起交给前沿模型(他们用的是 Astra),由它搭出一份参数化的 Newton 物理仿真,视觉上要能对上视频。
- 代码生成 + 递归自我改进(RSI):Graph-as-Policy 的载体拿这份仿真作为输入,加上"预期的任务变化范围",生成并自我改进一张机器人计算图,目标是让这张图在该变化范围里对全部/大部分初始状态都能又快又稳地跑通。
- Sim2Real:计算图导出并转成 ROS2,在真实 rollout 里执行;性能反馈再回到第 2 步。
图里有一条红线:红线右边没有智能体。 机器人跑的是导出的、轻量的 ROS2 代码,实时控制回路里永远不跑前沿模型。这条设计决定了它能用在哪——智能体可以慢,因为它离线干活;现场那台机器不能慢。
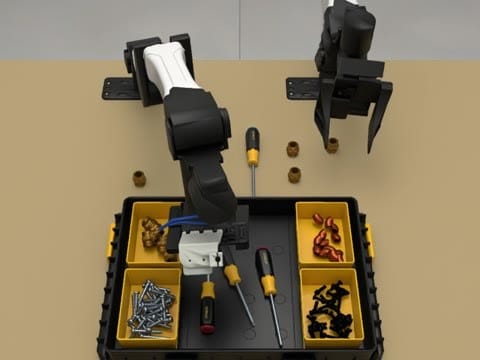
从这三个阶段能推出五条性质,其中两条对工程判断最有用:
- 一条真实演示是"证据",不是"训练数据"。 它用来证明"这个任务长这样",而不是喂给模型拟合动作分布。
- 学习在仿真里并行、且可以比真实时间快。 每轮智能体跑数百个 episode,把失败分组,然后重写代码。
四、Real2Sim 难在哪:一个物理解算器有几百个旋钮
论文自己列了难点:机器人与其操作对象之间的物理交互很难准确建模,包括接触力学、耦合的接触动力学、形变、刚度、摩擦。
RoboSimStudio(论文里简称 RSS,开源在 GitHub,11 月中已约 600 星)的解法不是"自动猜对所有参数",而是把选择暴露出来:解算器、接触模型、物理参数,全部显式、全部可编辑,人和编程智能体都能基于观察到的物理行为快速建、反复改仿真。
这一点值得停一下。Newton 引擎很强,但 Goldberg 说得直白:它太复杂,有几百个参数,所以一般人不太用——拨盘和开关太多。他的学生 Eric Kaiyuan Chen 最初是为自己做了个界面:左边可视化、右边滑杆,把参数调起来顺手。这个界面后来成了 RoboSimStudio。
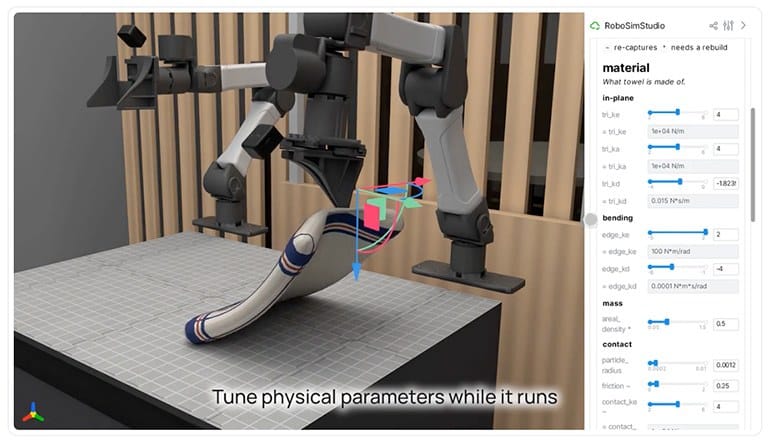
也就是说,这套方法的一个隐含前提是:仿真必须有人能看懂、能改的地方。 全自动黑箱建出来的仿真,一旦和真机不符,你连从哪改起都不知道。
论文把 Real2Sim 的实验分成三类:视觉评估、力反馈、以及 agentic Real2Sim2Real——最后这一类就是前面那根金属杆的故事。
五、GaP:不是让模型写一段代码,而是让它改一张技能图
Graph-as-Policy 的核心是把任务拆成模块:感知、抓取选择、无碰撞运动规划,还可以包含 VLA 策略。每个模块可以派给各自的智能体,几个 agent 并行工作而不互相踩脚。
然后 agent 生成代码、连接各节点、在仿真里排练、看失败、改。
三个工程细节决定了它能不能进现场:
- 这张图与 ROS 图等价,可以转成 ROS 2。
- 产物是 Python 写的、调用厂商既有模块做底层驱动控制,它不替代机器人控制器。
- 智能体被成千上万条提示词与结构约束住——不是自由发挥。
Goldberg 被问到这和"给 App 做 vibe coding"有什么区别时,回答的落点是:魔法在那套由 GaP 提供的 harness 上,是图结构在组织这些智能体;而 vibe coding 出来的程序第一遍也很少能用,测试与迭代是必需的。
对机器人来说,"迭代"的默认做法是先在仿真里测,再上真机。agentic 的区别是:智能体不只改代码,也改仿真环境本身。
六、怎么衡量:VABAR 的六个工业任务
没有基准,这类新闻只能靠演示视频判断。他们发布的基准是 VABAR(Variational Automation Benchmark for Agentic Robotics),六个接触密集的操作任务:
| 任务 | 考的是什么 |
|---|---|
| 工具分拣(tool sorting) | 抓取选择与放置策略 |
| 工具挂装(tool hanging) | 对位精度与松开时机 |
| 齿轮啮合(gear meshing) | 力控与微小位移 |
| 注射器装盒(syringe packing) | 易碎/规则摆放 |
| 线缆插入(cable insertion) | 柔顺性与视觉误差 |
| 线缆布线(cable routing) | 长程规划与拖拽 |
每个任务都有标准化的变化、难度分级与成功指标,让研究者能比较不同方法、判断系统能否应付工业运行的要求。底下用的是 Isaac Lab-Arena 做大规模系统性评测、Newton 做物理,任务里包含接触密集的机器人—物体交互仿真。
这套基准的意义在于:它把"agentic robotics 行不行"变成了可以复现的问题,而不是一段好看的视频。
七、读数字要先分清:哪句是仿真、哪句是转述
这批材料里数字不少,来源层级不同,混着用就会得出错误结论:
| 数字 | 出处与口径 |
|---|---|
| 56 分钟建成并通过仿真验证 | 论文口径,单个智能体,一个擦拭任务 |
| 30 种布置、14 次迭代、0% → 100% | 仿真结果,不是真机成功率 |
| 每轮数百 episode;Flip Anything 每轮 360 个仿真 episode,跨 36 个策略版本 | 项目页 |
| 24.7% → 95.0%(36 次自动修改) | 第三方二次转述(CASRAI 2026-11 的整理);AUTOLab 项目页没有直接给这组数字,引用时按转述标注 |
| 论文规模:13 页、7 图、1 表 | arXiv:2610.18835(v2,2026-10-14) |
项目页自己写明的边界也照抄一句:"还没可靠到能用于工业场景。" 论文里那次真机验证是单个硬件任务,仿真与真实行为的匹配主要靠定性观察。它没有证明家用通用机器人成立,也没有证明"以后的失败不会再发生"。
八、我们的整理:这套东西对工控现场意味着什么
把这条研究线放到自动化工程的语言里,它其实很眼熟:离线建模型 → 在模型里跑 → 差异回到模型 → 再交付。虚拟调试(virtual commissioning)二十年来做的就是这件事,只是改模型的人是工程师。
差别在两个地方,也正好是判断这类方案的两条线:
第一,谁改模型。 虚拟调试里,仿真和真机不符,是工程师去查"哪条假设错了"。这里,是智能体拿着失败视频去改约束。能不能改对,取决于两件事:仿真里的假设是否显式可编辑(RoboSimStudio 那排滑杆),以及失败是否留下了可用的证据(视频、轨迹、力)。
第二,产物是什么。 如果产物是一段只有模型自己能解释的策略,出问题没人能审;如果产物是 ROS 2 图、是能被 diff 的结构化程序,工程师就能像审代码一样审它——这条在这套方法里是被明确要求的:可读的程序,人能复核并微调。
还有一条更容易被忽略:仿真里没写的规则,学习过程不会自己补上。 支架固定还是自由,这一条假设决定了那 14 次迭代学到什么。所以"仿真刷到 100%"这个数字的含金量,完全等于"仿真的假设覆盖了多少真实约束"。
对做 PLC 与产线的人,这套逻辑可以直接借:
- 先问参数是否显式。 一个(仿真/验证)环境如果只给你一个"运行"按钮,失败时你无法定位;能改的旋钮越多,越可能把一次失败变成一条约束。
- 把失败当成规格的一部分。 支架那次的教训不是"模型不行",而是"需求里漏了一条"。这条在现场对应的是联锁、边界条件、上下料约束——它们通常不在程序员的脑图里,而在老工程师的嘴里。
- 分清仿真证据与现场证据。 每轮验收都要能回答:这一轮改的是程序还是世界模型?改完谁签的字?
至于"AI 替代工程师",这套方法自己都不敢这么说。它替代的是采集数据的成本,不是判断约束是否完整的责任。漏了约束,机器只会在你给的那个世界里最优。
九、要自己试,三步就够
- 第一步,只建一个仿真。 一条手机视频、一个已知的机器人规格,用开源工具建仿真,只调五个参数(刚度、摩擦、接触刚度、质量、阻尼),目标是"视频对得上"。对不上就说明参数还不够,别急着让智能体写程序。
- 第二步,先让它在仿真里失败。 把任务变化范围拉宽,让它自己撞墙——比一次真机失败便宜得多。这里要记录的是失败分类,不是成功率。
- 第三步,真机失败要写成一句话。 "仿真假设支架固定,真实支架可动"这种句子,是下一轮迭代唯一的输入。写不出来,说明这次失败白费了。
落地时怎么接(我们的部分)
- 要判"这段被智能体改过的程序对不对":用 PLC 云仿真。逐扫描执行、按周期回读变量,把"看起来对"变成可重复的 PASS/FAIL——仿真里能复现的失败,才值得占用一次真机时间。
- 要判"智能体能不能看到真工程":用 TiaLink。它把博途的 Openness 封装成 MCP,先把项目索引成知识图谱(调用关系、交叉引用、DB 成员读写、悬空引用),让智能体在改动接口之前就看清楚会被谁打破。
- 别把两层混成一层:仿真能证明行为,证明不了物理安全;约束是否完整,仍然要人签。
相关阅读
- 12 个最受欢迎的 PLC AI 工具:能写代码的多,能进工程的少
- AI 写的 PLC 程序,逐扫描周期验:CycleBench 把"通过"定义成每一拍都对
- AI 做 PLC 编程的 7 个教训:从编译通过到现场可用
- AI × 工业 / PLC 支柱页
来源
- Mike Oitzman,《Can AI agents program industrial robots without training data? Berkeley says yes》,The Robot Report,2026-11-11:https://www.therobotreport.com/can-ai-agents-program-industrial-robots-without-training-data-berkeley-says-yes/
- UC Berkeley AUTOLab × NVIDIA,《Agentic Robotics》项目页(含三段管线、GaP、VABAR、Flip Anything 每轮 360 episode × 36 个策略版本):https://berkeleyautomation.github.io/agentic-robotics/
- Kaiyuan Chen 等 12 人,《RoboSimStudio: An Interactive Toolkit for Human and Agent Rapid Real2Sim of Robot Manipulation Tasks》,arXiv:2610.18835(v2,2026-10-14),13 页 7 图 1 表:https://arxiv.org/abs/2610.18835
- Berkeley News,《Recent advances in AI are creating a "paradigm shift" for robotics》,2026-11-09(Goldberg、Spencer Huang 引语,56 分钟建仿真):https://news.berkeley.edu/2026/11/09/recent-advances-in-ai-are-creating-a-paradigm-shift-for-robotics/
- 开源仓库:https://github.com/robosimstudio/robosimstudio(约 600 星)、Graph-as-Policy 示例 https://github.com/graph-robots/agentic-self-learning(代码对应 arXiv:2611.09030)
- 擦拭任务的失败复现与"0%→100% 是仿真结果"的辨析:Robert Hu,《RoboSimStudio: What a Failed Wipe Taught a Robot Simulation》,2026-11:https://theroberthu.com/videos/robosimstudio-robot-simulation-missing-rule
- 24.7% → 95.0% 一组数字来自第三方整理 CASRAI,《Berkeley, NVIDIA Detail Agentic Robotics Paradigm》,2026-11:https://casrai.org/news/uc-berkeley-agentic-robotics-simulation-control-2026
本文由汇智网(hubwiz.com)编译整理,转载请注明出处。文中成功率、耗时均引自上述论文与项目页,未做本地复现;仿真证据不等于现场证据,约束完整性与安全验证仍由工程团队负责。