多轮强化学习赢在哪里:单步动作只有 46.8% 更好,靠出错后翻盘
RL 把 agent 推过了基座的 Pass@K 边界,但同一状态下的单步决策只有一半更好。真正被强化的是"出错之后"——代价是它需要更多轮次才兑现。
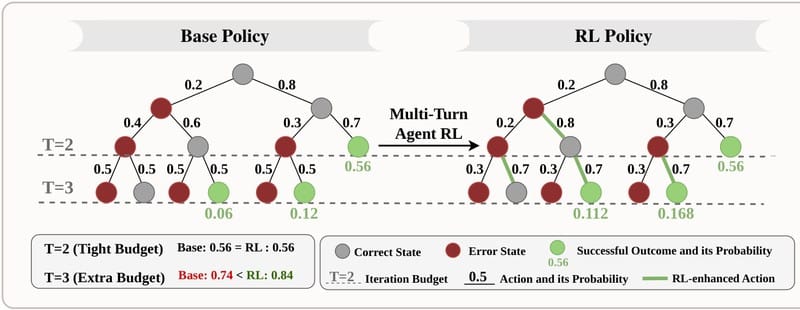
多轮 agent 强化学习(RL)在长程任务上效果很好,但它的优势高度依赖"允许交互多少次"。中科院自动化所、国科大与清华的作者(Kejian Zhu、Zhuoran Jin、Shangqing Tu、Tianyi Men、Yupu Hao、Jiachun Li、Kang Liu、Jun Zhao,arXiv 2611.06483,2026-11-04)把评估拆成两个维度——采样宽度 K 与交互深度 T——得到一个不太舒服的结论:
- 在 Pass@K(多采样几次)上,RL 模型稳定超过基座,甚至推过了基座的经验能力边界;
- 把交互预算收紧,这个优势缩小、消失,某些任务上甚至反转;
- 同一状态、同一历史下,RL 模型的单步动作只有 46.8%(DeepCoder-MT)/ 42.8%(FrozenLake)比基座更好,平均质量还略低;
- 但在错误状态上翻转:65.7% / 67.3% 的动作更好,从同一错误状态续跑的成功率是 51.3% vs 38.6%、38.5% vs 22.9%。
一句话:它没让 agent 每一步都变聪明,它让 agent 更会从错误里爬出来——而这个过程需要轮次。
一、原文摘要
多轮 agent RL 在长程任务上表现优异,但性能增益对交互约束高度敏感。作者用 Pass@(K,T) 在采样宽度 K 与交互深度 T 两个维度上评估,发现轨迹级的 RL 优势依赖足够的轮次预算,预算收紧时显著衰减。此外,agent RL 并不均匀地提升单步决策质量,它的强项集中在错误恢复与长程韧性上。为缓解这种"预算依赖"带来的部署风险,作者初步讨论过程监督信号的收益与局限,并提出 BudgetMix RL——训练时把交互预算也当作一个变量。实验显示 BudgetMix 在多种执行设置下都更稳。
二、问题:我们一直用"任务完成没完成"给 agent RL 打分
现有工作主要在轨迹层面评估 agent:在给定预算内任务有没有完成。单轮 RL 的早期研究用 Pass@K 探能力边界,办法是多采样几条独立解——它抓的是测试时扩展的一个维度:采样宽度。
但交互式 agent 还有另一个正交维度:每条轨迹允许交互多少次(交互深度)。作者的做法是先上 Pass@K,再上 Pass@T,最后把两者合成 Pass@(K,T)。
三、方法
3.1 交互的形式化
任务 x 采样自数据集 D。第 t 步给定交互历史 h_t = (x, o₁, a₁, …, o_{t−1}, a_{t−1}, o_t),agent 从 π(·|h_t) 采动作 a_t,环境返回观测 o_{t+1} ~ P(·|h_t, a_t)。动作可以是工具调用、终端操作或执行代码。在至多 T 轮的预算下,一条轨迹是 τ_{≤T} = (x, o₁, a₁, …, o_T, a_T),由终端验证器给奖励 R(τ_{≤T})。这个框架同时容纳纯结果型 RL(GRPO)与过程级信用分配方法(GiGPO)。
3.2 Pass@(K,T):把两个维度同时写进指标
对策略 π 与任务 x:
Pass@(K,T) = Pr[ 在 K 条独立采样 τ⁽¹⁾…τ⁽ᴷ⁾ 中,至少一条满足 R(τ⁽ⁱ⁾_{≤T}) = 1 ]
固定采样预算为常数 C、只扫 T,就得到 Pass@T = Pass@(C,T),用来单独隔离深度这一轴。
实验用 GRPO 作主算法,四个交互式基准:DeepCoder-MT(多轮代码:每轮可提交候选程序、看单元测试反馈、下一轮改)、BFCL(工具调用)、InterCode-SQL(交互式 SQL)、FrozenLake(具身规划的网格世界)。基座模型 Qwen3-4B 与 Qwen3-8B。
四、发现一:采样宽度上,RL 推过了基座的能力边界
随采样条数 k 增大,RL 模型始终高于基座(四个基准、两个模型规模都是)。这说明多轮 RL 能把轨迹级成功率推到基座的经验能力边界之外——这一点和单轮任务上的观察相反:单轮 RLVR 的 Pass@K 分析通常认为,RL 只是在给基座已经能采到的解重新加权。
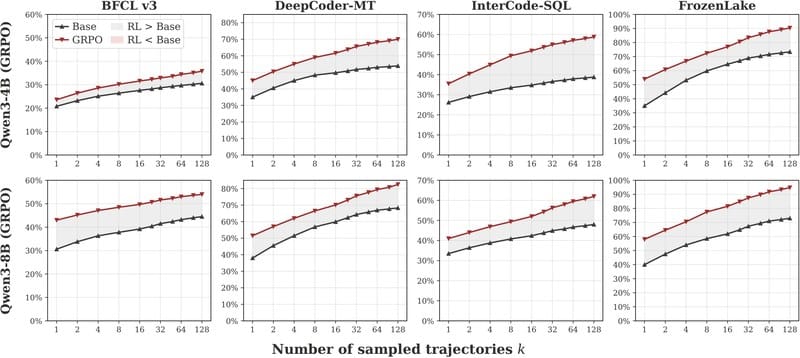
要点 3.1(原文):与单轮 RL 不同,多轮 agent RL 能把轨迹级表现推过基座的 Pass@K 经验能力边界。
五、发现二:预算一紧,优势就没了
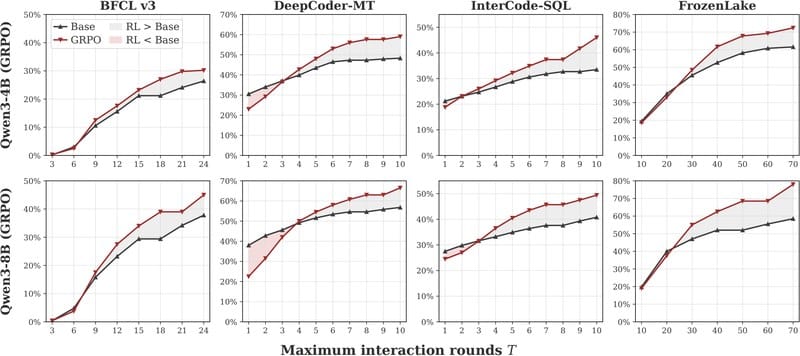
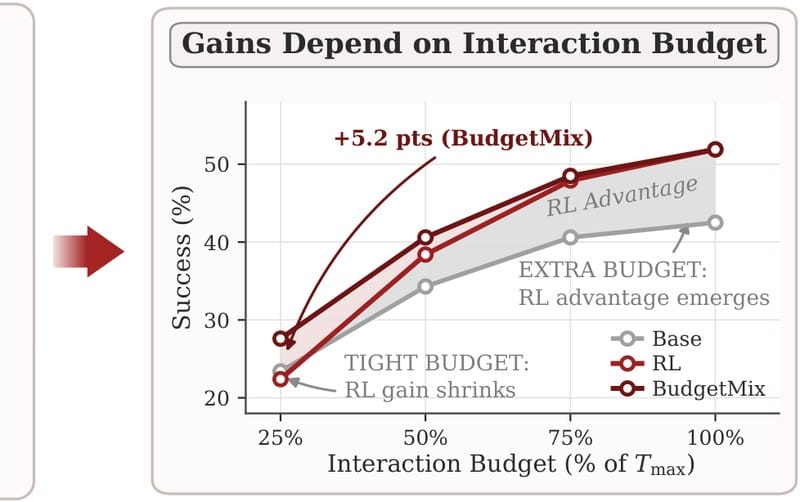
作者固定 k=8、扫最大交互轮数 T,出现一个清晰的模式:RL 的优势依赖足够大的交互预算。T 越大,RL 相对基座的领先越明显;T 小时领先缩小,某些任务上甚至反转。
为了排除"预算太小导致任务在结构上不可解"这个平凡解释,他们算了每个任务在每个预算下的结构上界:FrozenLake 用最短路径定上界,BFCL 用官方标注的正确工具调用轨迹估上界,DeepCoder 与 InterCode-SQL 因为每轮就是一次完整代码提交、原则上单轮可解,上界恒为 100%。结论是:在小 T 时,即使上界之下还留着大量空间,RL 也没表现出对基座的清晰优势。 所以不是"任务做不了",是"RL 的优势需要轮次才兑现"。
作者的猜想是:agent RL 主要强化长程能力,这种能力的收益要在预算充足时才显现;预算一紧,收益消失——这说明它的增益并不来自"每一步都更好"。
要点 3.2(原文):多轮 RL 的收益依赖足够的交互预算,紧预算下会衰减甚至反转。
六、发现三:单步动作质量并没有系统性变好
那么,回到最自然的问题:多轮 RL 到底有没有提升每一步的动作质量?
做法是在同一状态下比两个策略:对每个状态 s,分别从基座策略与 RL 策略各采 G=16 个动作,取质量分的平均,降低采样方差。
严格评估单步质量在 agent 场景里很难,因为可靠的过程奖励本身不好拿。所以只挑两个单步质量可算的任务:
- FrozenLake:用有限期动态规划(折扣 0.95)算出每个动作在"剩余预算内最优续跑"下的精确 Q*;
- DeepCoder-MT:每一步的代码可以用单元测试通过率打分。
为了把"动作质量"与"状态分布偏差"分开,他们从基座和 RL 的轨迹里等量采样中间状态建状态池。
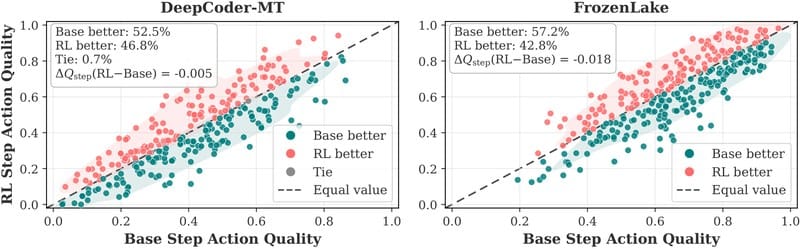
结果:RL 只在 46.8%(DeepCoder-MT)与 42.8%(FrozenLake)的匹配状态上给出更好的单步决策,平均质量不比基座好,甚至略低。也就是说,多轮 agent RL 不能稳定提升单步动作,偶尔还会让它变差。
七、但它在"出错之后"明显更强
既然单步不占优,轨迹级收益从哪来?作者把注意力放到紧接错误之后的状态上:在真实 agent 里,错误一旦发生,恢复能力才是关键。
构造方法是往前一步注入一个错误动作,得到错误状态池。这次分布明显翻到对角线上方:RL 选中更优动作的比例是 65.7%(FrozenLake)与 67.3%(DeepCoder-MT)。再从完全相同的错误状态续跑,RL 的终端成功率是 FrozenLake 51.3% vs 基座 38.6%、DeepCoder-MT 38.5% vs 22.9%。
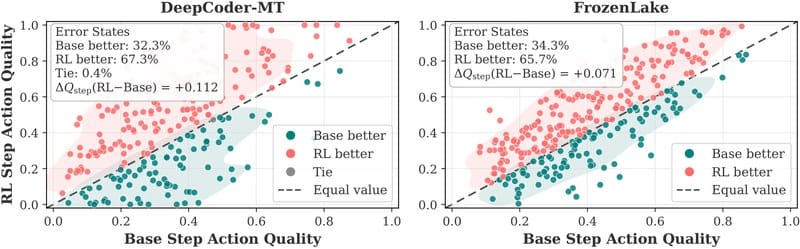
附录里还有一个更贴近工具的案例(BFCL):收集含工具调用错误的轨迹前缀 191 条(RL rollout 91 条、基座 100 条),让两个模型各在同一前缀上走一步。RL 的纠错率 41.4%,基座 27.2%;原文给了一个例子:RL 模型删掉不支持的参数,而不是把同一个错误再犯一遍。
八、优势出现在轨迹的后半段
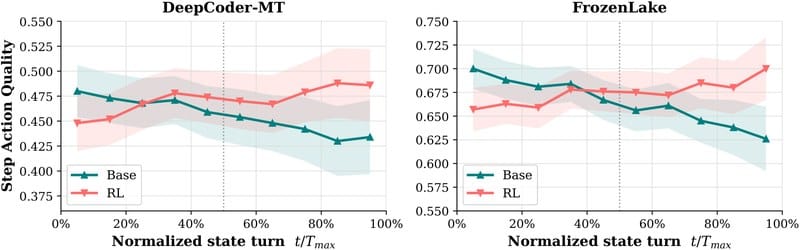
把中间状态按轮次分箱、定义归一化深度 d_t = t/T_max 后可以看到:RL 在轨迹早期没有优势,甚至不如基座;随着交互推进,差距逐渐缩小并反转。也就是说,RL 的逐步优势不是均匀分布在一条轨迹上,而是在后段、长程交互里才显现。
三条合起来解释了为什么它需要更多轮次:它买到的是"出错之后还有救",而"有救"这件事只有多走几步才看得出来。
九、机制:单步"局部合理",整条轨迹"整体更像"
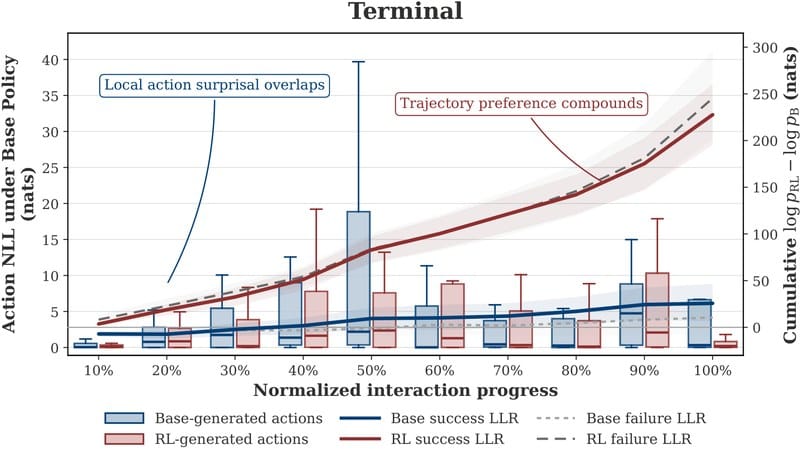
作者用似然把两件事分开算:
- 单步有多"异常":保持历史固定,用基座策略算 RL 动作的负对数似然 NLL。在 Terminal-Bench 上,RL 动作的 NLL 均值 12.20,基座自己的动作是 10.25——两组分布大幅重叠。含义是:RL 的单个动作并没有跑到基座策略的支撑集之外,这局部解释了 §6 的现象。
- 整条轨迹有多"像 RL":累计对数似然比 LLR_{1:t} = Σ[log π_RL(r_i|h_i) − log π_B(r_i|h_i)],r_i 是一轮里完整的模型响应(含推理与动作 token)。成功的 RL 轨迹,累计 LLR 随进度上升,到约 228;成功的基座轨迹只有约 26。
也就是说:每一步的条件概率都不离谱,但一整条长轨迹的联合概率可以差到"基座几乎采不出来"。 这提供了 §4 的一种解释——多轮 RL 让轨迹级成功率超过基座的 Pass@K 边界,靠的不是每一步更强,而是把"局部都合理"的动作可靠地串成一条长轨迹。
这个结论在 BFCL 上复现,并且做了长度控制:把基座与 RL 轨迹按任务配对、要求被计分的输出 token 数相差不超过较长序列的 10%,得到 Terminal 上 89 个任务的 193 对、BFCL 上 146 个任务的 283 对;累计 LLR(不做长度归一)的差在 Terminal 上是 185.9 nats、BFCL 上是 805.8 nats,两个 95% 置信区间都在 0 以上。
十、训练动力学:轨迹奖励一路涨,单步奖励往下走
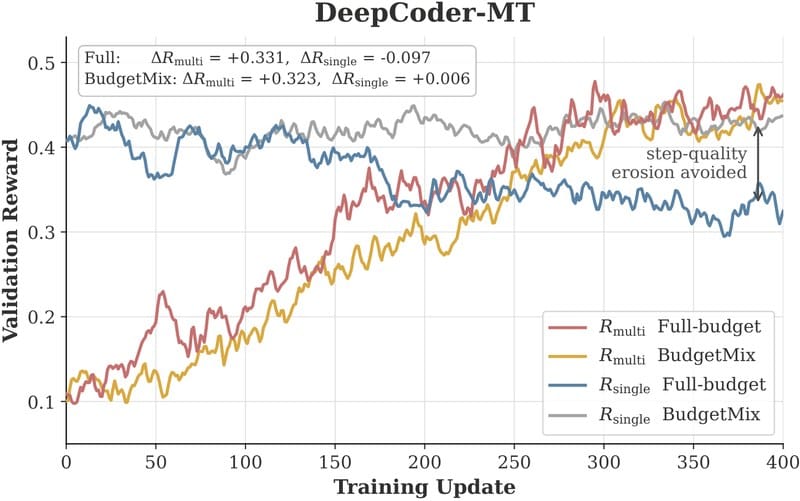
标准 agent RL 只用轨迹奖励 R_multi 优化和验证。对单步质量可测的任务,作者额外跟踪一个只用于验证的单步奖励 R_single。结果:R_multi 持续上升,R_single 不升反降——在 DeepCoder-MT 上,R_multi 涨了 0.331,R_single 掉了 0.097。FrozenLake 上同样:轨迹奖励上升,单步质量趋于下降。
所以终点的现象不是偶然:"轨迹级收益可以与单步动作质量下滑同时发生",而且这个分化是训练过程中逐步形成的。
十一、缓解办法一:高质量过程信号只能解决一部分
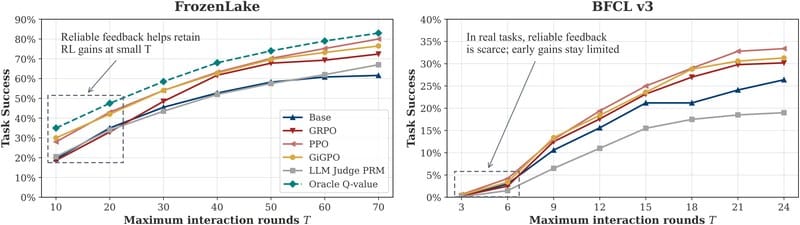
最自然的想法是引入更细粒度的信号:过程奖励,或更好的信用分配。作者试了几种:
- FrozenLake(有精确过程信号):oracle Q 值过程奖励与 GiGPO 都能在不同预算下稳住性能,紧预算下尤其明显——准确的进程监督确实能缓解"预算依赖"。
- BFCL(没有精确 oracle):这就是瓶颈。GiGPO、PPO 这类稠密信号方法在受限预算下没有带来提升,和 GRPO 差不多。他们还试了用 GPT-5.6-Sol 当过程奖励裁判,结论是即便很强的裁判模型,也无法在所有任务上稳定给出高质量的过程监督,在 BFCL 这种更真实的环境里尤其不行。
换句话说:能拿到精确过程信号的地方,这个病能治;而真实 agent 任务里,你通常拿不到。
十二、缓解办法二:BudgetMix——把"预算"变成训练维度
更简单的路子是 BudgetMix RL:奖励机制不变,只把交互预算在训练轨迹之间随机化。它可以直接套在现有算法上(GRPO、PPO、GiGPO)。
标准做法是在固定的 T_max 下采样轨迹、优化结果或单步奖励;但这个目标不区分"用了几轮才做完"——只要在预算内完成就行。BudgetMix 只改一处:对任务 x 及其满额预算 T_max(x),构造 10% 间隔的候选预算,每个任务组内均匀采一个:
T(x) ~ Uniform( Unique({ ⌈(k/10)·T_max(x)⌉ : k = 1…10 }) )
训练时把"总预算"和"剩余预算"写进 prompt(原文给了完整的系统提示模板:环境、最大轮数、已完成轮数、剩余轮数、任务指令、动作格式),超预算未完成给 0 奖励;奖励设计与传统 RL 一致。
核心想法是:预算改变了"同样奖励在什么条件下能拿到"。紧预算限制重试机会,对早期决策要求更高;宽预算保留长程执行的空间。
结果(Pass@8,按 T_max 的 25%/50%/75%/100% 评估):
- 紧预算(25%、50%、75%)下,BudgetMix 在四个任务上全面超过基座与标准全预算 RL,相对全预算 RL 的平均增益分别是 +7.5、+5.3、+4.0 个百分点;
- 满预算(100%)下与全预算 RL 打平——低预算上的提升没有牺牲长程能力;
- 训练动力学上(图 8 的黄/灰曲线),R_multi 稳步上升,而 R_single 保持稳定或略升;单步质量的直接评估也显示 BudgetMix 让局部决策质量稳定提升(附录 E.1),而标准 GRPO 会掉。
原文表 1 是 Pass@8 的完整矩阵(4 任务 × 4 预算 × 3 算法 × 2 模型)。下面只摘 25% 与 100% 两列,因为反转就发生在左端:
Qwen3-4B(25% / 100% 的 T_max)
| 任务 | 基座 | GRPO 全预算 | GRPO + BudgetMix | GiGPO 全预算 | GiGPO + BudgetMix | PPO 全预算 | PPO + BudgetMix |
|---|---|---|---|---|---|---|---|
| FrozenLake | 30.3 / 61.6 | 28.7 / 72.4 | 37.6 / 73.5 | 38.4 / 76.5 | 46.3 / 78.5 | 38.5 / 80.0 | 45.5 / 80.3 |
| DeepCoder-MT | 34.0 / 48.3 | 29.2 / 59.0 | 38.1 / 61.2 | 28.8 / 58.8 | 36.5 / 59.5 | 29.5 / 55.0 | 36.4 / 56.9 |
| BFCL-v3 | 3.0 / 26.4 | 2.5 / 30.2 | 8.5 / 30.8 | 3.4 / 31.3 | 8.5 / 33.0 | 4.2 / 33.4 | 10.2 / 34.5 |
| InterCode-SQL | 23.1 / 33.5 | 23.1 / 46.0 | 28.9 / 47.5 | 23.4 / 45.0 | 27.9 / 44.8 | 22.4 / 41.0 | 27.0 / 42.7 |
Qwen3-8B(25% / 100%)
| 任务 | 基座 | GRPO 全预算 | GRPO + BudgetMix | GiGPO 全预算 | GiGPO + BudgetMix | PPO 全预算 | PPO + BudgetMix |
|---|---|---|---|---|---|---|---|
| FrozenLake | 34.0 / 58.5 | 31.9 / 78.0 | 40.8 / 79.6 | 34.6 / 71.5 | 40.9 / 72.3 | 40.4 / 85.0 | 47.1 / 86.7 |
| DeepCoder-MT | 42.8 / 56.8 | 31.5 / 66.5 | 45.5 / 66.8 | 28.7 / 58.7 | 44.9 / 60.7 | 34.5 / 64.8 | 44.0 / 65.9 |
| BFCL-v3 | 4.8 / 37.8 | 3.8 / 45.0 | 10.5 / 47.2 | 5.6 / 43.5 | 10.8 / 43.2 | 7.0 / 48.0 | 12.2 / 50.5 |
| InterCode-SQL | 29.8 / 40.8 | 27.0 / 49.4 | 33.1 / 50.4 | 22.8 / 45.6 | 32.6 / 47.7 | 26.5 / 45.0 | 32.1 / 46.6 |
看两处就够:左端(25%)一列里,标准全预算 RL 常常还不如基座——Qwen3-8B 的 DeepCoder-MT 是 31.5 对基座的 42.8,Qwen3-4B 的 FrozenLake 是 28.7 对 30.3;而 BudgetMix 把同一格拉回到 45.5 与 37.6。右端(100%)BudgetMix 与全预算 RL 基本持平,个别格子还更高(8B 的 FrozenLake 79.6 vs 78.0、BFCL 47.2 vs 45.0)。
十三、相关工作与结论
多轮 agent RL 这条线,近几年从单轮 outcome-based RL 扩到交互任务(轨迹奖励),再往信用分配走:GiGPO 用"状态分组优势",SPA-RL 做逐步奖励分解,ARPO 用熵引导探索做优势归因;也有工作显式建模中间决策质量。但评估仍以轨迹级成功为主,所以本文要越过"任务完成没完成"去看增益来源与限制。
理解 RL 后训练 这条线:单轮的 Pass@K 分析认为 RLVR 主要在给基座已能采到的解重新加权;后续有工作报告长训后边界扩大,也有工作把增益归因于技能重组或放大基座潜在行为。这些都指向同一件事:终点的成功会掩盖增益的来源。最相关的前置工作是引入 Pass@(K,T) 刻画多轮能力边界、并显示 agent RL 能越过基座边界的 Zhai 等(2026);本文在此基础上加了预算依赖、单步质量与机制三层分析。
结论:多轮 agent RL 能扩展基座的经验能力,但这个优势在交互预算收紧时会衰减甚至反转;增益主要来自长程执行与错误恢复,不是"每一步都更好"。由于这会影响真实部署的可靠性,作者进一步讨论了缓解策略及其局限,并主张:agent 系统的评估不应只看最终任务成功,还要看它在不同执行约束下的稳健性,以及单个决策的可靠性。
十四、我们的整理:怎么用这份结论
第一,"成功率提升"不是一个可以放进采购文档的指标。 这篇论文最可直接搬走的东西是那个二维评估:Pass@(K,T)。它把"多试几次"和"多走几步"分开,暴露出一类此前被平均掉的风险——如果你的线上 agent 有严格轮次上限、或者单步动作不可逆(改数据库、发钱、下 PLC 指令),那么"离线评测 78.7%"这个数并不承诺你能拿到它。先量一遍自己的 agent 在 25%/50%/75% 预算下的曲线:如果曲线在紧预算处塌下去,说明你的 agent 也是"靠轮次换分数"的那一类。
第二,把"错误恢复"当成一个可测的独立能力。 论文的方法很便宜:往轨迹里注入一个错误动作,再从同一错误状态续跑,比续跑成功率。他们把这件事做成了三组数字(错误态动作质量 65.7%/67.3%、续跑 51.3% vs 38.6%、工具调用纠错率 41.4% vs 27.2%)。这比"任务成功率"更接近真实运维场景——真实世界里错误是常态,而 agent 的价值多半体现在"错了之后还能不能回来"。
第三,"单步更好"和"长轨迹更稳"是两件事,训练目标要分开。 机制分析(NLL 相当但轨迹 LLR 差一个数量级)说明:单步动作可以在基座支撑集内,而整条轨迹的联合概率极低——RL 学到的其实是"把局部合理的动作串起来"。凡是只优化轨迹奖励的训练,都在奖励"串得成",不奖励"这一步本身好不好";于是出现轨迹奖励涨、单步奖励跌的分化。BudgetMix 的价值不是那个随机预算本身,而是它把"预算"从评估维度搬进了训练维度,让模型在紧预算下也必须做对早期决策——这是靠改奖励函数很难达到的效果。
第四,和我们的后训练路线图对读。 这篇是"为什么 RL 那一层值得做、以及它的账怎么算";Hugging Face 那份 Agent 后训练五步 是"每一层用什么信号、用什么训练器"。两篇放在一起,刚好能回答一个很实际的问题:如果你的评测显示 agent 出错后不会恢复,那说明它缺的不是更多 SFT 数据,而是"见过自己的错误"——那是环境与 RL 那一层的活。
来源
- Kejian Zhu、Zhuoran Jin、Shangqing Tu、Tianyi Men、Yupu Hao、Jiachun Li、Kang Liu、Jun Zhao,What Does Multi-Turn Reinforcement Learning Really Improve in LLM Agents?,arXiv:2611.06483,2026-11-04;项目页 https://rethinking-agentic-rl.github.io/
- 图 1–9 取自论文原图(PDF 转图后压到 800px 宽;图 1 为便于阅读切成左右两块);表 1 数据摘自论文正文与附录
- 训练实现基于 VeRL,算法为 GRPO / GiGPO / PPO,基座 Qwen3-4B 与 Qwen3-8B
本文由汇智网编译整理,转载请注明出处。
这是「Agent / MCP」专题的一部分。完整地图见:Agent / MCP / 自动化完全指南