递归自我改进的账单:验证吃掉九成 token,最便宜的方案反而更准
账很难看:验证吞掉 75%–94% 的预算,六成花在后来没用上的技能与记忆上。而只改一段笔记的笨办法,赢了三个会搜索候选的方案。
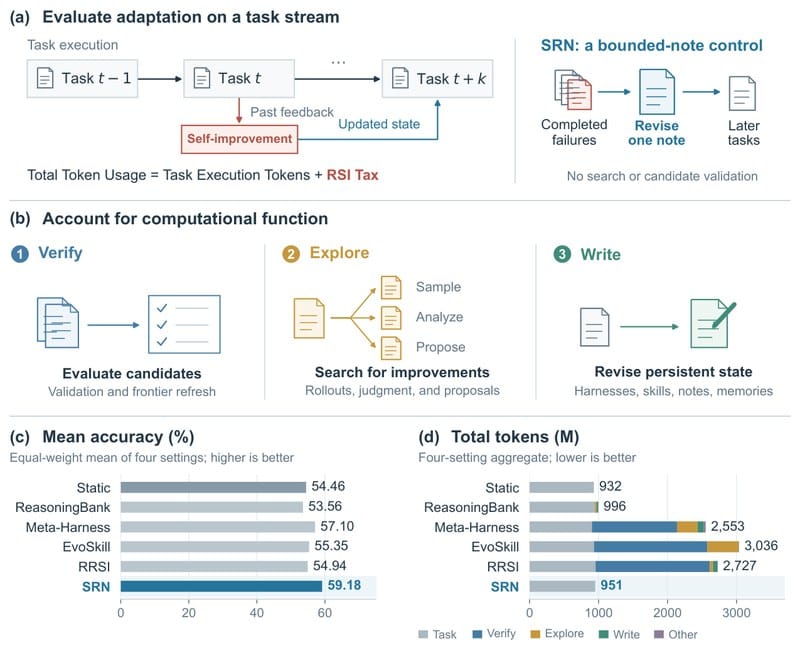
"自我改进"这件事本身要花钱,而大多数论文只报改进后的分数、不报改进过程的账。北京大学三位作者(Yitong Zhang、Ang Li、Yisen Wang,2026 年 11 月,arXiv 2611.13524)把这一栏单独拉出来,起名 RSI Tax(自改进税),再做端到端记账。结论不太好听:
- 在 6 种方法 × 2 个模型 × 194 个任务(2,328 组打分)上,Meta-Harness、EvoSkill、RRSI 的自改进开销是任务执行成本的 1.09—3.93 倍;
- 这笔开销里,验证(verify)占 74.8%—93.6%;
- 23.7%—63.6% 的自改进 token,花在后来在任务流里根本没被用过的状态或产物上;
- 而一个只维护一段 2,048 token 笔记、不做任何候选搜索的基线(SRN),在四个设置里三次准确率最高、一次打平,总 token 还少 65.6%—71.0%。
一、原文摘要
递归自我改进(RSI)试图用 agent 自己的任务经验来改进它。它的实际价值取决于一件事:性能增益值不值得付出"自我改进 + 任务执行"的全部成本。 作者在连续任务流上评估这个权衡,并且在每个任务的反馈被用于后续更新之前,先把这个任务的结果记录下来。
他们把自我改进过程的 token 成本定义为 RSI Tax,并在端到端评估中与任务执行成本并列。在六种方法和两个语言模型上,一个"有界笔记"基线(SRN)达到或超过了 Meta-Harness、EvoSkill 与 RRSI 的实测准确率,平均节省总 token 65.6%—71.0%。
他们把 RSI Tax 拆成验证、探索、写入三类,并跟踪对应状态或产物后续是否被使用。对这三种 RSI 方法,验证在四个设置合并后占 RSI Tax 的 74.8%—93.6%。相当一部分 RSI Tax 还与"后来没有被使用"的状态或产物相关。这些结果暴露了昂贵 RSI 流程的一个实际局限:部署时的 agent 变好了,并不意味着这个改进过程的花费是合理的。 它们指向一类新的 RSI 目标:在保证 agent 能力沿任务流持续增长的前提下,联合优化 RSI Tax 与期望的任务执行成本。
二、为什么要单独记这笔账
LLM agent 用工具做软件开发和其他专业工作。持续使用中,agent 会在同一个仓库或同一个应用里反复遇到相关任务;把有用的流程和失败教训留住,可以减少重复探索、提升后续任务的表现。近期一批"顺序型"基准正是在考察这种复用:相连的工作流、相关的任务变体、技能的累积。
RSI 用任务经验去更新 agent 带进下一个任务的状态。本文专注模型权重固定的 RSI,并按"它更新什么组件"来分类:
- 一类维护不断演化的记忆或技能集,供后续任务使用(ReasoningBank、Dynamic Cheatsheet、EvoSkill、SkillOpt);
- 另一类修改 agent 的 harness,包括指令、工具接口和执行用的控制代码(GEPA、Meta-Harness、RRSI、HarnessPro)。
自我改进过程本身有成本。近期有些工作比较了资源约束下的在线辅助模块与任务级搜索,把能力增益与学习成本关联起来;也有工作研究验证任务的选择、以及技能搜索成本的摊薄。但在任务流上,每一次更新都在"它对后续任务的价值还未知"的时候先付了钱;而任务执行本身的 token 需求也会随任务、运行和模型而变化。
作者把自我改进过程消耗的 token 称为 RSI Tax,并且明确规定:即使 agent 最后保留了原来的状态,尝试更新所花的 token 也要计入。 端到端成本 = 更新 token + 执行任务流用的 token。这两项是耦合的:一次更新可能让后续执行变短,也可能增加上下文、诱导更长的轨迹。真正该权衡的,是 agent 在任务流上的能力增益与这个合并成本。
三、实验怎么设的
3.1 六种方法
| 类别 | 方法 | 它更新什么 |
|---|---|---|
| 记忆 / 技能 | ReasoningBank | 从已完成的轨迹里抽策略,后续任务检索使用 |
| EvoSkill | 在可复用的技能文件夹上搜索 | |
| SkillOpt(本文未参评) | 对技能文档做有界编辑 | |
| harness | GEPA(未参评) | 用执行反馈优化指令 |
| Meta-Harness | 在控制器代码上搜索 | |
| RRSI | 对 harness 改动做正则化,抑制只针对某个基准的编辑 | |
| HarnessPro(未参评) | 选 harness 时把执行成本也算进去 |
各家的评估流程差别在于"反馈什么时候可用"和"在哪里测性能":ReasoningBank 在相邻任务之间更新记忆;EvoSkill 与 RRSI 先在固定任务集上优化技能或 harness,再到留出任务或其他基准上测被选中的状态;EvoTest 测同一游戏的重复回合内的适应;TTHE 先在无标签的当前批次上适应、再在该批次上打分;ServeLearnBench 在每个窗口内把"服务任务"与"留出测试任务"分开,并把学习调用计入资源账。
3.2 任务流与指标
先在任务结果被记录之后,才允许用它的反馈更新 agent。设任务序列为 x₁…x_T,模型参数 θ 固定,任务 t 使用状态 s_t;执行产生轨迹 τ_t 与二元验证结果 y_t ∈ {0,1}。更新只能使用已完成任务的历史 H_t,受状态边界与支持窗口限制:可以读公开指令、可见轨迹与标量结果,但不能读未来任务、参考答案或隐藏测试内容。为重新执行已完成任务所花的 token 计入 RSI Tax,而这些重跑不会替换任务原本的结果。
任务流有两个:
- 仓库类:SWE-Chain-Evo 中挑选的 7 条 15 任务链,共 105 个位置;学到的状态在链内保留,链与链之间重置;每个任务从规定的仓库快照开始。
- 终端类:Terminal-Bench 2.1 的 89 个异构任务,按固定顺序执行,学到的状态全程保留。把独立任务排成序列可以产生跨任务复用,但不会引入环境漂移。
对长度为 t 的前缀,定义累计正确数 Q(t)、准确率 A(t)=Q(t)/t、总 token N(t)=N_task(t)+N_RSI(t)。最终报告 A(T) 与 N(T)。
3.3 实验设置
六种方法(Static、ReasoningBank、EvoSkill、Meta-Harness、RRSI、SRN)× 两个模型(DeepSeek V4.1 Flash、GPT-6 Luna),共 6×2×(105+89) = 2,328 组"方法—任务"打分。在同一个"模型—基准"设置里,各方法共享任务顺序、初始 KIRA agent 与名义执行上限。
SRN、Meta-Harness、EvoSkill 每 4 个完成任务更新一次,窗口内选定的状态固定;同一窗口内的并行任务互相看不到对方的反馈。支持集大小:DeepSeek/SWE 用最近 2 个任务,其余设置用 4 个。ReasoningBank 保留逐任务的检索与记忆更新(去掉它独立的记忆感知测试时扩展组件)。EvoSkill 的原始流程被改造为对变化中的支持集重新打分它已有的前沿;Meta-Harness 的选择器要求严格提升才换部署;反馈选择也保留原方法的设定——SRN 用官方标量结果挑失败任务,ReasoningBank 用它内部的轨迹裁判。
四、RSI Tax 怎么算
4.1 记账口径
对每次记录下来的模型调用 c,n(c) 是它的输入 + 输出用量。任务执行调用集 C_task 与自我改进调用集 C_RSI 不相交:
- N_task = Σ_{c∈C_task} n(c)
- N_RSI = Σ_{c∈C_RSI} n(c)
- 税率 ρ_RSI = N_RSI / N_task
- N_total = N_task + N_RSI
要点:
- 税里包含"产出或评估一个更新"所花的 token,无论这个更新最终有没有被采纳。
- 执行期间读取已学状态属于 N_task;嵌入(embedding)token 计入 RSI Tax 的"探索"。
- RSI Tax 占总 token 的比例是 ρ/(1+ρ)。税率 100% 时,自改进的花费正好等于任务执行成本。
- 与参考方法 b 相比的"净 token 溢价"是 ΔN = N_total,m − N_total,b,用来和准确率对比。
4.2 拆成验证、探索、写入
| 方法 | Verify(验证) | Explore(探索) | Write(写入) |
|---|---|---|---|
| ReasoningBank | — | 轨迹裁判;嵌入 | 记忆抽取 |
| Meta-Harness | 现任与候选的验证 | 轨迹分析;候选搜索 | 候选 harness 编辑 |
| EvoSkill | 初始、新技能与前沿验证 | 额外 rollout;技能提案 | 技能落地 |
| RRSI | 现任与候选的验证 | 轨迹分析与摘要 | 候选 harness 生成与修订 |
| SRN | — | — | 笔记分析与改写(合并为一次) |
口径细节:验证是在已完成的支持任务上评估现任或候选,用于支撑选择(含基线验证、候选冒烟测试与进一步验证、以及对已有技能前沿的重新评估);原始任务执行中做的验证仍算在 N_task 里。探索是收集或分析用于提出更新的经验(额外任务 rollout、不做产物编辑的提案生成、轨迹裁判、ReasoningBank 的嵌入调用)。写入是创建或修订持久状态(harness 代码、技能、笔记、记忆)。每项成本只计一次,另有一个"Other"残差项。
4.3 "后来用到了吗"
作者把 RSI Tax 里的成本,按"对应状态或产物是否在下一次重置之前、或任务流结束之前被后续任务用到"分类。"用到"包括:运行更新后的 harness、执行中使用某个技能、把改写过的笔记或检索到的记忆加入 agent 的任务上下文。验证与探索成本跟着它们在记录中关联的状态或产物走,不只归到最后的写入调用上。
这个标签记的是"后来有没有被使用",不是实测的效果。 也就是说,"被用到"不等于"带来准确率收益","没被用到"也不等于"这些调用删掉后结果不变"。
于是有:r_no-use = (未使用状态的 token)/ N_RSI。注意它是 token 份额,不是更新次数或产物个数的比例。
五、SRN:一个有界笔记基线
SRN(Simple Reflection with Notes)基于"累积笔记"式适应:每 4 个任务更新一次,只用标量验证结果挑出失败任务来改写笔记,并在后续任务上下文里带上当前笔记;笔记上限 2,048 token。
更新规则很朴素:在更新边界取出允许的最近窗口 W_t,筛出其中失败的任务集 F_t;若 F_t 为空,笔记不变;否则让生成器读"旧笔记 + 公开指令 + 固定的轨迹摘录 + 标量结果",产出一份新笔记,再截断到 2,048 token。有效且非空的修订直接采纳,非法响应则保持原笔记。
SRN 不做额外任务采样、不做候选验证、不做检索搜索。 它的总成本包含笔记构建与带笔记完整执行任务的花费。作者把它定位成"低成本的自适应对照",并明确说实验没有把每个设计选择的贡献单独隔离。
六、结果
6.1 准确率与端到端成本
| 方法 | SWE-Chain-Evo(105 位置)DeepSeek 准确率 / 总 token(M) | SWE GPT-6 Luna | Terminal-Bench 2.1(89 任务)DeepSeek | TB GPT-6 Luna |
|---|---|---|---|---|
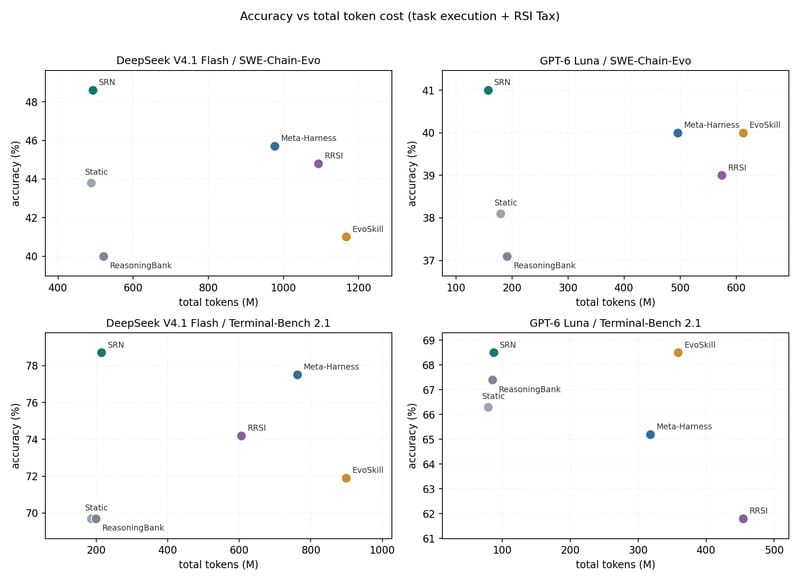
| Static | 43.8 / 487.92 | 38.1 / 179.69 | 69.7 / 185.55 | 66.3 / 78.86 |
| ReasoningBank | 40.0 / 520.64 | 37.1 / 191.21 | 69.7 / 198.87 | 67.4 / 85.46 |
| Meta-Harness | 45.7 / 976.61 | 40.0 / 495.81 | 77.5 / 762.57 | 65.2 / 317.99 |
| EvoSkill | 41.0 / 1,166.51 | 40.0 / 612.39 | 71.9 / 898.72 | 68.5 / 358.85 |
| RRSI | 44.8 / 1,092.94 | 39.0 / 574.07 | 74.2 / 605.75 | 61.8 / 454.30 |
| SRN | 48.6 / 492.56 | 41.0 / 157.07 | 78.7 / 214.65 | 68.5 / 87.08 |
总 token 含任务执行与 RSI Tax 两部分。四个设置等权平均后的准确率是:Static 54.46、ReasoningBank 53.56、Meta-Harness 57.10、EvoSkill 55.35、RRSI 54.94、SRN 59.18。
几个关键对比:
- 相对 Static,SRN 平均准确率 +4.7 个百分点,总 token 平均只多 3.6%。
- 相对 Meta-Harness / EvoSkill / RRSI,SRN 平均少用 65.6% / 71.0% / 68.2% 的 token(准确率增益按差值平均,token 变化按每个设置内的比值先算再平均)。
- SRN 的更新调用只占它总 token 的不到 0.4%,其余全花在任务执行(含带笔记)上。
- 不同设置下"准确率—成本"的关系不一样。DeepSeek 终端流上 Static 最省(185.55M),SRN 多花 15.7% 换来 +9.0 个百分点;GPT-6 Luna 仓库流上,SRN 的任务执行 token 是 156.67M,比 Static 的 179.69M 还少,多出的 0.40M 更新成本远不能抵消这个差额——总 token 比 Static 低 12.6%,准确率高 2.9 个百分点。
最能说明问题的是"漏算税会反转结论"这个例子:DeepSeek 终端流上,Meta-Harness 的任务执行 token 比 SRN 少(184.13M vs 214.37M),但它 578.45M 的 RSI Tax 把总数推到 762.57M(SRN 是 214.65M),而准确率还略低(77.5% vs 78.7%)。
6.2 税率与"后来没用到"
| 方法 | SWE DeepSeek | SWE GPT-6 Luna | TB DeepSeek | TB GPT-6 Luna |
|---|---|---|---|---|
| ReasoningBank | 4.78% | 5.96% | 4.53% | 7.39% |
| Meta-Harness | 109.06% | 177.35% | 314.16% | 329.15% |
| EvoSkill | 144.35% | 213.21% | 393.10% | 358.57% |
| RRSI | 125.79% | 213.02% | 223.23% | 346.68% |
| SRN | 0.04% | 0.25% | 0.13% | 0.36% |
表里是 100×N_RSI/N_task。100% 意味着自改进的花费等于执行整个任务流的成本;Static 是 0。可以看到,三个会搜索候选的方案在四个设置里,税都超过了任务执行成本——在终端流上甚至到 3—4 倍。
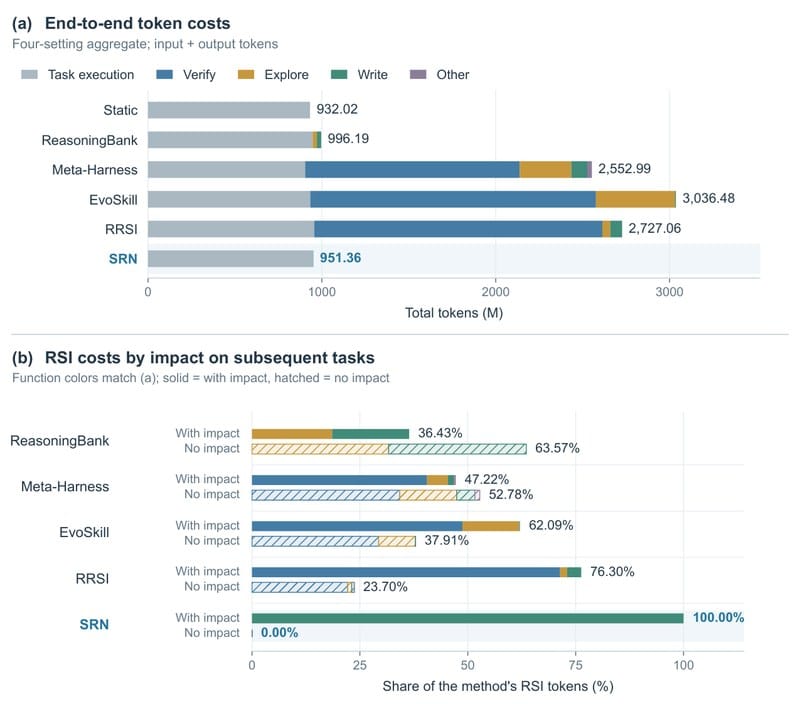
税的来源。 四个设置合并后,验证占 Meta-Harness 的 74.8%、EvoSkill 的 78.1%、RRSI 的 93.6%。EvoSkill 在额外 rollout 与提案上花 455.29M,而技能落地只花 4.59M;ReasoningBank 几乎把成本对半分在探索(裁判 + 嵌入)与记忆写入上;SRN 的整体笔记分析与改写操作只花 1.21M。
四个设置合计的自改进成本明细(M token,括号为占该方法 RSI 成本的比例):
| 方法 | RSI 合计 | Verify | Explore | Write | Other |
|---|---|---|---|---|---|
| ReasoningBank | 48.98 | 0 | 24.61(50.25%) | 24.37(49.75%) | 0 |
| Meta-Harness | 1,648.86 | 1,233.89(74.83%) | 296.99(18.01%) | 91.74(5.56%) | 26.24(1.59%) |
| EvoSkill | 2,103.05 | 1,643.17(78.13%) | 455.29(21.65%) | 4.59(0.22%) | 0 |
| RRSI | 1,770.50 | 1,656.86(93.58%) | 45.22(2.55%) | 68.41(3.86%) | — |
验证之所以这么贵,是因为它要反复把 agent 跑在支持任务上,而且常常每次更新都要评估多个候选或保留下来的程序。最刺眼的对比:DeepSeek 终端流上,EvoSkill 花 497.45M 去刷新它的旧前沿,而跑完 89 个到达任务是 182.26M——光是重新评估已有程序,就比服务整个任务流还贵,还没算额外 rollout 和新技能验证。另外,Meta-Harness 与 EvoSkill 的税里,记录下来的输入(input)约占 98.1%。
"后来没用到"的份额。 按 4.3 的归属口径:Meta-Harness 52.78%、EvoSkill 37.91%、ReasoningBank 63.57%、RRSI 23.70% 的 RSI Tax,关联的是后续任务里没有被使用的状态或产物。SRN 的全部更新成本都关联到被后续执行使用的笔记上。
同一个"没被用到",在不同方法里来自不同环节:Meta-Harness 把 564.85M 验证、217.60M 探索、69.22M 写入花在了后来没用上的候选上;ReasoningBank 则分别是 15.51M(裁判与嵌入)与 15.63M(记忆抽取)。只看总份额,看不出这个构成差异。
七、讨论:这笔账该怎么改
选更新策略。 一个 RSI 更新策略应该在控制 RSI Tax 的同时,让 agent 的能力随任务到达持续增长。它的效率目标应当同时包括:当下的更新成本、期望的任务执行成本、以及剩余任务上后续更新带来的成本。这样的策略可以选择保留当前状态、更新记忆或技能、或生成并评估 harness 改动。作者也承认:反复复用可能让更大的前期投入变得划算;而他们的实验比的是固定流程与已实现成本,没有评估"先预测成本再选更新"的策略。
怎么降税。 当验证主导税时,降低候选评估的成本就是第一优先级——支持任务的选择与前沿的维护是两个自然的着力点(自适应验证任务选择已经有现成做法)。"后续使用"的分析还指向更克制的技能与记忆构建:不该什么都存。不过作者强调,这些改动能否在保住性能的同时降低总 token,需要受控实验来验证。降税与 HarnessPro、RRSI 这类"成本感知的 harness 选择"是互补的:它们的挑选目标并没有把"获取更新的成本"和"持续服务任务流的期望成本"放在一起优化。
局限。 评估只覆盖两个基座模型、7 条仓库链、以及终端基准的一种排序;其他模型、工作负载、排序与重复运行都还没测,因此这些比较的稳定性未知。成本归属是描述性的:"后来被用到"不能证明带来准确率收益;"没被用到"也不能证明删掉这些调用不会改变后续更新或任务结果。 要量化每一类成本的可压缩空间,需要受控干预。
附录里的三个"可疑花法"(用于说明更新轨迹长什么样,不能直接外推比例):
- 空转的搜索轮(proposal-free search)——一轮搜索消耗了 token,却没产出任何提案。例:DeepSeek 的 EvoSkill 在第 68 个任务之后,先在 4 个支持任务上评估三个已有程序(44,882,109 token),又在两条额外轨迹上花 13,282,793 token,两条都成功,于是没有失败样本去触发提案器;整轮 58,164,902 token,零新提案,最终保留 iter-skill-7。这轮的钱大半花在"新提案还没出现之前,先把现有前沿重新评估一遍"上,而反复刷新来自实现里的滚动支持窗口(原版 EvoSkill 用固定验证集)。
- 结果不可能改变决策的评估(decision-invariant evaluation)——所有可能的验证结果都导向同一个采纳决定。例:GPT-6 Luna 的 Meta-Harness 在第 72 个任务之后,现任在支持集上是 100%,而选择器要求严格更高,所以任何候选的采纳概率都是 0;但新候选仍然拿到 69,715 token 的冒烟测试 + 534,126 token 的进一步验证,共 603,841 token。
- 存了没被取回的记忆(unretrieved memory)——存下来的记忆包后面明明有任务机会,却在重置前一次都没被检索。例:DeepSeek 的 ReasoningBank 在第 55 个任务(caffe-cifar-10)上花 117,631 token 判卷 + 124,108 token 抽取,产出一个三项记忆包,剩下 34 个任务一次都没检索它。把这条判据套到全部记忆记录上,得到 ReasoningBank 的 53.1%—61.5% 的 RSI token 属于这一类;终端任务上是 8.61M 里的 5.16M(DeepSeek)与 5.88M 里的 3.62M(GPT-6 Luna)。
八、原文结论
作者在任务流上评估了主流 RSI 方法的端到端 token 成本与任务表现,用 SRN 作为简单自适应基线,并提出 RSI Tax 来量化部署期自我改进过程的 token 成本。在被研究的任务流上,SRN 表明有竞争力的准确率不必以高额 RSI Tax 为代价。把 RSI Tax 拆成验证、探索、写入之后可以看到,反复验证的 token 消耗可以超过执行任务流本身;而相当一部分税与后续任务没用到的状态或产物相关。这些发现指向一类新的 RSI agent:在保证能力沿任务流持续增长的同时,联合优化试错式自改进的税与期望任务执行成本。
九、我们的整理:自己量一遍这笔账
第一,把"税"当成一个独立指标,而不是成本的一部分。 论文最实用的是那个定义:ρ = 自改进 token / 任务执行 token,100% 意味着"改自己的花费等于干正事的成本"。三个搜索型方法在四个设置里的税率是 109%—393%,终端流上尤其高——因为任务越多、机会越多,刷新前沿的次数也越多。在你的 agent 上量这个数只需两个计数器:把"为了更新而跑的调用"和"为了完成任务而跑的调用"打上标签分开记;如果你现在只有一个总数,那这篇论文的意思是:你看到的那条成本曲线里,很可能有一半到四分之三根本不在服务用户。
第二,先砍验证,而不是先砍模型。 验证占 74.8%—93.6%,其中约 98% 的 token 是输入——因为它们反复把支持任务、上下文、候选实现一起塞进 prompt 重跑。所以最直接的三个动作:缩小支持集、不要在"不可能改变决策"时还去验证(第 72 个任务那个 60 万 token 的例子)、以及给前沿刷新加频率上限。这也解释了为什么单靠"换更便宜的模型"救不了这类成本:贵的是次数,不是单价。
第三,"更聪明的自改进"这条路本身需要被证明。 一个只改一段 2,048 token 笔记、不搜索、不验证、不额外采样的做法(SRN),在四个设置里三次准确率最高、一次打平,还少用 65.6%—71.0% 的 token。作者也说得很克制:实验没有隔离每个设计选择的贡献,所以不能断言"搜索一定没用";但至少可以说,在这些公开任务流上,搜索式 RSI 的收益没有付清自己的账。要证明它值得,需要的不只是"分数更高",而是"扣除税之后仍然更高"。
第四,跟本站另外两篇成本拆解对着看。 前面那篇 Agent 成本体检(15 个 MCP、901 个技能的启动账)说的是"常驻上下文吃掉预算",这一篇说的是"为了改进自己而反复跑的那部分吃掉预算"——两者是同一个病根的两种表现:把一切都塞进 prompt 重跑。再加上那篇关于 AI 研发加速的综述 里"每位研究者每天 600 美元推理支出"的数字,可以看出一条线:能力越往"自主"走,成本结构就越从"每次问答"转向"每次自我维护"。
来源
- Yitong Zhang(北京大学物理学院)、Ang Li、Yisen Wang(北京大学通用人工智能国家重点实验室),The RSI Tax: When Recursive Self-Improvement Is Not Worth the Cost,arXiv:2611.13524,2026-11-10
- 图 1、图 3 取自论文原文(Figure 1、Figure 3);图 2 按论文表 2 数据重绘
- 文内所有百分比、token 数、准确率均出自论文正文与附录,未做二次估算
本文由汇智网编译整理,转载请注明出处。
这是「AI 基建 / 评测 / 安全」专题的一部分。完整地图见:AI 基建 / 评测 / 安全完全指南